


ИИ убивает интернет-экономику: когда машинный трафик превысит человеческий, модель платного контента вынуждена будет перезапуститься
Автор: Shoal Research
Перевод: TechFlow
Введение от TechFlow: Согласно последним данным Cloudflare, трафик ИИ-ботов уже составляет 60% от всех HTML-запросов в интернете, впервые превысив долю человеческого трафика. Это означает, что десятилетиями поддерживавшая открытый интернет модель «контент в обмен на трафик» рушится, а новая инфраструктура «оплаты за запрос» еще не готова. Для создателей контента, рекламодателей и всех специалистов, зависящих от поискового трафика, это вопрос выживания фундаментальнее любых обновлений алгоритмов.
19 марта 2026 года генеральный директор Cloudflare Мэтью Принс прогнозировал, что под влиянием генеративного ИИ трафик ботов превысит человеческий трафик к 2027 году. Cloudflare является крупнейшей в мире сетью доставки контента, обслуживающей около 20% интернета. Всего несколько месяцев спустя Принс заявил, что трафик агентов растет настолько быстро, что теперь боты опережают людей. На сети Cloudflare роботы составляют примерно 60% HTTP-запросов к HTML-контенту, тогда как люди — лишь 38,2%. По мере того как доля автоматизированных систем, генерирующих запросы к HTML-страницам, превышает человеческую, причем все большую долю среди них занимают ИИ-агенты, бизнес-модель, на которой держится интернет, рушится.

Сделка, питавшая открытый интернет
Всемирная паутина обеспечила беспрецедентную демократизацию глобальной информации, а поддерживала эту миссию простая и прямая система обмена («контент в обмен на трафик»): издатели публикуют контент в сети, а поисковые системы направляют читателей на их сайты при поиске. Издатели поставляют информацию или развлечения для сети в виде контента; поисковые системы помогают направлять читателей на соответствующие веб-страницы; рекламодатели монетизируют эти визиты, размещая таргетированную рекламу на страницах, куда перенаправлены пользователи. Этот синхронно работающий замкнутый цикл совместно создал рекламу стоимостью в миллиарды долларов, которая кормила открытый интернет без платных стен.
Эта сделка обеспечивала массовый бесплатный доступ к информации, но также сосредотачивала власть распределения в руках поисковых и рекламных платформ. Она поощряла поведенческую рекламу, объемное создание SEO-оптимизированного контента и гонку за трафиком, делая издателей глубоко зависимыми от рекомендательного и аналитического трафика. ИИ разрушает环节 «рекомендаций» в этой и без того хрупкой сделке, в то время как альтернативы еще не готовы.
Рекламный доход Google вырос с 66,9 млн долларов в 2001 году (год первого полного раскрытия этих данных) до 294,7 млрд долларов в 2025 году, увеличившись примерно в 4400 раз.
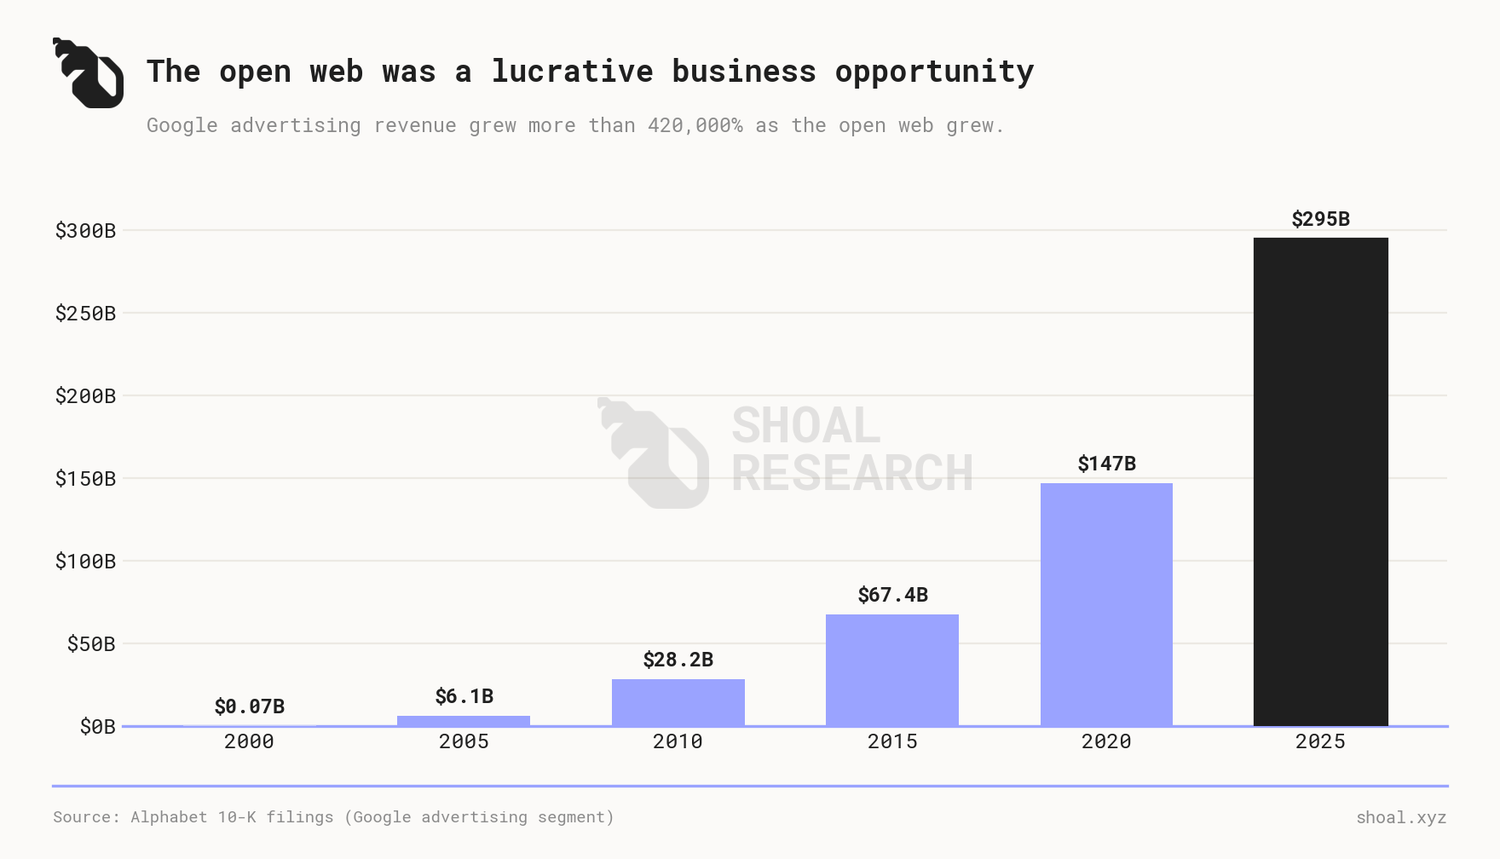
Однако взрывной рост приложений для чат-ботов на базе ИИ в последние годы внедрил новую парадигму поиска информации в сети. По своей сути эти приложения ставят удобство пользователя на первое место, удерживая аудиторию внутри интерфейса чата. Это удобно для пользователей, но особенно смертельно для издателей. Поисковые системы направляют читателей на сайты источников контента, тогда как приложения ИИ сжимают и суммируют информацию, представляя ее напрямую как часть окончательного ответа на запрос пользователя. Издателям становится все труднее монетизировать трафик через свои сайты, поскольку они теряют прямой контакт с пользователями, а объем человеческого посещения снижается.
Набирает силу новое решение — внедрение совершенно новой инфраструктуры платежей «по запросу» для контента и поиска в интернете. В этой статье мы рассмотрим, как ИИ «ломает интернет», два разных пути реализации этого решения, а также текущее состояние формирующейся pay-per-request сети.
ИИ-краулеры и смерть модели обмена
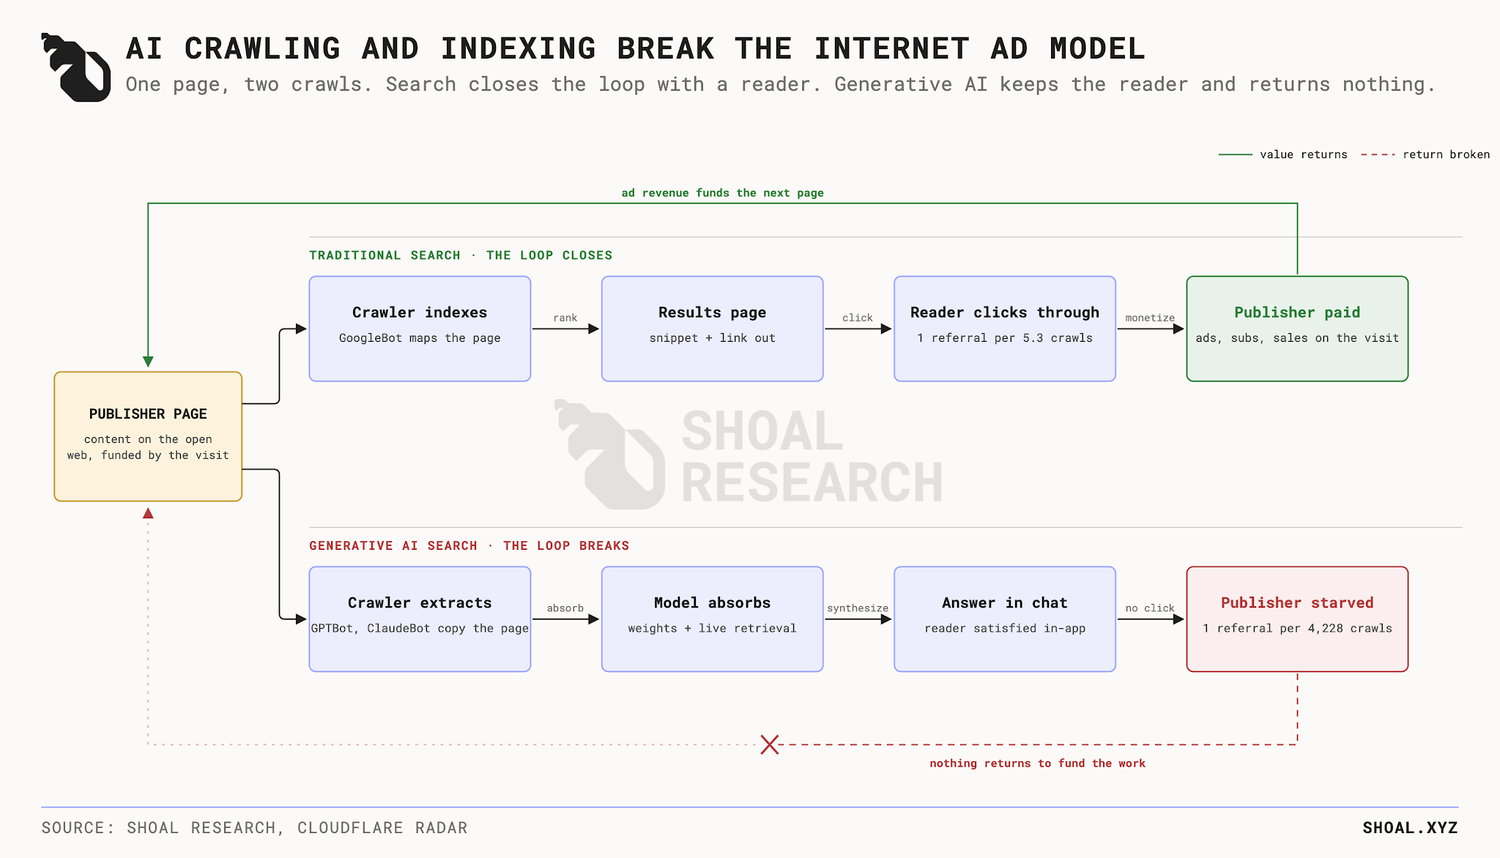
Поисковые системы используют краулеров (автоматизированные программы для индексации веб-страниц) для построения «карты» сети. В традиционной модели «контент за трафик» издатели позволяли этим краулерам бесплатно копировать их текст, поскольку поисковики отвечали направлением человеческих читателей обратно на их сайты. Для управления этим доступом отрасль опиралась на текстовый файл robots.txt — систему добровольного соблюдения правил, основанную на доверии и не имеющую шифрования. Robots.txt долго работала стабильно, потому что игнорирование файла означало потерю доступа к контенту издателей, что напрямую вредило качеству индексации сети поисковыми системами.
Приложения генеративного ИИ превращают краулеры из инструментов индексации в активных потребителей, тем самым разрушая сделку по обмену контентом в сети, что наиболее ярко проявляется в этапах обучения и выборочного поиска. На этапе обучения крупные языковые модели, такие как GPT или Claude, обучаются на гигантских корпусах текста, собранных из открытого интернета, включая книги, статьи, код и художественные произведения. Модель обучается на всем массиве человеческих знаний, а затем возвращает эти знания пользователям без ссылок на источники и без выплаты авторам каких-либо вознаграждений. На этапе выборочного поиска (RAG) модель индексирует реальные данные в сети прямо в момент ответа на запрос пользователя, извлекает соответствующие фрагменты и переформатирует их. Модель не передает оригинальную страницу читателю, а вместо этого пересказывает информацию в виде совершенно нового встроенного ответа, полностью закрывающего вопрос пользователя. Краулеру достаточно один раз проиндексировать страницу, чтобы модель могла предоставить найденный контент миллионам читателей, ни один из которых не будет возвращен на первоисточник.
Последствия
Если рассмотреть механизмы сбора данных вместе с поведенческими показателями, федеральными судебными исками и эксплуатацией искусства, становится очевидно, что фундамент открытой сети испытывает структурный коллапс, последствия которого уже проявляются в нескольких взаимосвязанных областях.
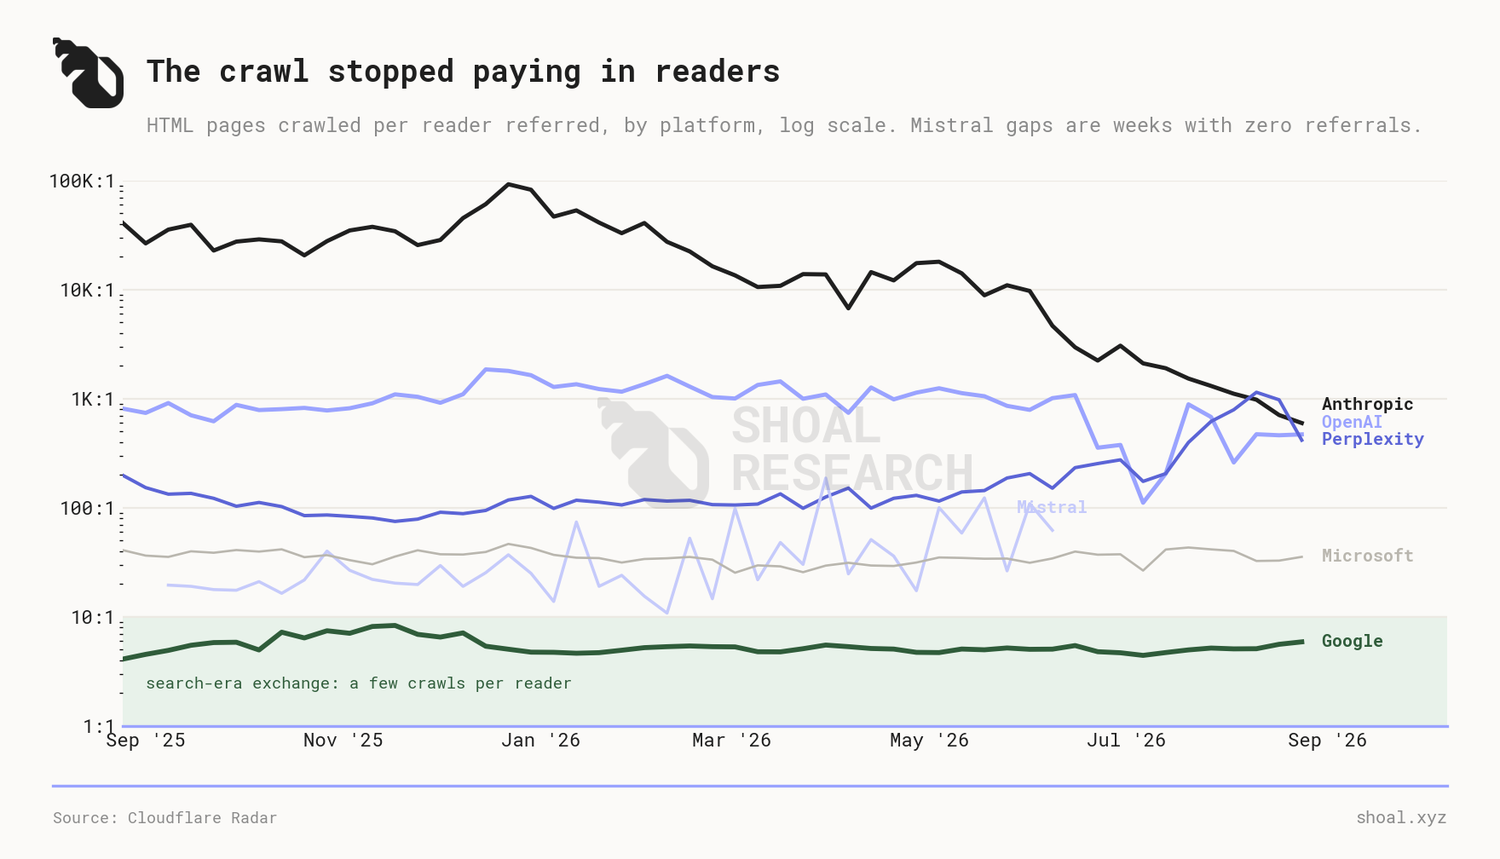
Влияние ИИ-краулеров на поведение можно измерить через «соотношение скачивания и транзита» (crawl-to-traffic ratio): отношение количества проиндексированных страниц к фактическому количеству привлеченных пользователей. Данные Cloudflare показывают, что только за последние шесть месяцев краулеры для обучения (43,9%) и для обучения плюс поиска (41,5%) составили более 85% от всех выявленных AI-краулеров запросов в сети Cloudflare. Googlebot по-прежнему сканирует почти пять страниц на одного привлеченного посетителя (5,3 в прошлом году), что ближе к историческим уровням обмена, в то время как каждый основной ИИ-платформа превосходит его на один-три порядка. За последний год ClaudeBot от Anthropic сканировал в среднем 4200 страниц на каждого приведенного на сайт источник посетителя, Mistral — 884, OpenAI — 731, Perplexity — 147. Cloudflare действительно отмечает, что трафик от нативных приложений не передает заголовки реферера, поэтому эти коэффициенты могут преувеличивать дисбаланс. Исследование Pew Research Center показало, что когда AI-саммари перехватывает поисковые запросы, уровень кликов людей падает с 15% до 8%, прямое атрибутирование кликов со саммари снижается до 1%, а в 26% случаев пользователи вообще отказываются от просмотра сессии.
ИИ-краулеры также спровоцировали судебные иски. В деле Bartz против Anthropic судья Уильям Алсап постановил, что использование легально полученных книг для обучения является добросовестным использованием, поскольку такое применение носит трансформационный характер, то есть создает что-то новое, а не заменяет сами книги, тогда как обвинения, касающиеся загруженных Anthropic пиратских библиотек, были переданы в производство. Позже Anthropic урегулировала это обвинение конфиденциально за 1,5 млрд долларов, что составляет примерно 3000 долларов за произведение при расчете на около 500 тысяч произведений. Этот результат широко истолковали как победу Anthropic, поскольку постановление о том, что обучение относится к добросовестному использованию, было сохранено, а урегулирование исключило потенциально гораздо более высокие статутные убытки. Поскольку дело было урегулировано, ни один суд так и не определил реальную стоимость использования пиратского контента для обучения. Тем временем иск New York Times против OpenAI и Microsoft продолжается, вынуждая OpenAI передать 20 миллионов логов диалогов ChatGPT как часть расследования того, насколько сильно модели копируют статьи, заменяющие платные подписки.
Эти дела подчеркивают, что затраты на бессчетный сбор данных ИИ-краулерами ложатся особенно тяжело на независимых авторов и визуальных художников. Когда в начале 2025 года OpenAI представила возможности рендеринга в стиле Studio Ghibli, это точно продемонстрировало, насколько слабы существующие механизмы защиты авторских прав. Поскольку американское право защищает конкретное выражение произведения, а не общий стиль, ИИ-модели могут систематически клонировать эстетику, созданную десятилетиями человеческих усилий, без упоминания или компенсации творцам. Политика OpenAI запрещает использовать имена живущих художников, таких как Хаяо Миядзаки, в качестве подсказок, но абсолютно разрешает использовать «Studio Ghibli». Конкретные персонажи, такие как Тоторо, защищены, но общий стиль Ghibli нет, что оставляет художников практически без юридических оснований, хотя модели могут создавать такие изображения исключительно благодаря обучению на фильмах этой студии. Инфраструктура оплаты по запросу не способна устранить все вышеперечисленные повреждения. Она может учитывать и компенсировать будущий доступ к работам, но не может задним числом компенсировать материалы, использованные художниками для обучения, и не может помешать моделям воспроизводить освоенные стили. Эти повреждения требуют отдельных лицензионных, авторско-правовых мер и механизма исполнения.
Коротко говоря, две основные реакции на крах сделки «контент за трафик» (судебные иски и частные лицензии) являются лишь временными мерами спасения, а не масштабируемыми бизнес-моделями. На данный момент судебные иски оценили стоимость прошлого сканирования, но оставили без внимания продолжающееся и будущее сканирование, в то время как частные двусторонние лицензионные соглашения позволяют крупным медиагруппам напрямую продавать доступ к архивам ИИ-лабораториям (например, контракт NewsCorp с OpenAI на 250 млн долларов или сообщаемая сделка Google с Reddit на 60 млн долларов ежегодно). Несмотря на внушительные суммы, исследование рынка показало, что большинство частных сделок составляют менее одного процента от ожидаемого дохода лицензиата от ИИ. Однако переговоры по таким соглашениям требуют значительных финансовых и юридических ресурсов, что означает, что независимый длинный хвост интернета (миллионы независимых создателей контента) по-прежнему не имеет возможности масштабно противостоять ИИ-краулерам.
Таким образом, ситуация проясняется: ненадежная система кредитования на основе robots.txt и сделка по обмену контентом, поддерживавшая открытый интернет тридцать лет, не могут выдержать интернет, где экономически приоритет отдан потреблению данных над транзитным трафиком, а краулеры стали главными потребителями. В прошлом издатели охотно брали на себя 100% затрат на производство контента, получая взамен 100% потребительского трафика и внимания; теперь же генеративный ИИ полностью потребляет контент, почти не предоставляя атрибуции, фактически отрезая источник человеческого сетевого трафика, который издателям именно и нужен для генерации доходов от рекламы или подписок, в результате издатели все равно оплачивают дорогие счета за хостинг за машинное сканирование, не получая никакого трафика. Это давление происходит одновременно с двух сторон. Полоса пропускания и вычислительные затраты на обслуживание одного робота идентичны затратам на обслуживание одного читателя, но робот уходит, не посмотрев рекламу и не оформив подписку. При соотношении скачивания и транзита в сотни или тысячи издатель платит за обслуживание тысяч запросов за каждый единственный потенциально монетизируемый визит. Поскольку издатели не могут позволить себе платить за серверы просто ради бесплатного копирования текста машинами, интернет нуждается в новом способе обеспечения выплат создателям за их продукты. Поскольку люди читают AI-саммари вместо посещения сайтов, издатели больше не могут зарабатывать исключительно на человеческом внимании. Следовательно, точка монетизации сместилась на момент фактического сканирования данных ИИ-ботами, а следующим логичным шагом станет внедрение новой сетевой pay-per-request платежной инфраструктуры.
Pay-per-request сеть
Для расширения модели оплаты за запрос на весь интернет необходима эффективная система учета контента и доступа к серверам. Хотя все большая часть этой деятельности движется ИИ-краулерами, эта рамка применима к любому нечеловеческому взаимодействию, включая источники данных и автоматизированные API. Проще говоря, для доступа к платному контенту программное обеспечение должно программно оплачивать другому программному обеспечению, процесс, официально называемый machine payment.
Для масштабной поддержки machine payment инфраструктурные компании строят автоматизированные шлюзы биллинга на уровне маршрутизации сети, взимая плату с роботов в миллисекундный момент возникновения запроса. Однако способы реализации в основном делятся на два принципиально различных подхода: закрытая рыночная модель, требующая регистрации аккаунтов краулерами и получения уникальных цифровых ключей для доступа к сайтам через посреднические маршрутизаторы; и открытая протокольная модель, спроектированная вокруг стандартизированных общедоступных правил программного обеспечения, машинно-читаемых заголовков и поддержки расчетов платежей на более широких цифровых треках.
Закрытый рынок
Модель gated market рассматривает веб-контент как частный актив, управляемый корпоративным посредником. В этой рамке machine payment должен сначала пройти аутентификацию и получить разрешение на доступ. Издатели конфигурируют свою сеть, перенаправляя входящие ИИ-краулеры с публичных сайтов для людей на выделенные вторичные URL-адреса, управляемые провайдерами маркетплейсов. На этом шлюзе платформа сверяет учетные данные краулеров с базой данных, оценивает настроенные издателем правила доступа, фиксирует использование и форматирует страницы в машинно-читаемый текст. Финансовые транзакции происходят вне уровня сетевых протоколов. Когда робот инициирует запрос, платформа регистрирует это использование и списывает средства с предварительно пополненного кредитного баланса ИИ-компании. Расчеты производятся периодически через платформ торговых представителей, такие как Stripe Connect, в фиате, поскольку комиссия за каждую микро-транзакцию картой могла бы превысить стоимость самого запроса. Установка посредника напрямую между ИИ-краулером и сервером исходного сайта издателя помогает максимизировать безопасность, защитить серверы от агрессивных потоков трафика и обеспечить доступ только проверенным корпоративным партнерам. Однако при масштабном внедрении эта рамка может превратить открытый интернет в сеть, состоящую из магазинов с лицензионным доступом,进一步 ухудшив опыт обычных пользователей.
Ранняя сетевая программная pay-per-request инфраструктура платежей всегда была gated market, самой известной из которых является TollBit и первая версия Cloudflare Pay-Per-Crawl. TollBit — это платформа для управления, мониторинга трафика ИИ-агентов и его монетизации. Для развертывания издателю необходимо настроить специальный поддомен (например, https://tollbit.thedailydispatching.com/), и при обнаружении ИИ-краулера, пытающегося получить доступ к основному сайту, сервер автоматически перенаправит его на поддомен TollBit, откуда доступ будет получен только после оплаты. TollBit проверяет, имеет ли ИИ-компания зарегистрированный биллинг-аккаунт, фиксирует количество запрошенных роботом страниц, доставляет данные в чистом текстовом формате и обрабатывает платежи в долларах США. Требуется API-ключ, поэтому如今的 обнаружение контента стоит средств не является самостоятельным: ИИ-разработчики должны сначала зарегистрироваться в TollBit.
1 июля 2025 года Cloudflare запустила свою первую модель Pay-Per-Crawl. Cloudflare работает на уровнях DNS и CDN, что означает обработку трафика до того, как он достигнет физического сервера источника контента издателя. В первой версии Pay-Per-Crawl Cloudflare интегрировала свой edge-level Web Application Firewall (WAF), который по умолчанию автоматически обнаруживает и блокирует известные ИИ-краулеры в своей сети. Когда ИИ-краулер запрашивает доступ к домену, защищенному Pay-Per-Crawl, Cloudflare перехватывает запрос до достижения им веб-сайта издателя и促成 платеж, если владелец сайта решит монетизировать свой контент.
Вызовы модели gated market
TollBit опирается на настройку разработчиков API, проприетарные ключи и традиционные банковские каналы для платежей. Маршрутизация транзакций pay-per-request через merchant-сети, такие как Stripe, вводит фиксированные комиссионные за обработку (обычно около тридцати центов плюс процент от общей суммы), что делает экономически невыгодными одиночные, менее чем за миллионную долю доллара, real-time запросы. Чтобы обойти это ценовое препятствие, человеческие разработчики должны вручную регистрировать аккаунты у посредников gated market, генерировать уникальные API-ключи и предварительно пополнять баланс кредитной картой или банковским переводом, с которого платформа впоследствии постепенно списывает средства. Таким образом, агенты и другое автономное ПО пока не способны самостоятельно находить и приобретать данные по требованию; вместо этого человеческие администраторы должны вручную создавать коммерческие аккаунты, отслеживать постоянно колеблющиеся балансы у разных провайдеров и координировать безопасные ключи.
Хотя человеческое участие остается незаменимым во многих ИИ-центричных процессах, использование модели gated market для масштабного управления доступом к веб-контенту по умолчанию предполагает предсказуемые, линейные паттерны сетевого трафика, что прямо конфликтует с реальностью работы современного программного обеспечения. ИИ-агенты и краулеры используют циклы рассуждений для динамического выбора собственных путей навигации в зависимости от подсказок пользователя, что означает, что они часто сталкиваются с незнакомыми доменами, содержащими точные данные, необходимые для задачи. Остановка посередине задачи для ручного вмешательства человека быстро создает узкое место в исполнении, разрушая пользовательский опыт. Фиксированные подписки здесь также не являются максимально эффективным решением; ИИ-агенты запускаются в любое время по получении инструкций, что часто проявляется в непредсказуемых всплесках активности (например, кто-то может три дня подряд заниматься исследовательским проектом, а потом взять двухнедельный перерыв).
Между предварительным депозитом и необходимостью кастомной интеграции ПО для доступа к защищенному контенту и данным, gated market по своей сути представляет собой высоколицензионную систему. С одной стороны, сетевые издатели получают контролируемый, верифицированный трафик от зрелых технологических компаний; с другой стороны, административная и финансовая нагрузка от управления счетами с предоплатой на нескольких независимых платформах ограничивает анонимный доступ, препятствует спонтанному сканированию независимыми разработчиками и сокращает возможности монетизации для мелких и средних издателей, не обладающих масштабным корпоративным трафиком.相比之下, прямое машинно-машинное финансовое рукопожатие позволяет издателю прикрепить микровознаграждение к тексту и данным, которые собираются запросить краулеры; этот принцип проектирования лежит в основе open protocol mode.
Открытая альтернатива: x402 и MPP
Открытые протоколы представляют собой сетевую архитектуру, основанную на открытых, стандартизированных правилах связи. Большая часть современного интернета построена на открытом протоколе HTTP, SMTP и TCP/IP, которые используются до сих пор. В последние годы статус-код HTTP 402 (сохранен более тридцати лет, но оставался неактивированным) стал ключевым компонентом web-native инфраструктуры для поддержки machine payments на открытых протоколах с использованием блокчейн-треков.
Эксперименты с оплатой биткоинов через HTTP 402 восходят к 2015 году, к пионерским проектам относятся 21co Bitcoin Computer и Lightning Network L402. В мае 2025 года протокол x402 впервые внедрил стейблкоины в процесс HTTP 402, в то время как усилия, такие как Machine Payment Protocol (MPP) Stripe и Tempo, поддерживают оплату биткоинами и кредитными картами помимо стейблкоинов. Опция кредитных карт предназначена для макро-транзакций, а не для микроплатежей, поскольку фиксированная комиссия за свайп поглотит запросы менее чем на миллионную долю доллара. Стейблкоины остаются трекком, делающим возможным ценообразование pay-per-request.
x402 встраивает платежные инструкции непосредственно в код обмена данными, без необходимости регистрации третьих сторон в аккаунтах или проприетарных клиринговых центров. Когда ИИ-краулер запрашивает веб-страницу, хост-сервер напрямую встраивает машинно-читаемый ответ (pay header) в метаданные соединения. Этот заголовок предоставляет точную цену за каждый запрос, указанный платежный трек и цифровой адрес счета получателя.
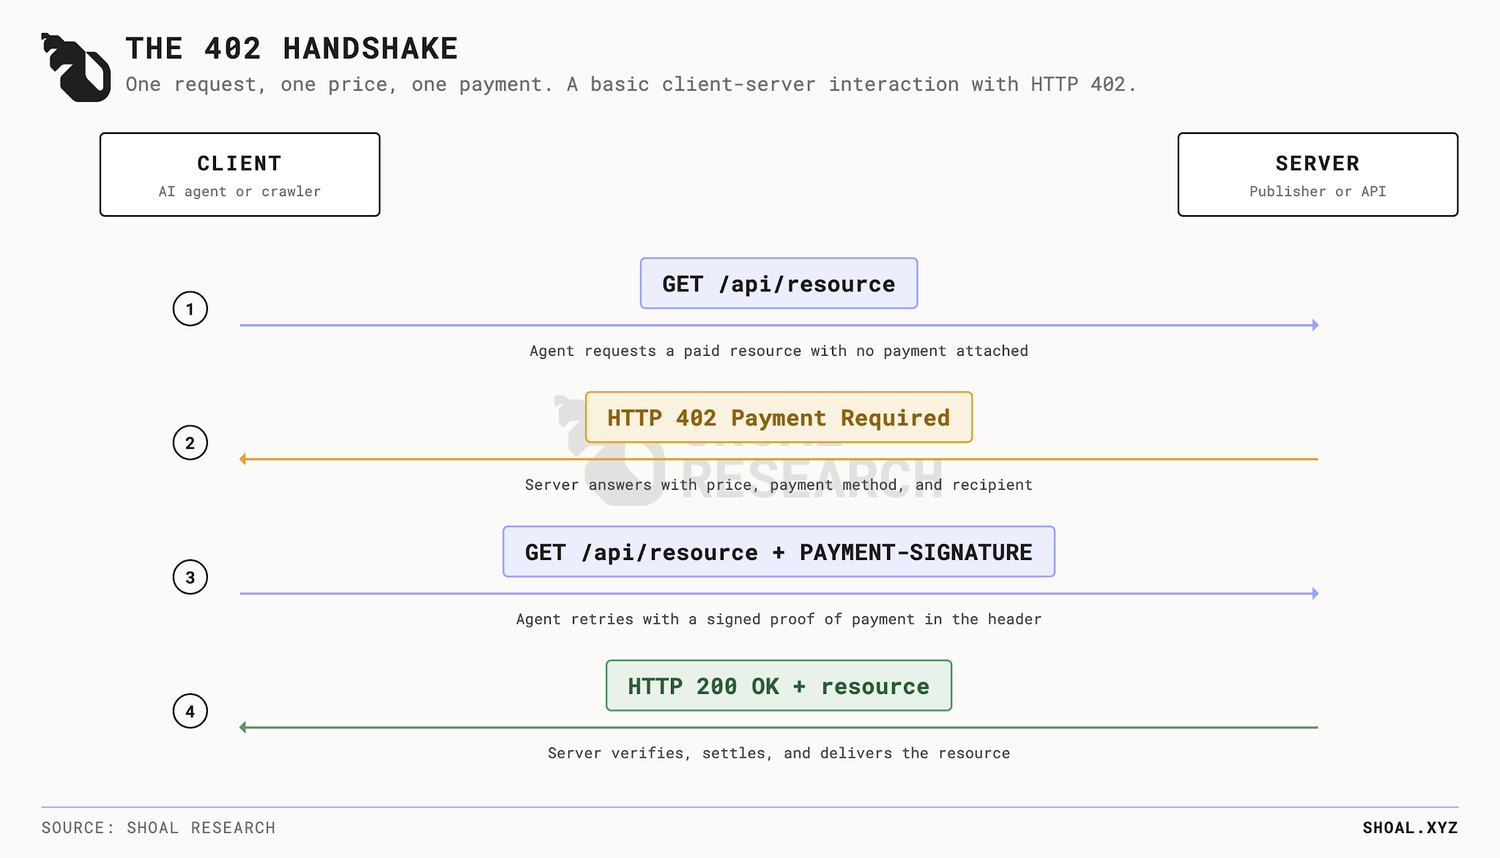
Блокчейн играет все более заметную роль в облегчении machine payments, поскольку предоставляет неизменяемый, программируемый финансовый слой, чья нативная скорость и уровень автоматизации согласуются с программной логикой. Криптоактивы, такие как стейблкоины, структурно расположены близко к ИИ-агентам в сети, поскольку они работают на той же сетевой инфраструктуре, что и ИИ-агенты и краулеры, существуют в форме программного кода и могут быть интегрированы через простые API-эндпоинты и криптографические подписи. Затраты и комиссии на использование блокчейн-треков для платежей все еще значительно ниже, обычно составляя доли цента за транзакцию на ведущих высокопропускных цепочках, что намного дешевле, чем кредитные карты и финтех-компании (хотя все больше финтехов активно сокращают этот разрыв, например Wise).
Блокчейн-треки также изначально обеспечивают криптографические квитанции и проверку для каждого платежа. Каждый цикл pay-per-request предоставляет постоянно хранящуюся квитанцию, содержащую цифровую подпись покупателя, запрошенный URL и точный временной штамп. Поскольку эти инструкции хранятся в публичной цепи, любой автоматизированный агент может распарсить входящие метаданные, выполнить микроплатеж совместимым активом (например, стейблкоином) и загрузить контент в рамках единого непрерывного HTTPS-рукопожатия. Расчеты по традиционным банковским трекам требуют сверки дебетовых и кредитовых позиций между банками-корреспондентами через клиринговые центры, обычно занимая несколько дней, в то время как блокчейн-расчеты завершаются немедленно после проверки сетью узлов цифровой подписи и обновления состояния глобальной цепи, как упоминалось ранее, обычно за несколько секунд на ведущих цепях. Самое главное, подход open protocol стандартизирует доступ к сетевым данным, позволяя любому издателю независимо от масштаба монетизировать свои активы, а разработчикам с финансируемым автоматизированным аккаунтом — осуществлять сканирование без предварительного получения административного разрешения.
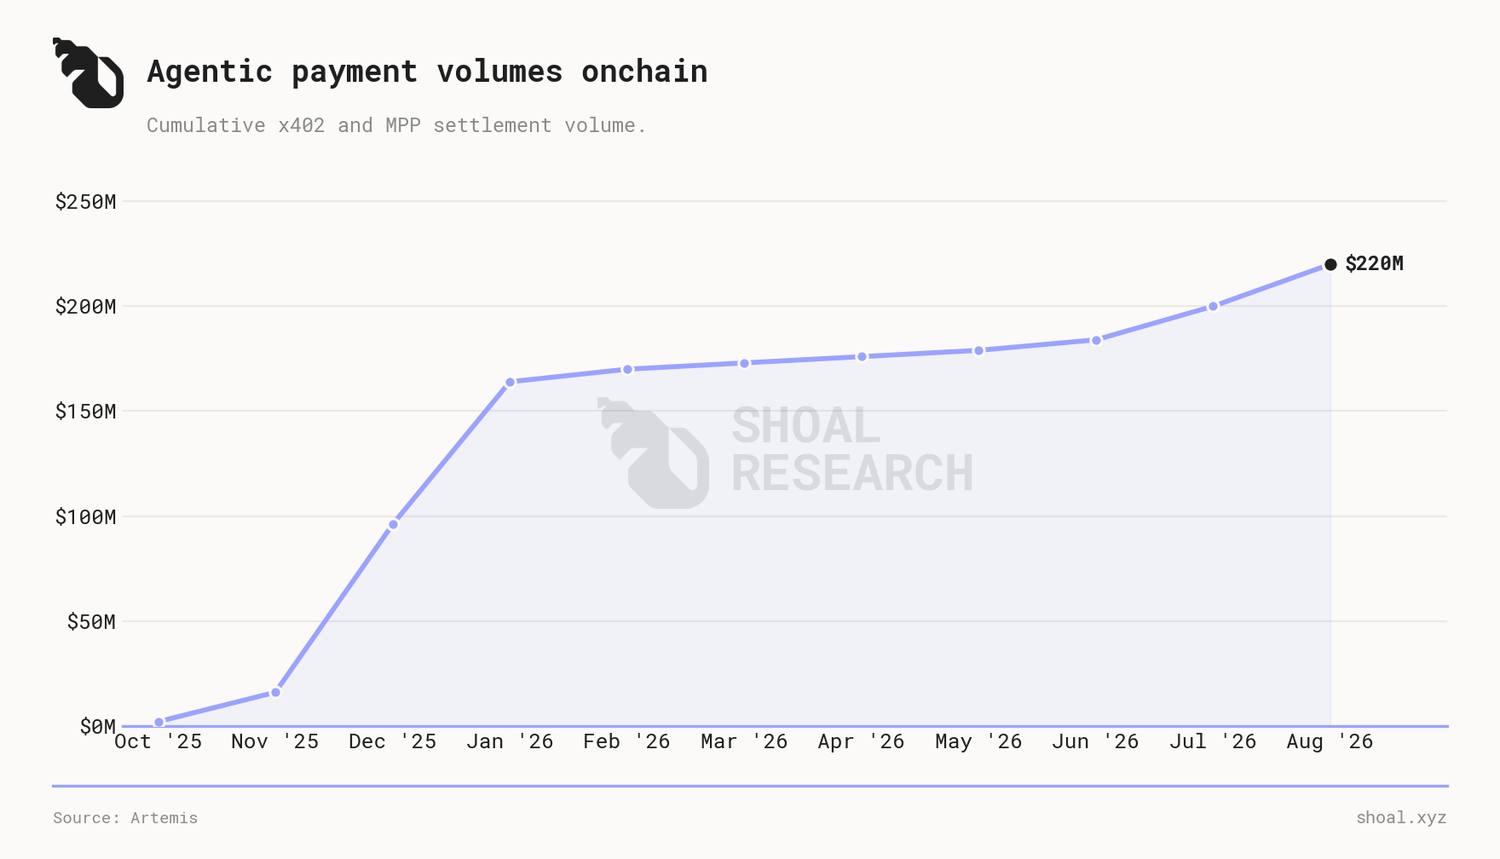
15 июня 2026 года Amazon Web Services (AWS) напрямую интегрировала протокол x402 в CloudFront и свой WAF. Эта конфигурация позволяет примерно четверти интернета активировать автоматизированное биллинг-учет агентов непосредственно из их существующей облачной консоли, предоставляя контент платящим роботам. Cloudflare последовала примеру: ее Pay-Per-Crawl V1 требовала от Cloudflare выступать в роли recorded merchant для обработки платежей через Stripe, в то время как новый Cloudflare Monetization Gateway полностью исключает Cloudflare из платежного цикла, маршрутизируя платежи peer-to-peer напрямую в кошелек продавца.
Основное различие между закрытыми рынками и открытыми протоколами заключается в том, кому разрешено покупать доступ к сетевому контенту. В модели закрытого рынка доступ ограничен курируемым whitelist-ом; ИИ-роботы могут приобретать контент только после того, как материнская компания вручную подпишет корпоративный контракт и пройдет проверку фона через посредническую платформу. В модели открытого протокола доступ полностью автоматизирован и не ограничен; любая программа в интернете может мгновенно покупать и скачивать данные, если ее автоматизированный биллинг-аккаунт может мгновенно рассчитать требуемую микро-комиссию. По мере распространения этих двух систем в сети маршрутизации интернета издатели сталкиваются с выбором между двумя разными инфраструктурными опциями. Модель закрытого рынка обслуживает корпоративные организации, ставящие во главу угла строгие требования безопасности и соответствия, юридические гарантии и курируемые партнерские отношения с технологическими компаниями. Напротив, модель открытого протокола обслуживает автоматизированные рабочие процессы, нуждающиеся в бесшовных микро-транзакциях, позволяя разнообразной экосистеме независимых разработчиков и издателей программно обмениваться данными без административных барьеров.
Что на самом деле встречают ИИ-краулеры сегодня
Для оценки фактического покрытия pay-per-request сети Shoal Research 19 августа 2026 года探测ировал 108 основных издательских и потребительских сайтов в качестве ИИ-краулера (GPTBot). Выборка впоследствии была расширена с 108 до 500 доменов. Нижеприведенные результаты описывают первоначальный августовский тест. Для каждого запроса мы фиксировали код статуса, цепочку редиректов, заголовки ответа и тело вызова, а также вычисляли SHA-256 хеш для обеспечения целостности данных во время сбора. Эндпоинт классифицировался как x402-payable или proxy-payable только в том случае, если его HTTP 402 ответ возвращал разбираемые платежные параметры в заголовке Payment-Required / X-Payment-Required или в корректной нагрузке запроса x402 JSON.
Из 108 издателей сеть разделилась на три основные позиции:
Предоставляется бесплатно (49,1%, n=53): 53 домена открыто предоставляют свои главные страницы со статусом HTTP 200 OK, разрешая неограниченное извлечение.
Граница заблокирована (33,3%, n=36 всего): 31 домен возвращает HTTP 403 Forbidden, два требуют аутентификации (HTTP 401), два отвергают согласование контента (HTTP 406), один возвращает правовую блокировку (HTTP 451). Еще 3 издателя завершились таймаутом после множественных попыток.
Возвращает HTTP 402 (14,8%, n=16): ровно 16 издателей возвращают статус-код HTTP 402 Payment Required.
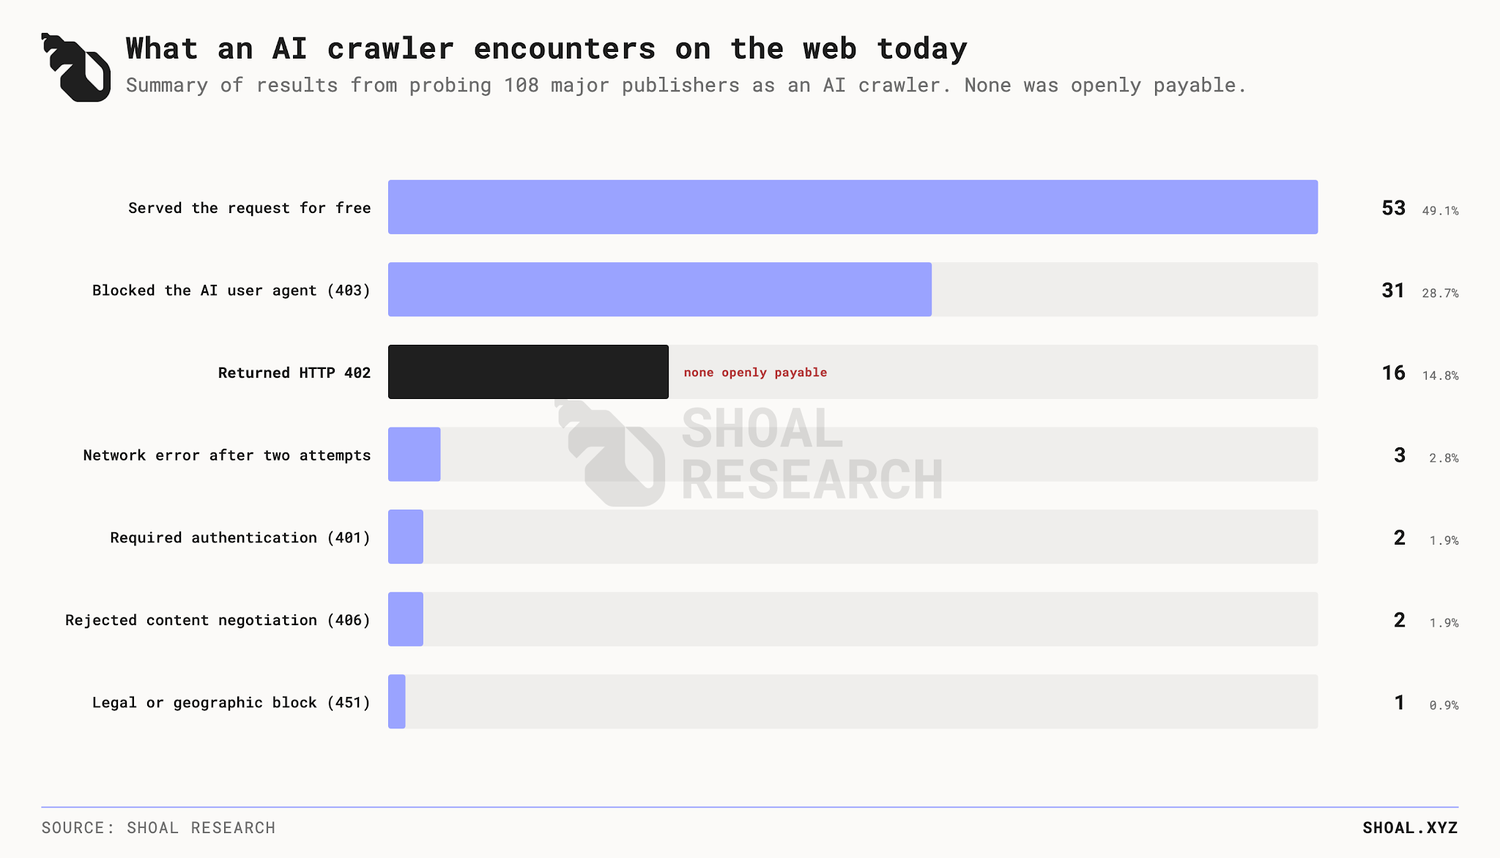
Ключевым моментом является то, что ни один издатели в наборе данных не вернул открытого, машинно-платежного вызова.
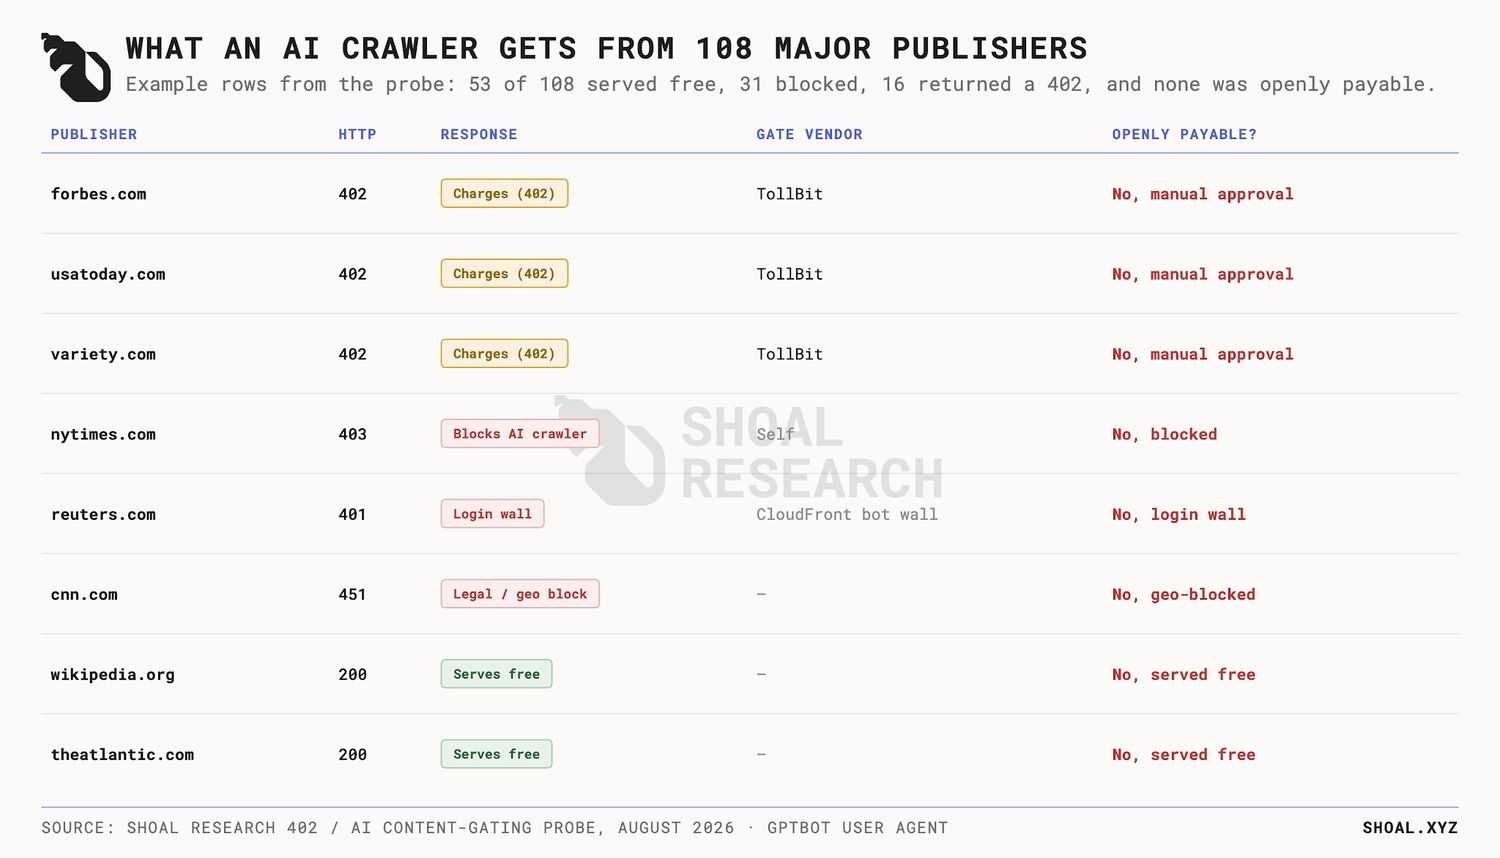
В 16 ответах HTTP 402, 10 редиректят на TollBit Bot Paywall, а 6 возвращают статическую HTML форму для связи по лицензии. Вторичная проверка всех 13 издателей, управляемых TollBit в базовой выборке, с использованием верифицированного ключа разработчика, во всех запросах тарифов возвращала HTTP 403. Нагрузка API четко указывает, что провайдеры контента отключили программный доступ и не возвращают ставку цены за каждое сканирование.
Одним из способов интерпретации этих результатов является то, что TollBit действует как ранний ИИ-партнер для традиционных издателей, помогая им тестировать и понимать оплату за использование контента, при этом все еще предоставляя издателям контроль и безопасность, обусловленные контролируемым доступом агентов. Система, требующая ручной регистрации разработчиков, проприетарных API-ключей и корпоративных whitelist-ов, сложно масштабируется на беспрецедентное количество автономных агентов, навигирующих в динамических сетевых путях; напротив, она представляет собой переходный этап, предназначенный для защиты традиционных доходов в ожидании формирования постоянных машинно-нативных стандартов расчетов. На данный момент стадия ранняя, и мы считаем, что подобные провайдеры, как TollBit, пытаются понять и установить баланс между доступом, лицензированием и автономностью, которую несет такой сервис.
Мы также извлекли полный реестр регистрации Coinbase CDP 19 августа, чтобы понять, кто фактически использует x402 и какие сервисы работают в этой сети. Эта сеть, заявляющая о наличии более 15 000 эндпоинтов, из которых сотни находятся в активном использовании.
Основные издатели контента еще не приняли x402, но под этим отсутствием сформировался активный рынок предложения. Хотя потребительские медиа еще не активно интегрируются, инструменты разработки, специализированные поставщики данных и сети агентов быстро развернули открытые endpoint машинных платежей; узнаваемые имена в экосистеме x402 включают такие Data API, как Tavily, Nansen, CoinGecko, Chainlink, Apify и Browserbase, а недавно Ramp. Крупнейшие поставщики услуг на x402 включают имена вроде ChatGPT, Claude, TripAdvisor и Perplexity, однако крупных контентных издателей пока нет.
15 073 активных эндпоинта свидетельствуют о том, что программное обеспечение активно ценит и продает программный доступ к другому программному обеспечению по открытым публичным трекам. Некоторые трекеры этой сети сообщают, что с учетом bundled market количество эндпоинтов может достигать 50 000. Однако эти эндпоинты все еще строго сконцентрированы в сфере сканирования, вызовов ИИ-инструментов и потоков данных в реальном времени; после перекрестной проверки всего реестра с основными потребительскими медиа и издательскими доменами (New York Times, Reuters, ESPN, Wikipedia) совпадений нет. Мы ожидаем, что эта ситуация медленно, но увернно изменится, так как обычно требуется известный институт, чтобы «раскачать ситуацию». Исторические сдвиги в монетизации сетей часто следовали за одним игроком на рынке, ломающим status quo: New York Times запустила metered paywall в 2011 году; Associated Press открыло precedent для коммерческой торговли ИИ-данными в 2023 году, запустив цепную реакцию от News Corp до Time и Condé Nast. Поэтому мы ожидаем, что когда первый лидер из отрасли установит цену на свой доступ на открытых протоколах (таких как x402, MPP), остальные участники рынка быстро последуют примеру.
Вызовы подхода открытых протоколов
Инфраструктура открытых pay-per-request протоколов уже функционирует, но сам рынок находится на ранней стадии. Технические каналы открытых платежей активно развертываются: у издателей есть машинно-читаемые рамки прав, такие как RSL; хостинговые и маршрутизирующие шлюзы в AWS CloudFront и Cloudflare могут проводить биллинг в миллисекундный момент запроса; расчетные треки варьируются от кредитных карт до цифровых активов и стейблкоинов, все из которых повсеместно доступны через такие протоколы, как x402 и MPP. Главный оставшийся барьер для активного внедрения полностью находится на стороне спроса.
Во-первых, ни одна основная ИИ-лаборатория не маршрутизирует производственный краулер-трафик через открытый трек машинных платежей для контента потребительской сети. Мы полагаем, этому есть три основные причины. Во-первых, краулеры лишены интегрированных кошельков, автоматизированных бюджетов на закупку и, самое главное: коммерческих обязательств реально оплачивать контент для своих запросов. Как показали наши краулер-сканирования, большая часть сети все еще полностью свободна от барьеров, что означает, что агенты, заблокированные HTTP 402, могут просто отбросить этот URL и с нулевой стоимостью извлечь почти или полностью идентичный контент у открытых неограниченных конкурентов. Правовая среда усиливает эту динамику: согласно федеральным постановлениям, таким как решение судьи Уильяма Алсапа в деле Bartz против Anthropic, суды пришли к выводу, что потребление легально доступных произведений для обучения ИИ-моделей является трансформационным добросовестным использованием. Хотя Алсап наказал за сохранение нелегально полученных пиратских наборов данных, обучение на контенте, доступном в открытом интернете, не несет никакой ответственности за нарушение авторских прав. Поскольку извлечение текста из открытого интернета юридически бесплатно, у ИИ-лабораторий нет коммерческого мотива добровольно платить открытые микро-комиссии.
Как ИИ-поисковые провайдии распределяют вознаграждения
Производственное внедрение все еще ограничено, но ИИ-поисковые провайдеры начинают рассматривать компенсацию как часть дизайна продукта.
В несостоявшемся интервью Shoal Signal бывший инженер параллельного развертывания Son Do описал Index, план, напрямую сотрудничающий с издателями для измерения вклада каждого источника в окончательный ответ агента и передачи части дохода этим источникам. До прогнозирует, что издатели и другие поставщики данных перейдут на модели, основанные на использовании, а трек платежей агентов поддержит множество мелких транзакций. Index показывает, что компенсация внедряется на этапе проектирования продуктов ИИ-поиска и извлечения, хотя это еще не стало стандартным поведением закупки основных ИИ-лабораторий.
Помимо отсутствия обязанностей на юридическом и экономическом уровнях, существующие открытые протоколы платежей имеют структурный недостаток: они измеряют неправильную часть цикла pay-per-request: они измеряют начальное HTTP-сканирование, а не downstream reasoning, то есть момент, когда модель синтезирует усвоенные знания для ответа на пользовательскую подсказку. Взимание платы менее чем за миллионную долю доллара за сырой HTML не компенсирует создателя, если ИИ-модель может однажды поглотить репортаж и воспроизвести его в миллионах пользовательских ответов. Хотя такие рамки, как RSL, определяют опции оплаты за reasoning, сетевые шлюзы уровня Cloudflare или AWS не могут проверить скрытые веса нейронной сети для криптографической верификации того, какие обучающие документы породили определенный токен вывода. Пилотный проект Cloudflare в июле 2026 года с Ceramic.ai и You.com恰好凸显了这一技术瓶颈。计划试图摆脱按抓取收费的模式,测试一种“按查询付费”模型,仅当出版商文本实际被引用于面向用户的 AI 回答中时才向其付费。虽然这正确地瞄准了价值创造的时刻,但 Cloudflare 等网络边缘提供商位于 AI 服务器之外,意味着 Cloudflare 无法独立验证模型在生成过程中引用了哪些来源,因此系统不得不依赖 AI 公司自行统计引用并自行报告欠款金额,退回到一种荣誉制度。
Другая фундаментальная проблема открытых протоколов заключается в том, что вы не можете действительно предотвратить ИИ-краулера от оплаты одного микро-вознаграждения за контент, записи текста во внутреннее кэширование или память, а затем необдуманного предоставления этих данных. Вы также не можете помешать ИИ-краулеру делать это тысячи раз, повторяясь по разным сайтам и издателям. Как утверждал Brendan Ryan, соавтор MPP от Tempo, в нашем интервью Shoal Signal, способность продавца собирать плату во многом зависит от того, является ли информация уникальной, свежей и сложной для кэширования.
Это ограничение наиболее серьезно сказывается на упомянутых выше статических творческих работах и репортажах. Статический текст почти сразу теряет экономическую ценность после публикации, даже собираемый через механизм извлечения ИИ-инструментов. Как только ИИ-модель прочитала расследовательский репортаж, историческую статью или пресс-релиз, эта информация поглощается в памяти модели. Модель может навсегда использовать эти факты для ответов на вопросы, без повторного доступа к исходному сайту. Следовательно, простое упаковывание программного инструмента, объединяющего открытый сетевой текст с ИИ-интерфейсами, увидит, как прибыль быстро исчезает, поскольку конкуренты будут строить те же краулеры на той же свободной информации.
Фундаментальное правило, таким образом, просто: статические данные почти немедленно теряют способность к ценообразованию, в то время как динамичный и несканируемый контент сохраняет возможность оплаты. Поскольку ИИ-модели могут прочитать один раз неоплаченную статью или исторический отчет и навсегда сохранить эти знания в весах, микро-плата за запрос не сможет поддерживать бизнес, зависящий от статического текста; регулярная оплата применима только к информации, которая должна непрерывно производиться и проверяться, что, как мы полагаем, сводится к трем основным категориям контента:
Первая — это реальные, эфемерные состояния, включая биржевые книги в реальном времени, субсекундные финансовые котировки, телеметрию срочных новостей и потоки данных IoT-датчиков. ИИ-модели не могут ответить на запросы о текущем состоянии мира, используя веса обучения месяца назад или устаревшее кэширование; они должны в тот самый точный момент отправлять новый, оплаченный API-запрос к серверу источника для получения текущего реалиума.
Вторая — это проприетарные оффлайн-данные, не контактирующие с открытой сетью. Возьмем为例 разведку на приватных рынках: опубликованные в пресс-релизах исторические раунды финансирования и смены топ-менеджеров быстро сканируются и товаризируются дешевыми конкурентами. Настоящая способность к ценообразованию принадлежит провайдерам, проводящим первичные ручные исследования, например, напрямую собирающим неофициальные условия股权结构表的, стоимостные оценки приватных сделок и проверенные конфигурации LP через конфиденциальные отношения с фондовыми менеджерами. Поскольку эти данные никогда не индексируются на публичных URL, автоматизированные краулеры не могут обойти платную стену или извлечь их бесплатно.
Третья — это четкий человеческий голос и репутация бренда. Как отметил медиа-стратег Ашни Кристо в Shoal Signal, общая агрегированная лента новостей, заблокированная или снятая с публикации, мгновенно заменится идентичным автоматическим краулером без потери аудитории. Но когда настоящий аналитик с устоявшейся точкой зрения, журналист-расследователь или создатель прекращает публикацию контента, читатели мгновенно замечают это и ищут их в другом месте. Реальные интервью, субъективный анализ и прямой контакт не могут быть заранее вычислены LLM, сохранены в промежуточном кэше или скопированы из статического обучающего набора, что делает реальные информационные потоки, частные оффлайн-записи и личные перспективы единственными активами, способными надежно оцениваться.
Заключение
Интернет рушится, по крайней мере, выглядит так.
Для ускорения коммуникации и координации друг с другом человечество создало и соединило глобальную сеть компьютеров и программного обеспечения. Десятилетиями каждый последующий технологический слой стремился сделать этот обмен быстрее и эффективнее, в конечном итоге породив программное обеспечение, построенное для массовой автоматизации. Генеративный ИИ вручил эту автоматизированную способность в руки сотен миллионов людей одним ударом. Но по мере того как автоматизированное программное обеспечение захватывает сеть, оно фундаментально меняет способ обнаружения, синтеза и потребления информации. Наиболее серьезным последствием этого перехода является экономическое: монетизация сетевого трафика через показ рекламы и ручные рекомендации, поддерживавшие открытый интернет последние три десятилетия, больше не жизнеспособна; именно поэтому мы сейчас видим формирование pay-per-request интернета.
Два существующих различных пути представляют собой старую историю сетевого мира: централизованные, закрытые посредники, предлагающие биллинг в фиате, комплексное соответствие требованиям и знакомый процесс входа для бизнеса, но также приводящие к платформенной блокировке и лицензионному контролю; и открытые протоколы, обеспечивающие нелицензионный доступ и программные микроплатежи через стейблкоины, хотя они все еще имеют пробелы в корпоративном распространении, атрибуции reasoning и, самое главное, фактическом принятии издателями.
После того как мы лично протестировали состояние pay-per-request интернета, мы обнаружили, что инфраструктура и предложение открытых протоколов платежей уже готовы. Такие открытые протоколы, как x402, уже активно продвигают функциональные рынки сбора данных, вызовов инструментов, ИИ-reasoning и потоков данных в реальном времени, но все еще не поддерживаются основными онлайн-издателями. Платформы, такие как TollBit, в настоящее время позиционируются как рынки программной монетизации, но данные показывают, что издатели используют их лишь как временное решение для блокировки сканеров и направления ИИ-лабораторий на частные внебиржевые сделки.
Это говорит нам о том, что спор о том, «победит» ли закрытый рынок или открытый протокол, далек от завершения. На самом деле, почему это должно быть смещено в сторону одной из них? Будущее очень вероятно будет включать оба пути, обслуживая разные клиенты и разные случаи использования. Стейблкоины будут так же активно использоваться, как предоплаченные кредиты, подписки и традиционные счета. Эта игра далеко не такая zero-sum game, как считают некоторые люди или по крайней мере утверждают. По крайней мере, не в ближайшее время.
Однако, несмотря на то, что интернет находится на переломе, легко делать предвосхищающие прогнозы о том, куда все пойдет дальше, важно отдалить взгляд и помнить, что сети всего 30 лет, и за эти годы она постоянно развивалась. Независимо от того, сойдется ли Emerging pay-per-request интернет в плане платежной инфраструктуры к закрытому рынку или открытым протоколам, существует вероятность: дальнейшее развитие этой активной эволюции, богатого капиталом ИИ-пространства может сделать оба пути бесполезными, заложив основу для совершенно нового, неисследованного пути. На данный момент мы считаем, что более вероятно увидеть более широкое одновременное принятие открытых протоколов и закрытых рынков, каждый из которых обслуживает разные сегменты рынка и разные случаи использования. Однако, как и в любом предвосхищающем суждении, только время даст ответ.
Крах старых контрактов в конечном итоге может создать более здоровый интернет, в то же время повысив глобальные информационные затраты для тех, у кого изначально не хватило средств для оплаты использования по запросу или использования агентов. Однако прямые машинные платежи могут предоставить издателям путь монетизации машинного использования, не зависящий от рекламы или рекомендаций платформ. Результат будет зависеть от того, останутся ли эти новые треки открытыми для независимых издателей или станут еще одним слоем gatekeepers.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 @Shoalresearch











