

IOSG | От горячего хранения к холодным архивам: децентрализованное хранение на фоне бума систем хранения в эпоху ИИ
Автор: Джейкоб Чжао, IOSG
В последнее время «первая китайская акция на рынке хранения данных» ChangXin Memory Technologies (CXMT) официально вышла на биржу ChiNext, спровоцировав шум на рынке благодаря взлету на 500%. Несмотря на то что весь сектор хранения данных в последнее время все еще испытывает давление из-за последствий недавних коррекций, хранилища для ИИ по-прежнему подвергаются ажиотажной переоценке со стороны капитала в рамках текущего технологического нарратива. Между тем децентрализованное хранение в сфере Web3 погружено в долгосрочную стагнацию и разочарование. Почему две технологии, объединенные общим названием «хранение», демонстрируют столь противоположную динамику на рынке? Фундаментальная причина заключается в кардинальном расхождении их базовых функций создания стоимости.
Переоценка хранилищ в эпоху ИИ — это по сути оргия围绕 «эффективности горячих данных», обслуживающая предельную максимизацию утилизации вычислений и коммерческой монетизации; в то время как децентрализованное хранение придерживается ценностного принципа «надежности холодных данных», отстаивая справедливость данных, устойчивость к цензуре и долгосрочную память человечества. Первое представляет собой систему эффективности горячих данных, второе — систему доверия к холодным данным. Текущий капитальный рынок, несомненно, решительно стоит на стороне «эффективности», но человеческой цивилизации в конечном итоге по-прежнему требуется неизменяемая база памяти. Долгосрочная ценность надежного холодного хранения никогда не исчезала, она лишь затаилась в теневой стороне циклов, ожидая новой оценки эпохой.
Почему хранение снова стало фокусом цепочки создания стоимости ИИ
В традиционную эру IT хранение было бизнесом «объемов». Ключевые метрики корпоративных CIO сосредоточены на себестоимости единицы объема, надежности носителей, планах резервного копирования, стратегиях архивирования и трех–пятилетних циклах обновления оборудования. Хранение воспринималось как сопутствующий компонент при закупке серверов.
Текущая волна роста спроса на хранение — это не традиционное восстановление отраслевого цикла, а новая оценка потока данных силами ИИ. В эпоху больших моделей логика хранения качественно трансформировалась из приоритета «объема» в культ «эффективности»: непрерывное тестирование на соответствие показателям максимальной загрузки GPU, записи контрольных точек (Checkpoint) и сверхнизкой задержки RAG. Это знаменует переход ценности хранения из роли «финального места парковки данных» в статус «высокоскоростного канала входа данных в вычисления».
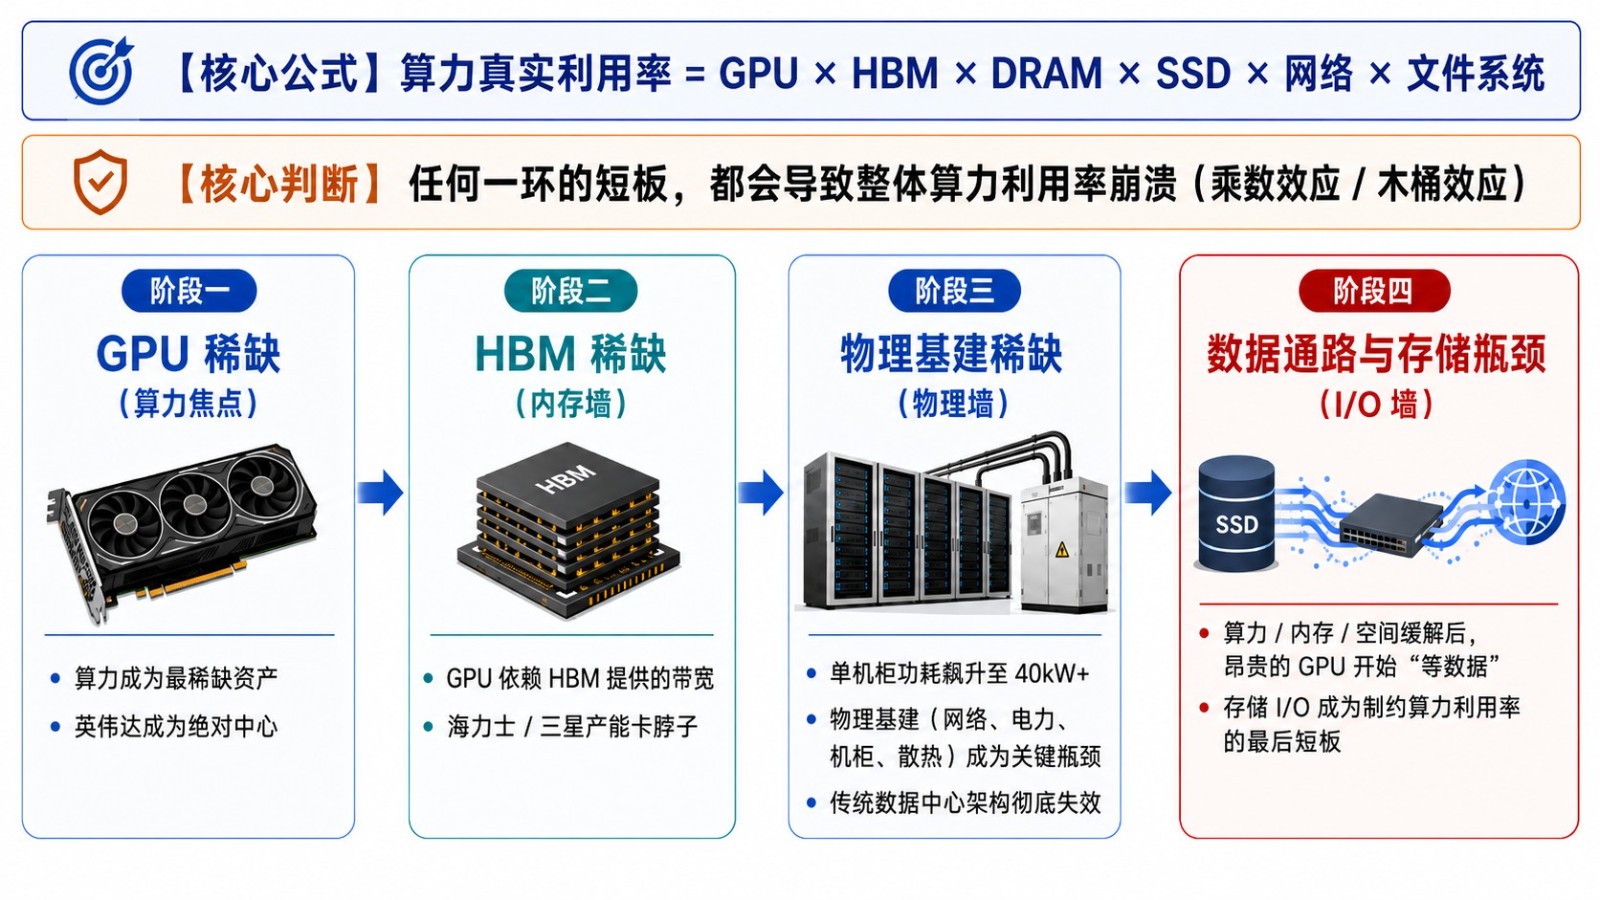
Эволюция узких мест в ресурсах инфраструктуры ИИ по своей сути является борьбой за устранение слабых звеньев. Реальная утилизация вычислительных мощностей — это не линейная сумма отдельных активов, а строгий мультипликативный эффект: реальная утилизация = GPU × HBM × DRAM × SSD × сеть × файловая система. Любой недостаток одного из компонентов приводит к краху общей утилизации мощности. В эпоху ИИ хранение впервые превратилось из «центра затрат» в «двигатель эффективности». Вот в чем лежит фундаментальная логика его новой оценки.
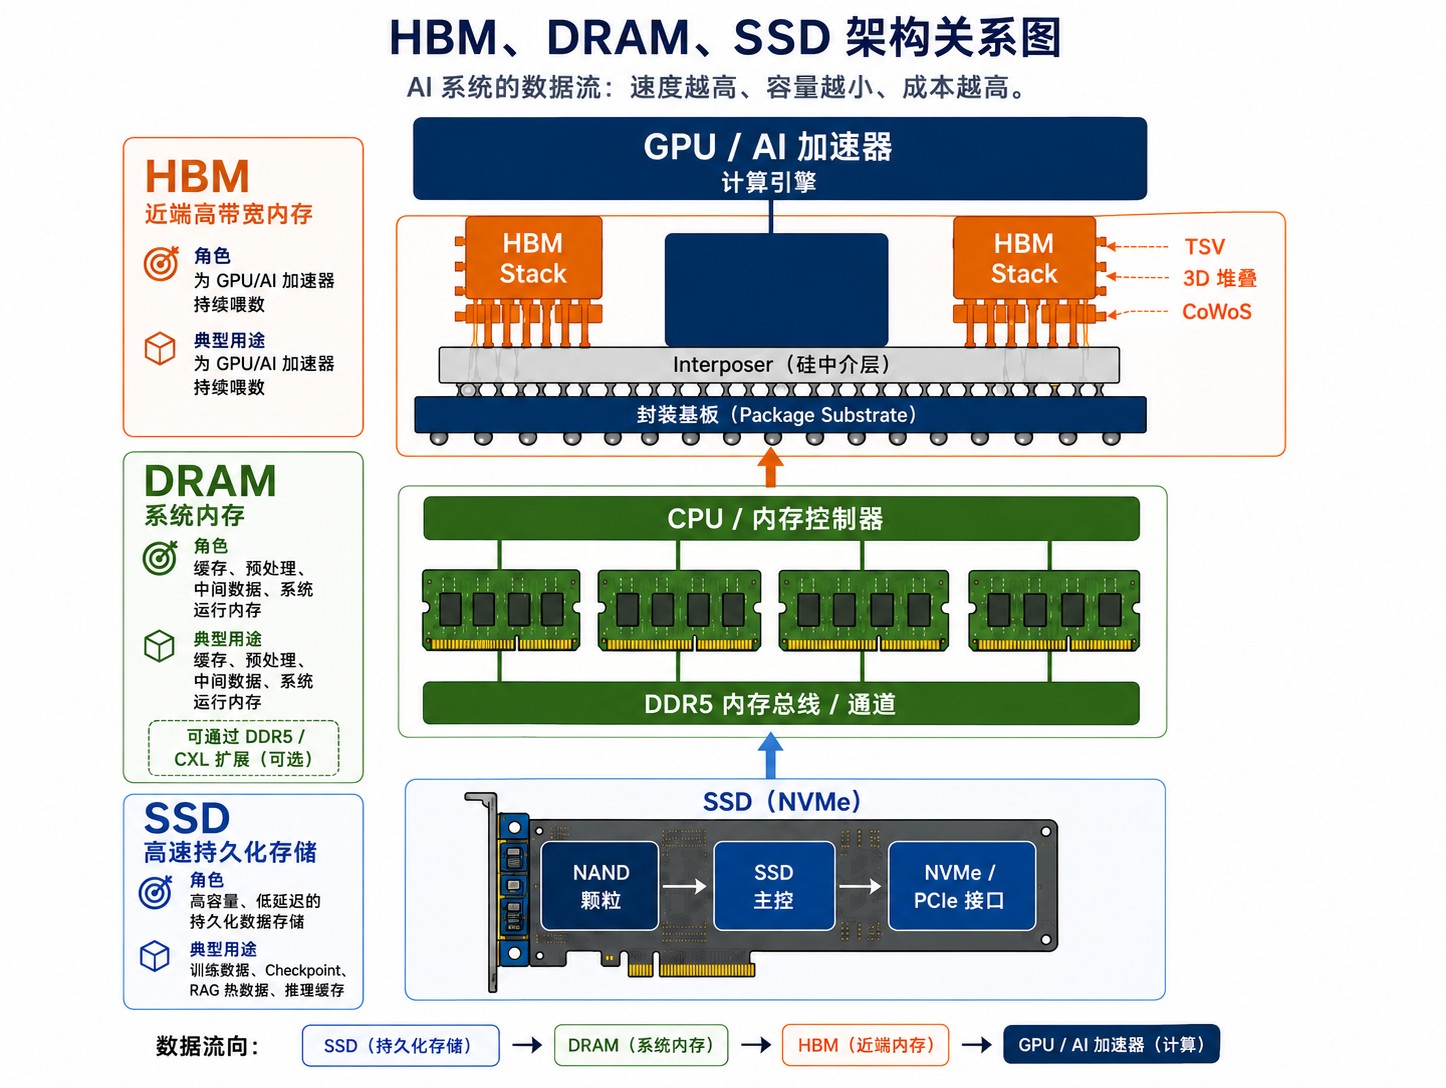
Архитектура AI-хранилищ в полном объеме: от органа пропускной способности HBM до базы озер данных
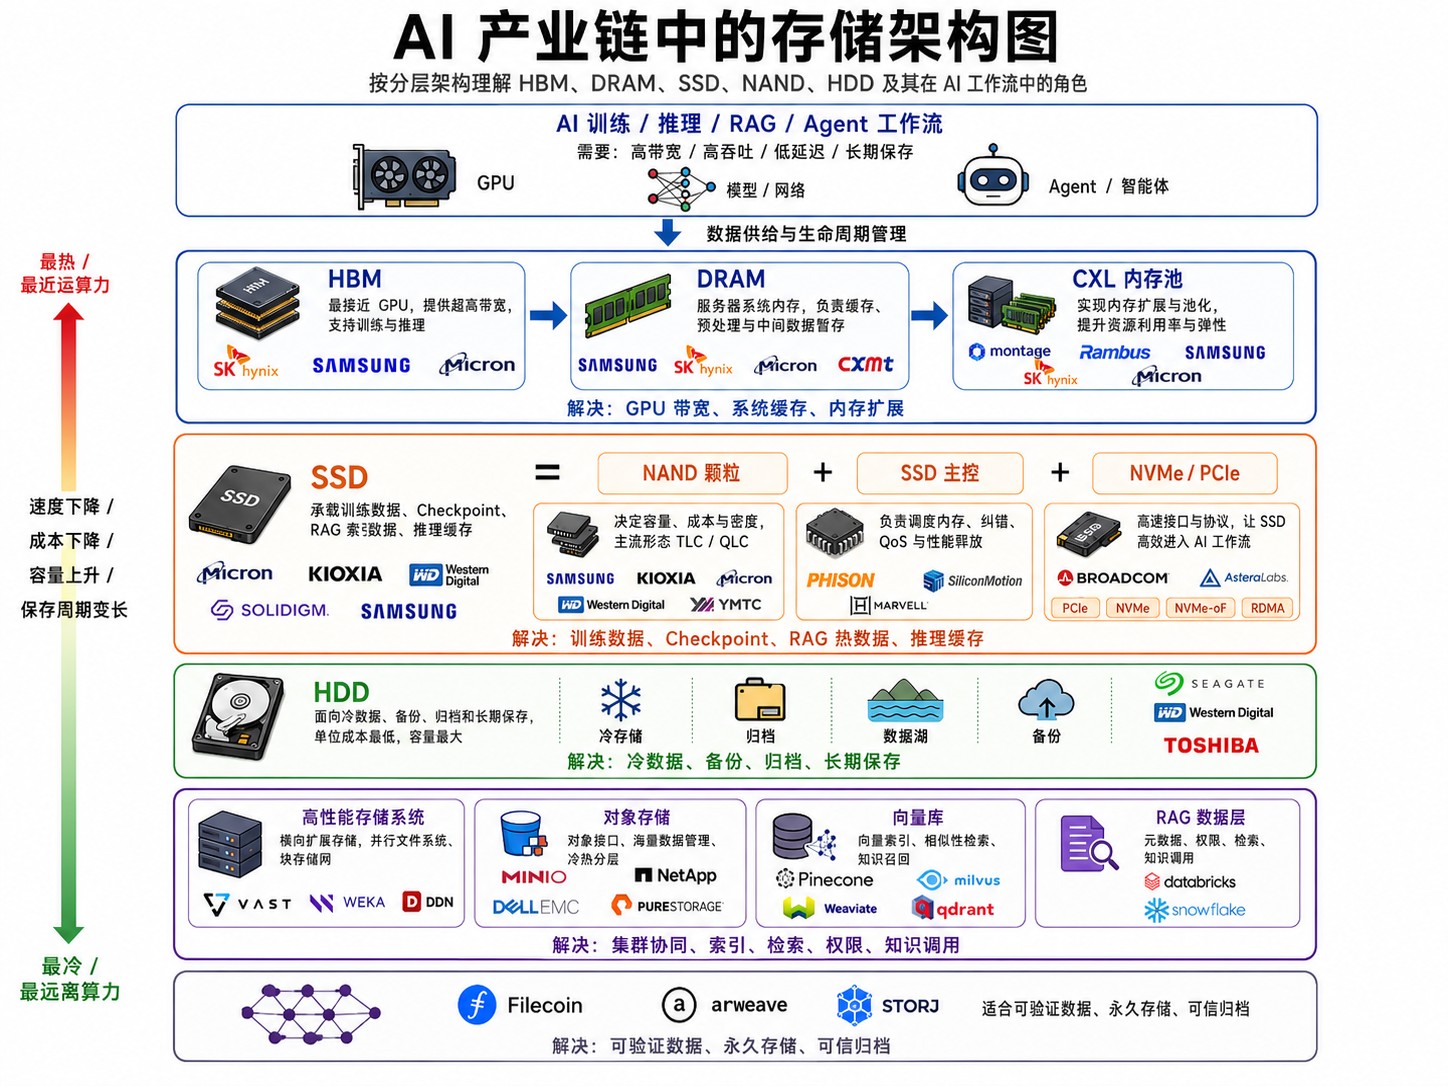
Хранилища для ИИ — это далеко не просто совокупность аппаратных средств, а тесно связанная, многоуровнево управляемая сложная система. В этой системе промышленная добавленная стоимость и фокус капитала концентрируются на HBM, корпоративных SSD, контроллерах SSD, протоколах NVMe/CXL и высокопроизводительных системах хранения. Для четкого разбора потоков ценности мы разделим архитектуру AI-хранилищ сверху вниз на четыре ключевых уровня:
- Уровень памяти рядом с вычислениями (ядро пропускной способности): Опирается на абсолютного лидера — HBM, дополненного DRAM и технологиями пула памяти на базе CXL. Данный уровень напрямую примыкает к корпусам или шинам GPU/CPU, стремясь преодолеть «стену памяти» и являясь первым рубежом определения того, будет ли утилизация вычислений раскрыта в полной мере.
- Уровень высокоскоростного персистентного хранения (центр IO): Базовая формула здесь такова: корпоративный SSD = чипы NAND + контроллер SSD + канал передачи данных NVMe/PCIe. Этот уровень принимает частые записи контрольных точек, загрузку массивов обучающих данных и кэширование горячих данных RAG, являясь самым очевидным источником прироста персистентного хранения в дата-центрах ИИ.
- Уровень дешевого хранения большого объема (база емкостей): Состоит из HDD, холодного хранения и систем архивирования озер данных. Перед лицом экспоненциально растущих мультимодальных исходных данных, исторических журналов и регламентированного резервного копирования этот уровень по-прежнему обеспечивает незаменимое преимущество по TCO (общей стоимости владения).
- Системы и программное обеспечение AI-хранилищ (координационный мозг): Включают высокопроизводительные параллельные файловые системы, распределенное объектное хранилище, векторные базы данных и уровень управления данными RAG. ИИ потребляет вовсе не голые «железки», а доступность данных, эффективно организованную, проиндексированную и ограниченную правами доступа через программный стек.
- В качестве экосистемного расширения децентрализованное хранение не участвует напрямую в гонке скорости миллисекунд для горячих данных ИИ, а вместо этого фокусируется на верификации публичных наборов данных, отслеживании происхождения (Provenance) обучающих данных ИИ и долгосрочном архивировании холодной памяти, закрепляя за собой уникальный экосистемный статус «надежного холодного уровня».
HBM: самый близкий к вычислениям «орган пропускной способности» в цепи AI-хранилищ
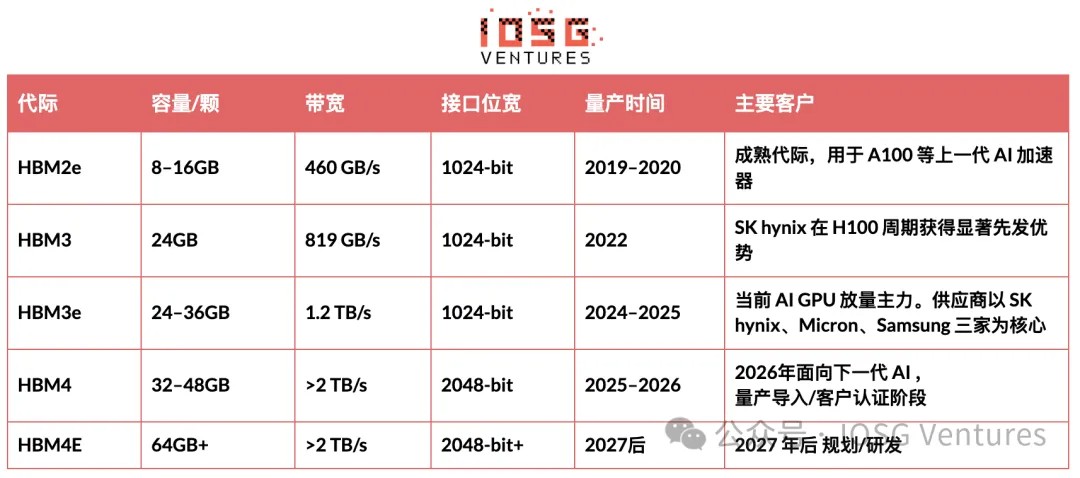
High Bandwidth Memory (HBM) — это не традиционное хранилище, а слой памяти с высокой пропускной способностью рядом с GPU. Его основная задача — не сохранение данных, а постоянная «подкормка» вычислительных мощностей данными с экстремальной скоростью. HBM является самым близким к вычислениям и наиболее детерминированным звеном в цепи хранения ИИ, напрямую определяя, сможет ли GPU быть «полностью загружен», и в настоящий момент представляет главный узкий место в цепочке поставок.
Базовая архитектура HBM базируется на «3D-стэкировании DRAM + передовой упаковке 2.5D»: за счет вертикального стэкинга через TSV и гетерогенной интеграции CoWoS расстояние между памятью и вычислениями критически сокращается, обеспечивая скачкообразный рост пропускной способности на поколение. Барьер отрасли заключен не только в проектировании DRAM, но и в системном инжиниринге процессов производства DRAM, TSV, сверхтонкого стэкинга, упаковки, отвода тепла, тестирования и сертификации клиентами. Дефект выхода годных в любом из этих этапов может привести к списанию всего стэка HBM.
В настоящее время лишь три гиганта — SK hynix, Samsung, Micron — способны стабильно выпускать продукцию массовыми партиями, создав тройную защитную стену из передовых технологий производства DRAM, возможностей упаковки и сертификации клиентами NVIDIA/AMD.
DRAM и CXL: база системной памяти и двигатель пулизации памяти
HBM решает проблему предельной полосы пропускания рядом с GPU, DRAM укрепляет базу системной памяти сервера, а CXL стремится преодолеть физические границы, реорганизуя способ структурирования ресурсов памяти в дата-центрах.
- DRAM: В основном выполняет функции кэширования на стороне CPU, предварительной обработки данных, временного хранения промежуточных состояний и работы системы, являясь базовым уровнем системной памяти сервера. Рынок DRAM в глобальном масштабе高度 монополизирован тремя гигантами SK hynix, Samsung, Micron; ChangXin Memory (CXMT) выступает главным фактором импортозамещения DRAM в Китае.
- CXL (Compute Express Link): Это новое поколение протоколов связи с согласованием кэша, ориентированных на дата-центры, призванное преодолеть ограничения традиционных слотов DIMM, локальной емкости памяти и изоляции ресурсов памяти сервера, продвигая эволюцию архитектуры памяти к расширению, пулизации и совместному использованию. На текущем этапе CXL находится на ранней стадии перехода от поддержки платформами к масштабному развертыванию, обладающей высокой долгосрочной архитектурной ценностью; ключевыми игроками являются Astera Labs и Montage Technology.
Корпоративные SSD: центр данных, построенный из NAND, контроллеров и NVMe
Корпоративные SSD представляют собой самое главное расширение персистентного хранения с высокой пропускной способностью в дата-центрах ИИ. Обеспечивая огромную скорость, сверхнизкую задержку и стабильный QoS, они непрерывно «подкармливают» данные в GPU, сопровождая полный жизненный цикл от загрузки обучающих данных и записи контрольных точек, поиска RAG, кэширования вывода (inference) до обратной передачи логов.
В архитектуре AI-хранилищ SSD не является изолированным оборудованием, а представляет собой тесно связанную систему, которую можно свести к отраслевой формуле: корпоративный SSD = чипы NAND + контроллер SSD + канал передачи данных NVMe/PCIe. Три компонента представляют независимые сегменты отрасли:
- Чипы NAND (слой сырья): Определяют плотность хранения и себестоимость единицы, контроллер управляет высвобождением производительности и управлением сроком службы. Представители: Samsung, SK hynix (Solidigm), Micron, Kioxia, Western Digital, ChangXin Memory.
- Контроллер SSD (слой усиления производительности): Определяет высвобождение скорости, исправление ошибок, стабильность QoS и балансировку износа. Представители: Phison, Silicon Motion, Marvell, Maxio.
- NVMe/PCIe (слой канала передачи данных): Определяет скорость передачи данных от хранения к вычислениям. В сочетании с технологией GPUDirect Storage, снижая участие bounce buffer в памяти CPU и самого CPU, существенно снимает узкое место ввода/вывода. Представители: Broadcom, Marvell, Astera Labs.
HDD / холодное хранение / архив: дешевая база озера данных ИИ
ИИ не уничтожит HDD. По мере возрастающего желания многомодельных больших моделей к видео и графическим данным, а также экспоненциального роста корпоративных журналов соблюдения нормативов и исторических наборов данных, спрос на дешевое холодное хранение синхронно взлетает. В архитектуре AI-хранилищ SSD и HDD работают на основе дифференциации по бизнес-ценности: SSD отвечает за горячие данные и высокую пропускную способность, HDD — за низкую стоимость и долгосрочное сохранение. Представители: Seagate, Western Digital, Toshiba.
Программный стек AI-хранилищ: координационный центр доступности данных
ИИ на самом деле потребляет вовсе не голые диски, а «сервисы данных», тщательно организованные программным стеком. Эта архитектура превращает базовое оборудование в активы знаний,可直接 вызываемые верхним уровнем ИИ, конкретно разделяясь на четыре уровня:
- Высокопроизводительные системы хранения (система подачи материалов): Сфокусированы на одновременной пропускной способности и низкой задержке. Решают проблему «голода данными» кластеров GPU посредством параллельных файловых систем, гарантируя молниеносный поток для обучения и вывода. Представители: VAST Data, WEKA, Pure Storage.
- Объектное хранилище (озеро исходных данных): Базируется на управлении Object, Key и Metadata, принимая огромные объемы неструктурированных данных. Не гонится за предельно низкой задержкой, а формирует емкость базы за счет низкой стоимости и cloud-native характеристик. Представитель: AWS S3.
- Векторная база данных (слой семантического индексирования): Отвечает за хранение, индексацию и поиск векторов, сгенерированных моделями embedding, позволяя ИИ точно локализовать релевантный контент среди колоссального объема знаний. Представители: Pinecone, Milvus.
- Слой данных RAG (слой вызова знаний): Превышает единичный поиск, включая сегментацию данных, очистку, контроль прав доступа и отслеживание цитирования, гарантируя безопасное, точное и прослеживаемое использование корпоративных данных большими моделями. Представитель: Databricks.
От горячего хранения ИИ к децентрализованной холодной памяти: максимизация эффективности против максимизации доверия
Хранилища для ИИ — это система, движимая предельной эффективностью, где функция ценности сфокусирована на максимальной отдаче вычислений. Пропускная способность HBM определяет, будет ли загружен GPU, throughput SSD определяет скорость чтения/записи наборов данных и контрольных точек, низкая задержка касается реального опыта использования RAG и вывода. Эти показатели в конечном итоге конвергируются в коэффициент утилизации GPU и себестоимость токена, напрямую определяя коммерческую прибыльность приложений ИИ. Конечная цель AI-хранилищ — не сохранение, а ускорение, обслуживающая продуктивность.
Функция ценности децентрализованного хранения принципиально иная. Оно задается вопросом: будут ли данные существовать через десять лет, не были ли они изменены, смогут ли противостоять точечной цензуре. Посредством криптографических доказательств и распределенной сети оно формирует открытую базу данных для общественного доступа и вечного сохранения. Его конечная цель — отстаивать абсолютную подлинность данных и независимость суверенитета, служа требованиям справедливости, устойчивости к цензуре и памяти цивилизации.
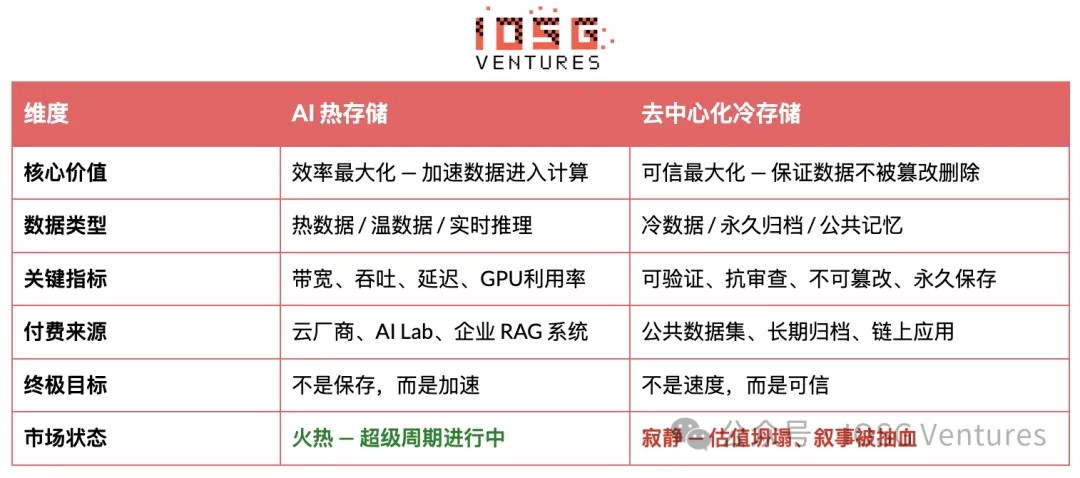
Хранилища для ИИ — это «горячее хранение», подающее топливо будущим производительным силам, тогда как децентрализованное хранение — это «холодная память», сохраняющая для человеческой цивилизации неудаляемые исторические записи. Первые служат эффективности, стремясь к предельной скорости; вторые служат доверию, отстаивая тихую память. Первые определяют, насколько быстро бежит модель; вторые — останется ли память без удаления. В настоящее время рыночный механизм вознаграждает эффективность производительности, AI-хранилища находятся на острие ветра, тогда как децентрализованное хранение, по-видимому, переживает коллапс оценки и тишину исчерпанного нарратива.
Визионерство и реальность децентрализованного хранения
Проектов децентрализованного хранения множество, но согласно отраслевому восприятию и экосистемной накопленности ключевыми представителями всегда остаются Filecoin и Arweave. Оба относятся к «децентрализованному хранению», но философия их базовых архитектур практически представляет два совершенно разных пути — первый приближается к эластичности AWS через рыночные контракты, второй подходит к вечности библиотеки посредством одноразового социального контракта.
- Filecoin: Построил наиболее полную проверяемую экономическую систему через PoRep и PoSt. Ему не следует продолжаться в лобовой конкуренции с AWS на потребительском рынке облачных дисков, а следует переключиться на отслеживание происхождения AI-данных (Provenance), размещение публичных наборов данных и соблюдение нормативного архивирования, обеспечивая проверяемый блокчейн для аудита моделей и подтверждения авторских прав. Единственный правильный путь — обернуть его в API, совместимый с S3, и поддержку платежей фиатными валютами, трансформируясь с «дешевого рынка хранения» в «проверяемую вычислительную инфраструктуру».
- Arweave: Через нарратив «одноразовая оплата — вечное хранение» посредством механизмов Blockweave и SPoRA вынуждает майнеров сохранять и предоставлять быстрый доступ ко всему возможному количеству, особенно дефицитных исторических данных. Его наилучшая позиция — база публичной человеческой памяти: сохранение записей о правах человека, улик военных преступлений, культурных памятников, архивирование правовых и финансовых историй, предоставление постоянного доступа для долгой памяти агентов ИИ. Ценность Arweave не в скорости, а в способности нести культурную память сквозь циклы.
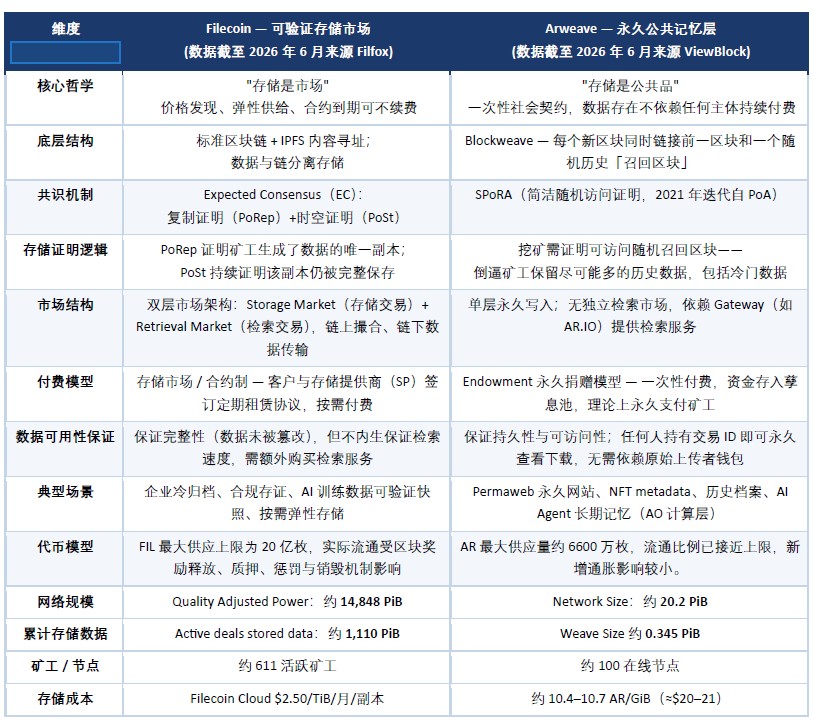
Трудности проектов децентрализованного хранения, таких как Filecoin и Arweave, заключаются не в ошибочности ценностного предложения, а в долгосрочном рассогласовании между продуктовостью, опытом получения данных, реальной потребностью и токеническим стимулированием. Это обнажает огромный разрыв между идеями энтузиастов и mainstream коммерческих приложений:
- Рассогласование стимулов предложения и спроса: Ранние сети типа Filecoin быстро расширяли емкость благодаря токенам, но не сформировали достаточно сильного платящего спроса, что привело к огромной емкости, но недостаточной утилизации и конверсии оплат. Награждается «я могу хранить», а не «это нужно хранить».
- Отсутствие корпоративного сервиса: Барьер AWS — это не диски, а «операционная система данных», составленная из API, SLA, управления правами, compliance-аудита и техподдержки. Корпорации покупают «спокойствие», а не экспериментальную инфраструктуру, требующую самостоятельной обработки ключей и выбора узлов.
- Дефицит опыта получения (Retrieval): «Записать внутрь» не означает «стабильно и низколатентно доставать». Рассеянность узлов, сложная топология, отсутствие единого SLA делают невозможным прием рабочих нагрузок горячих данных ИИ, что делает технологию более подходящей для надежного холодного архивирования и отслеживания данных.
- Недостаточная защита конфиденциальности и compliance: Приватные корпоративные данные нельзя просто так записывать в публичную вечную сеть; право на удаление и вечная неизменяемость имеют естественный конфликт. Децентрализованное хранение лучше подходит для общественных данных и долгосрочных архивов, а не для безраздельного приема критически важных приватных данных.
- Макрозагон Token-экономики: Финансиализация бычьего рынка скрывает нехватку спроса, падение ROI майнеров медвежьего рынка обнажает недостатки коммерциализации. Токены могут запустить предложение холодно, но не способны автоматически создать спрос и устойчивый доход.
Другие проекты децентрализованного хранения чаще фокусируются на специфичных экосистемах или нишевых направлениях: Storj/Sia уступают Filecoin/Arweave в межцикловом отраслевом восприятии и влиянии нарративов Web3; BNB Greenfield/Walrus связаны со специфичными экосистемами L1 BNB или SUI; Celestia/EigenDA относятся к слою доступности данных (DA), обслуживающему подтверждение транзакций Rollup, а не долгосрочное архивирование; такие проекты смешанного нарратива AI/DA, как 0G, пытаются интегрировать хранение, доступность данных, вычисления и расчеты AI-агентов в единый модульный AI-native基础设施, однако их реальная потребность, adoption разработчиков и коммерческий замкнутый цикл все еще нуждаются в проверке.
Будущие возможности децентрализованного хранения: маятник долгосрочного баланса эффективности и доверия
В период бурного всплеска технологических дивидендов капитал без ума гонится за эффективностью, наделяя активами вроде GPU, HBM высочайшей премией, в то время как主張щие «доверие и справедливость» децентрализованные хранения естественно отодвигаются на обочину. Однако исторический маятник никогда не будет оставаться на стороне эффективности. Беспрецедентные блокировки и удаление контента суперплатформами, всплеск судебных исков об авторских правах ИИ, заставляющий доказывать происхождение данных; споры о суверенитете данных из-за геополитических конфликтов; исчезновение общественных архивов из-за монопольных практик данных; а также давление аудитов регуляторов на compliance обучающих данных моделей — все эти события способны вызвать новую переоценку «надежного хранения». Будущие возможности децентрализованного хранения продолжают демонстрировать уникальную ценность по следующим направлениям:
- Provenance AI-данных: Совместно с криптографическими доказательствами формировать «сертификат происхождения данных» для реагирования на давление регуляторов и аудитов.
- Публичные наборы данных и архивы цивилизации: Закрепляться на подверженных цензуре архивах и культурном наследии, формируя незаменимую неудаляемую память.
- Надежное архивирование и юридическое заверение: Обеспечивать самоверифицируемое доказательство через хеш-запись, предоставляя цифровое заверение высокого класса.
- Интеграция технологий ZK/TEE/DID: Снять напряжение конфиденциальности, трансформировавшись из единичного «протокола хранения» в «инфраструктуру доверенных данных».
- Невидимая продуктовая траектория: Предоставлять API, совместимый с S3, и фиатное тарифицирование, позволяя пользователям напрямую приобретать сервис «надежного архивирования».
AI-хранилища и децентрализованное хранение: одно гонится за предельной эффективностью, подавая нам топливо для движения в будущее; другое отстаивает тихую память, защищая наше право оглядываться в прошлое. Текущий рынок безоговорочно вознаграждает эффективность, поэтому децентрализованное хранение кажется тихим или даже рушащимся; однако, когда эпоха ИИ дальше усилит проблемы монопольных данных, споров об авторских правах и хрупкости исторической памяти, децентрализованное хранение может встретить переоценку ценностей в образе «надежного холодного уровня». Память, которую не способен легко стереть платформа, корпорация или какая-либо одна власть, возможно, превратится из романтики идеализма и маргинальной веры в необходимую инфраструктуру.
Отказ от ответственности: В процессе создания данной статьи автор использовал вспомогательные инструменты ИИ, включая Claude Opus 4.8, ChatGPT-5.5, Qwen 3.7 и другие. Автор приложил все усилия для редактирования и обеспечения достоверности информации, однако неизбежно могут присутствовать неточности, надеемся на понимание. Следует особо отметить, что содержание данной статьи предназначено исключительно для информационной интеграции и академического/исследовательского обмена, не составляет никаких инвестиционных рекомендаций и не должно рассматриваться как рекомендация к покупке или продаже любых токенов.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 IOSG Ventures











