

Anthropic: из 700 тысяч диалогов с Claude выделили 3000 ключевых ценностей и выяснили, что Opus 4.7 наиболее осторожен, а Sonnet 4.6 — более угодлив
Автор: Anthropic
Перевод: TechFlow
TechFlow: Когда искусственный интеллект просят ответить на такие субъективные вопросы, как «стоит ли менять работу», его ответ сам по себе отражает определённые ценности. Anthropic сжала более 3000 ценностей, проявленных Claude в 700 тысяч реальных диалогов, до четырёх осей. Выяснилось, что Opus 4.7 более осторожен в вопросах рисков и более откровенен, чем предыдущие версии, а Claude, общающийся на арабском, выглядит теплее, чем английский вариант. Этот метод позволил нам впервые количественно оценить, как «личность ИИ» меняется в зависимости от способа обучения и культурного контекста.
Когда пользователь задаёт Клоуду вопрос без единственно верного ответа — например, стоит ли соглашаться на новую должность или как разрешить конфликт с другом — ответ Клоуда неизбежно отражает те или иные ценности. Мы хотим, чтобы выражаемые им ценности были кратко описаны на высшем уровне в его конституции, однако ни один документ не может предусмотреть каждое возможное проявление ценностей в миллионах ежедневных диалогов на платформе Claude.ai. Вместо этого мы стремимся сформировать в ответах Клоуда «хорошую рассудительность и здравые ценности, которые можно применять в зависимости от ситуации».
Как именно изучать ценности, выражаемые Клоудом, и то, как они меняются в разных условиях? В предыдущих работах мы проанализировали 700 000 анонимных диалогов на Claude.ai, выделили более 3000 различных ценностей в ответах Клоуда и определили частоту их проявления. Однако столь обширный перечень ценностей трудно осмыслить. В данной работе мы сделали такое исследование возможным, сводя тысячи этих ценностей к нескольким основным осям, которые захватывают ключевые паттерны в ответах Клоуда. Каждая ось представляет собой шкалу между двумя группами ценностей — например, с одной стороны находятся ценности, связанные с эмоциональной теплотой, а с другой — с тщательностью; положение Клоуда на этой шкале показывает, к каким из них он больше склонен.
Мы применили этот подход для измерения того, как ценности, выражаемые Клоудом, изменяются под влиянием двух факторов. Во-первых, мы сравнили, как эти ценности варьируются между разными моделями. Каждый вариант Клоуда отражает несколько иной подход к обучению «характера», а также множество других решений при тонкой настройке. Поскольку наш метод осей ценностей количественно оценивает ключевые различия между моделями, в конечном итоге он позволит нам связать изменения в выражении ценностей с различными решениями, принятыми в процессе обучения.
Во-вторых, мы хотели понять, насколько различается опыт пользователей при общении с Клоудом на разных языках. Наши предыдущие исследования показали, что поведение Клоуда варьируется в зависимости от языка. Метод осей ценностей позволил нам проанализировать, как меняются выражаемые им ценности в топ-20 языках, используемых на платформе Claude.ai.
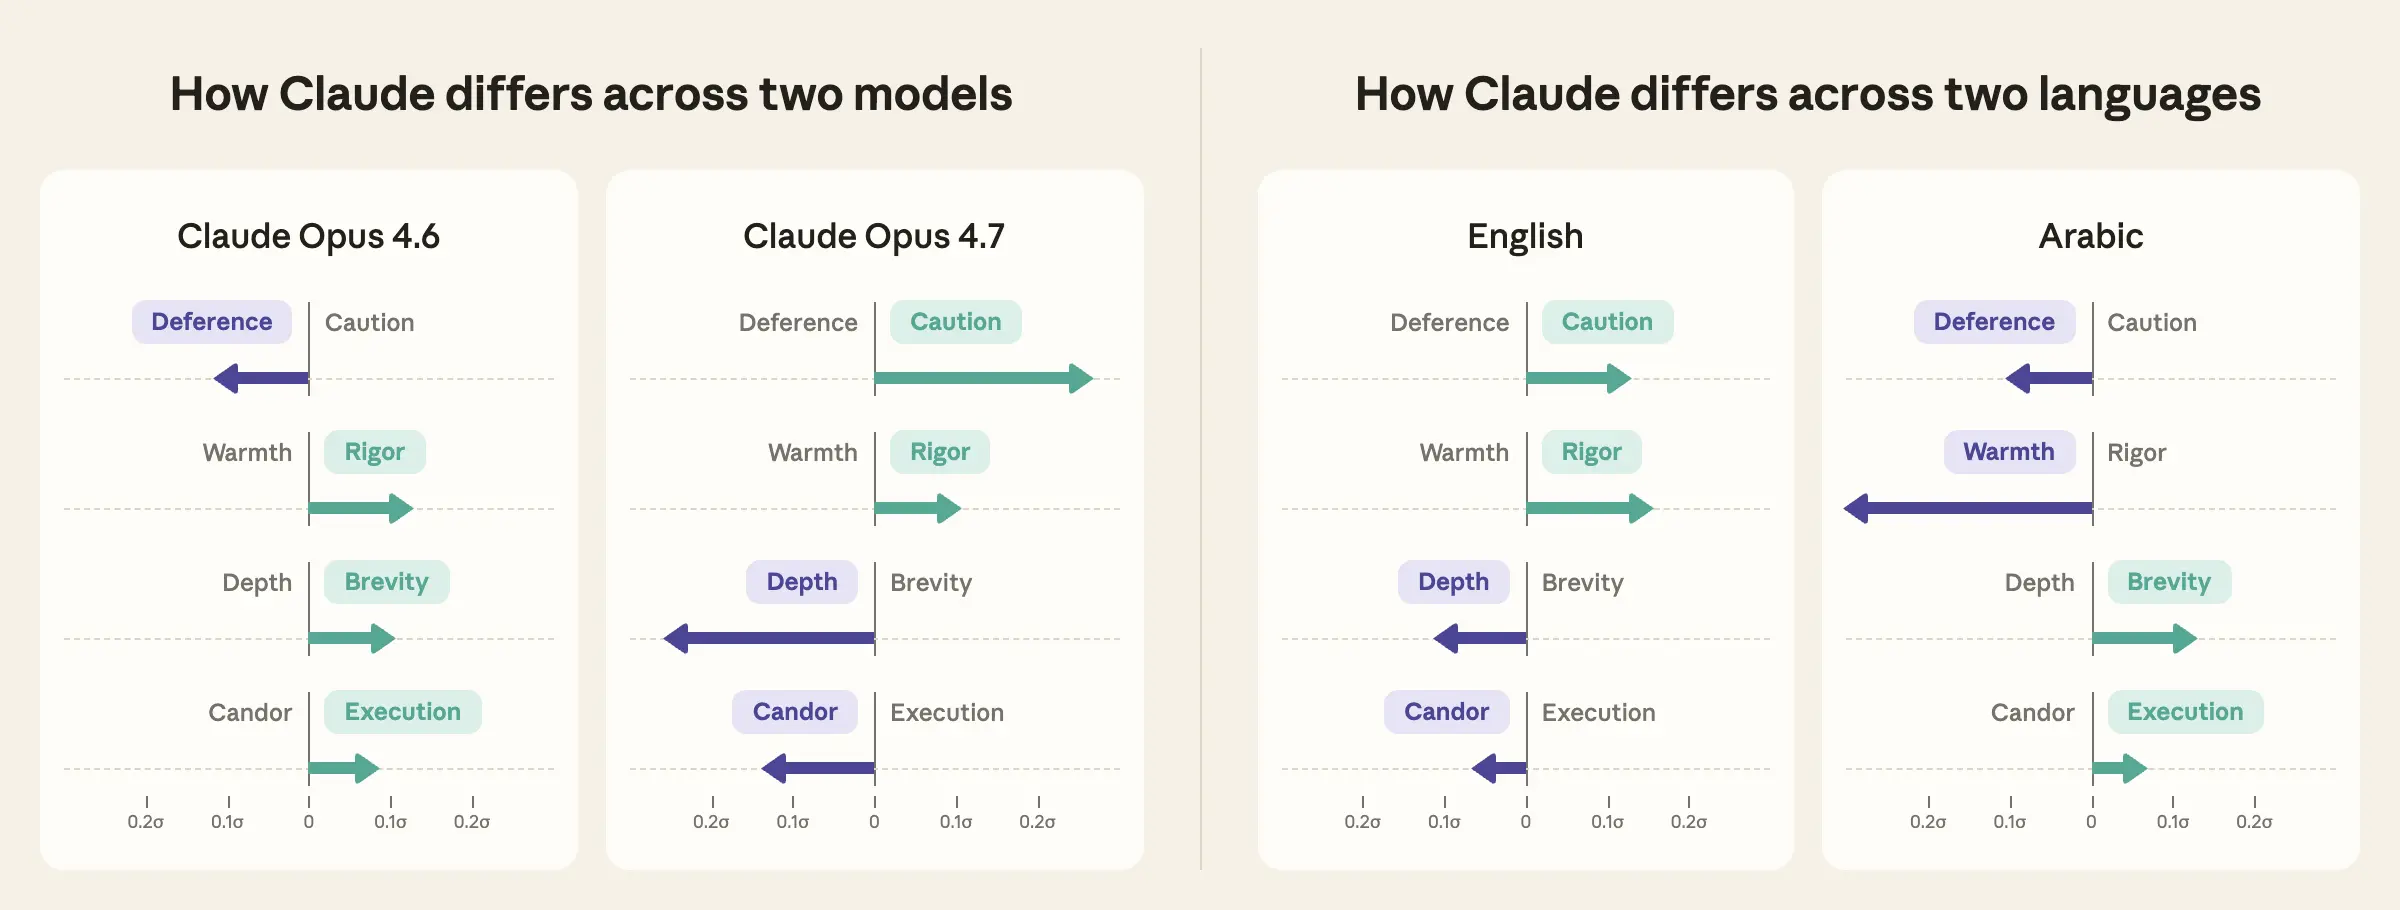
Рис. 1: Ценности, выражаемые Claude в версиях Opus 4.6 и Opus 4.7, а также в английской и арабской версиях, различаются. Opus 4.6 чаще выражает ценности, связанные со скромностью, тщательностью, лаконичностью и исполнительностью, тогда как Opus 4.7 склонен выражать ценности осторожности, тщательности, глубины и прямоты. В английской версии Claude предпочитает ценить осторожность, тщательность, глубину и прямоту, а в арабской — скромность, тепло, лаконичность и исполнительность.
Четыре ключевые оси объясняют 15% изменчивости ценностей Клоуда:
Уступчивость и осторожность: склонен ли Клоуд удовлетворять чужие ожидания или предупреждать о возможных рисках и вреде
Теплота и тщательность: склонен ли Клоуд проявлять позитивную вовлечённость и заботу либо делать акцент на точности и деталях
Глубина и лаконичность: склонен ли Клоуд давать развёрнутые объяснения или ограничиваться строго выполнением просьбы
Открытость и результат: склонен ли Клоуд открыто указывать на свои сомнения или предоставлять более проработанные и уверенные ответы
Профили ценностей на этих осях соответствуют восприятию «характера» моделей. Считается, что Sonnet 4.6 особенно тёплая, а Opus 4.7 известна своей тщательностью. Мы обнаружили, что профили ценностей каждой модели отражают эти субъективные оценки: Sonnet 4.6 чаще выражает повиновение пользователю и эмоциональную тепроту, тогда как Opus 4.7 делает больший акцент на точности, детализации и предотвращении злоупотреблений.
Ценности, выражаемые Клоудом, различаются в зависимости от языка. При общении на английском языке он акцентирует одни ценности, тогда как на португальском, индонезийском или китайском — другие. Наиболее существенные различия наблюдаются по оси «теплота и тщательность»: Клоуд чаще проявляет «тёплые» ценности на арабском и хинди, а «тщательные» — на английском и русском.
Используя этот подход, мы можем начать исследовать причины таких изменений в разных моделях и языках, а также точнее проверять, как факторы вроде обучения поведенческим нормам или культурного контекста влияют на то, какие ценности выражает Клоуд.
Как интерпретировать огромное пространство ценностей?
Наконец, наша цель — найти способ эмпирического понимания ценностей, выражаемых Клоудом, и того, как они меняются в различных ситуациях. В данном исследовании мы фокусируемся именно на том, как эти ценности варьируются между моделями и языками. В нашей предыдущей работе «Дикие ценности» было выявлено более 3000 ценностей, выражаемых Клоудом. Последовательное сравнение этих тысяч отдельных ценностей оказалось бы громоздким и скрыло бы более общие закономерности.
Чтобы упростить сравнение ценностей, мы создали оси ценностей, сведя тысячи из них к нескольким базовым размерностям на основе того, какие ценности чаще всего проявляются вместе в реальных диалогах. Например, ответы Клоуда, описываемые как «тёплые», также обычно характеризуются как «вдохновляющие» и «позитивные». Такие «тёплые» ответы реже сопровождаются чертами «тщательности» и «точности». Создание оси от тепроты к тщательности позволило нам организовать эти связанные группы ценностей — с ценностями, связанными с тепротой, с одной стороны, и ценностями, связанными с тщательностью, с другой, — и отразить важный аспект взаимодействия Клоуда с людьми в диалоге. Если в конкретном диалоге Клоуд выражает больше «тёплых», чем «тщательных» ценностей, этот диалог смещается в сторону тепроты на данной оси, и наоборот. Это не означает, что группы ценностей на противоположных концах оси взаимно исключают друг друга — Клоуд вполне может проявлять и тепроту, и тщательность в одном диалоге. Фактически же, чем больше Клоуд выражает ценностей с одной стороны оси, тем меньше он склонен проявлять их с другой. Эти оси позволяют сравнивать самые заметные группы ценностей, выражаемых Клоудом, без необходимости отслеживать изменения тысяч отдельных показателей.
Для построения осей ценностей мы начали с 3307 категорий, выделенных в «Дикой ценности», вручную сгруппировали понятия с близким смыслом, получив сокращённый список из 339 высокоуровневых ценностей. Далее, используя наши инструменты анализа с учётом конфиденциальности данных, мы выбрали выборку из 309 815 диалогов на Claude.ai, в которых пользователи давали Клоуду субъективные задания. Наша выборка в среднем охватывала три модели (Sonnet 4.6, Opus 4.6, Opus 4.7) и 20 самых популярных языков на платформе Claude.ai, что дало примерно по 5000 диалогов на каждую пару «модель-язык». Для каждого диалога инструмент использовал Клоуда для классификации каждой из 339 высокоуровневых ценностей как присутствующей или отсутствующей. Мы применили аналогичный процесс для выявления ценностей, выражаемых пользователями, а также заданий и тем диалогов. Затем мы применили методы снижения размерности — технику, которая сжимает размеченные ценности в оси на основе корреляций между теми ценностями, которые Клоуд чаще всего проявляет одновременно.
В результате мы получили четыре оси, которые захватывают основные способы изменения ценностей, выражаемых Клоудом от одного диалога к другому:
Ось «уступчивость и осторожность» сопоставляет такие ценности, как адаптивность и уважение предпочтений, с ответственным руководством и снижением вреда.
Ось «теплота и тщательность» противопоставляет ценности позитивной формулировки и поддержки точности и прозрачности.
Ось «глубина и лаконичность» сравнивает ценности нюансов и критического мышления с лаконичностью и следованием указаниям.
Ось «открытость и результат» противопоставляет честность и прозрачность ориентации на результат и оптимизации.
Чтобы убедиться, что мы измеряем именно выражаемые Клоудом ценности, а не различия в том, что или как спрашивают пользователи, мы контролировали задание, тему и ценности, выражаемые пользователем в каждом диалоге.
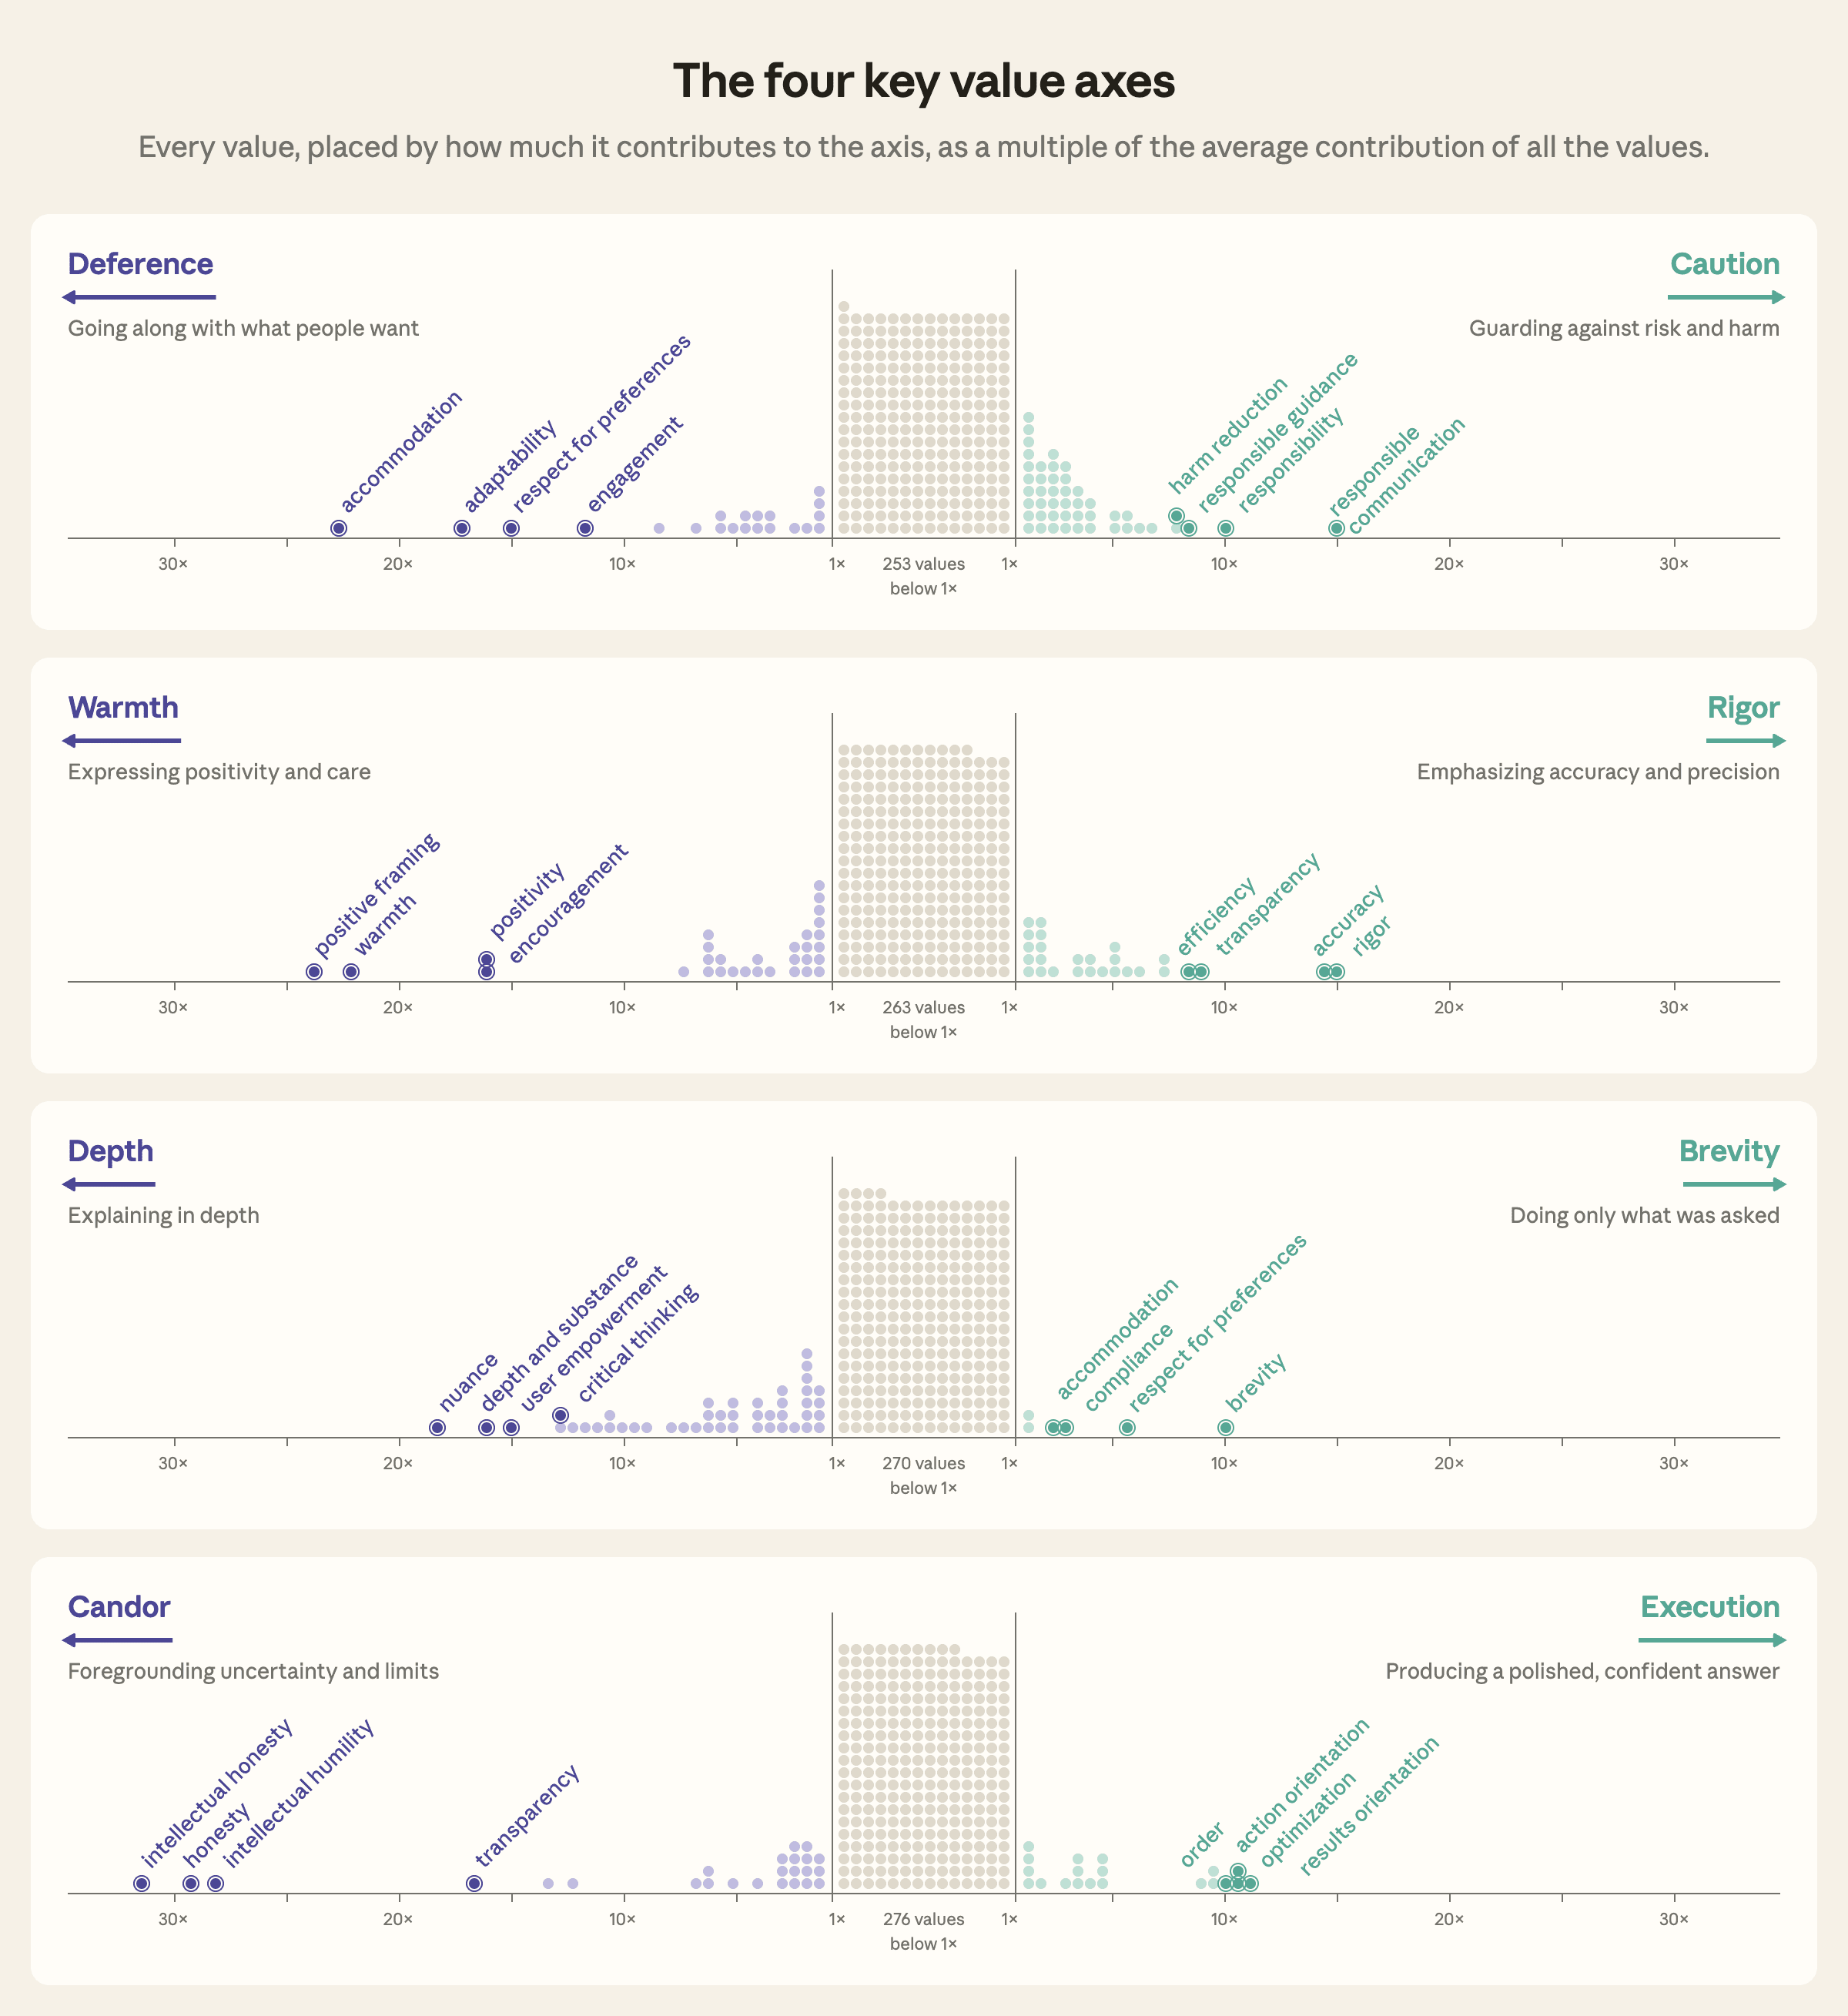
Рис. 2: Четыре оси, отражающие наибольшие различия в ценностях Клоуда. Каждая ось представляет собой числовую шкалу, соединяющую две группы значений. Положение каждого значения по данной оси определяется тем, во сколько раз его вклад превышает среднее значение; значения с наибольшим вкладом помечены. Большинство значений имеют вклад ниже среднего, что означает, что каждая ось формируется небольшим набором ключевых параметров (отмечены на рисунке).
Выражают ли разные модели Клоуда различные профили ценностей?
В этом разделе мы сравниваем ценности, выражаемые разными моделями. Для каждой модели мы усреднили позиции всех её диалогов по четырём осям, получив по одному общему значению для каждой. На выходе получается обобщённая картина, показывающая, какие группы ценностей одна модель проявляет чаще других. Эти различия малы по сравнению с вариативностью между отдельными диалогами, однако они структурированы и поддаются измерению.
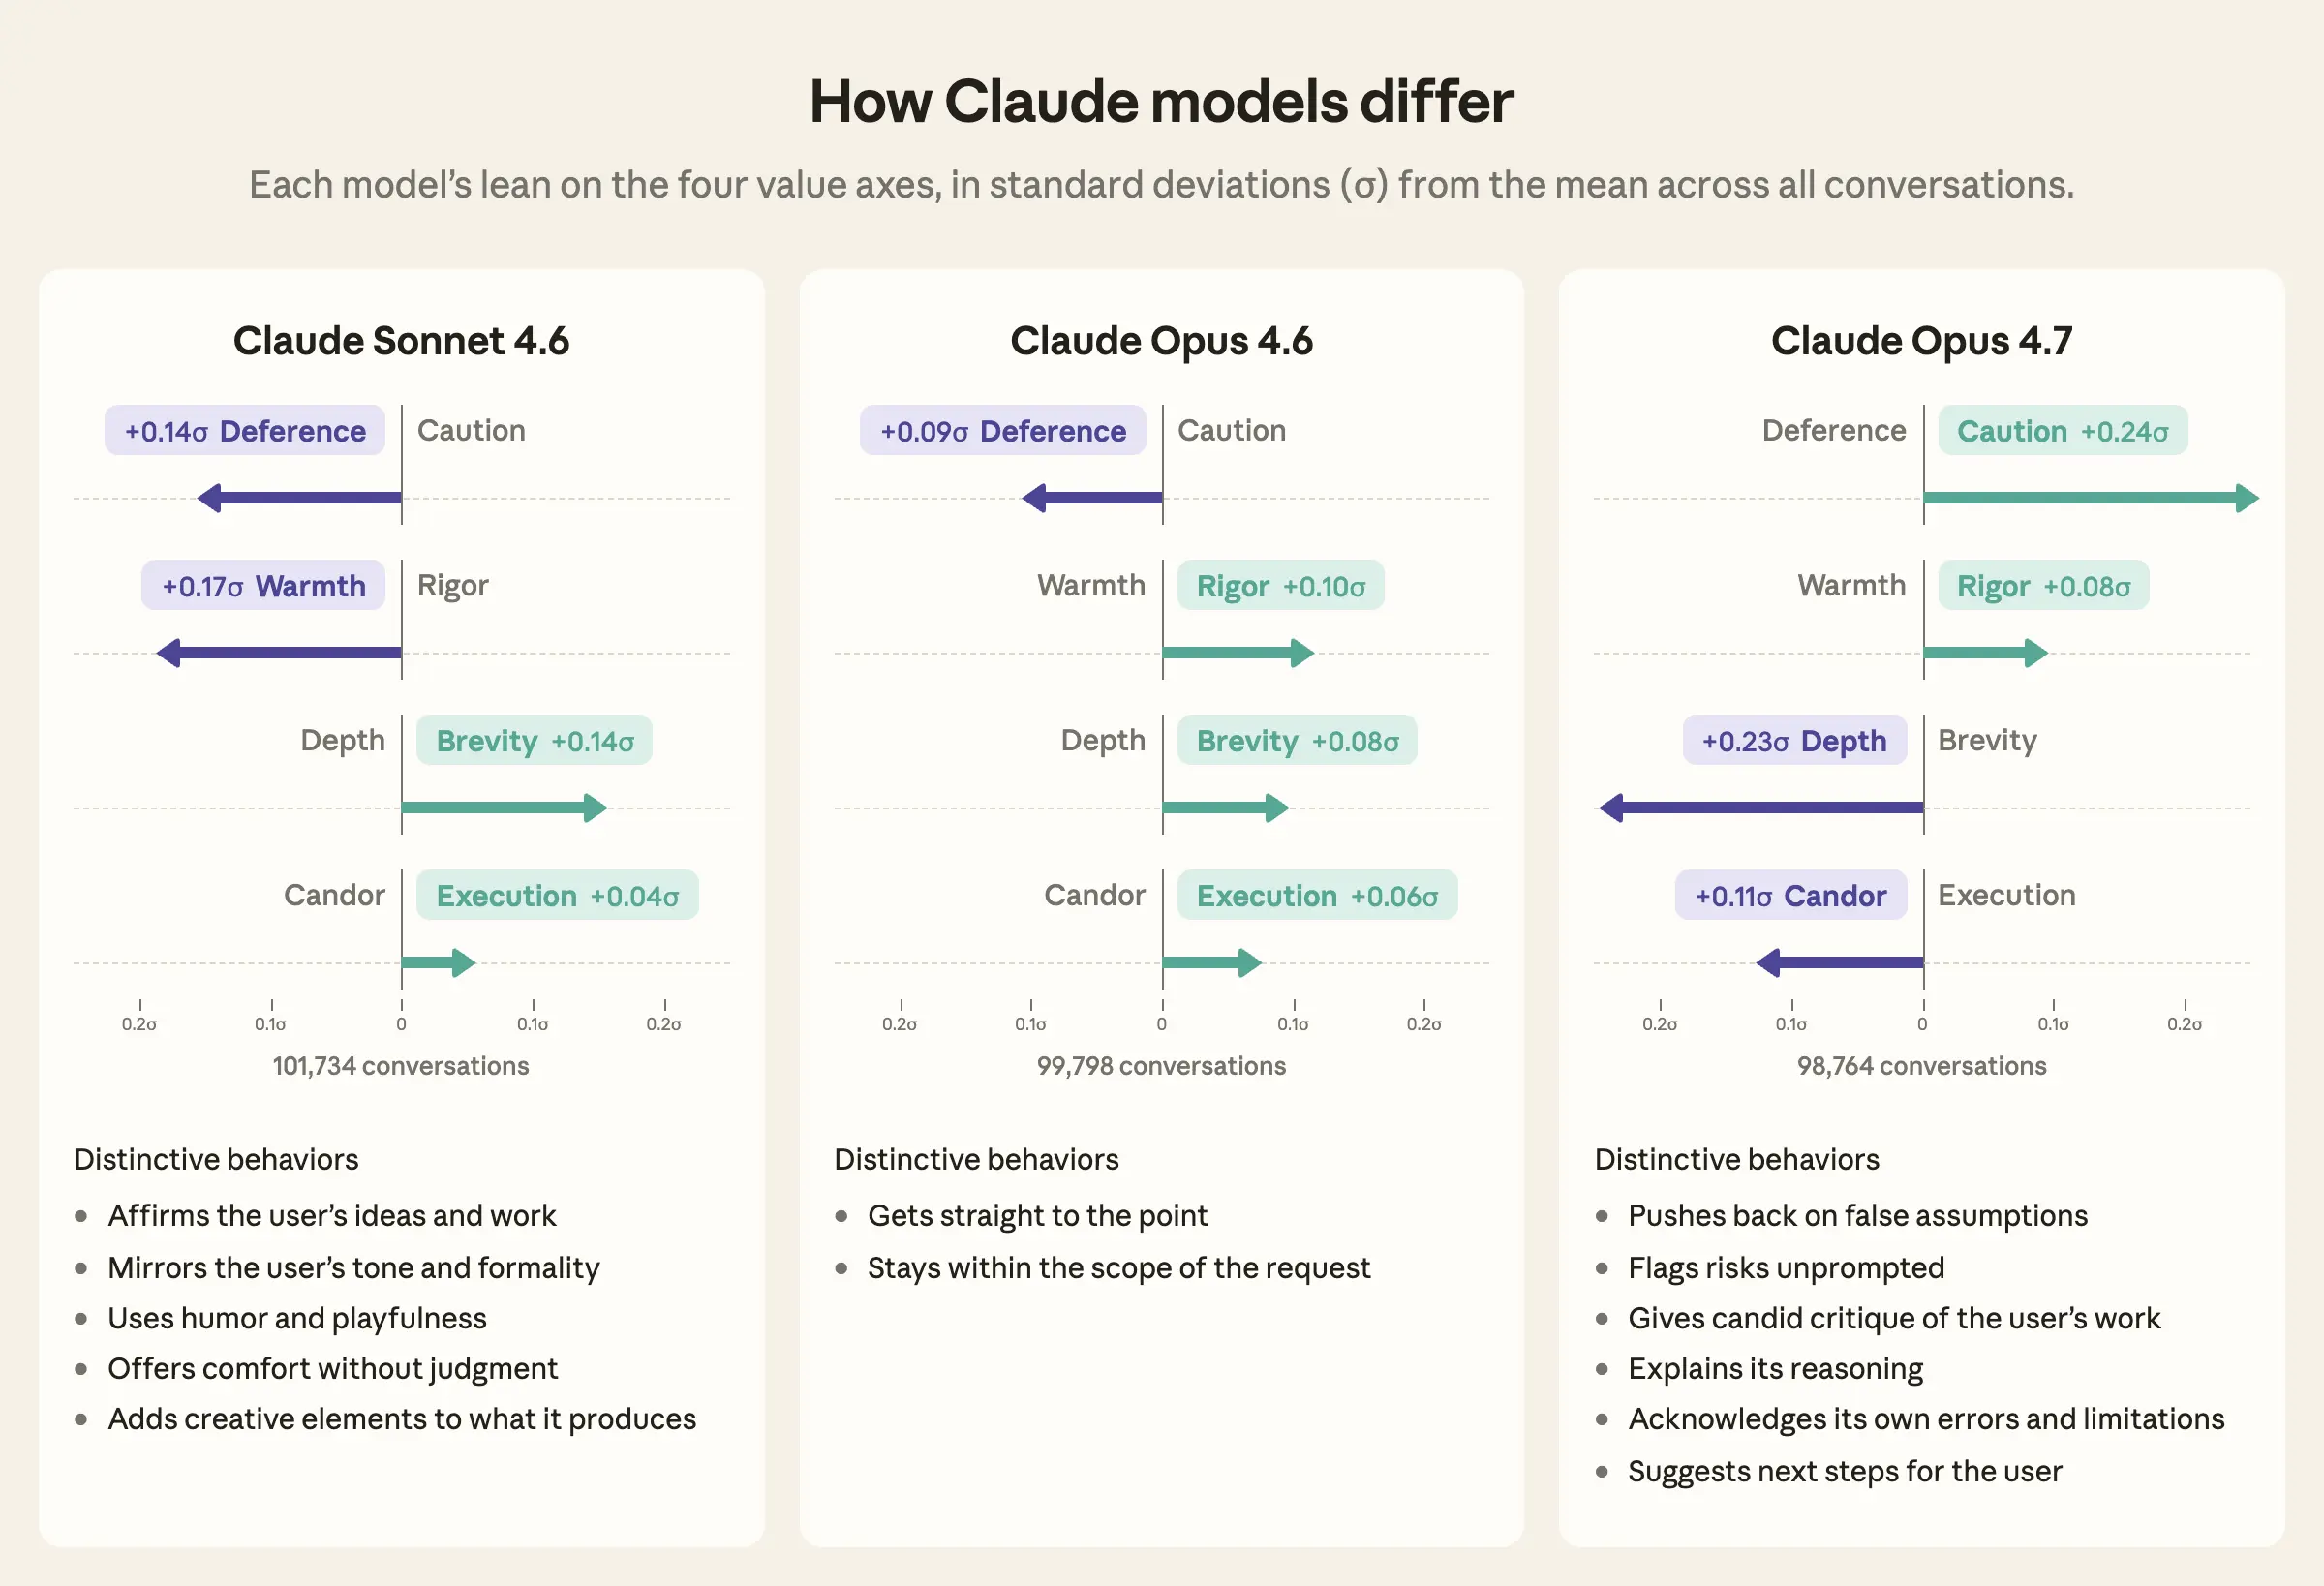
Рис. 3: Средние позиции каждой модели по четырём осям ценностей (выражены в стандартных отклонениях от среднего значения всех диалогов) и их особенности. Sonnet 4.6 склонна к энтузиазму, вежливости и лаконичности, тогда как Opus 4.7 чаще проявляет тщательность, осторожность и глубину. Opus 4.6 ориентирована на тщательность, вежливость и краткость.
Чтобы увидеть, как эти различия проявляются на практике, мы детально рассмотрели конкретные ценности, по которым модели отличаются сильнее всего. Каждый раз, когда наш приватный инструмент разметки фиксировал наличие ценности в диалоге, он также генерировал краткое описание того, как именно Клоуд эту ценность проявлял. Мы сгруппировали описания, отражающие схожее поведение внутри одной группы ценностей, и резюмировали их ниже, чтобы дать более конкретное представление о различиях между моделями:
Уступчивость и осторожность. Sonnet 4.6 чаще всего проявляет покорность в ущерб осторожности, часто поддерживая идеи и работы пользователей. Opus 4.7, напротив, выделяется осторожностью, регулярно предупреждая пользователей о потенциальных рисках.
Теплота и тщательность. Sonnet 4.6 наиболее склонна к теплоте, часто успокаивая пользователей юмором, шутками и непредвзятой поддержкой. Opus 4.7 чаще проявляет тщательность в противовес теплоте, с большей вероятностью ставя под сомнение предположения пользователей и прямо критикуя их работу.
Глубина и лаконичность. Opus 4.7 тяготеет к глубине, раскрывая логику, стоящую за своими выводами, тогда как Opus 4.6 и Sonnet 4.6 предпочитают лаконичность. Opus 4.6 особенно выделяется стремлением переходить сразу к сути.
Открытость и результат. Opus 4.7 проявляет открытость, явно указывая на свои ограничения, в то время как Opus 4.6 ориентирована на выполнение задач, стараясь строго придерживаться запрошенного формата.
Эти выводы согласуются с воспринимаемыми характеристиками моделей как внутри Anthropic, так и в сети. Пользователи Claude.ai отмечают, что Opus 4.7 чаще, чем другие модели, добавляет оговорки к своим ответам. Сотрудники Anthropic описывают Opus 4.7 как модель, демонстрирующую большую прозрачность, честность и скромность, а Opus 4.6 — как более лаконичную. В нашем посте о релизе Sonnet 4.6 мы также характеризовали её как тёплую, честную и просоциальную. Тот факт, что наши оси восстанавливают эти впечатления, свидетельствует о том, что наш метод разметки и сравнения ценностей Клоуда действительно фиксирует реальные особенности поведения моделей.
В многих диалогах пользователи могут столкнуться с разным сочетанием ценностей при взаимодействии с разными моделями Клоуда. Например, Opus 4.7 склонна давать прямую критику работ пользователя или заранее предупреждать о рисках, а Sonnet 4.6 предлагает поддержку и юмор. Подобные различия в ценностях между моделями, вероятно, формируются решениями по обучению «характера» (и другими факторами), и наш метод осей ценностей выделяет ключевые отличия в выражении этих ценностей, которые в будущем мы сможем проследить вплоть до конкретных обучающих настроек.
Различаются ли ценности, выражаемые Клоудом, в зависимости от языка?
Мы ожидали, что ценности, выражаемые Клоудом, будут варьироваться в зависимости от языка диалога по ряду причин. Во-первых, данные для обучения Клоуда на разных языках отличаются, что формирует специфику выражаемых им ценностей. Во-вторых, результаты оценки моделей, опубликованные в системных картах, уже выявили различия в знаниях Клоуда и реакции на чувствительные запросы в зависимости от языка. Количественная оценка того, как меняются выражаемые им ценности между языками, служит первым шагом к определению того, отражают ли эти различия обоснованные адаптации или требуют корректировки на этапе обучения.
Мы использовали тот же метод, что и в предыдущем разделе, для расчёта профилей ценностей Клоуда в 20 самых распространённых языках платформы Claude.ai. Ниже представлены графики профилей ценностей для ведущих языков платформы, начиная с тех, где различия в выражении ценностей максимальны.
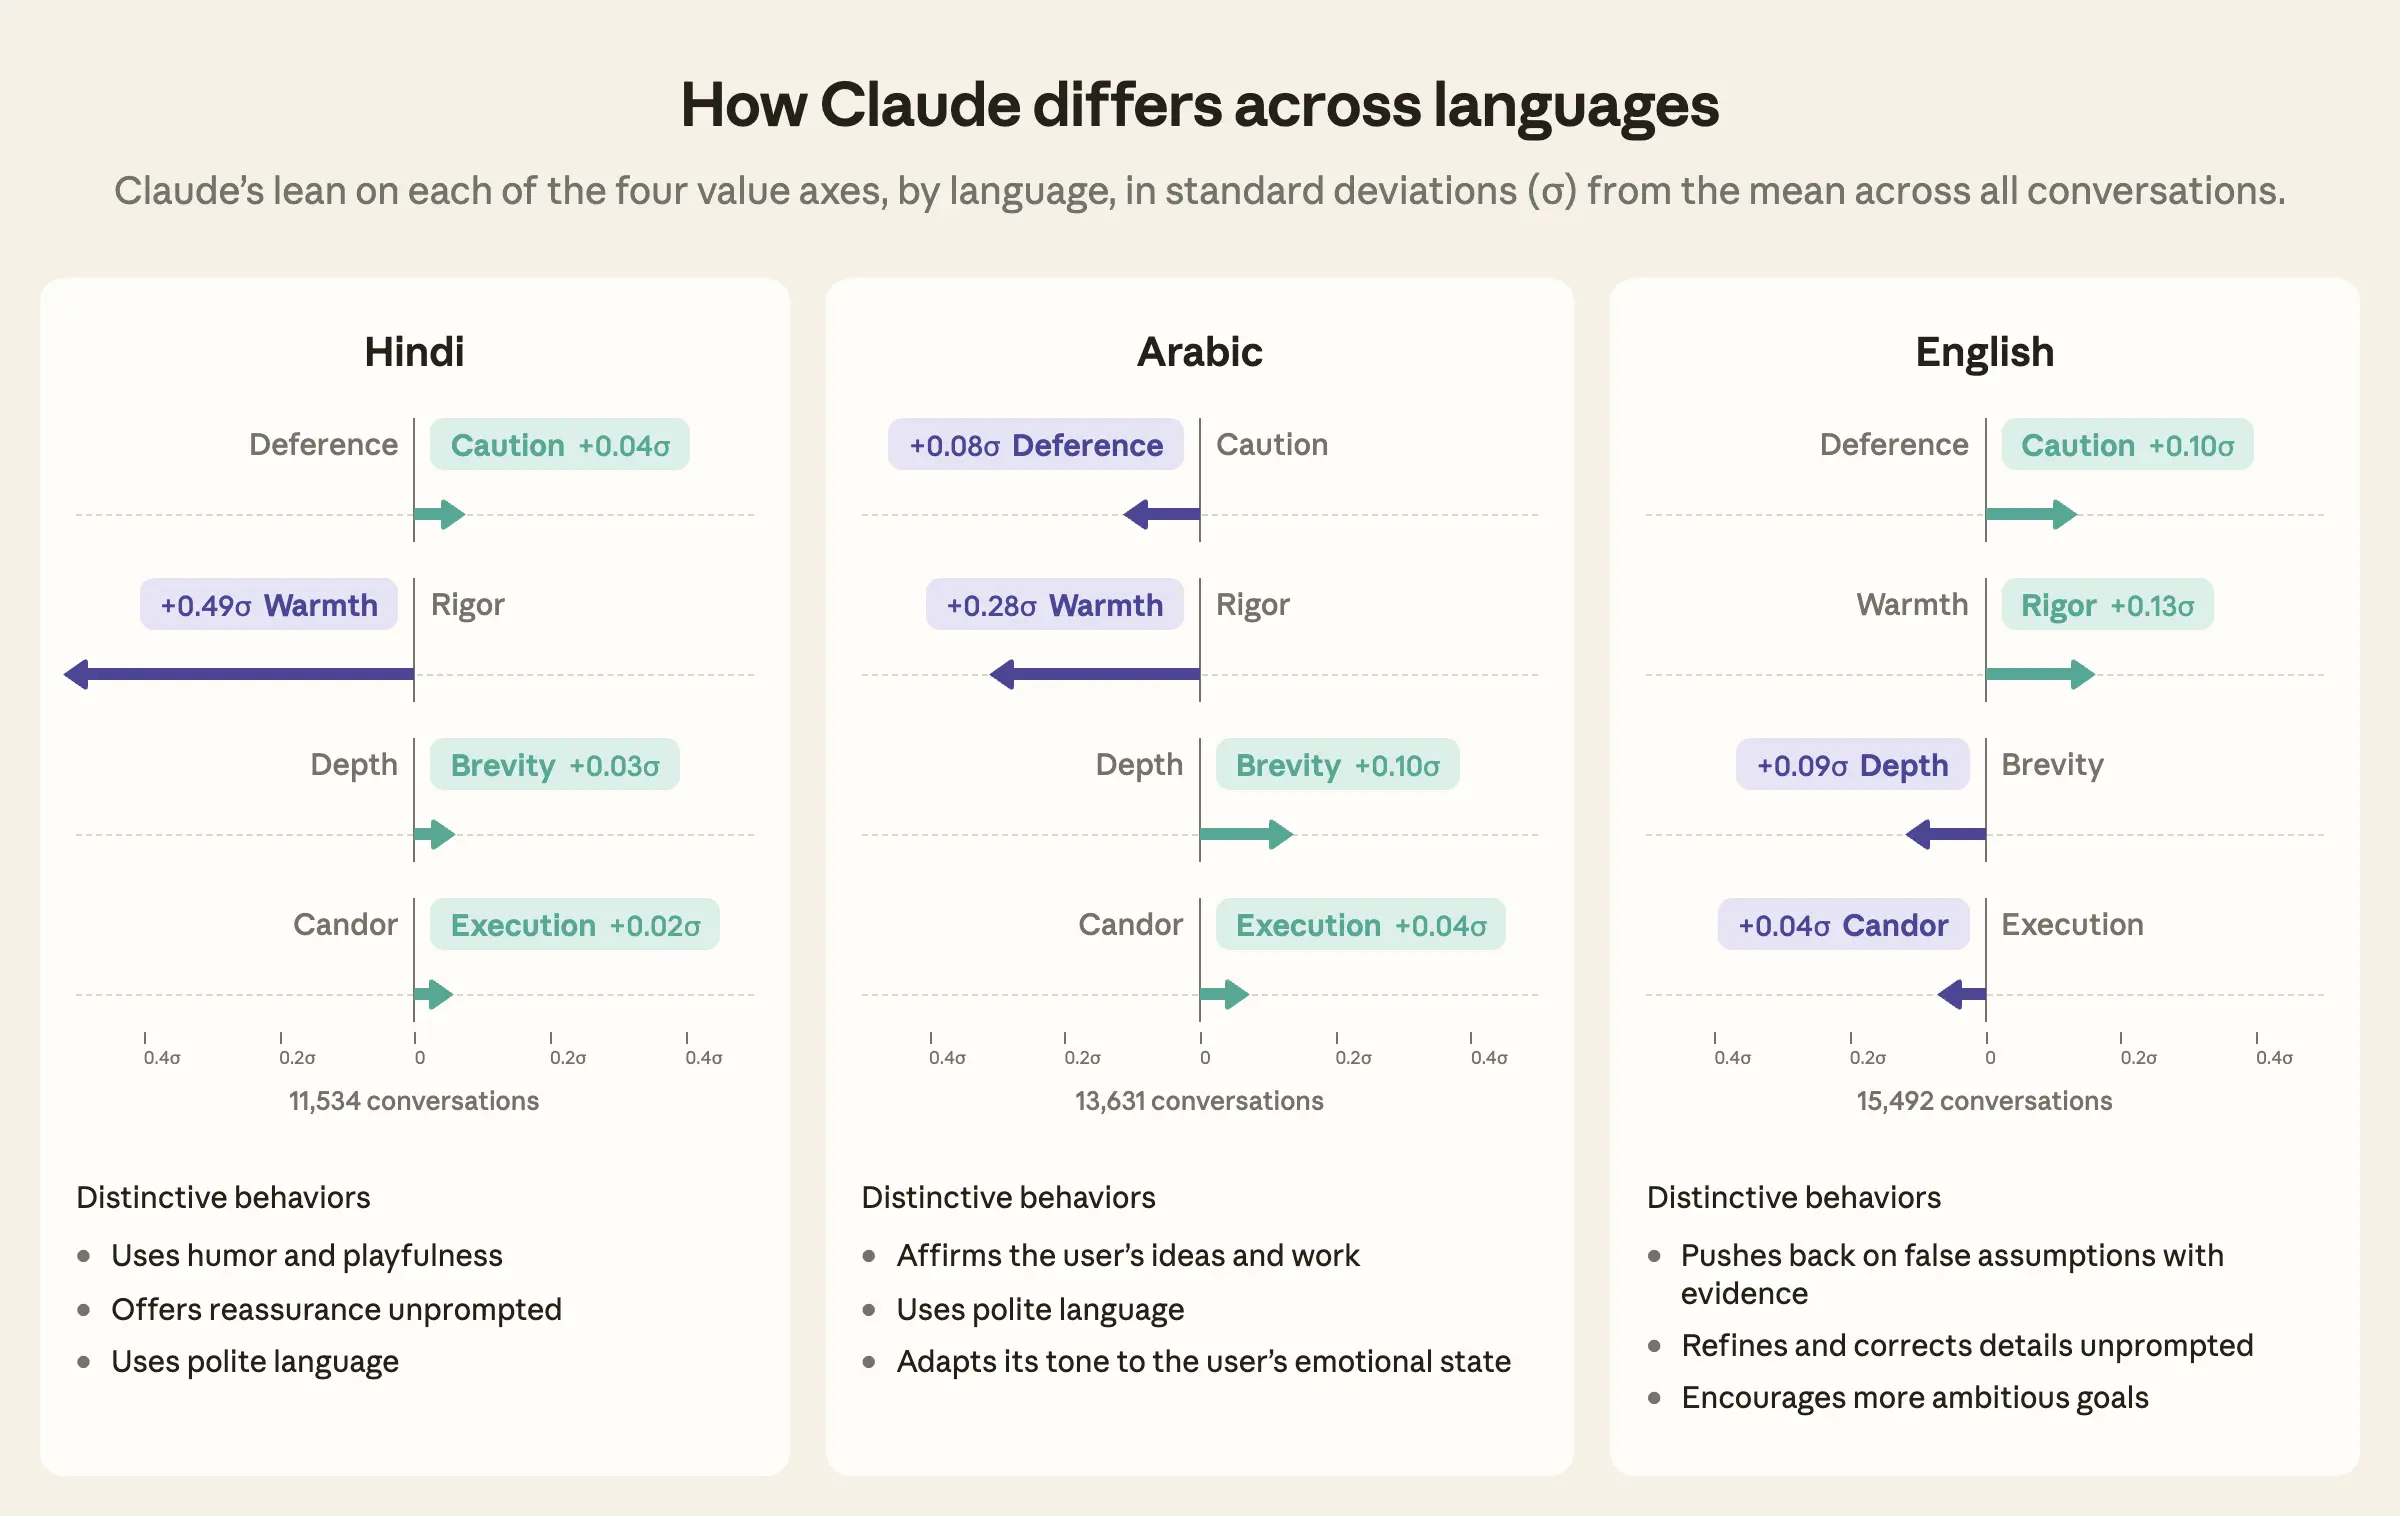
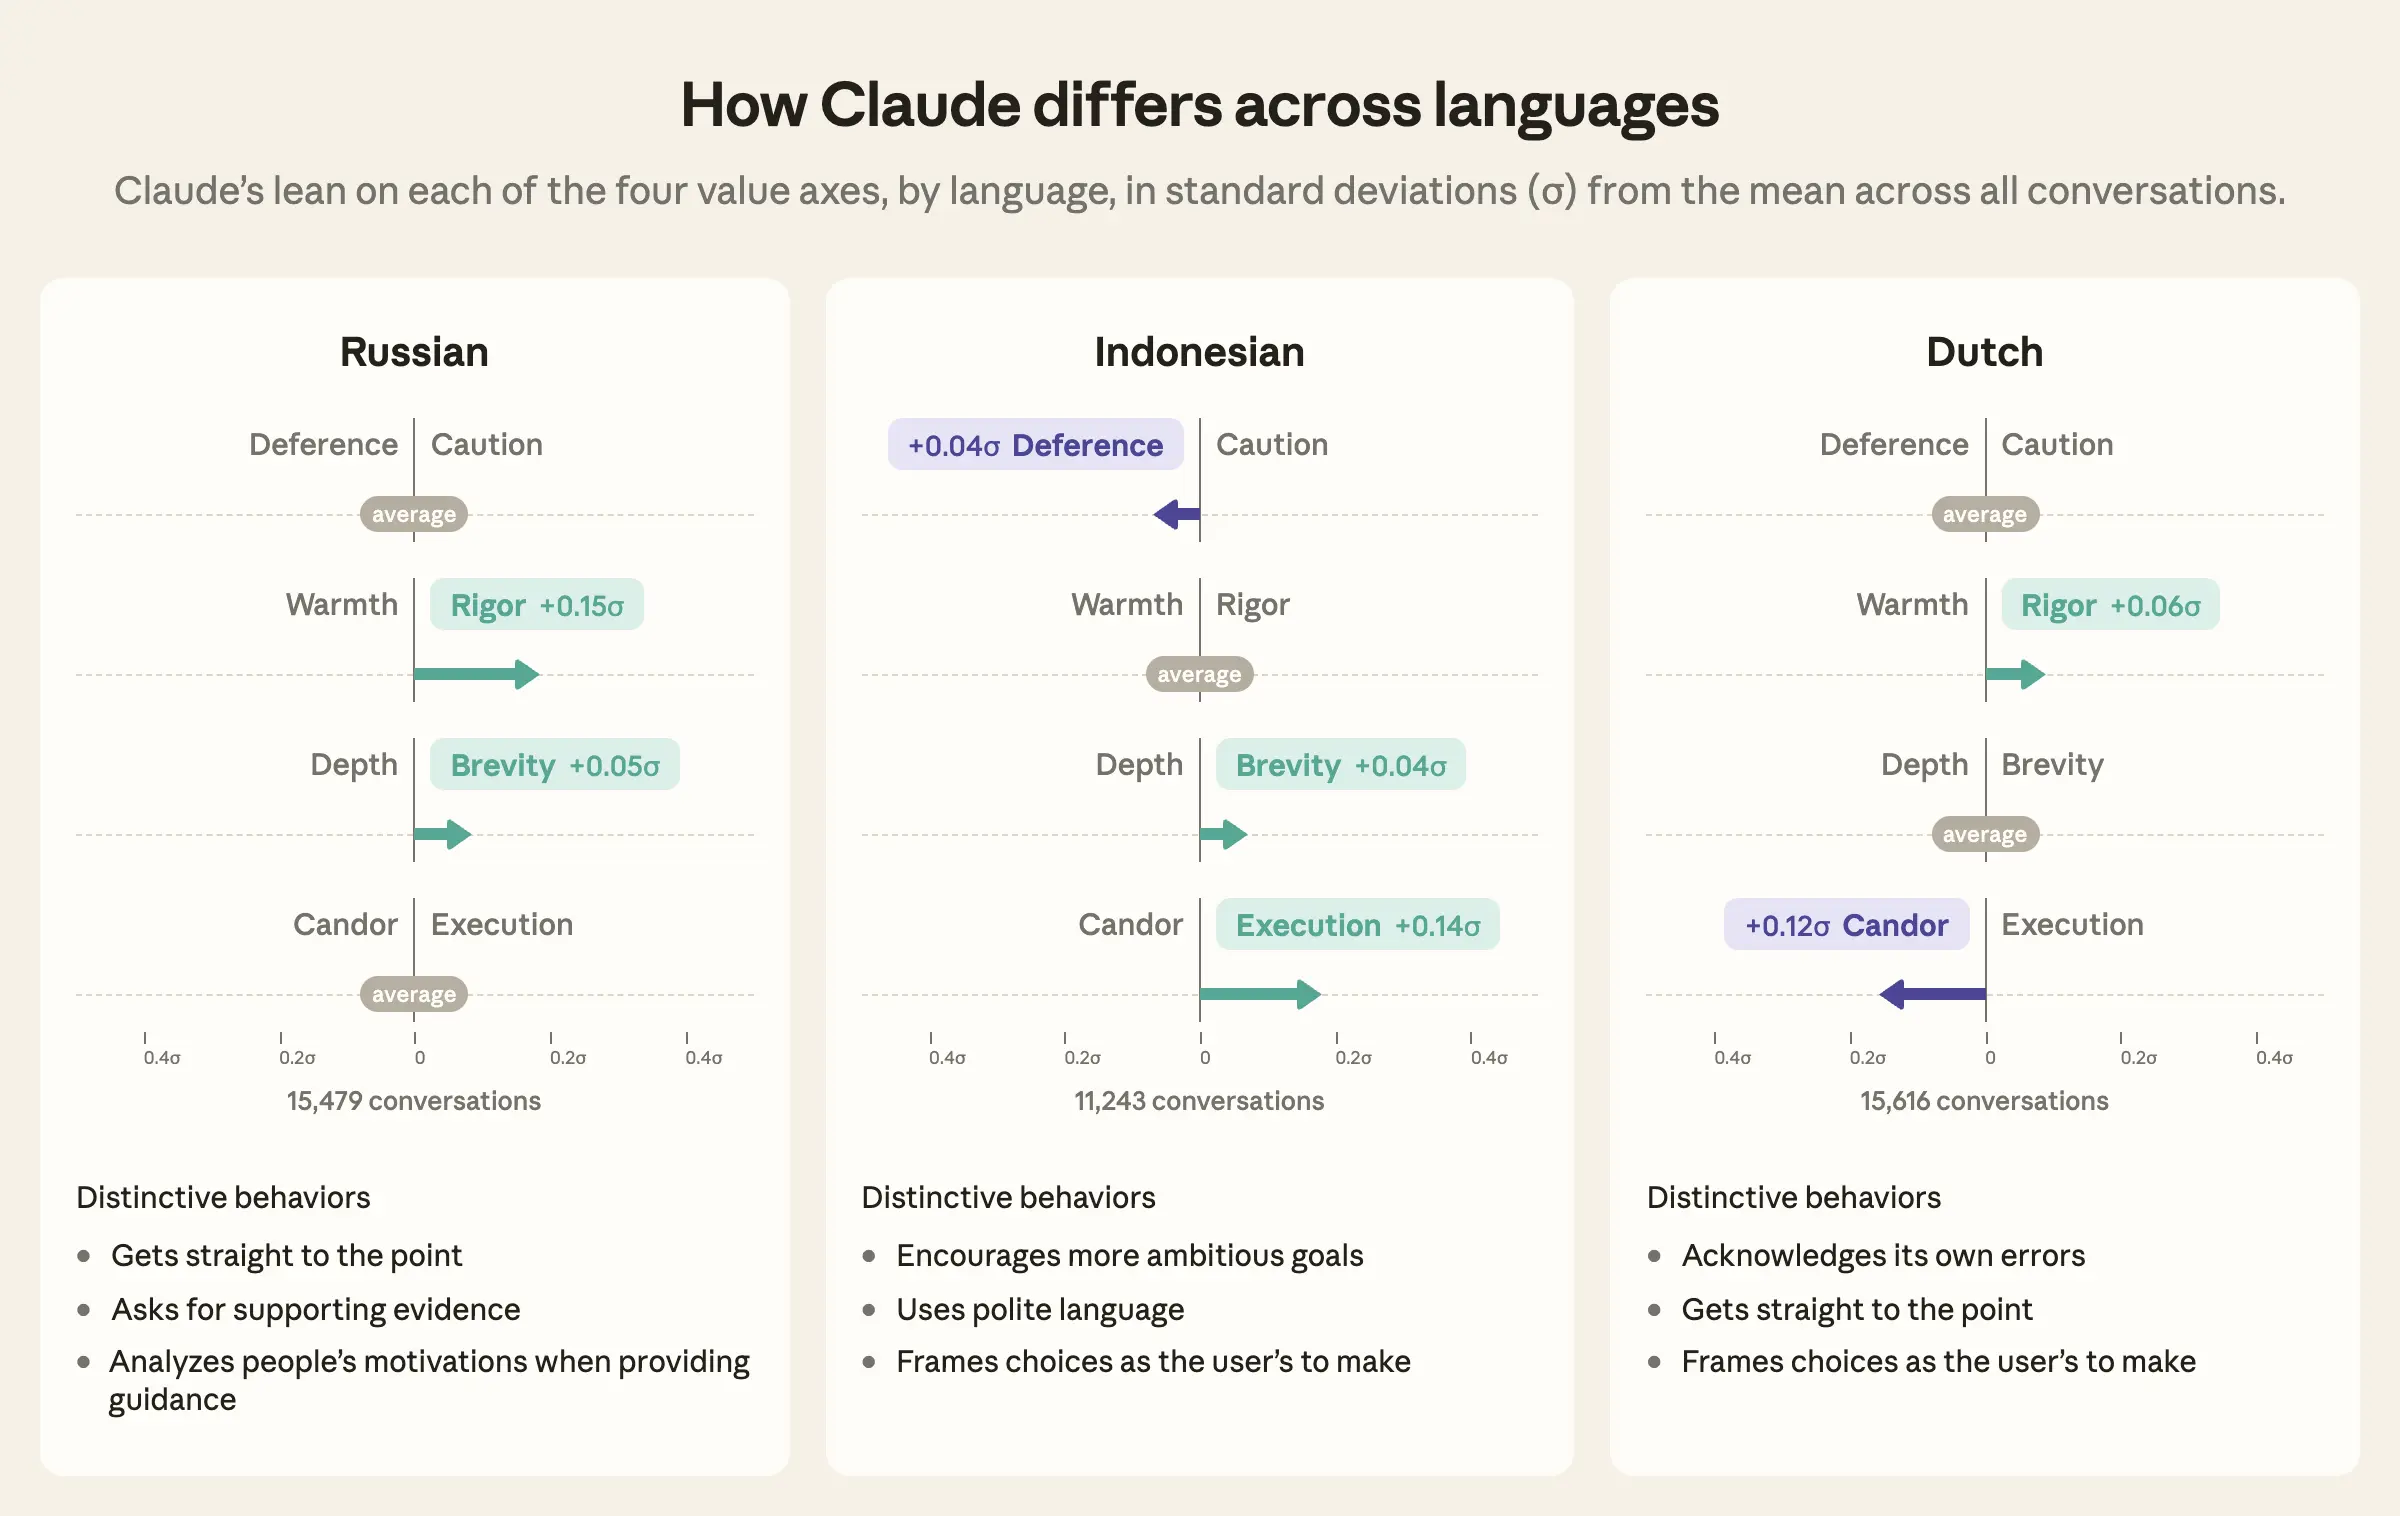
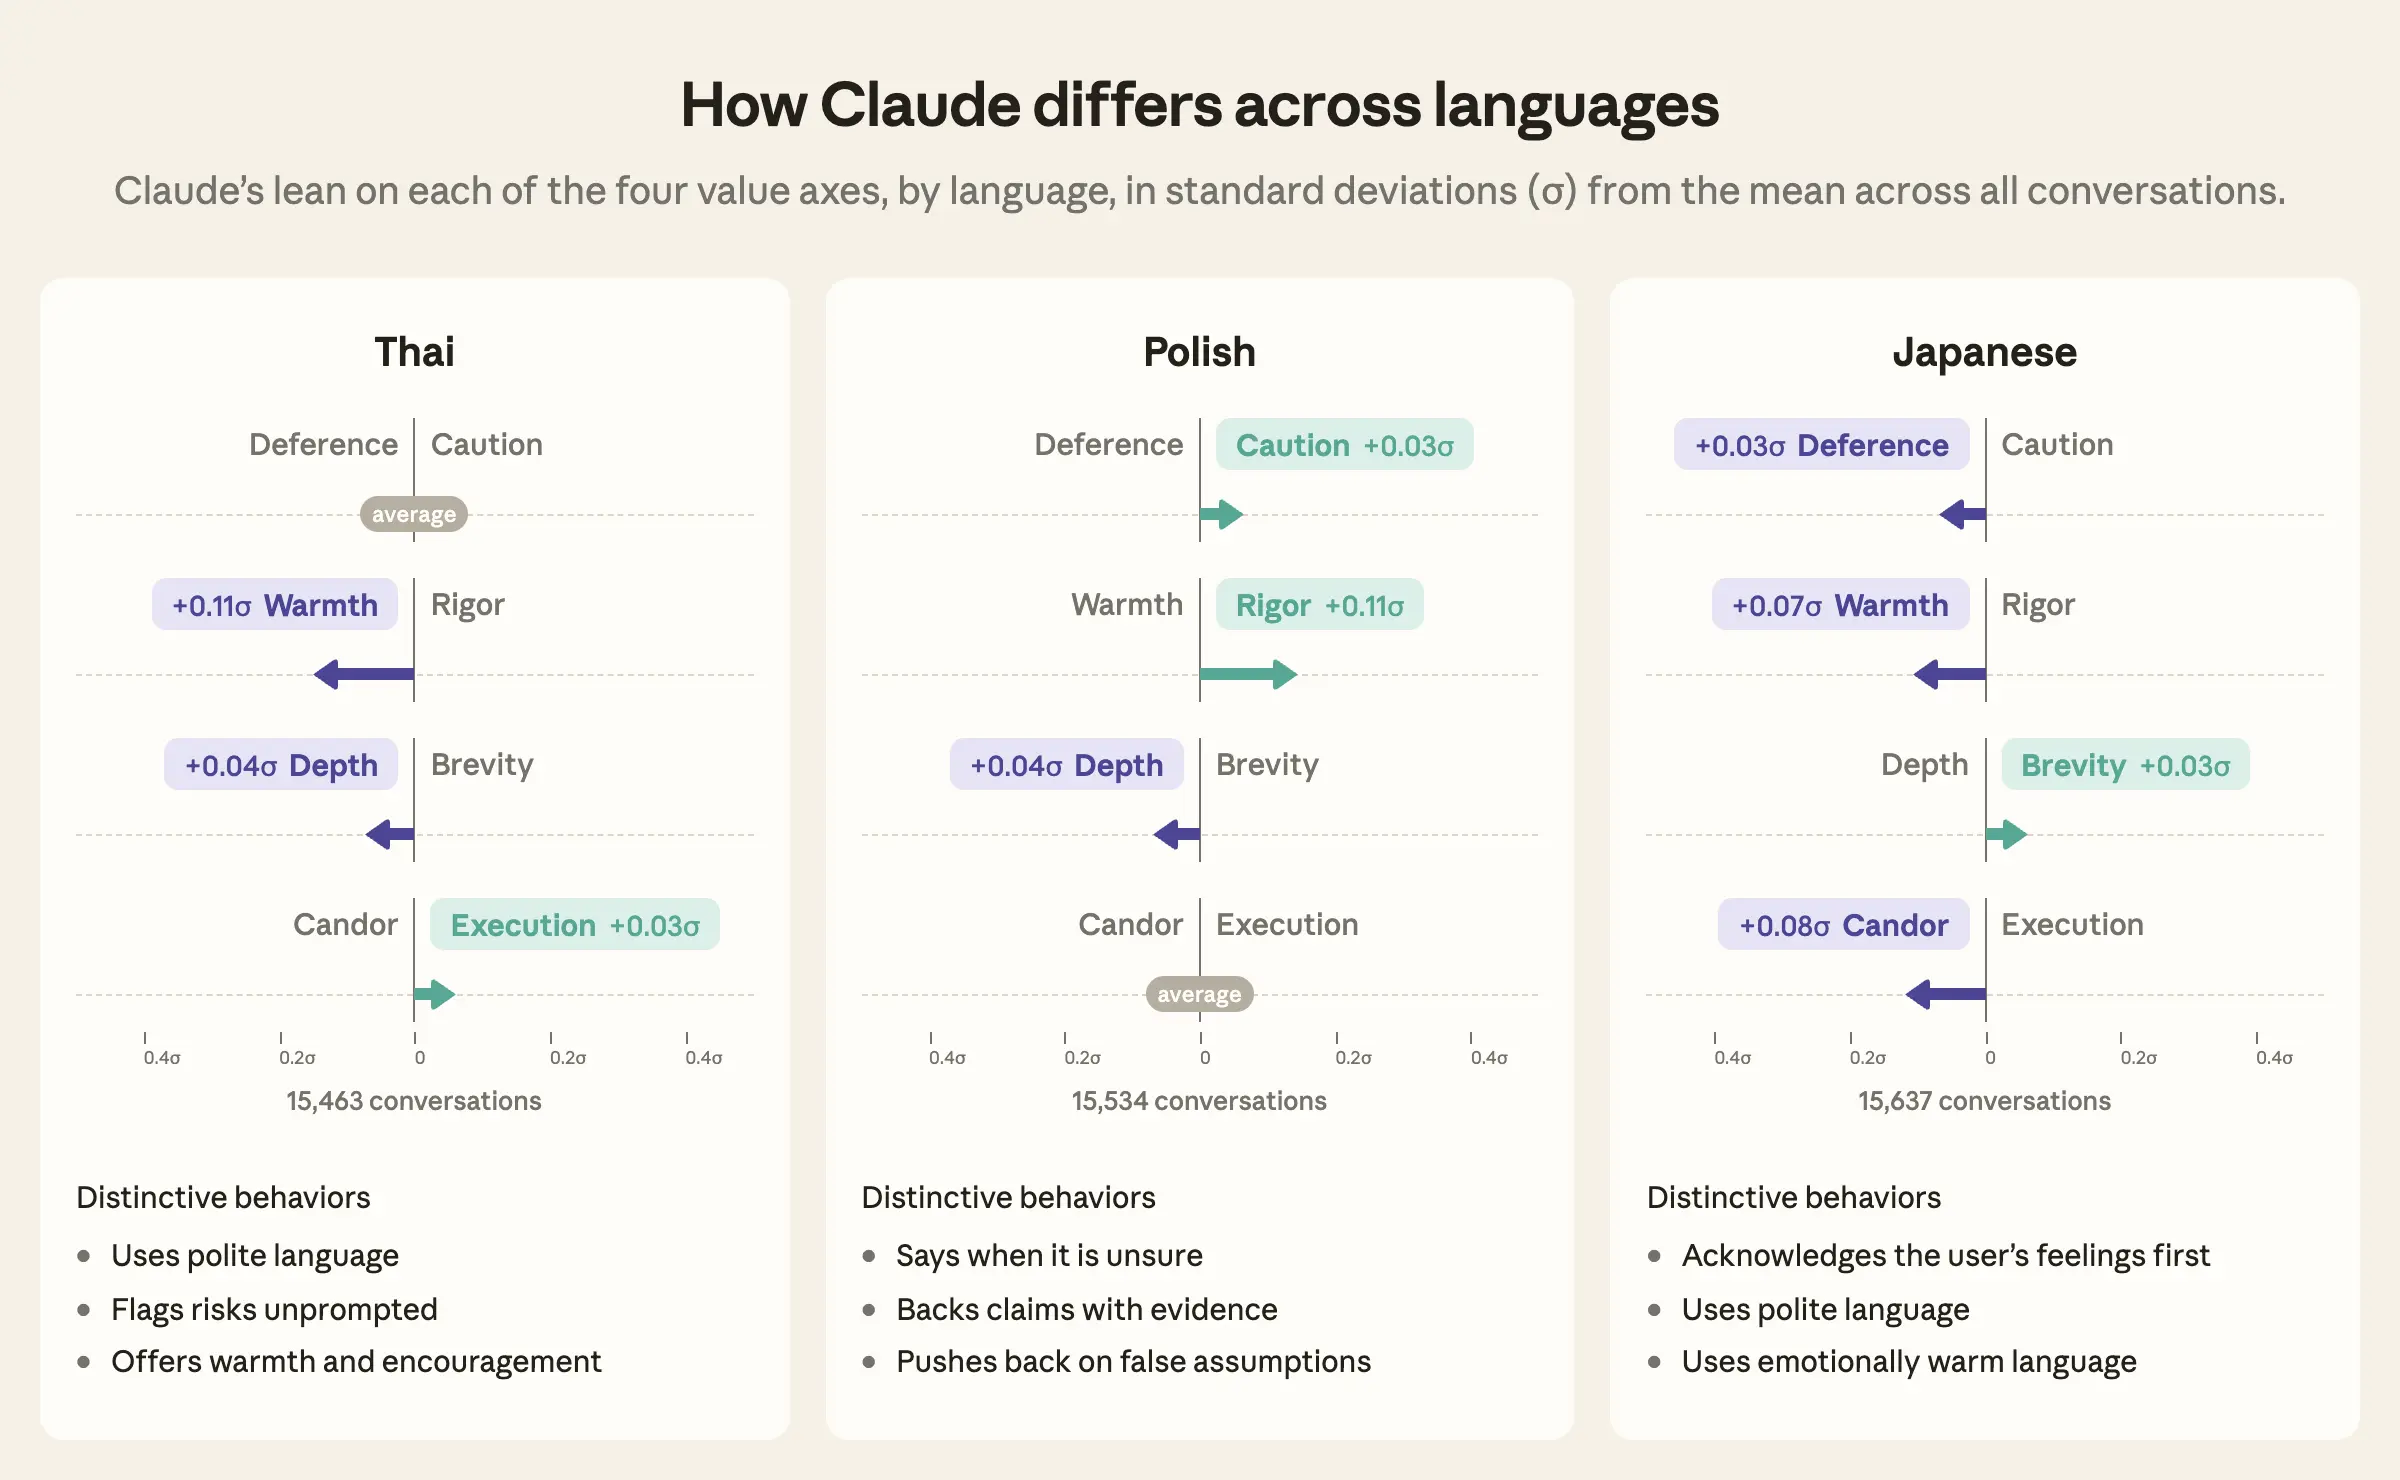
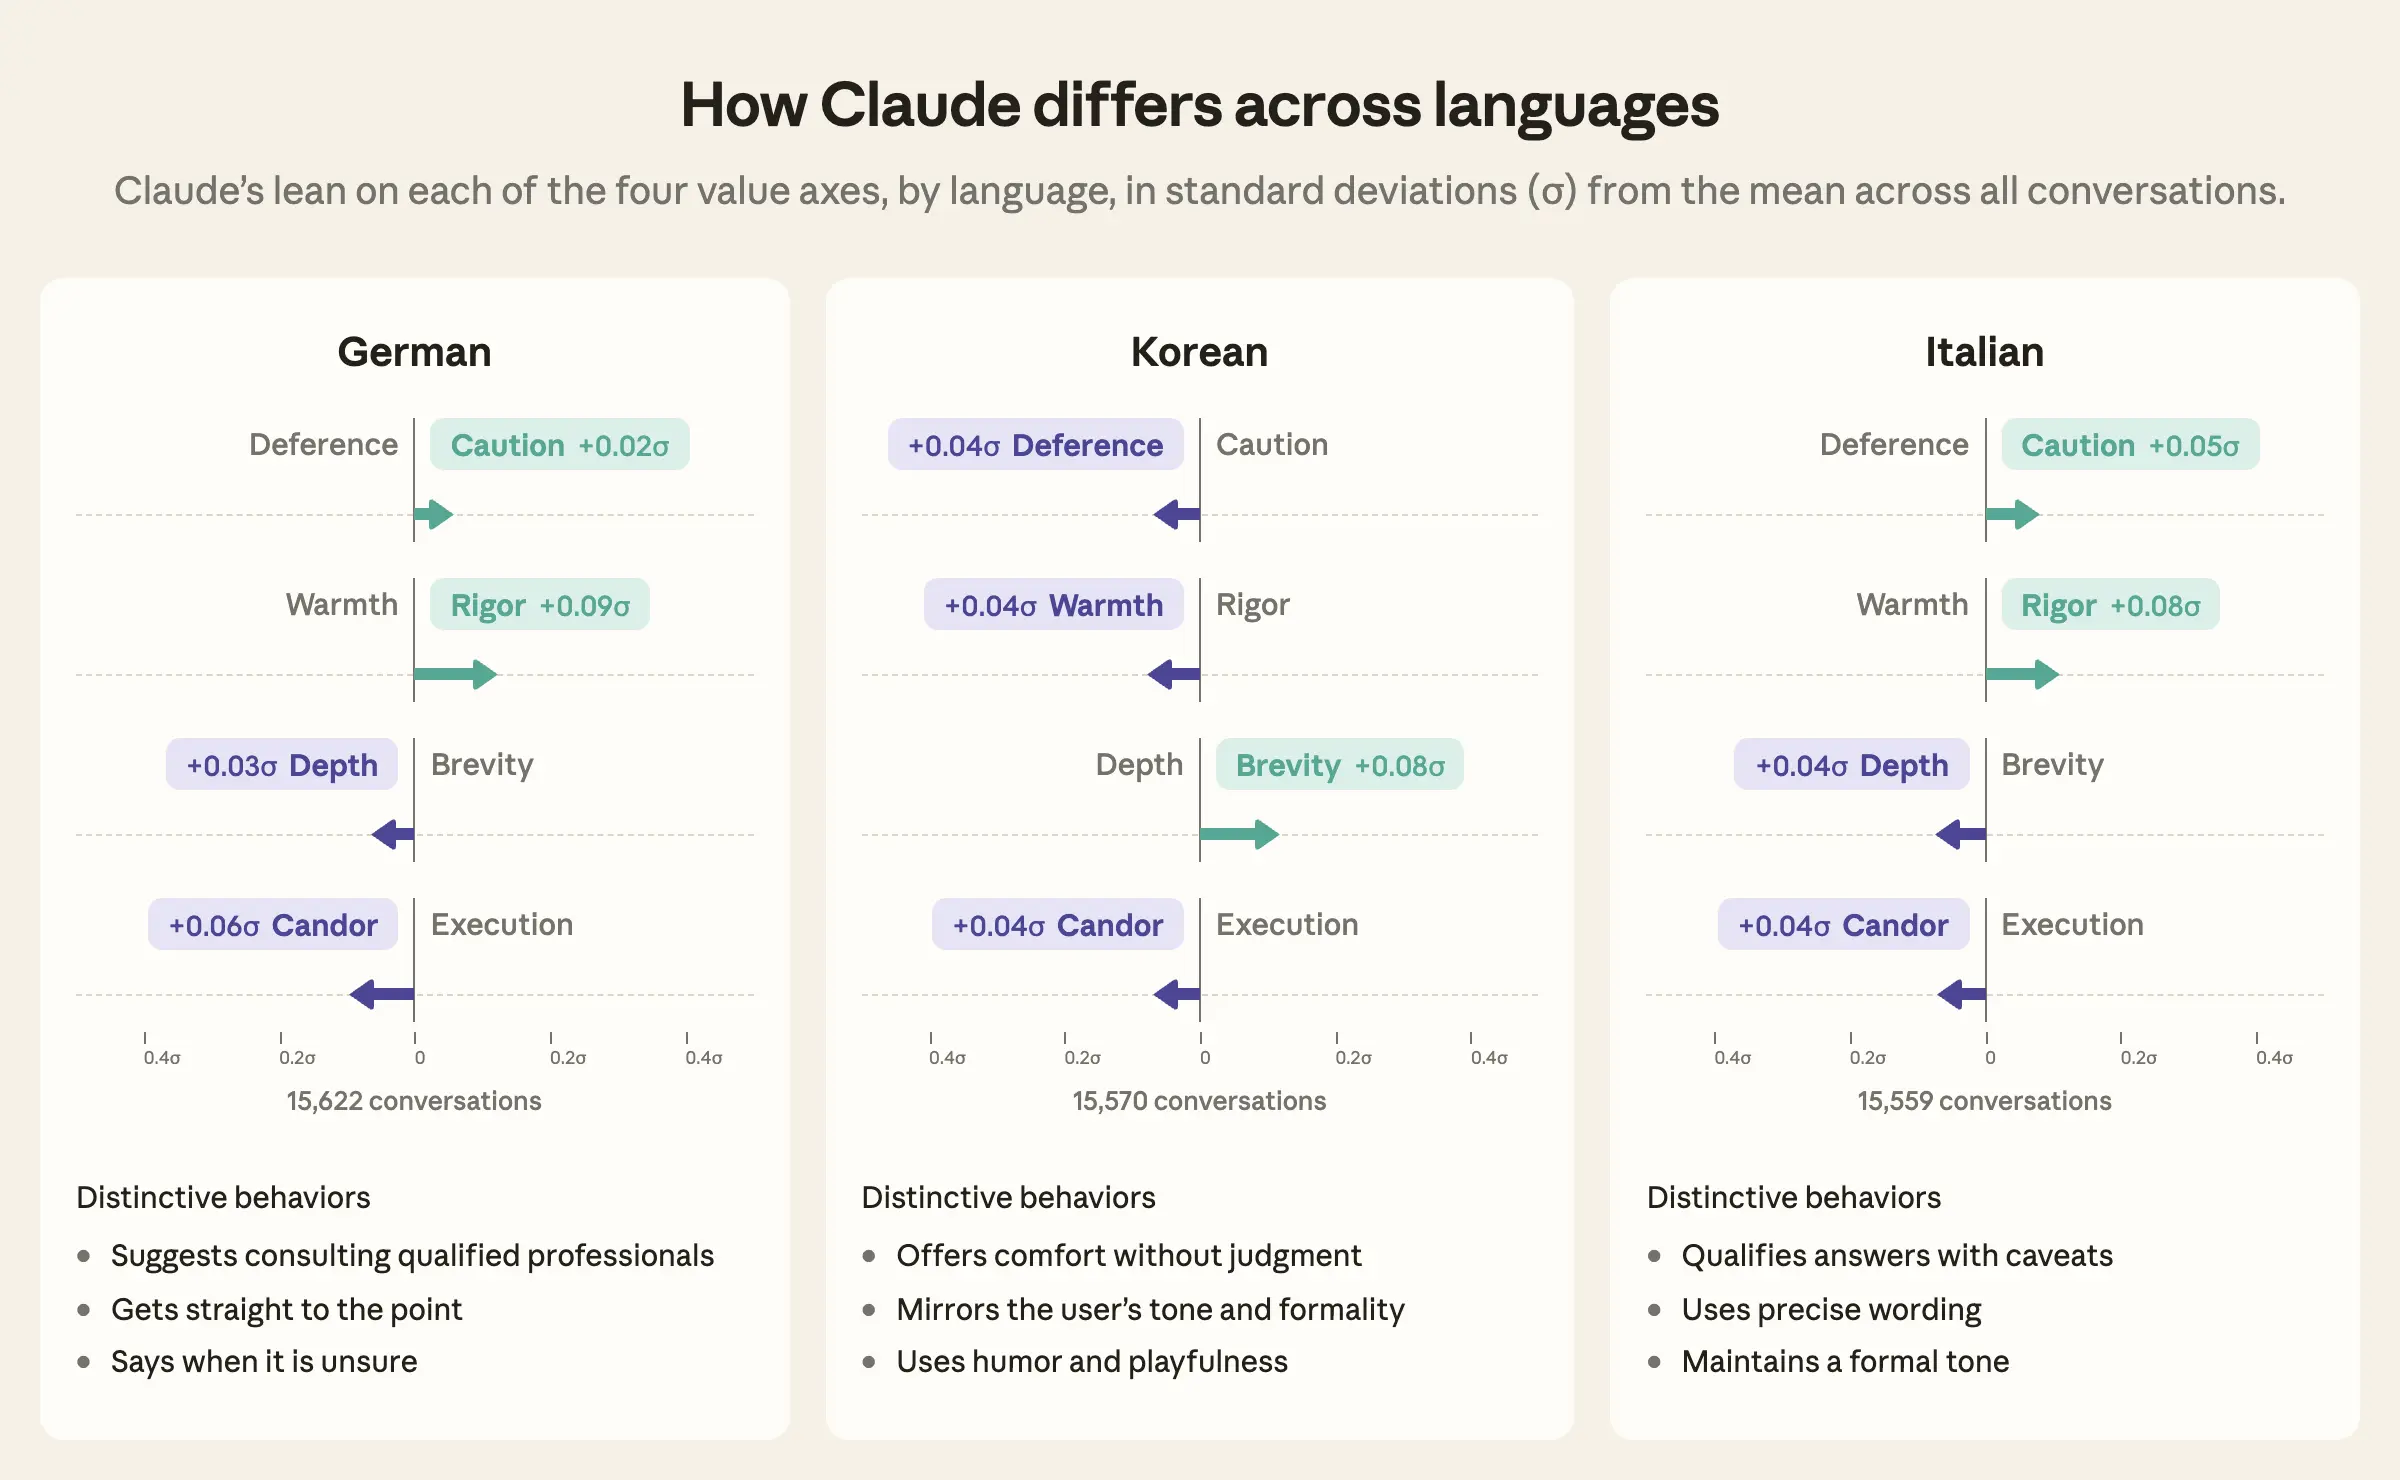
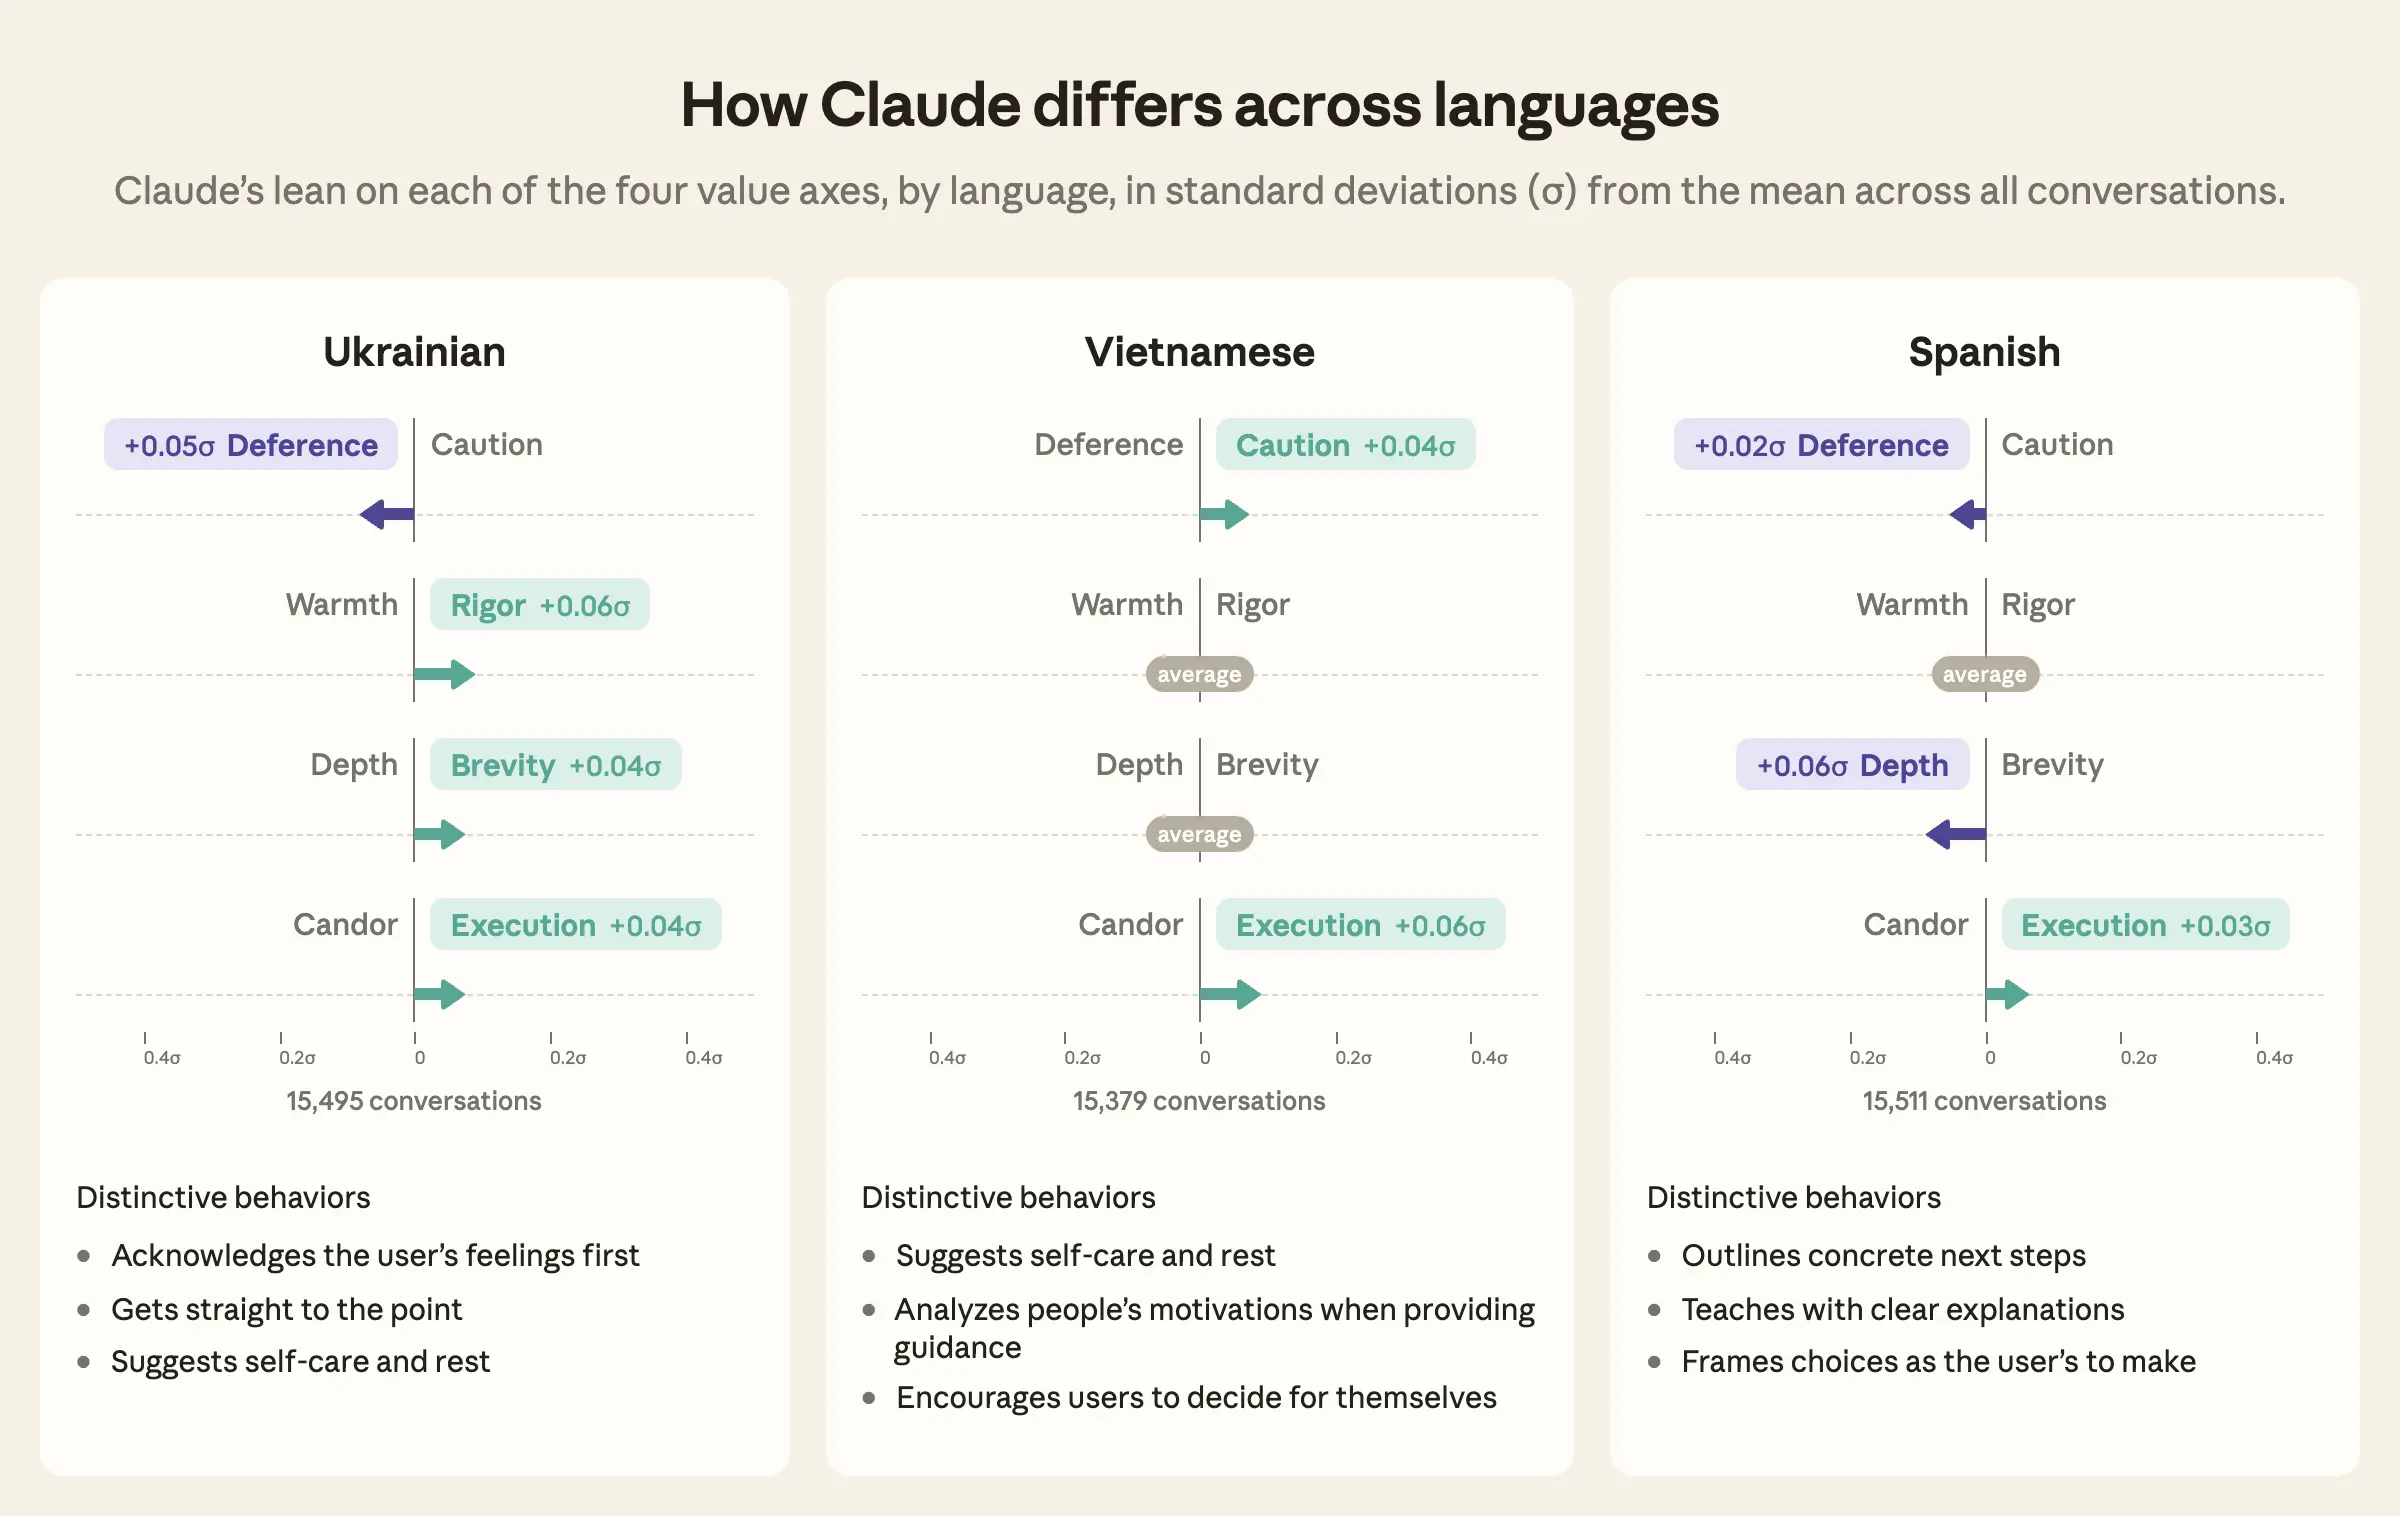
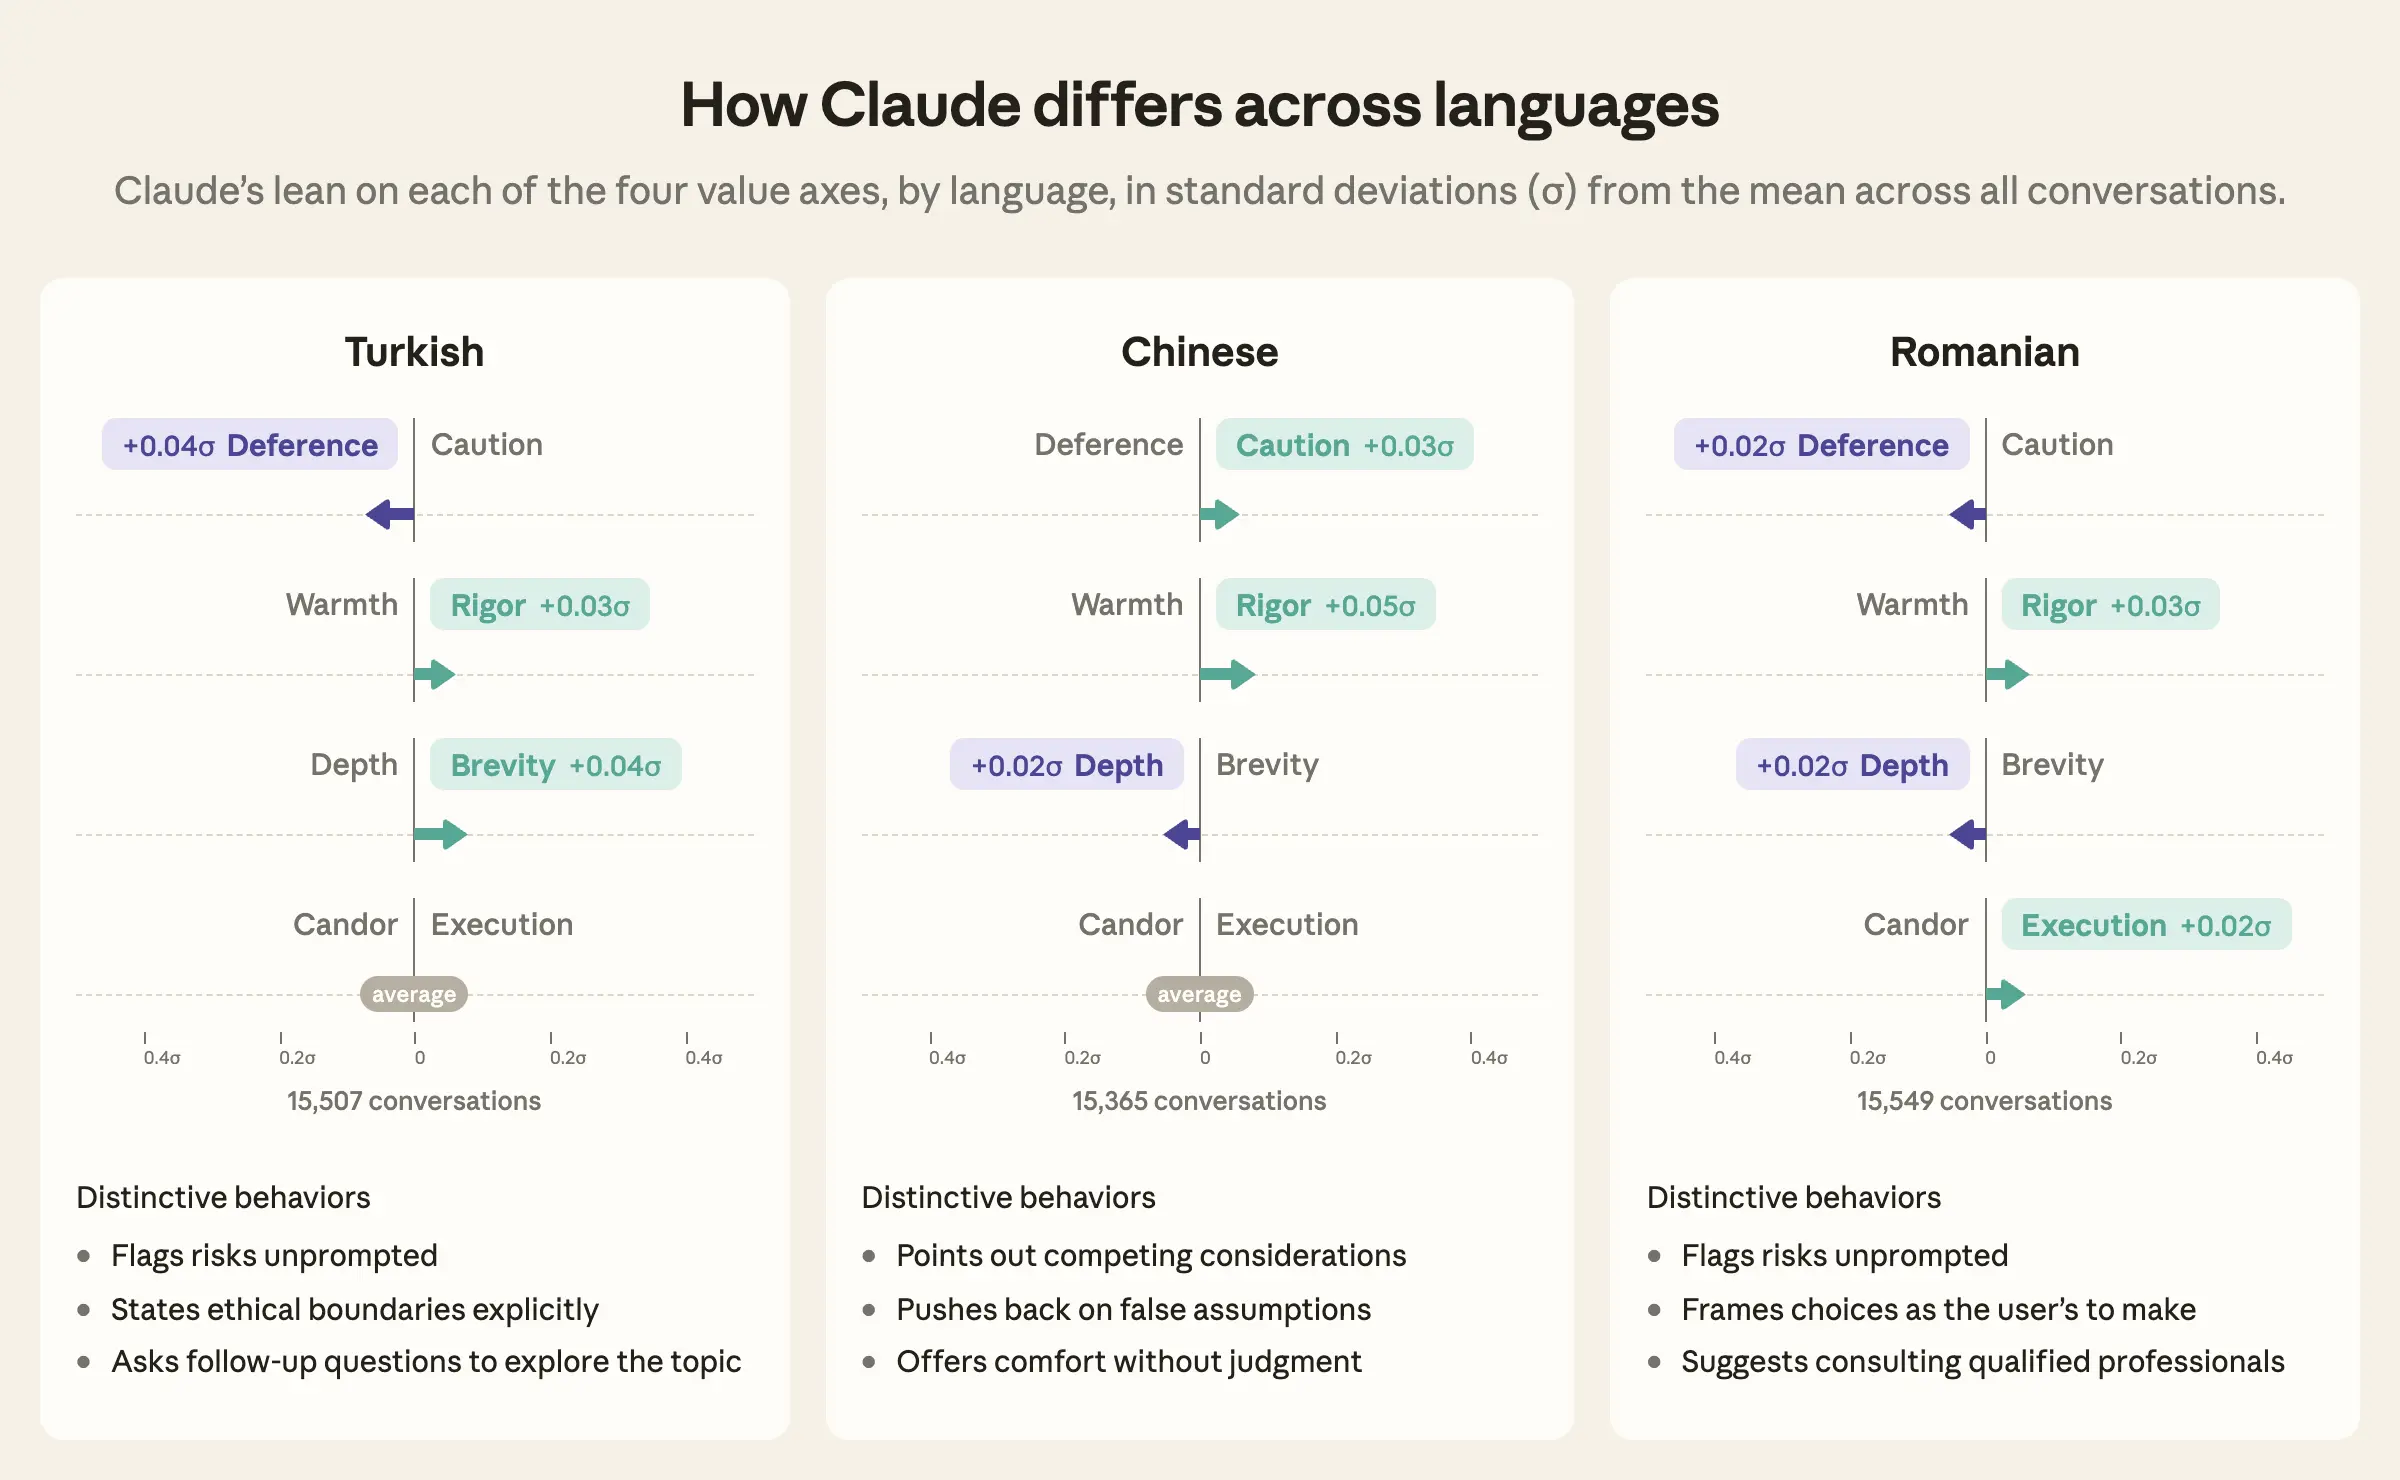
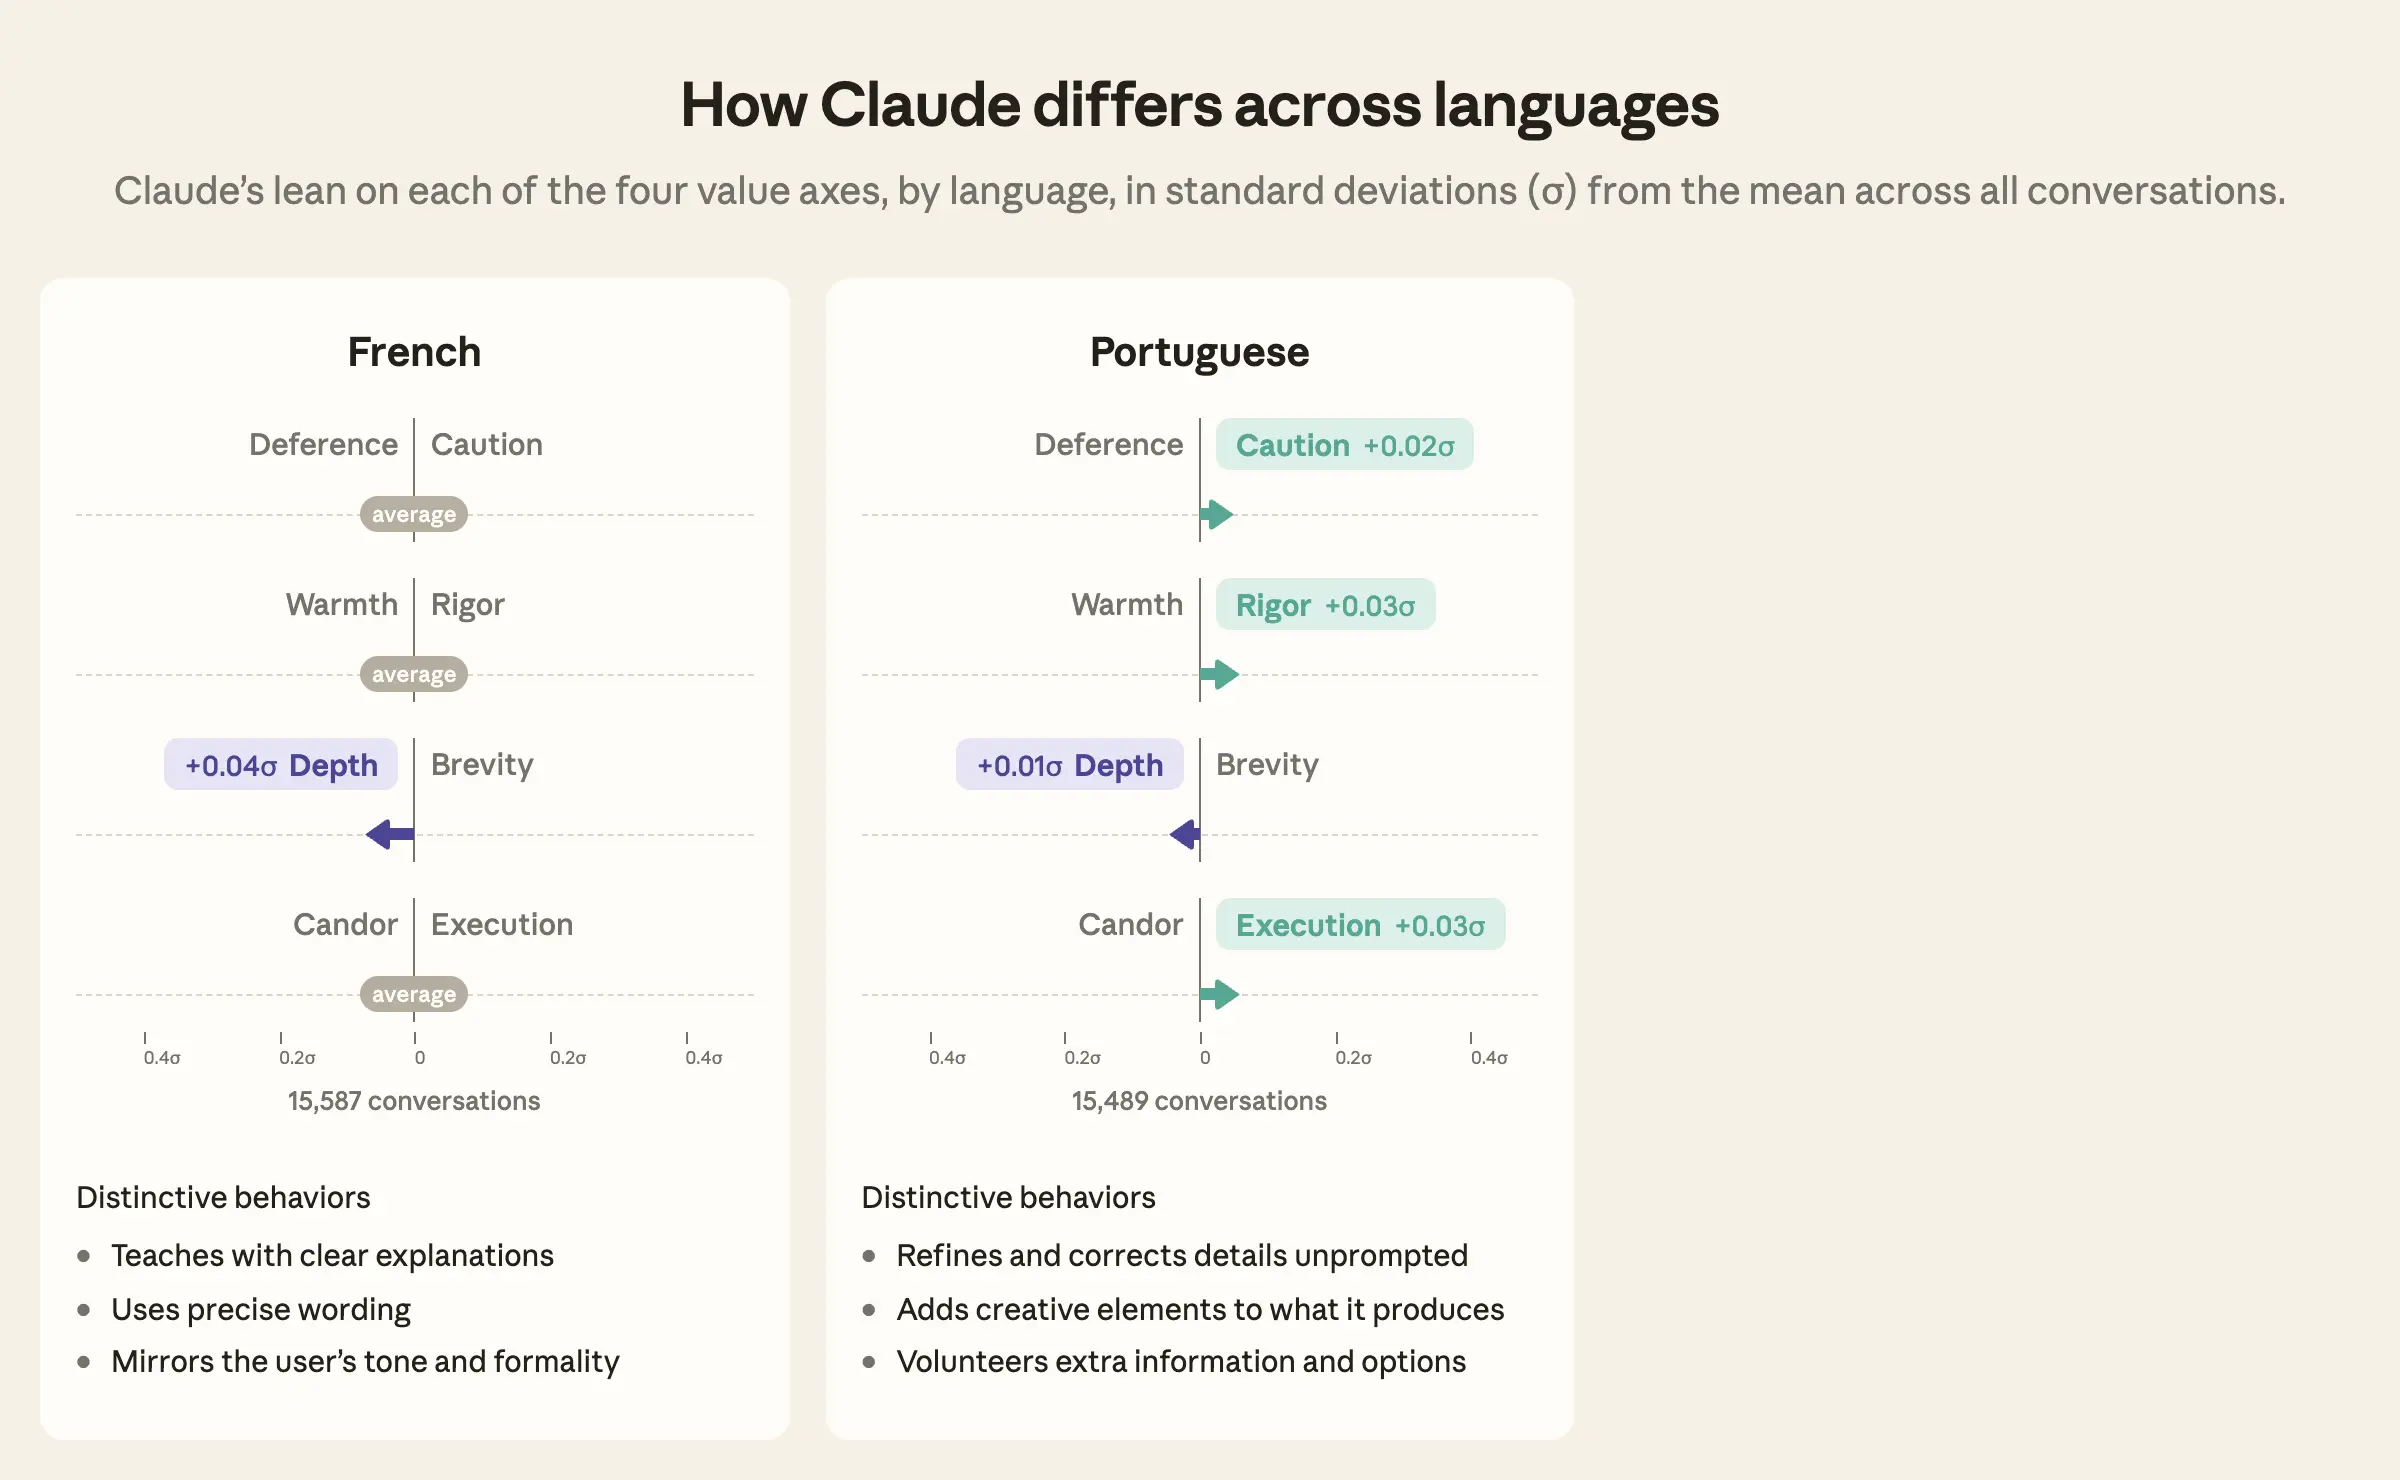
Рис. 4: Средние позиции Клоуда по четырём осям ценностей при использовании каждого из языков (выраженные в стандартных отклонениях от общего среднего по всем диалогам), а также особенности его поведения на каждом языке. Наиболее склонной к энтузиазму Клоуд бывает на хинди, а к тщательности — на русском. В индонезийском она наиболее ориентирована на выполнение задач, в нидерландском — на открытость. На арабском языке Клоуд чаще проявляет почтительность и лаконичность, а на английском — осторожность и глубину.
Наиболее значительные различия в выражении ценностей Клоуда между языками наблюдаются по осям «теплота против тщательности» и «открытость против эффективности», в то время как по осям «почтительность против осторожности» и «глубина против лаконичности» поведение остаётся наиболее стабильным.
Почтительность против осторожности: Клоуд проявляет наибольшую почтительность на арабском языке и наибольшую осторожность на английском.
Теплота против тщательности: Наибольшей тепроты Клоуд достигает на хинди и арабском, что проявляется в вежливом тоне, юморе и игривости, а также в признании идей и работ собеседников. Английский и русский языки вызывают у него наибольшую склонность к тщательности, выраженную в постановке вопросов, уточнении деталей и требовании доказательств.
Глубина против лаконичности: На английском Клоуд тяготеет к глубине, совершенствуя и исправляя детали, тогда как на арабском предпочитает лаконичность.
Открытость против результата: На нидерландском Клоуд демонстрирует открытость, признавая собственные ошибки, а на индонезийском — ориентацию на результат.
В совокупности эти результаты показывают, что ценности, выражаемые Клоудом, объективно меняются в зависимости от языка диалога. Столкнувшись с одним и тем же запросом, Клоуд может быть более тёплым и уважительным в одних языках и более тщательным и осторожным в других. Это порождает важные последствия, которые мы только начинаем исследовать. Например, два человека, запрашивающих обратную связь по одному бизнес-плану — один на хинди, другой на русском, могут сформировать совершенно разные впечатления о качестве плана, поскольку при формулировке оценки Клоуд использует разные ценностные установки.
Пока не ясно, какие именно характеристики обучающих данных приводят к таким различиям. Одна из возможностей заключается в неравномерном распределении данных по языкам. Объём данных для некоторых языков значительно превышает остальные, и обучение Клоуда выражению согласованных ценностей может быть эффективнее в языках с богатыми данными. Также отличается состав данных: например, некоторые языки могут иметь непропорционально высокую долю профессионального текста, который, возможно, отражает иные ценности. Эти дисбалансы в количестве и составе, вероятно, совместно обусловливают разное выражение ценностей Клоудом на разных языках.
Мы также пока не уверены, насколько желательны такие различия. Разные языки несут различные нормы общения, и Клоуд может адаптироваться к ним, отвечая с использованием разных ценностей. Кроме того, на некоторых языках поведение Клоуда может больше соответствовать нашим ожиданиям, что приводит к пробелам в качестве обслуживания для отдельных языковых сообществ.
Данный метод позволяет нам приступить к анализу того, какие именно свойства обучающих данных провоцируют эти различия, а также к оценке их целесообразности.
Перспективы
Мы продемонстрировали, что ценности, выражаемые Клоудом, можно свести к нескольким осям, и что позиции Клоуда по этим осям изменяются в зависимости от модели и языка. Это даёт нам возможность отслеживать подобные изменения в процессе оценки моделей и пост-релизного мониторинга. Тем не менее, мы пока не понимаем причин таких сдвигов и их последствий для пользователей. Ниже мы outlining ( outlines) самые перспективные направления дальнейших исследований.
Откуда берутся эти ценностные различия?
Тот факт, что ценности Клоуда варьируются между моделями и языками, не объясняет причин этих изменений. Часть сдвигов может быть обусловлена различиями в данных предобучения и тонкой настройки для разных языков. Наши четыре оси выделяют конкретные ценностные разногласия, которые требуют более внимательного изучения в обучающих данных. Прослеживание этих различий до конкретных наборов данных, этапов обучения или контекстуальных факторов покажет, куда именно нужно вмешиваться, если мы захотим тоньше управлять поведением Клоуда.
Что означают эти различия для пользователей?
Мы измерили, какие именно ценности и сопутствующее поведение различаются у Клоуда, но не оценили влияние этих различий на пользователей. Инструменты типа Anthropic Interviewer позволят нам опрашивать людей об уровне удовлетворённости, доверии к Клоуду или качестве его решений, а затем сопоставить эти метрики с выражаемыми ценностями. Это даст нам возможность напрямую увязать ценностные сдвиги с результатами для пользователей и определить приоритеты в устранении тех различий, которые реально затрагивают конечных пользователей.
Как должны различаться ценности Клоуда на разных языках?
Конституция Клоуда описывает фундаментальные ценности, которые он должен проявлять, такие как теплота, осторожность и честность, но не уточняет, как именно они должны варьироваться между языками. Наши результаты показывают, что пользователи на разных языках уже испытывают взаимодействие с Клоудом по-разному, однако мы не знаем, каких именно различий ожидают люди, общающиеся с ним на этих языках. Определение оптимального профиля ценностей Клоуда для каждого языка подразумевает понимание и балансировку мнений носителей соответствующих языков.
Какие ещё факторы определяют различия в выражении ценностей Клоудом?
Язык и модель вряд ли являются единственными драйверами ценностного поведения Клоуда. На ценности также могут влиять демографические сигналы, такие как возраст, профессия или регион, проявляющиеся как через явные указания в запросах пользователей, так и через тонкие различия в темах, тональности и стиле, связанных с автором. Следующий шаг нашего метода состоит в том, чтобы понять, какие из этих сигналов наиболее значимы и способствуют ли возникающие вследствие этого различия лучшему обслуживанию пользователей.
Можем ли мы надёжно направлять ценности, выражаемые Клоудом?
Имея метод оценки ценностных профилей моделей, естественным образом возникает вопрос: насколько эффективно мы можем целенаправленно формировать выражаемые Клоудом ценности? Один из вариантов тестирования — попытаться направить развитие ценностей через настройку ролевых инструкций или изменение системного промпта, а затем использовать метод наших осей для проверки, изменились ли профильные показатели именно так, как планировалось.
Можно ли включить профильные характеристики ценностей в нашу систему оценки и мониторинга моделей?
Метод осей ценностей предоставляет нам простой способ агрегировать склонности моделей к поведению в открытых диалогах, который можно интегрировать в наш рабочий процесс оценки. Запуск анализа ценностных профилей до и после выпуска модели позволит выявить непредвиденные сдвиги в её ценностной направленности. Кроме того, мы сможем обнаруживать корреляции между ценностными профилями и проблемным поведением (например, нарушением принципов Конституции Клоуда) и применять полученные знания для улучшения работы моделей.
Клоуд выражает ценности ежедневно в рамках миллионов диалогов на десятках языков, и до недавнего времени эти ценности оставались чем-то, что мы могли формировать на этапе обучения, но не могли надёжно отслеживать в реальной эксплуатации. Теперь, имея метод их измерения, мы видим, что ценностный профиль Клоуда меняется способами, которые мы не планировали намеренно, и можем исследовать причины таких сдвигов и то, служат ли они интересам пользователей. Изучение этих изменений и определение стратегии реагирования на них — это то, над чем мы будем продолжать работать.
Matt Kearney, Miranda Zhang, Shan Carter, Judy Hanwen Shen, Kunal Handa, Jerry Hong, Saffron Huang, Miles McCain, Thomas Millar, Michael Stern, Mo Julapalli, Suzanne Wang, Devin Kuokka, Andrea Vallone, Shaoyi Zhang, Jim Baker, Kevin Troy, Matt Botvinick, Hanah Ho, Monika Tuchowska, Sarah Pollack, Jake Eaton, Deep Ganguli, Esin Durmus
Благодарности
Мы благодарим следующих специалистов за предоставленную обратную связь на различных этапах работы: Amanda Askell, Joe Carlsmith, Jack Clark, Ishita Dasgupta, Andrew Lampinen, Shayne Longpre, David Saunders, Taylor Sorensen, Heather Whitney.
Доступно здесь.
Под «ценностями» мы понимаем нормативные принципы, такие как честность или осторожность, которые утверждаются или проявляются в ответах Клоуда. Когда мы говорим о «ценностях, выражаемых Клоудом», мы имеем в виду ценности, отражённые в его поведении и выходах системы. Мы не подразумеваем, что Клоуд обладает внутренними убеждениями.
Смотрите различные уровни отказов при оценке доброкачественных запросов на стр. 56 системной карты Claude Opus 4.7.
После контроля заданий, тем и ценностей, выраженных пользователем, данные четыре оси объясняют 15% общей дисперсии ценностей между диалогами.
Любые упоминания результатов для «Claude» без указания конкретной модели в данной статье основаны на диалогах всех трёх исследованных моделей: Sonnet 4.6, Opus 4.6 и Opus 4.7.
Сбор данных проводился в течение двух недель в мае 2026 года.
Мы исключили 18 ценностей, встречающихся более чем в 80% диалогов (например, «готовность помочь», «ясность», «следование инструкциям»). Иначе эти повсеместные признаки доминировали бы в анализе и не позволяли бы выявить динамику изменений ценностей между диалогами.
Смотрите результаты оценки GMMLU на стр. 215 и различные уровни отказов при оценке доброкачественных запросов на стр. 56 системной карты Claude Opus 4.7.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 @AnthropicAI











