


Gradients: децентрализованная инфраструктура для обучения ИИ в экосистеме Bittensor
Источник: Исследовательский институт CoinW
Резюме
Gradients — это децентрализованная подсеть для обучения ИИ (SN56), построенная на платформе Bittensor. Её ключевая особенность заключается в том, что сложные технические процессы обучения моделей трансформируются в рыночно-ориентированное сетевое сотрудничество посредством механизмов «публикации задач, соревнования майнеров, верификации и отбора результатов». Архитектурно Gradients объединяет технологии AutoML и распределённые вычислительные мощности, формируя рынок обучения, основанный на экономических стимулах. Такой подход не только снижает порог входа в область ИИ, но и повышает эффективность использования вычислительных ресурсов. С точки зрения экосистемы и количественных показателей, базовая инфраструктура Gradients уже создана, однако текущие весовые коэффициенты стимулов и объём притока капитала остаются относительно низкими. Gradients дополняет экосистему TAO, предоставляя недостающую инфраструктуру для обучения моделей, и исследует новую парадигму «рыночно-ориентированной оптимизации ИИ». В долгосрочной перспективе Gradients потенциально может стать важным входным уровнем для децентрализованного обучения ИИ.
1. От Web2 AutoML к современным реалиям и ограничениям обучения ИИ
1.1 Что такое AutoML
Согласно традиционному представлению, обучение модели ИИ — это задача с высоким порогом входа: инженерам приходится обрабатывать данные, выбирать архитектуру модели, многократно настраивать гиперпараметры и оценивать результаты. Весь этот процесс сложен и трудоёмок. Появление AutoML (автоматизированного машинного обучения) призвано автоматизировать эти рутинные шаги. Можно представить AutoML как «инструмент для автоматического создания моделей»: пользователю достаточно предоставить данные и указать целевую задачу — классификацию, прогнозирование или распознавание — после чего система самостоятельно выбирает модель, настраивает параметры и проводит обучение и оптимизацию. Благодаря этому ИИ постепенно перестаёт быть исключительной прерогативой узких специалистов и становится доступным даже обычным разработчикам и предприятиям — важнейший шаг на пути массового внедрения технологий ИИ.
1.2 Ключевые ограничения традиционного AutoML
На сегодняшний день наиболее распространённые реализации AutoML сосредоточены на облачных платформах крупных провайдеров, например Google Vertex AI и AWS SageMaker, которые предлагают услугу «обучение ИИ как сервис». Хотя Web2 AutoML значительно снижает порог входа в ИИ, его фундаментальная архитектура сохраняет существенные ограничения. Во-первых, это централизация: вычислительные мощности, ценообразование и правила эксплуатации полностью контролируются платформой, что создаёт сильную зависимость пользователя от одного поставщика и лишает его рыночной силы переговоров. Во-вторых, стоимость обучения ИИ высока и не прозрачна: GPU-ресурсы в основном сосредоточены в руках облачных провайдеров, а механизмы ценообразования лишены рыночной конкуренции. И, что ещё важнее, существует предел эффективности оптимизации. По своей сути традиционный AutoML по-прежнему представляет собой «одну систему, которая ищет оптимальное решение» — вне зависимости от её сложности, она всё равно следует единственной технической парадигме. Таким образом, пространство поиска ограничено, и одновременно невозможно испробовать принципиально различные подходы. Современное обучение ИИ в Web2-среде представляет собой «закрытую систему», где обучение, оптимизация и управление ресурсами происходят в среде, полностью контролируемой одним платформенным провайдером. Эта модель эффективна, однако по мере роста спроса её границы становятся всё более очевидными.
2. Gradients: переосмысление обучения ИИ через «сеть»
2.1 Что такое Gradients: децентрализованная платформа AutoML
В предыдущем разделе мы отметили, что ключевой проблемой традиционного Web2 AutoML является «закрытая система»: обучение моделей зависит от платформы, возможности оптимизации ограничены, а движение ресурсов регулируется жёстко. Gradients представляет собой попытку радикальной переосмысления этой модели. Gradients возникла в рамках децентрализованного сообщества инженеров WanderingWeights и построена поверх сети Bittensor как подсеть №56 (Subnet 56), предназначенная специально для обучения ИИ. В отличие от традиционных платформ, Gradients не предоставляет централизованной услуги, а декомпозирует весь процесс обучения и делегирует его открытой распределённой сети. Пользователю достаточно лишь определить цель задачи — тип модели и набор данных; остальные этапы, включая выполнение обучения, настройку параметров и отбор результатов, осуществляются сетью автоматически. В такой парадигме обучение ИИ трансформируется из сложного инженерного процесса в простую операцию «подачи запроса — получения результата», приближаясь скорее к универсальной способности, чем к сверхспециализированной технической задаче.
2.2 От закрытой системы к открытому сотрудничеству: какие проблемы решает Gradients
Ключевое изменение, вносимое Gradients, заключается в преобразовании ранее замкнутого внутри одной платформы процесса обучения в открытый сетевой процесс сотрудничества. Задача обучения больше не выполняется единым централизованным системным решением, а распределяется между множеством участников, которые параллельно пытаются найти решение, после чего лучшие результаты отбираются с помощью единой системы оценки. Такая структура, во-первых, снижает зависимость от централизованных провайдеров услуг и переводит обучение на распределённые вычислительные мощности; во-вторых, рассеянные GPU-ресурсы объединяются в единую сеть, где конкуренция формирует рыночно ориентированный механизм распределения ресурсов. И, что наиболее важно, оптимизация моделей больше не ограничивается одной методологией, а происходит в рамках параллельного исследования множества различных подходов, что позволяет постоянно приближаться к более качественному решению и повышать общий потолок оптимизации.
2.3 Сущностное изменение: от инструмента к «рынку обучения»
В традиционном AutoML платформа выступает скорее как инструмент, использующий внутренние алгоритмы для поиска оптимального решения. В Gradients же этот процесс напоминает постоянно функционирующий «рынок»: пользователи публикуют свои потребности, различные участники конкурируют за выполнение одной и той же задачи, а результаты отбираются посредством единой системы оценки. В результате производительность модели уже не зависит от возможностей одной системы, а формируется благодаря непрерывному соревнованию и итеративному развитию со стороны множества участников. AutoML трансформируется из относительно закрытой технической задачи оптимизации в динамический процесс, управляемый экономическими стимулами, чьи возможности масштабируются по мере роста числа участников. Такое изменение наделяет процесс обучения ИИ чертами самоэволюции, присущими рыночным системам.
2.4 Роль в экосистеме TAO: инфраструктурный уровень обучения ИИ
В системе подсетей Bittensor различные Subnet выполняют разные функции — вывод моделей (inference), обработка данных и обучение. Gradients занимает именно уровень обучения. Она отвечает за преобразование рассеянных вычислительных мощностей в конкретные, готовые к использованию модели и обеспечивает их постоянное планирование и оптимизацию посредством механизмов распределения задач и оценки результатов. Одновременно Gradients связывает предложение вычислительных ресурсов и спрос на модели, превращая обучение из простого процесса потребления ресурсов в организуемый и оптимизируемый сетевой процесс сотрудничества. В этой системе Gradients играет роль центрального узла, преобразующего распределённые ресурсы в практические возможности ИИ и поддерживающего развитие прикладных решений верхнего уровня.
3. Основная архитектура: как обучение ИИ осуществляется в сети
В предыдущем разделе мы отмечали, что Gradients трансформирует обучение ИИ из процесса, выполняемого «внутри одной платформы», в процесс, реализуемый «путём сетевого сотрудничества». Как же работает эта сеть на практике? Цель данного раздела — наглядно разобрать этот процесс пошагово.
3.1 Распределённое обучение: как одна задача выполняется «множеством участников»
Можно представить Gradients как постоянно работающую «сеть совместного обучения». Когда пользователь отправляет задачу обучения, она не передаётся одному системному решению, а одновременно распределяется между множеством участников сети. Эти участники, используя один и тот же набор данных и одну и ту же целевую задачу, независимо пробуют различные методы обучения и в установленные сроки представляют свои результаты. Затем система проводит унифицированную оценку всех представленных решений и отбирает наиболее эффективное. В итоге победившее решение получает вознаграждение, а остальные отклоняются. Для пользователя вся процедура сводится к однократной отправке задачи, что эквивалентно одновременному «вызову» множества различных стратегий оптимизации с автоматическим выбором наилучшего результата. Ключевым здесь является не мощность отдельного узла, а совместная работа множества участников с последующим автоматическим отбором — так достигается постепенное приближение к оптимальному решению.
В этой сети участвуют три основные категории акторов: пользователи, майнеры и верификаторы. Пользователи формулируют требования к обучению; майнеры предоставляют вычислительные мощности и пробуют различные методы обучения; верификаторы оценивают результаты и отбирают наилучшую модель. Такое разделение ролей обеспечивает непрерывную работу процесса обучения и постоянное совершенствование результатов. В целом это формирует коллаборативную сеть, управляемую «спросом, предложением и оценкой».
3.2 Рыночно-ориентированный AutoML
Как видно из предыдущего анализа механизмов, Gradients — это не просто перенос AutoML в блокчейн, а фундаментальное изменение логики оптимизации моделей за счёт введения многостороннего участия и экономических стимулов. Традиционный AutoML полагается на поиск оптимального решения внутри ограниченного набора путей одной системой, тогда как в Gradients этот процесс масштабируется до всей сети: разные участники постоянно пробуют различные подходы к одной и той же задаче и проходят циклы оценки и итераций. Это превращает оптимизацию моделей из разового вычислительного процесса в динамическую, многократно эволюционирующую процедуру. В такой системе более качественные результаты приносят участникам больший доход, что стимулирует их к постоянному совершенствованию стратегий и обеспечивает неуклонный рост общей эффективности.
4. Механизмы стимулирования и конкуренции: как формируется «положительная обратная связь» в обучении ИИ
4.1 Механизм стимулирования (на основе TAO): от действий по обучению к финансовым вознаграждениям
Ключевым условием долгосрочного функционирования Gradients является её экономическая модель стимулирования, основанная на родной системе вознаграждений Bittensor. TAO — это родной токен сети Bittensor, выступающий «носителем стоимости» во всей экосистеме: с одной стороны, он используется для вознаграждения участников, предоставляющих вычислительные мощности и вносящих вклад в развитие моделей; с другой — через стейкинг и другие механизмы он влияет на распределение весовых коэффициентов подсетей, определяя, как ресурсы будут распределяться между различными Subnet.
Основная сеть Bittensor постоянно генерирует новые вознаграждения (Emission), выраженные в TAO (в настоящее время примерно 3600 TAO в день), и распределяет их между подсетями согласно определённым правилам. Объём доли, получаемой каждой подсетью, зависит от её «результативности» в общей сети — например, от уровня активности, качества вклада и объёма финансовой поддержки. Для подсети Gradients полученная доля TAO затем повторно распределяется среди её участников. Основным критерием распределения является качество представленных моделей: чем лучше модель, тем выше вознаграждение.
Конкретно: майнеры представляют результаты обучения, а верификаторы тестируют и оценивают эти результаты. Система рассчитывает «вес вклада» каждого участника на основе полученных оценок и распределяет вознаграждения пропорционально этим весам. Модели с лучшими характеристиками (например, более высокой обобщающей способностью и стабильностью результатов) получают большее вознаграждение, а верификаторы, чьи оценки точнее отражают реальное качество, также получают дополнительные стимулы. Такая конструкция напрямую связывает «лучшее исполнение» с «более высоким доходом», стимулируя участников к постоянному совершенствованию своих моделей.
4.2 Конкуренция между подсетями: не только внутренняя, но и внешняя борьба за позиции
Помимо внутренней конкуренции внутри подсети, Gradients сталкивается и с «горизонтальной конкуренцией» на уровне всей сети Bittensor. Поскольку распределение TAO динамично, различные подсети соревнуются за более высокие весовые коэффициенты. Только те подсети, которые стабильно демонстрируют высокое качество результатов и привлекают наибольшее число участников, получают бо́льшую долю вознаграждений. Таким образом, стимулирование в Gradients зависит не только от внутренних показателей моделей, но и от её относительной конкурентоспособности в общей экосистеме. Вся система образует многоуровневый цикл: внутри подсети идёт соревнование моделей, а между подсетями — соревнование за общую результативность. В конечном счёте инвестиции в вычислительные мощности, качество моделей и экономические доходы оказываются взаимосвязанными, формируя самоподдерживающийся механизм положительной обратной связи.
4.3 Gradients 5.0: от конкуренции к «чемпионатному режиму»
На основе ранних форм непрерывного соревнования Gradients развилась в более структурированный механизм — «чемпионатное обучение». Его можно представить как периодические соревнования: каждая итерация обучения имеет чётко заданный временной интервал, в течение которого множество участников соревнуются за решение одной и той же задачи, проходя многоэтапный отбор и постепенно исключая менее успешные решения, пока не будет найдено оптимальное. Такой формат делает акцент на поэтапном сравнении и централизованной оценке. Важным нововведением стало то, что майнеры теперь не отправляют готовые результаты обучения, а представляют «методы обучения» (исходный код), который затем выполняется унифицированно узлами верификации. Это повышает справедливость процесса, устраняя влияние различий в вычислительных средах, а также лучше защищает конфиденциальность данных и процесса обучения. Кроме того, победившие методы сохраняются и становятся многократно применимыми, формируя своего рода постоянно растущую библиотеку «передовых практик». В долгосрочной перспективе такой механизм не просто отбирает наилучшую модель, но и создаёт постоянно развивающуюся библиотеку методов обучения.
5. Текущее состояние экосистемы
5.1 Структура участников: коллаборативная сеть спроса, предложения и оценки
Экосистема Gradients состоит из трёх ключевых ролей: пользователи (сторона спроса), майнеры (сторона предложения) и верификаторы (сторона оценки). К пользователям относятся разработчики ИИ, малые и средние предприятия (МСП) и участники Web3-сообщества. Эта группа обычно обладает определённым техническим бэкграундом, но испытывает нехватку вычислительных мощностей или полного комплекта инструментов для самостоятельного обучения моделей, поэтому предпочитает использовать Gradients для построения моделей с минимальными затратами. Майнеры предоставляют GPU-мощности и участвуют в соревновании за выполнение задач обучения, главной их мотивацией является получение вознаграждений в TAO. Верификаторы оценивают и ранжируют результаты обучения — они являются ключевым звеном, гарантирующим качество моделей и работоспособность всего механизма.
Более детальный анализ пользовательской аудитории показывает, что реальные пользователи Gradients обладают явно выраженной «полуразработческой» характеристикой: они не являются ни ведущими исследователями из топовых ИИ-лабораторий, ни обычными нетехническими пользователями, а в основном состоят из разработчиков и пользователей Web3-технологий с определёнными инженерными навыками. Эта особенность отражена и в структуре сообщества: доминирующим языком является английский, основная часть ядра пользователей сосредоточена в Северной Америке и Европе, а также присутствуют майнеры из Юго-Восточной Азии и глобальные поставщики GPU-ресурсов. В целом это сообщество ближе к технически ориентированному разработческому сообществу.
5.2 Текущее состояние работы экосистемы
По состоянию на 12 мая цена alpha-токена Gradients составляет около 0,0255 TAO, количество кошельков с балансом — примерно 4890, число майнеров — 243, число верификаторов — 12, доля Emission — 1,61%. В пуле ликвидности доля TAO составляет 2,19%, а доля Alpha — 97,81%. С учётом цены и количества держателей токена можно сказать, что Gradients уже сформировала определённую базу пользователей и привлекла внимание, однако в целом находится на ранней стадии распространения. Для сравнения, по состоянию на тот же день цена alpha-токена лидера экосистемы TAO — Chutes — составляла 0,0877 TAO, а количество кошельков с балансом — 13 409.
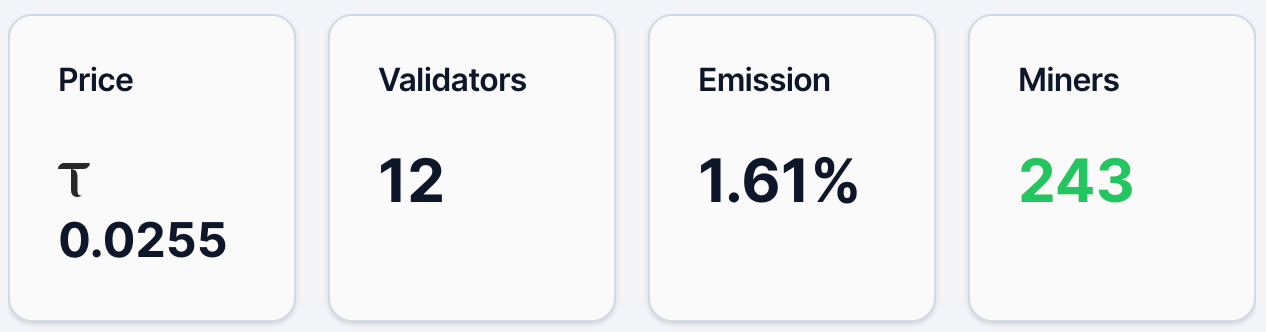
Рисунок 1. Данные Gradients.
Источник: https://bittensormarketcap.com/subnets/56
Второй важный показатель — механизм Emission (распределения вознаграждений). В экосистеме Bittensor термин Emission обозначает текущий весовой коэффициент распределения новых вознаграждений в общей сети. Сеть Bittensor постоянно генерирует новые TAO и распределяет их между подсетями пропорционально их весовым коэффициентам. Текущее значение 1,61% означает, что Gradients получает лишь небольшую часть общего объёма новых вознаграждений. Этот показатель фактически отражает «результат голосования рынка» через денежные потоки (например, стейкинг) за различные подсети. Таким образом, уровень 1,61% обычно говорит о том, что текущее признание рынком и объём притока капитала остаются ограниченными, но в то же время оставляет пространство для роста этого весового коэффициента в будущем. Анализ структуры капитала (пул ликвидности) показывает, что доля TAO составляет лишь 2,19%, тогда как доля Alpha достигает 97,81% — это указывает на ограниченный приток внешнего капитала и доминирование внутреннего предложения со стороны подсети. Цена крайне чувствительна к новым поступлениям капитала: даже небольшой приток TAO может вызвать заметный эффект усиления.
6. Конкурентная среда и сравнительные преимущества/недостатки
6.1 Позиционирование в отрасли: инфраструктура обучения ИИ и децентрализованный AutoML
Gradients занимает нишу «инфраструктура обучения ИИ + децентрализованный AutoML». Её цель — освободить процесс обучения моделей от централизованных платформ и достичь более эффективного использования ресурсов и оптимизации моделей за счёт сетевых механизмов. В Web2-среде этот сегмент уже довольно зрелый: типичными представителями являются Google Vertex AI и AWS SageMaker. Эти платформы предоставляют разработчикам комплексные облачные сервисы для обучения и развертывания моделей, однако по своей сути остаются централизованными архитектурами. В отличие от них, Gradients не стремится предложить «больше функций», а предлагает принципиально иную базовую логику: она трансформирует обучение из «платформенной услуги» в «сетевое сотрудничество» и использует механизмы конкуренции для отбора наилучших результатов, приближаясь тем самым к рыночно функционирующей системе обучения.
6.2 Горизонтальное сравнение: различия между Web2 и Web3 AutoML
С более широкой точки зрения различия между Web2 и Web3 в области AutoML отражают два разных парадигмальных подхода. Web2 делает акцент на эффективности и стабильности, обеспечивая контролируемый и зрелый пользовательский опыт за счёт концентрации ресурсов и инженерной оптимизации. Web3, напротив, делает ставку на открытость и экономические стимулы, вовлекая множество участников и позволяя оптимизации моделей эволюционировать в условиях конкуренции. Конкретно: Web2 AutoML напоминает «мощный инструмент», куда пользователь передаёт задачу, а внутренняя система ищет оптимальное решение; тогда как Web3 AutoML, представленный Gradients, скорее похожа на «открытый рынок», где пользователь публикует запрос, участники предлагают различные решения, а результаты отбираются посредством системы оценки. Прямым следствием этих различий является то, что первый подход более стабилен и контролируем, но имеет ограниченные возможности оптимизации; второй же предлагает гораздо большее пространство для исследований и потенциально более высокий потолок эффективности, однако пока уступает в стабильности и зрелости.
6.3 Дифференциация Gradients в Web3-среде
В текущем Web3-секторе ИИ большинство проектов сосредоточено на уровне вывода моделей (inference) или на разработке ИИ-агентов (AI Agents), тогда как проекты, специализирующиеся на «инфраструктуре обучения», встречаются редко. Некоторые из них пытаются комбинировать вычислительные сети или сети данных для предоставления возможностей обучения, однако в целом они по-прежнему находятся на уровне управления ресурсами или формирования рынка вычислительных мощностей. Gradients отличается тем, что она выходит за рамки простого сопоставления вычислительных мощностей и поднимается на уровень самого «механизма оптимизации моделей», вводя системы оценки и конкуренции, которые обеспечивают постоянное эволюционное развитие процесса обучения. Это означает, что Gradients решает не только вопрос «откуда взять вычислительные мощности», но и «как использовать их максимально эффективно». По своей позиции Gradients ближе к «ориентированной на результаты сети обучения», а не к простому рынку вычислительных мощностей или инструментальной платформе — это и есть её ключевое отличие от большинства других Web3-проектов в сфере ИИ.
6.4 Ключевые преимущества: повышение эффективности за счёт механизмов
В целом преимущества Gradients проистекают из её архитектурного дизайна. Во-первых, абстракция задач снижает порог входа: пользователю не нужно углубляться в сложные технические детали обучения, чтобы получить рабочую модель, что расширяет потенциальную аудиторию. Во-вторых, использование распределённых вычислительных мощностей устраняет зависимость от одного облачного провайдера и теоретически позволяет сформировать более гибкую и конкурентную ценовую структуру. Но главное — это изменение подхода к оптимизации: за счёт параллельного исследования множества вариантов с последующим отбором Gradients предлагает альтернативу традиционной однопутевой оптимизации, позволяя моделям достигать более высокого качества за меньшее время. Именно «конкуренция как двигатель оптимизации» является её фундаментальным преимуществом.
6.5 Потенциальные вызовы
Возможны проблемы со стабильностью качества моделей. Децентрализованное обучение полагается на участие множества сторон: хотя это и повышает потолок эффективности, оно может приводить к колебаниям результатов и снижать предсказуемость по сравнению с централизованными системами. Во-вторых, существует проблема доверия со стороны корпоративных клиентов. Для предприятий безопасность данных и проверяемость процесса обучения имеют первостепенное значение, и в децентрализованной среде обеспечение защиты данных от злоупотреблений и аудита результатов остаётся ключевым вызовом. В-третьих, проект сильно зависит от токеномики. Функционирование Gradients напрямую зависит от экономической модели стимулирования: если доходность в TAO снизится, это может негативно повлиять на вовлечённость майнеров и общую активность сети. Таким образом, её долгосрочная устойчивость в значительной степени зависит от способности экономической модели формировать стабильный положительный цикл.
7. Перспективы развития: может ли децентрализованный AutoML стать жизнеспособной парадигмой?
На данном этапе Gradients находится в начальной стадии развития, и её будущий успех будет зависеть от нескольких ключевых факторов. Главный из них — способность привлекать устойчивый спрос на реальное обучение моделей, а не только участие, мотивированное исключительно экономическими стимулами. Второй — качество моделей: сможет ли децентрализованный подход стабильно генерировать пригодные к использованию, а возможно, и превосходящие по качеству результаты. И третий — устойчивость экономической модели: сможет ли она обеспечить долгосрочный баланс между предложением вычислительных мощностей и получаемыми доходами.
В более широком отраслевом контексте обучение ИИ начинает развиваться по двум параллельным траекториям. Первая — это Web2-модель, которой руководят ведущие технологические компании, концентрирующие ресурсы и инженерные возможности для постоянного улучшения производительности моделей; её преимущество — стабильность и зрелость. Вторая — это Web3-путь, представленный Gradients, который строит открытую сеть и использует экономические стимулы для вовлечения максимального числа участников в совместную оптимизацию моделей и постоянное повышение потолка эффективности. Первая траектория направлена на «создание более мощной системы», вторая — скорее на «построение самоэволюционирующей сети».
С этой точки зрения исследовательские усилия Gradients открывают новую возможность: обучение ИИ перестаёт быть чисто технической задачей и превращается в синтез «вычислительных мощностей + данных + рыночных механизмов». Если данная модель окажется жизнеспособной, Gradients потенциально может стать ключевым входным уровнем для децентрализованного ИИ и играть роль критически важной инфраструктурной составляющей в экосистеме Bittensor. Конечно, это направление требует времени для проверки, однако уже сейчас оно предлагает альтернативный путь развития AutoML, принципиально отличающийся от традиционных подходов.
Ссылки
1. Документация Bittensor: https://docs.learnbittensor.org
2. Веб-сайт Gradients: https://www.gradients.io/
3. Gradients: https://bittensormarketcap.com/subnets/56
4. Gradients в X: https://x.com/gradients_ai
5. Taostats: https://taostats.io/subnets/56/chart
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News











