


8 уровней инженерии агентов
Автор:Бассим Эледат
Подготовка: Бао Юй
Возможности ИИ в программировании опережают нашу способность ими управлять. Именно поэтому все эти попытки изо всех сил набрать очки в SWE-bench не синхронизированы с метриками продуктивности, которые действительно интересуют инженерное руководство. Команда Anthropic запустила Cowork всего за 10 дней, тогда как другая команда, используя ту же модель, не смогла даже завершить POC (доказательство концепции) — разница заключается в том, что одна команда уже преодолела разрыв между возможностями и практикой, а другая ещё нет.
Этот разрыв не исчезнет за одну ночь; он будет сокращаться постепенно, по уровням. Всего их восемь. Большинство читателей этой статьи, вероятно, уже прошли первые несколько уровней, но вы должны стремиться к следующему — потому что каждый новый уровень означает огромный скачок в производительности, а каждое улучшение возможностей модели лишь многократно усиливает этот эффект.
Ещё одна причина, на которую стоит обратить внимание, — эффект многопользовательского взаимодействия. Ваш результат больше зависит от уровня ваших коллег, чем вы думаете. Представьте, что вы эксперт 7-го уровня: пока вы спите, фоновые агенты уже подготовили для вас несколько пулл-реквестов (PR). Но если для слияния вашего кода в репозиторий требуется одобрение коллегой, который всё ещё на 2-м уровне и вручную проверяет PR, ваша пропускная способность оказывается заблокированной. Поэтому помощь коллегам в повышении их уровня выгодна и вам.
После общения со множеством команд и отдельных разработчиков об опыте использования ИИ-помощников в программировании, вот эволюционный путь повышения уровней, который я наблюдаю (порядок не является абсолютным):
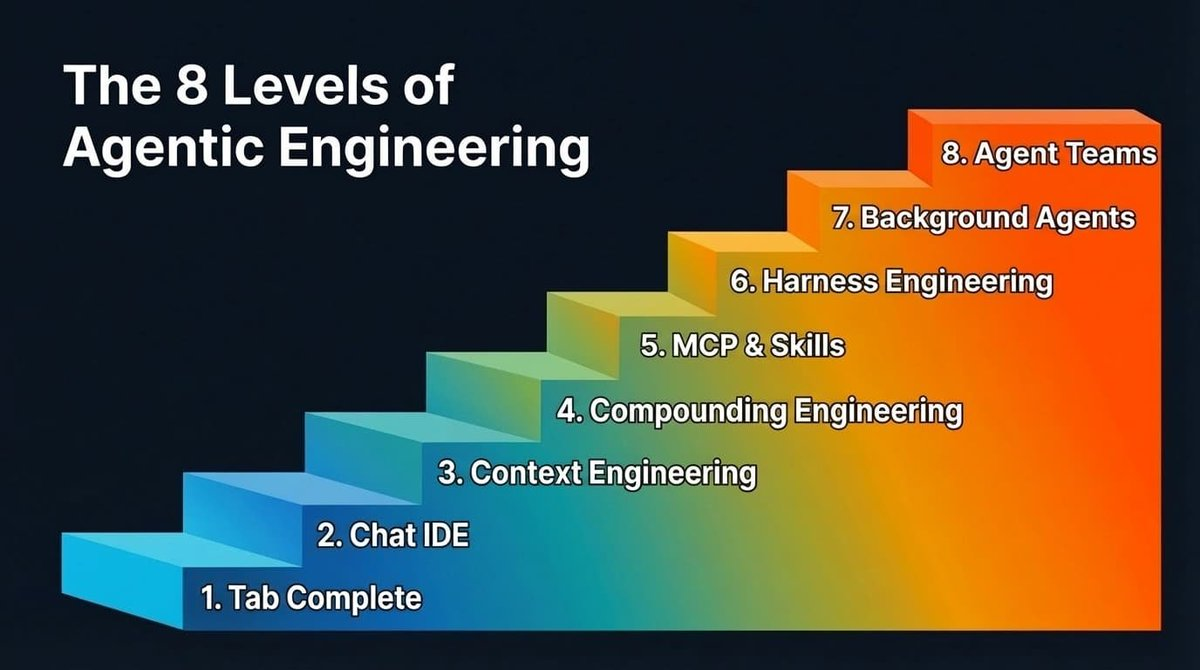
8 уровней агентной инженерии
Уровни 1 и 2: Автозаполнение по Tab и IDE на основе агентов
Эти два уровня я проведу быстро, просто чтобы сохранить полноту описания. Можете свободно перескакивать их.
Автозаполнение по Tab — это отправная точка всего. GitHub Copilot открыл эту эпоху — нажал клавишу Tab, и код дополнился автоматически. Многие, возможно, уже забыли об этом этапе, а новички могли его сразу пропустить. Он больше подходит опытным разработчикам, которые сначала создают скелет кода, а затем поручают ИИ заполнять детали.
Специализированные IDE на базе ИИ, такие как Cursor, изменили расклады, связав чат с репозиторием кода и значительно облегчив редактирование между файлами. Но потолок остаётся ограниченным контекстом. Модель может обрабатывать только то, что она «видит», и вызывает раздражение тот факт, что либо она упускает нужный контекст, либо получает слишком много нерелевантной информации.
Большинство пользователей этого уровня также пробуют режим планирования выбранных ИИ-агентов: превращают грубую идею в структурированный пошаговый план для LLM, многократно его уточняют, а затем запускают выполнение. На этом этапе это работает хорошо и позволяет сохранять контроль. Однако на более высоких уровнях мы увидим, что зависимость от режима планирования будет постепенно снижаться.
Уровень 3: Инжиниринг контекста
Теперь переходим к самому интересному. Инжиниринг контекста (Context Engineering) стал главным трендом 2025 года. Это понятие оформилось, потому что модели наконец стали надёжно выполнять разумный объём инструкций при предоставлении соответствующего контекста. Зашумлённый контекст так же плох, как и недостаточный, поэтому основная задача заключается в повышении информационной плотности каждого токена. «Каждый токен должен бороться за своё место в промпте» — именно этим принципом руководствовались в те времена.
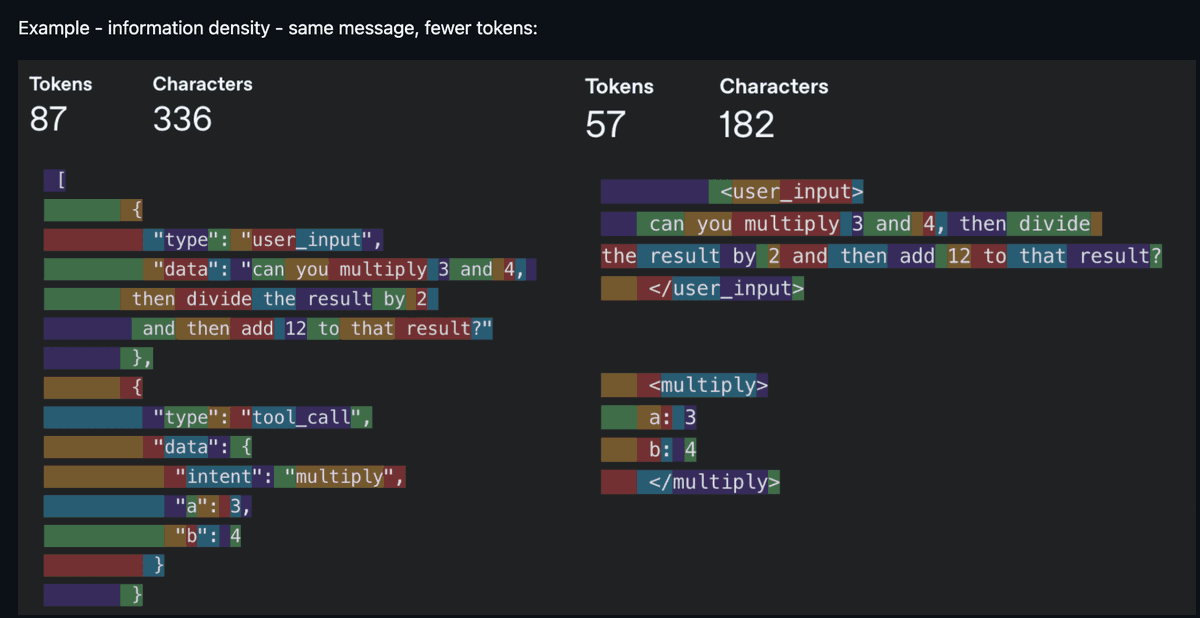
Та же информация, меньше токенов — информационная плотность решает (источник: humanlayer/12-factor-agents)
На практике инжиниринг контекста охватывает гораздо больше аспектов, чем многие осознают. Он включает ваши системные промпты и файлы правил (.cursorrules, CLAUDE.md). Он включает описание инструментов, поскольку модель анализирует их, чтобы решить, какой инструмент вызвать. Он включает управление историей диалогов, чтобы долгосрочные агенты не терялись после десятого витка беседы. Он также включает решение о том, какие инструменты доступны на каждом шаге, потому что избыток вариантов ставит модель в тупик — точно так же, как человека.
Сейчас вы реже слышите термин «инжиниринг контекста». Чаша весов склонилась в сторону моделей, способных работать с более зашумлённым контекстом и сохранять качество рассуждений в более хаотичных условиях (большее окно контекста тоже играет роль). Однако расход контекста по-прежнему имеет значение. В следующих сценариях он всё ещё становится узким местом:
- Маленькие модели более чувствительны к контексту. Приложения голосового взаимодействия обычно используют компактные модели, кроме того, размер контекста коррелирует с задержкой появления первого токена, что сказывается на скорости ответа.
- Ресурсоёмкие операции. MCP (Model Context Protocol, протокол контекста модели), например через Playwright, и загрузка изображений быстро расходуют токены, из-за чего в Claude Code вы скорее ожидаемого столкнётесь со статусом «сжатие сессии».
- Агенты с десятками подключённых инструментов. Токены на парсинг определений инструментов уходят быстрее, чем на само выполнение задач.
Более глобальный вывод: инжиниринг контекста не исчез, он лишь эволюционировал. Акцент сместился с фильтрации «плохого» контекста на обеспечение появления правильного контекста в нужное время. Именно этот переход подготовил почву для уровня 4.
Уровень 4: Композиционная инженерия
Инжиниринг контекста улучшает текущую сессию. Инженерия накопления эффекта (Compounding Engineering, предложенная Кьераном Клаассеном) улучшает каждую последующую сессию. Эта идея стала переломным моментом для меня и многих других — она показала, что «программирование на ощупь» далеко не всегда сводится к созданию прототипов.
Это цикл «планирование, делегирование, оценка, закрепление знаний». Вы планируете задачу, предоставляете LLM достаточный контекст для успеха. Делегируете задачу. Оцениваете результат. Затем ключевой шаг — закрепляете полученные знания: что сработало, где возникли проблемы, какие паттерны использовать дальше.
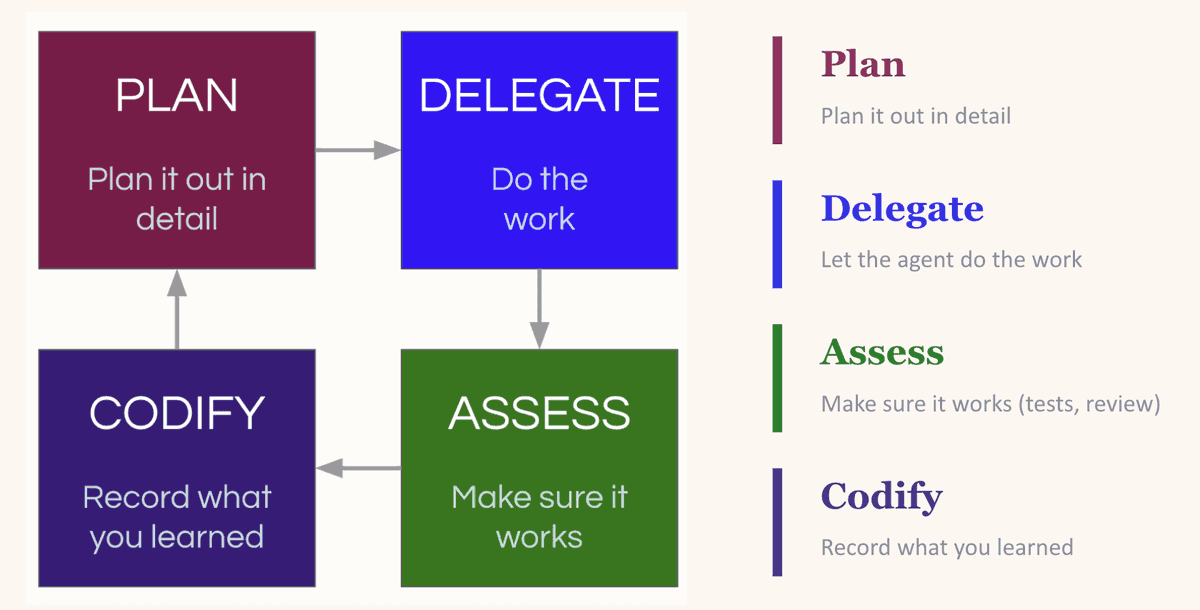
Цикл накопления: планирование, делегирование, оценка, закрепление — каждый виток делает следующий лучше
Магия заключена в этапе «закрепления знаний». LLM не обладают состоянием. Если вчера она случайно вернула зависимость, которую вы явно удалили, завтра она сделает это снова, пока вы прямо не укажете иное. Самый распространённый способ решения — обновить CLAUDE.md (или аналогичный файл правил), закрепив выводы для всех будущих сессий. Однако стоит быть осторожным: желание впихнуть в файл правил всё подряд может дать обратный эффект (слишком много инструкций равнозначно их отсутствию). Лучше создать среду, где LLM сможет самостоятельно легко находить полезный контекст — например, поддерживая актуальную папку docs/ (подробнее об этом на уровне 7).
Практикующие композиционную инженерию обычно очень тонко чувствуют контекст, подаваемый в LLM. Когда модель ошибается, их первая мысль — нехватка контекста, а не проблема самой модели. Именно такая интуиция открывает путь к уровням с 5 по 8.
Уровень 5: MCP и навыки
Уровни 3 и 4 решают проблему контекста. Уровень 5 решает проблему возможностей. MCP и кастомные навыки дают вашей LLM доступ к базам данных, API, CI-конвейерам, дизайн-системам, а также к Playwright для браузерного тестирования и Slack для уведомлений. Модель теперь не просто анализирует ваш код — она способна напрямую взаимодействовать с ним.
По MCP и навыкам уже есть множество качественных материалов, поэтому я не буду повторяться. Приведу лишь примеры их использования нашей командой: мы разделяем общий навык проверки PR, который совместно дорабатываем (процесс продолжается). Он условно запускает дочерних агентов в зависимости от характера PR. Один проверяет безопасность интеграции с БД, другой проводит анализ сложности для выявления избыточности или переусложнения, третий оценивает состояние промптов на соответствие стандартам команды. Также он запускает линтеры и Ruff.
Зачем вкладывать столько ресурсов в навыки проверки? Потому что когда агенты начинают массово генерировать PR, ручная проверка превращается в узкое место, а не в фильтр качества. Latent Space высказал убедительное мнение: традиционный code review мёртв. На смену ему приходят автоматизированные, предсказуемые проверки, управляемые навыками.
Что касается MCP, я использую Braintrust MCP, чтобы LLM могла запрашивать логи оценки и вносить правки напрямую. DeepWiki MCP позволяет агентам получать доступ к документации любых open-source репозиториев без необходимости вручную загружать её в контекст.
Когда несколько человек в команде начинают писать похожие навыки автономно, возникает смысл объединить их в единый shared registry. Block (примите наши соболезнования) опубликовали отличную статью: они создали внутренний маркетплейс навыков со списком из 100+ инструментов и настроили подборки под конкретные роли и команды. Навыки обслуживаются по тем же стандартам, что и код: pull request, code review, история версий.
Стоит отметить ещё один важный тренд: LLM всё чаще предпочитают CLI-инструменты вместо MCP (и каждая компания вроде бы выпускает свой собственный: Google Workspace CLI, скоро появится и от Braintrust). Причина — эффективность использования токенов. MCP-серверы на каждом витке инжектируют полные определения инструментов в контекст, независимо от того, используются ли они. CLI работает наоборот: агент выполняет целевую команду, и в окно контекста попадает только релевантный вывод. Я активно использую agent-browser вместо Playwright MCP именно по этой причине.
Прежде чем двигаться дальше, краткая остановка. Уровни с 3 по 5 — фундамент всего остального. LLM поражают своими сильными сторонами в одних областях и такими же неожиданными слабыми местами в других. Вам нужно выработать интуицию относительно этих границ, прежде чем накладывать сверху дополнительные слои автоматизации. Если ваш контекст зашумлён, промпты недостаточны или неточны, а описания инструментов размыты, уровни с 6 по 8 лишь усугубят эти проблемы.
Уровень 6: Инжиниринг рабочих сред (Harness Engineering)
Здесь ракета по-настоящему набирает высоту.
Инжиниринг контекста фокусируется на том, что видит модель. Инжиниринг рабочих сред (Harness Engineering) сосредоточен на создании полной инфраструктуры — инструментов, архитектуры и контуров обратной связи — позволяющих агенту надёжно функционировать без вашего вмешательства. Агенту даётся не просто редактор, а полноценный контур обратной связи.
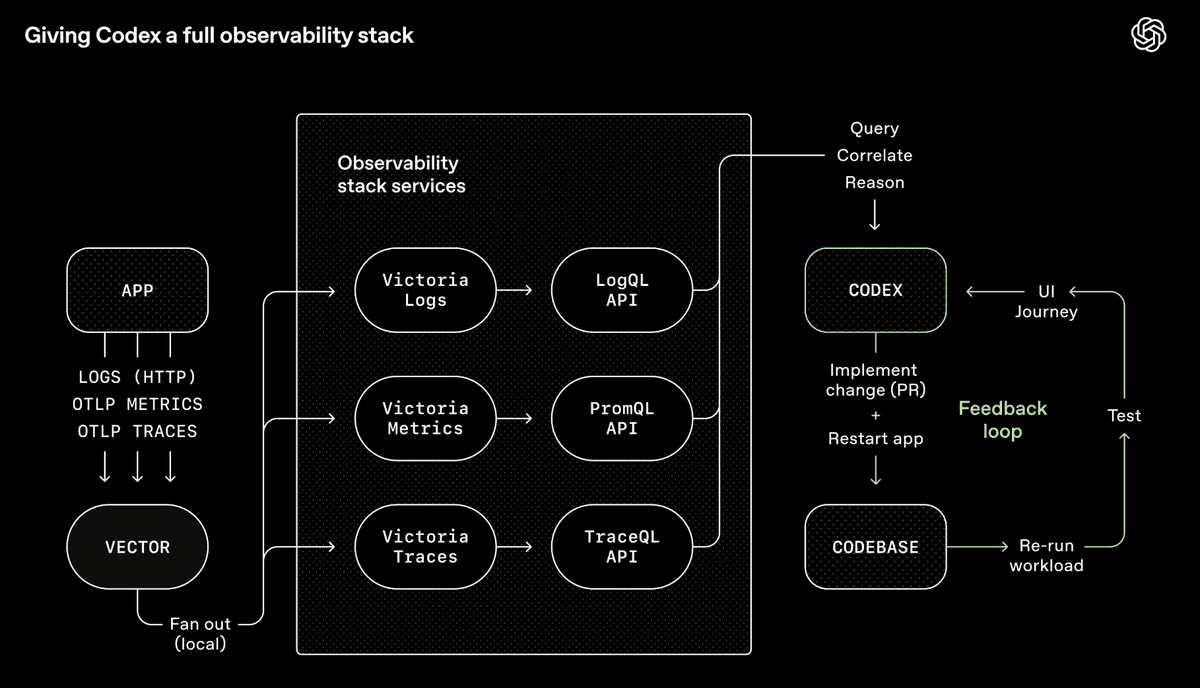
Инструментарий OpenAI Codex — полная система наблюдаемости, позволяющая агентам опрашивать, связывать и делать выводы на основе собственных результатов (источник: OpenAI)
Команда Codex от OpenAI интегрировала Chrome DevTools, инструменты наблюдаемости и навигацию по браузеру прямо в среду выполнения агента, добавив возможности скриншотов, управления UI-флоу, запросов к логам и валидации собственных исправлений. Получив один промпт, агент способен воспроизвести баг, записать видеофиксацию, внедрить фикс. Затем он проверяет результат через взаимодействие с приложением, создаёт PR, отвечает на замечания по ревью, сливает изменения — и привлекает человека только там, где нужна экспертиза. Агент не просто пишет код: он видит последствия своих изменений и итерирует улучшения — точь-в-точь как человек.
Моя команда занимается разговорными и чат-агентами для диагностики технических сбоев, поэтому я создал CLI-утилиту под названием converse, которая позволяет любой LLM общаться с нашим бэкендом в формате поэтапных диалогов. После внесения изменений в код LLM тестирует диалоги через converse на боевой системе, после чего итерирует. Иногда цикл самоусовершенствования может длиться часами без остановки. Этот подход особенно мощен, когда результат можно проверить: диалог обязан следовать заданному флоу или вызывать определённые инструменты в конкретных сценариях (например, перевод на оператора колл-центра).
Фундаментальной концепцией, стоящей за всем этим, является механизм обратного давления (Backpressure) — автоматизированные контуры обратной связи (типизация, тесты, линтеры, pre-commit хуки), позволяющие агенту обнаруживать и исправлять ошибки без ручного вмешательства. Хотите автономность? Требуются механизмы backpressure, иначе вы получите машину по генерации брака. Это напрямую относится и к безопасности. CTO Vercel отмечает, что агенты, генерируемый ими код и ваши учётные данные должны находиться в разных доменах доверия, поскольку инъекция промпта, скрытая в логах, может спровоцировать агента на кражу ваших ключей — если всё делит одно пространство безопасности. Границы безопасности выступают формой backpressure: они ограничивают действия агента в случае выхода из-под контроля, а не просто предписывают корректное поведение.
Два принципа, проясняющие эту концепцию:
- Проектируйте для пропускной способности, а не для совершенства. Когда требуете идеального коммита, агент будет зацикливаться на одном баге, перезаписывая исправления друг друга. Лучше tolerated мелкие незаблокирующие ошибки и проводить финальную проверку качества непосредственно перед релизом. С коллегами-людьми мы поступаем точно так же.
- Ограничения эффективнее инструкций. Пошаговые подсказки («сначала сделай А, потом В, затем С») выходят из моды. На мой взгляд, определение границ работает лучше составления списков, потому что агент будет слепо следовать пунктам списка, игнорируя всё за его пределами. Более эффективный промпт звучит так: «Я хочу получить вот такой результат. Продолжай, пока не пройдёшь все эти тесты».
Вторая половина Harness Engineering — обеспечение свободы навигации агента в репозитории без вашего участия. Подход OpenAI таков: держите AGENTS.md строго до 100 строк, используйте его как индекс для остальных структурированных документов, а актуальность этих документов включите в CI-пайплайн, не полагаясь на хаотичные ручные обновления, которые устаревают мгновенно.
Когда всё это построено, естественно возникает вопрос: если агент умеет проверять свою работу, свободно ориентироваться в репозитории и исправлять ошибки без тебя — зачем тебе вообще сидеть за столом?
Предупреждение: для тех, кто пока находится на ранних уровнях, дальнейшее может показаться научной фантастикой (ничего страшного, добавьте в избранное и вернитесь позже).
Уровень 7: Фоновые агенты
Жёсткий вердикт: режим планирования умирает.
Создатель Claude Code Борис Черни в настоящее время всё ещё начинает 80% задач через режим планирования. Однако с каждым новым выпуском моделей вероятность успешного выполнения задачи с одного раза после планирования постоянно растёт. Я считаю, мы приближаемся к точке невозврата, когда самостоятельный этап ручного планирования полностью исчезнет. Не потому, что планирование менее важно, а потому, что модели станут достаточно умными, чтобы строить планы самостоятельно. Но есть важное условие: это справедливо только при условии качественно пройденных уровней с 3 по 6. Если ваш контекст чист, ограничения ясны, описания инструментов полны, а контуры обратной связи замкнуты, модель сможет надёжно планировать без вашей сверки. Пока эти условия не соблюдены, вам придётся контролировать план вручную.
Чтобы избежать недопонимания: планирование как практика не исчезнет, оно трансформируется. Для новичков режим планирования остаётся правильным входом (как указано на уровнях 1 и 2). Но для сложных задач уровня 7 «планирование» выглядит не как составление пошагового плана, а скорее как исследование: сканирование репозитория, эксперименты в worktree, изучение пространства возможных решений. И всё чаще это исследование за вас выполняют фоновые агенты.
Это критически важно, ведь именно здесь открывается дверь к фоновым агентам. Если агент способен сгенерировать адекватный план, подтвердить его и выполнить без вашего постоянного согласования, он сможет работать асинхронно, пока вы занимаетесь другими делами. Происходит фундаментальный сдвиг: от «я одновременно переключаюсь между десятком вкладок» к «задачи продвигаются в фоне без моего участия».
Цикл Ральфа (Ralph loop) — популярный стартовый механизм: автономный цикл агента, многократно запускающий программирующий CLI до полного закрытия пунктов в PRD (техническом задании). Каждая итерация стартует с совершенно новым контекстом. На практике успешно загонять цикл Ральфа сложно: любая неточность или пробел в PRD рано или поздно выйдет боком. Механизм слишком напоминает стратегию «бросил и забыл».
Запуская циклы Ральфа параллельно, вы быстро заметите, куда уходит время: координация, приоритизация задач, контроль выводов, драйв прогресса. Вы перестаёте писать код и превращаетесь в среднего менеджера. Вам нужен оркестратор-агент для управления расписанием, чтобы вы могли сфокусироваться на намерениях, а не на логистике.
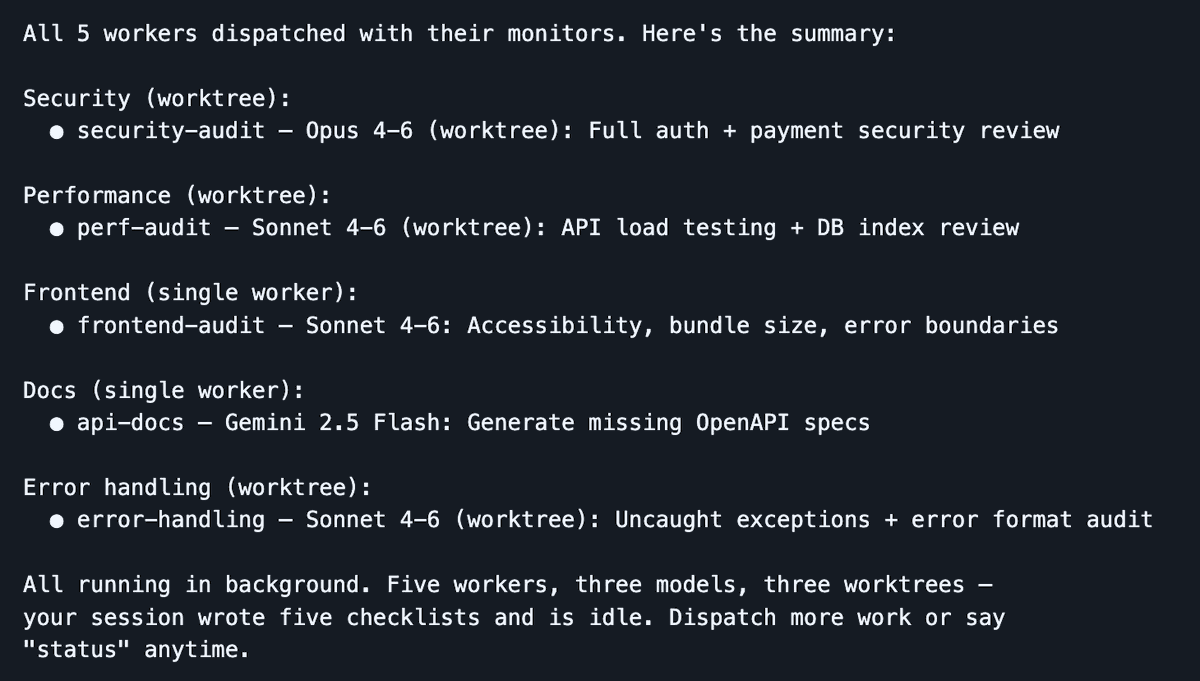
Dispatch запускает 5 воркеров параллельно через 3 разные модели — ваш сеанс остаётся чистым, агенты работают
Недавно я начал активно использовать Dispatch — созданное мной навык для Claude Code, превращающее ваш сеанс в диспетчерский центр. Вы остаётесь в чистом окне, а воркеры исполняют грязную работу в изолированных контекстах. Планированием, делегированием и трекингом управляет планировщик, ваше основное окно контекста сохраняется исключительно для оркестрации. Если воркер застревает, он задаёт уточняющий вопрос, а не падает молча.
Dispatch работает локально и идеально подходит для быстрого разработки, где важна близость к процессу: быстрый фидбек, удобное дебаггинг, нулевые затраты на инфраструктуру. Inspect от Ramp выступает дополнением для длительных и высокоавтономных задач: каждый сеанс агента стартует в облачной песочнице VM с полным стеком разработки. Менеджер продукта нашёл UI-баг, отметил его в Slack, и Inspect берёт задачу в свои руки, пока ноутбук закрыт. Цена — сложность поддержки (инфраструктура, снапшоты, безопасность), но взамен вы получаете масштабируемость и воспроизводимость, недоступные локальным агентам. Рекомендую использовать оба варианта (локальные и облачные фоновые агенты).
На этом уровне кроется невероятно мощный паттерн: распределять разные типы работ между разными моделями. Лучшие инженерные команды состоят не из клонированных копий. Коллеги думают по-разному, имеют разный опыт и сильные стороны. Та же логика применима к LLM. Эти модели прошли различную дообучку и обладают ярко выраженными характерами. Я часто доверяю реализацию задач Opus, исследовательскую работу — Gemini, а проверку качества — Codex. Совокупный результат превосходит работу любой отдельной модели. Можно назвать это коллективным интеллектом, применённым к написанию кода.
Критически важно разделить реализации и проверки. Я на горьком опыте убедился в этом неоднократно: если один и тот же экземпляр модели отвечает и за создание кода, и за его оценку, возникает предвзятость. Она проигнорирует дефекты и сообщит, что всё готово, хотя это не так. Это не злой умысел, это естественное человеческое поведение, перенесённое на модель (никто сам себя на экзамене честно не оценивает). Поручите проверку другому экземпляру или модели со специальным промптом для ревью. Качество сигнала заметно возрастет.
Фоновые агенты также открывают шлюзы для интеграции CI и ИИ. Как только агенты могут функционировать без человеческого контроля, их можно триггерить из существующей инфраструктуры. Документирующий бот перегенерирует документацию после каждого мерджа и создаст PR для обновления CLAUDE.md (мы используем это, экономя массу времени). Бот проверки безопасности сканирует PR и предлагает патчи. Бот управления зависимостями не просто помечает устаревшие пакеты, а реально апгрейдит их и прогоняет тестовые кейсы. Хороший контекст, накапливаемые правила, мощные инструменты, автоматизированные контуры обратной связи — теперь всё работает автономно.
Уровень 8: Автономные команды агентов
Никто ещё по-настоящему не освоил этот уровень, несмотря на то что некоторые уже делают первые шаги в этом направлении. Это сегодняшняя грань прогресса.
На уровне 7 у вас есть оркестратор, распределяющий задачи рабочим LLM по звездообразной схеме. Уровень 8 устраняет эту точку единственного отказа. Агенты координируются напрямую — берут задачи, делятся выводами, отмечают зависимости, разрешают конфликты — всё без посредничества центрального контролёра.
Экспериментальная функция Agent Teams в Claude Code служит ранней реализацией этого подхода: несколько инстансов параллельно работают над общим репозиторием, коллеги функционируют в своих окнах контекста и обмениваются сообщениями напрямую. Anthropic собрала с нуля компилятор C для Linux, задействовав 16 параллельных агентов. Cursor неделю гонял сотни конкурентных агентов для создания собственного браузера и миграции своего репозитория с Solid на React.
Но при ближайшем рассмотрении всплывают проблемы. Cursor обнаружил, что без иерархии агенты становятся нерешительными и крутятся на месте без реального прогресса. Агенты Anthropic постоянно ломали существующий функционал, пока не внедрили CI-конвейер для защиты от регрессий. Все, кто экспериментирует на этом уровне, говорят одно: координация мультиагентных систем — крайне сложная задача, оптимального решения пока не найдено.
Честно говоря, я не думаю, что модели готовы к такому уровню автономии для большинства задач. Даже если они умнее, проекты уровня «высадки на Луну» (кроме сборки компиляторов и браузеров) для них всё ещё слишком медленные, ресурсоёмкие по токенам и экономически неэффективные (впечатляет, но до зрелости далеко). Для повседневной работы большинства из нас именно уровень 7 даёт настоящий рычаг воздействия. Я не удивлюсь, если однажды уровень 8 станет мейнстримом, но сейчас сконцентрирую усилия именно на уровне 7 (если только вы не Cursor — сами инновации являются вашим бизнесом).
Уровень ?
Неизбежный вопрос «что дальше?».
Как только вы начнёте мастерски оркестрировать команды агентов без существенного трения, нет причин ограничивать интерфейс только текстом. Взаимодействие «голос на голос» (а может, «мышление на мышление»?) с ИИ-разработчиком — это диалоговый Claude Code, а не простой voice-to-text ввод. Это естественный следующий шаг. Посмотрите на приложение, вслух опишите серию изменений и наблюдайте, как они происходят прямо перед вами.
Есть группа энтузиастов, погонявшая за идеальной генерацией в один приём: произнёс желание — получил идеальный результат сразу. Проблема в том, что эта логика строится на предположении, будто люди точно знают, чего хотят. Но мы не знаем. Никогда не знали. Разработка ПО всегда была итеративным процессом, и я уверен, таким и останется. Просто она станет в разы проще, полностью выйдет за рамки текстового интерфейса и пойдет намного быстрее.
Таким образом: на каком вы уровне? Что конкретно вы делаете, чтобы перейти на следующий?
На каком вы уровне?
Как обычно вы начинаете работу над задачей программирования с помощью ИИ?
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News











