


Разбор открытого рекомендательного алгоритма X: какой контент нам стоит подготовить, чтобы материал привлекал больше внимания?
Автор: Дэвид, TechFlow
Днём 20 января X открыл исходный код новой рекомендательной алгоритмической системы.
Комментарий Маска получился довольно интересным: «Мы знаем, что этот алгоритм глупый и нуждается в серьёзной переработке, но по крайней мере вы видите, как мы изо всех сил пытаемся улучшить его в реальном времени. Другие социальные платформы на это не рискнут».
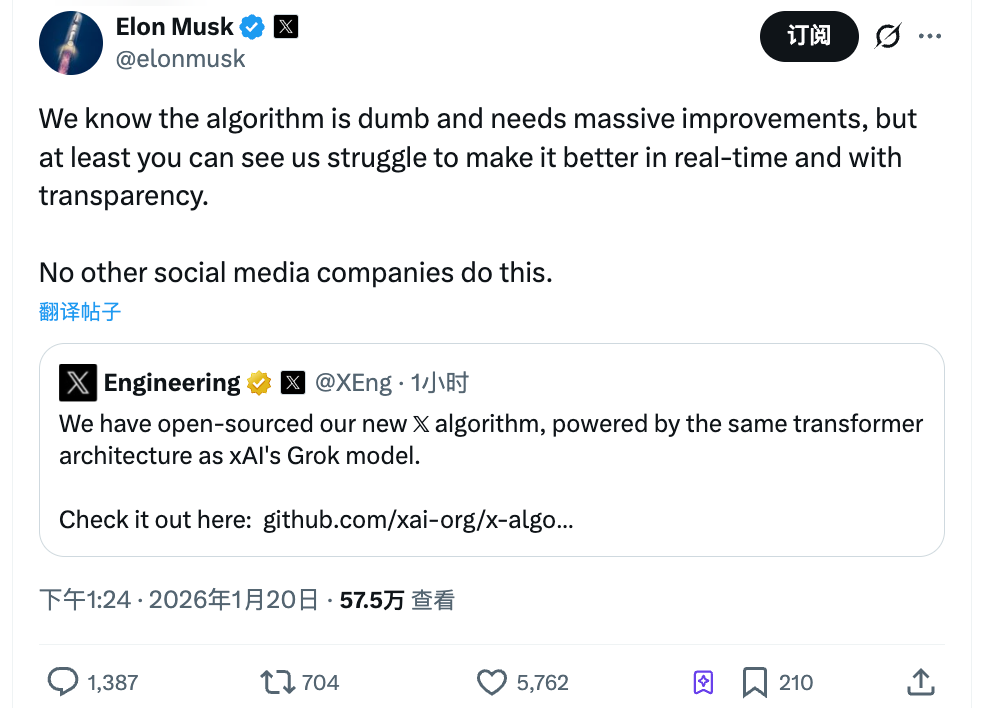
В этих словах заложено два смысла.Первый — признание того, что с алгоритмом есть проблемы, второй — использование «прозрачности» как ключевого преимущества.
Это второе открытие исходного кода алгоритма платформой X. Код версии 2023 года не обновлялся три года и давно отстал от реальной системы. В этот раз он был полностью переписан: базовая модель заменена с традиционного машинного обучения на Grok transformer, согласно официальной формулировке, «полностью устранён ручной инжиниринг признаков».
Если перевести на простой язык: старый алгоритм зависел от ручного подбора параметров инженерами, а теперь ИИ напрямую анализирует вашу историю взаимодействий, чтобы решить, продвигать ли ваш контент или нет.
Для создателей контента это означает, что старые мистические советы вроде «в какое время лучше публиковать» или «какие теги использовать для набора подписчиков» могут потерять актуальность.
Мы также изучили открытый репозиторий на GitHub, при поддержке ИИ обнаружили в коде ряд чётких логических конструкций, которые стоит разобрать подробнее.
Изменение логики алгоритма: от ручного определения к автоматическому решению ИИ
Сначала давайте чётко разграничим различия между старой и новой версиями, чтобы дальнейшее обсуждение не вызывало путаницы.
В 2023 году открытый Твиттером код назывался Heavy Ranker, и по сути представлял собой традиционное машинное обучение. Инженерам приходилось вручную определять сотни «признаков»: есть ли у публикации изображение, сколько подписчиков у автора, сколько времени прошло с момента публикации, содержит ли пост ссылку...
Затем каждому признаку присваивался вес, параметры постоянно менялись, пока не находилась оптимальная комбинация для максимальной эффективности.
Новая открытая версия называется Phoenix, её архитектура совершенно иная. Её можно понять как алгоритм, в гораздо большей степени полагающийся на большие языковые модели; ядром является модель Grok transformer, использующая тот же тип технологий, что и ChatGPT, и Claude.
В официальном файле README написано предельно прямо: «We have eliminated every single hand-engineered feature.»
Правила традиционного ручного извлечения контентных признаков были убраны без исключения.
Так на чём же теперь алгоритм основывает своё решение о том, хорош контент или нет?
Ответ кроется в вашей последовательности действий. Что вы лайкали ранее, кому отвечали, над какими постами задерживались более двух минут, какие типы аккаунтов скрывали. Phoenix подает эти действия в трансформер, позволяя модели самостоятельно выявлять закономерности и делать выводы.
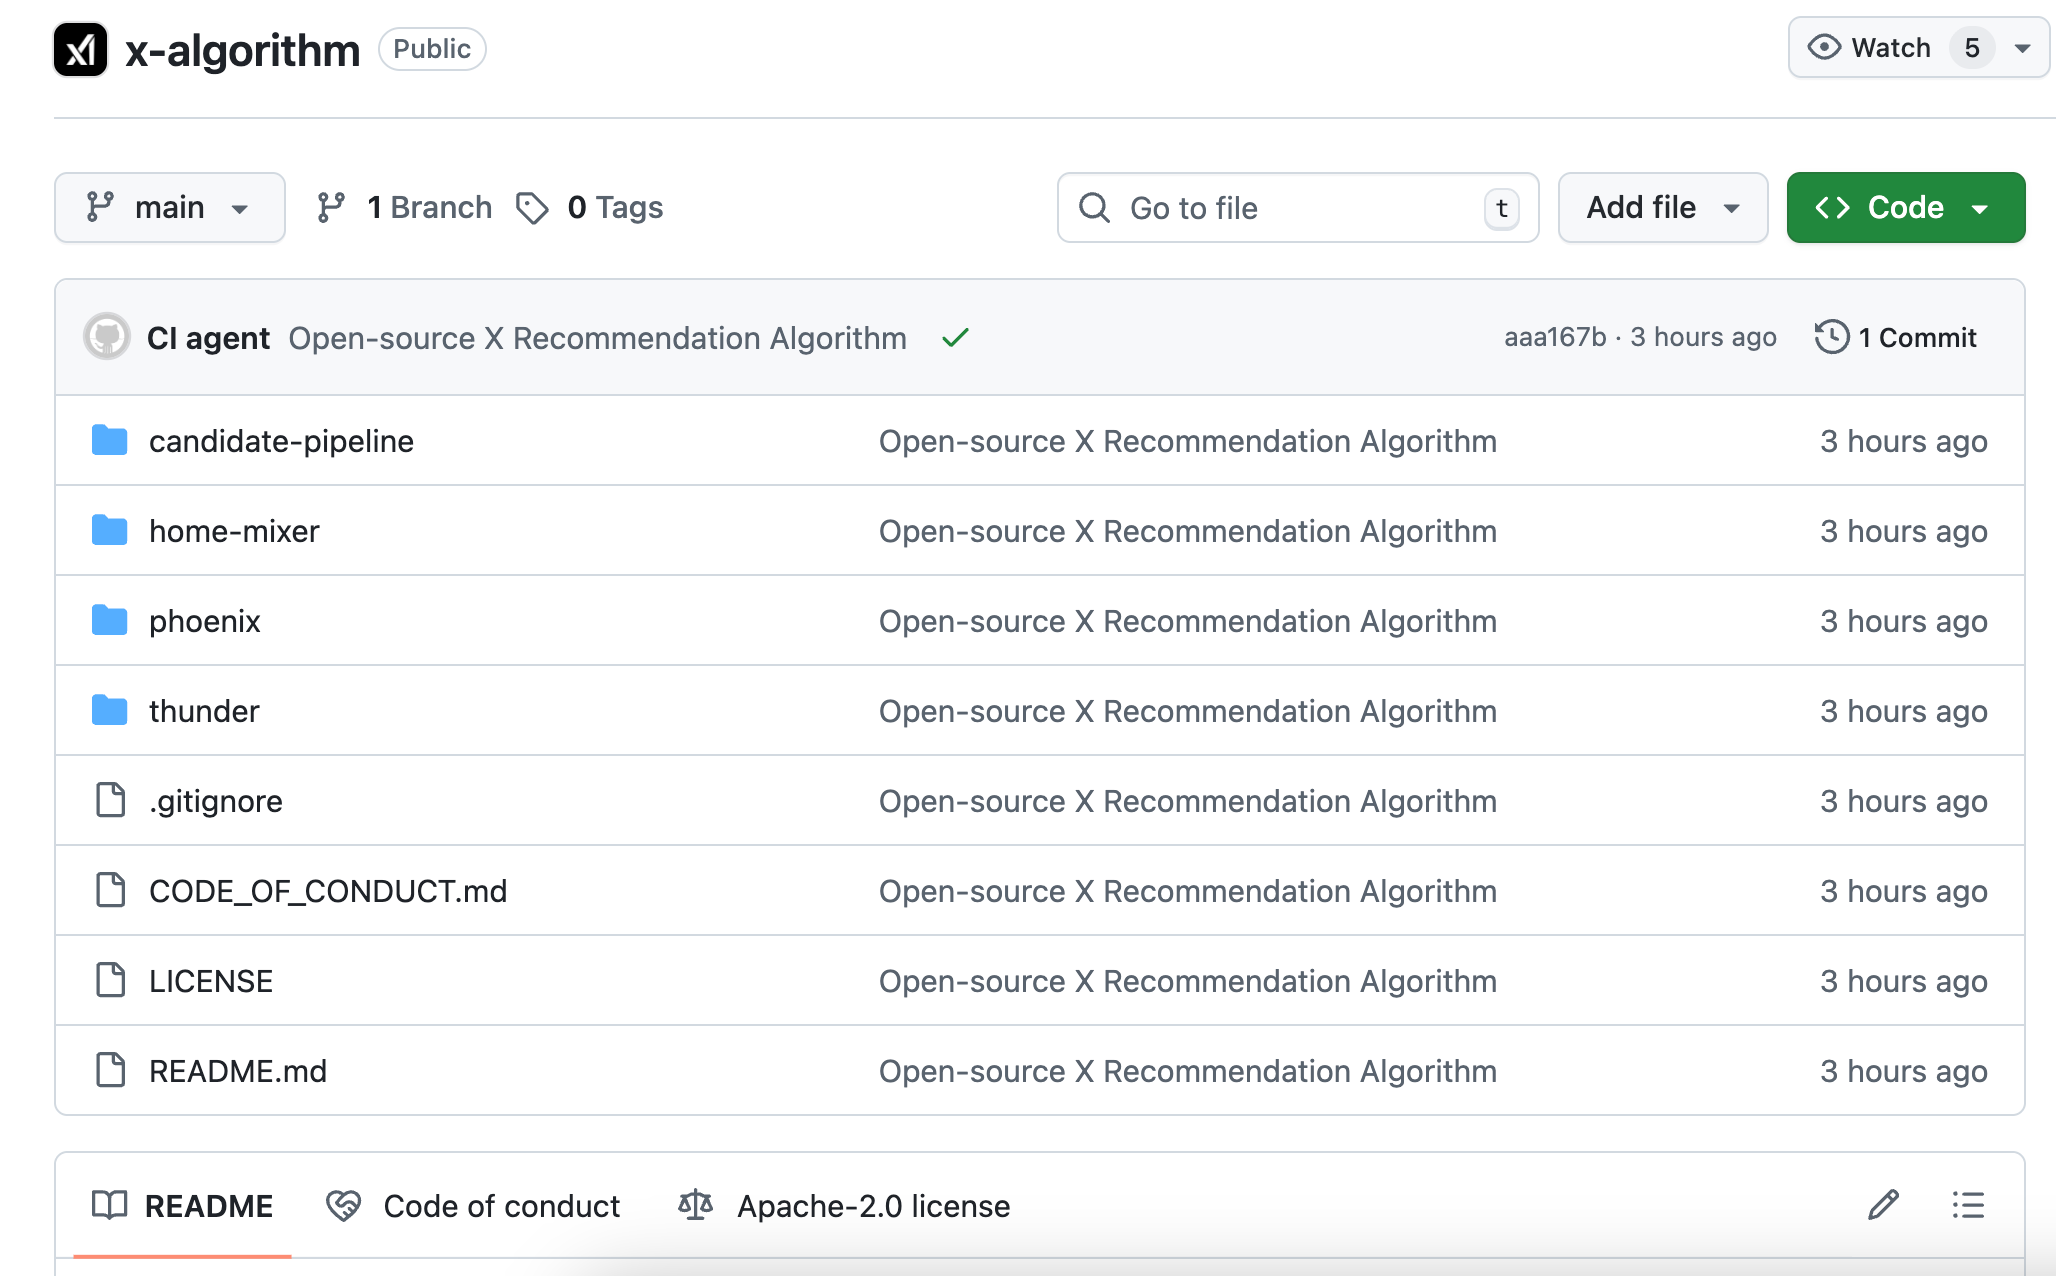
Проще говоря: старый алгоритм похож на составленную вручную таблицу оценивания, где каждый пункт отмечается галочкой и приносит очки;
а новый алгоритм напоминает ИИ, который видел всю вашу историю просмотров и напрямую предсказывает, что вы захотите увидеть следующей секундой.
Для создателей контента это означает две вещи:
Во-первых, ценность старых приемов вроде «лучшего времени для публикации» или «золотых тегов» значительно снизилась. Поскольку модель больше не опирается на эти фиксированные признаки, она учитывает индивидуальные предпочтения каждого пользователя.
Во-вторых, продвижение вашего контента всё больше зависит от того, «как отреагируют люди, увидевшие ваш материал». Эта реакция была квантифицирована в виде 15 видов поведенческих предсказаний, о которых мы поговорим в следующем разделе.
Алгоритм прогнозирует 15 ваших реакций
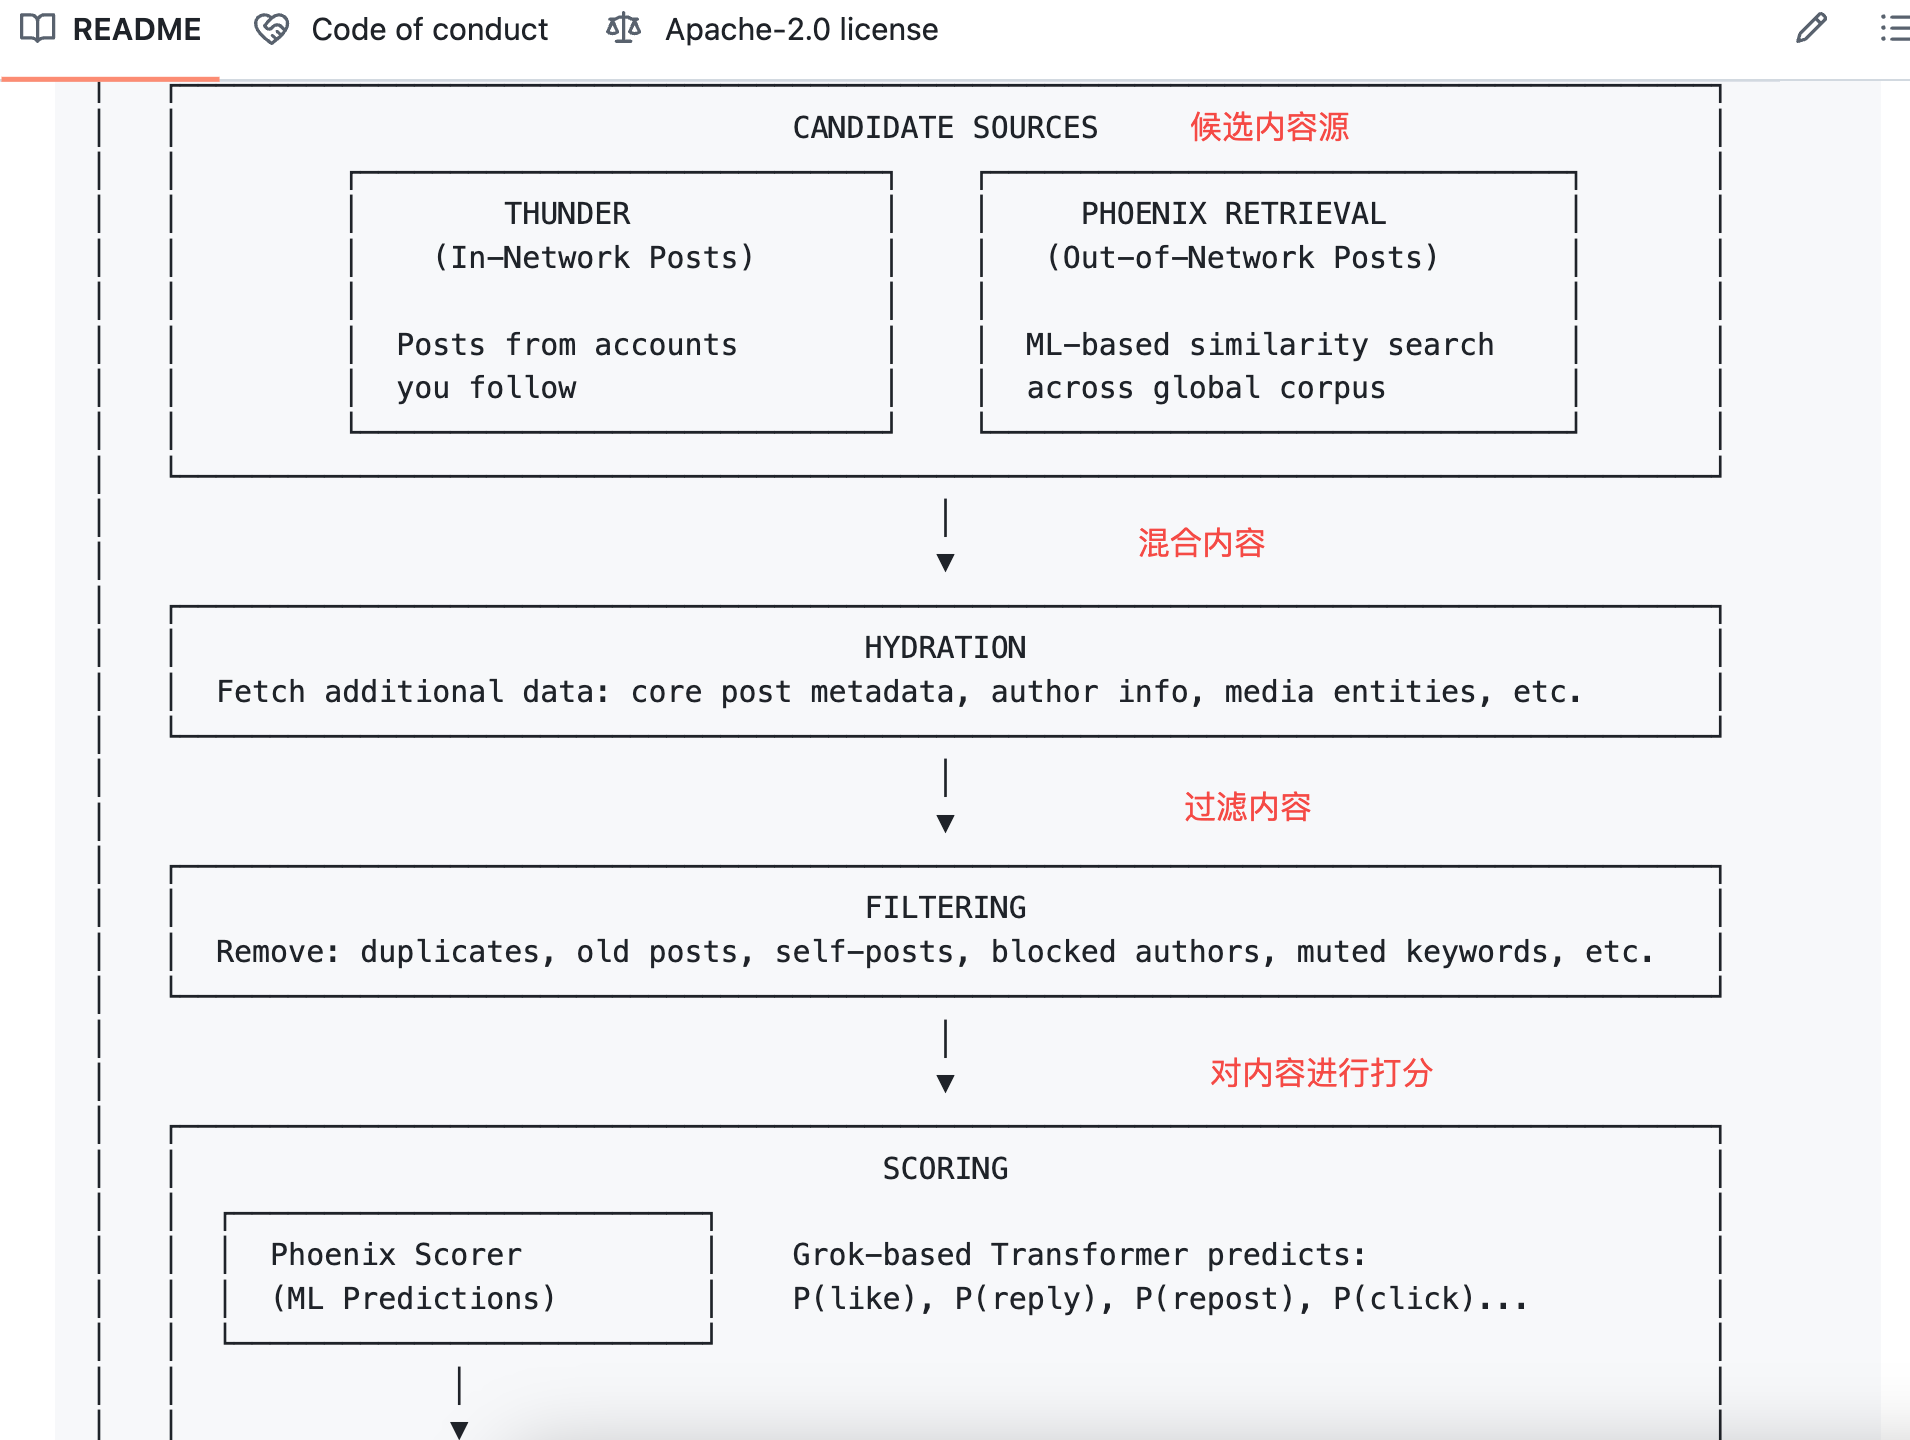
Получив публикацию на рекомендацию, Phoenix прогнозирует 15 возможных реакций текущего пользователя на данный материал:
- Положительные действия: такие как лайк, ответ, репост, цитирование, клик по публикации, переход на профиль автора, просмотр более половины видео, раскрытие изображения, шеринг, удержание внимания свыше определенного времени, подписка на автора
- Отрицательные действия: такие как нажатие «Не интересно», Block автора, Mute автора, жалоба
Каждому действию соответствует вероятностная оценка. Например, модель может определить, что вероятность лайка данного поста составляет 60%, а вероятность блокировки автора — 5%, и так далее.
Затем алгоритм совершает простое действие: умножает каждую вероятность на соответствующий ей вес, суммирует их и получает итоговый балл.
Формула выглядит следующим образом:
Final Score = Σ ( weight × P(action) )
Вес положительных действий имеет положительное значение, а вес отрицательных действий — отрицательное.
Публикации с высоким итоговым баллом поднимаются выше, низкий балл опускает их вниз.
Если говорить простыми словами вне формулы:
Сейчас качество материала действительно уже не определяется исключительно тем, насколько хорошо он написан (разумеется, читабельность и польза остаются основой распространения); оно в большей степени зависит от того, «какую реакцию вызовет эта публикация у вас». Алгоритму безразлично качество самой записи, ему важны только ваши действия.
Размышляя по этой логике, в экстремальных случаях низкокачественный пост, вызывающий непреодолимое желание ответить и покритиковать, может получить больший балл, чем качественный материал, но без единого взаимодействия. Вероятно, именно такова фундаментальная логика данной системы.
Однако в новом открытом коде конкретные числовые значения весов действий не опубликованы, хотя в версии 2023 года они были доступны.
Опорные данные старой версии: одна жалоба равна 738 лайкам
Далее мы можем разобрать данные 2023 года. Несмотря на их возраст, они помогут вам понять, насколько сильно различается «ценность» различных действий в глазах алгоритма.
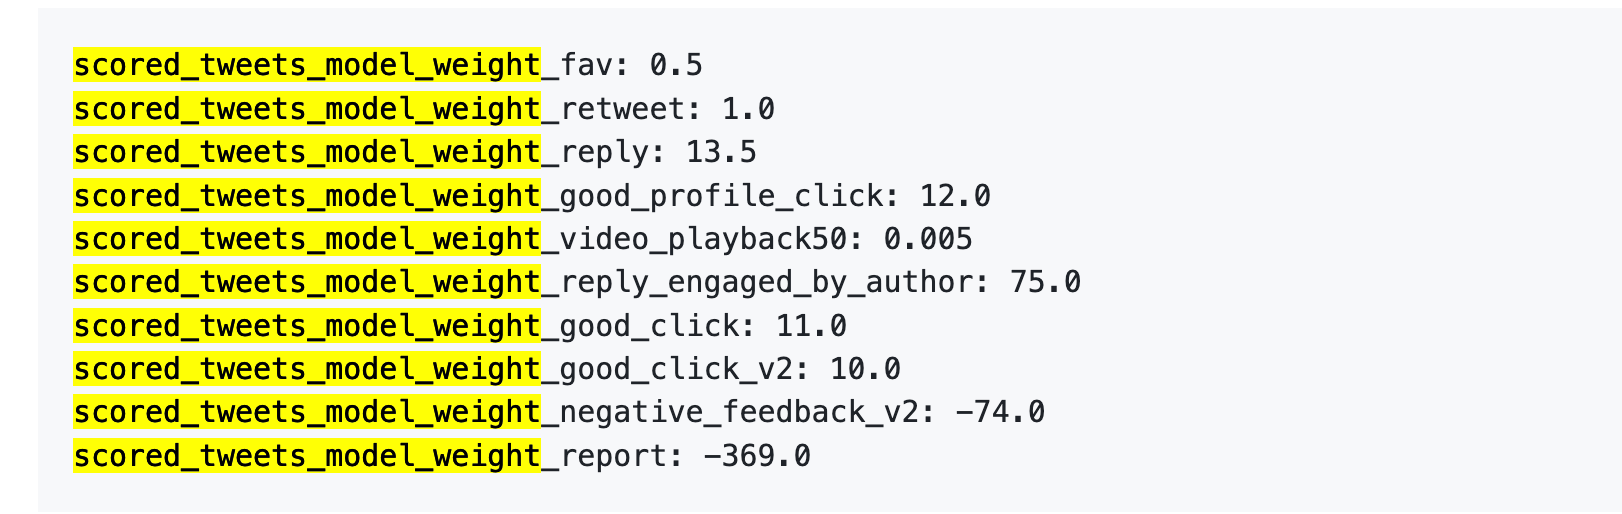
5 апреля 2023 года платформа X действительно опубликовала набор данных о весах на GitHub.
Немного цифр:
Еще проще:

Источник данных: старая версия репозитория GitHub twitter/the-algorithm-ml, нажмите, чтобы посмотреть оригинальный алгоритм
Несколько цифр заслуживают пристального внимания.
Во-первых, лайки почти ничего не стоят. Вес составляет всего 0,5 — минимальный среди всех положительных действий. В глазах алгоритма один лайк равен нулю.
Во-вторых, диалоговое взаимодействие — настоящая валюта. Вес ответа автора на ваш комментарий равен 75, что в 150 раз больше, чем у лайка. Алгоритму больше нравится не одностороннее одобрение, а живой обмен мнениями.
В-третьих, цена обратной отрицательной связи крайне высока. Для нейтрализации одного Block или Mute (-74) требуется 148 лайков. На одну жалобу (-369) нужно 738 лайков. Более того, эти штрафы накапливаются в рейтинге доверия вашего аккаунта, влияя на распределение всех последующих публикаций.
В-четвертых, вес показателя полного просмотра видео невероятно низок. Он составляет лишь 0,005, чем практически можно пренебречь. Это резко контрастирует с Douyin и TikTok, где показатель полноты просмотра считается ключевой метрикой.
В том же официальном документе указывалось: «The exact weights in the file can be adjusted at any time... Since then, we have periodically adjusted the weights to optimize for platform metrics.»
Веса могут быть изменены в любой момент, и они действительно изменялись.
В новой версии конкретные числа не раскрываются, но логическая структура в README осталась прежней: положительные действия добавляют баллы, отрицательные снимают, итог получается путем взвешенной суммы.
Конкретные цифры могли измениться, но соотношение порядковых величин, скорее всего, сохранилось. Ответ на комментарий другого пользователя ценнее, чем 100 лайков. Желание кого-то заблокировать вас хуже, чем полное отсутствие взаимодействия.
Как создателям контента действовать, зная об этом
Проанализировав коды старого и нового алгоритмов Твиттера и сопоставив их, выделим несколько практических рекомендаций.
1. Отвечайте своим комментаторам. В таблице весов «ответ автора комментатору» дает максимальное количество баллов (+75), что в 150 раз больше одностороннего лайка пользователя. Речь не о том, чтобы выпрашивать комментарии, а о том, чтобы отвечать на них. Даже фраза «спасибо» будет учтена алгоритмом.
2. Не давайте повода для быстрого свайпа. Один блок наносит такой негативный ущерб, для нейтрализации которого нужно 148 лайков. Спорные материалы действительно легко провоцируют активность, но если реакция сводится к «этот человек бесит, бань», рейтинг доверия аккаунта будет постепенно падать, что скажется на распространении всех последующих публикаций. Трафик от дискуссий — обоюдоострое оружие: прежде чем цеплять других, убедитесь, что не вредите себе.
3. Размещайте внешние ссылки в комментариях. Алгоритм стремится удержать пользователей внутри платформы. Публикации со ссылками в основном тексте будут понижены в выдаче. Об этом Маск заявлял публично. Если ваша цель — направить трафик, пишите основной контент в посте, а ссылку оставляйте в первом комментарии.
4. Не засоряйте ленту. В новом коде присутствует компонент Author Diversity Scorer, который снижает релевантность публикациям одного и того же автора, идущим подряд. Цель дизайна — сделать ленту пользователя разнообразнее, побочный эффект таков: лучше тщательно подготовить и выпустить один пост, чем разглагольствовать десятком штук подряд.
5. Понятия «лучшего времени для публикации» больше нет. Старый алгоритм использовал признак «время публикации», созданный вручную, который новая версия просто упразднила. Phoenix ориентируется исключительно на последовательность действий пользователя, а не на час выпуска записи. Рекомендации вроде «оптимальное время — вторник в полдень» теряют свою ценность.
Выше приведены выводы, сделанные на основе анализа кода.
Существуют и другие факторы начисления или снятия баллов, описанные в открытых документах X, но отсутствующие в этом репозитории: наличие голубой галочки дает бонус, написание ЗАГЛАВНЫМИ БУКВАМИ приводит к снижению ранжирования, а чувствительный контент ограничивает охват на 80%. Поскольку эти правила не вошли в открытый код, останавливаться на них подробно не будем.
В целом представленный для ознакомления код выглядит весьма практичным.
Здесь описана полная архитектура системы, логика подбора кандидатов, процесс сортировки и выставления баллов, а также реализация различных фильтров. Исходный код написан преимущественно на Rust и Python, отличается четкой структурой, а README составлен даже подробнее, чем во многих коммерческих проектах.
Однако несколько ключевых элементов осталось за кадром.
1. Параметры весов не опубликованы. В коде фигурирует лишь принцип «положительные действия добавляют баллы, отрицательные снимают»; конкретные значения баллов за лайк или снятие баллов за block отсутствуют. В версии 2023 года по крайней мере приводились числа, сейчас предоставлена лишь общая формула.
2. Веса модели не опубликованы. Phoenix использует Grok transformer, однако внутренние параметры самого движка не размещены. Вы можете наблюдать, как модель вызывается, но не видите, как происходят вычисления внутри.
3. Данные для обучения не опубликованы. Ничего не сказано о том, на каких данных обучалась модель, как выбирались примеры поведения пользователей и конструировались положительные и отрицательные выборки.
Если провести аналогию, данный релиз кода равносилен сообщению «мы считаем итоговый балл через взвешенную сумму», но не указывает сами веса; сообщению «мы используем трансформер для прогнозирования вероятностей поведения», но не раскрывает внутреннее устройство этого трансформера.
При сравнении с аналогами стоит отметить, что TikTok и Instagram не раскрывали даже таких деталей. Объем информации, открытый платформой X, действительно превышает показатели других основных площадок. Однако путь к «полной прозрачности» ещё пройден не полностью.
Это вовсе не значит, что открытый код бесполезен. Для создателей контента и исследователей возможность заглянуть в него всегда выгоднее, чем оставаться в неведении.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 深潮TechFlow



