


От гонки вычислительных мощностей к алгоритмическим инновациям: новая парадигма AI, возглавляемая DeepSeek
Автор: BadBot, IOBC Capital
Буквально вчера вечером DeepSeek выпустила обновление версии V3 на Hugging Face — DeepSeek-V3-0324, количество параметров модели составляет 685 миллиардов, возможности написания кода, дизайна UI, рассуждений и т.д. значительно улучшились.
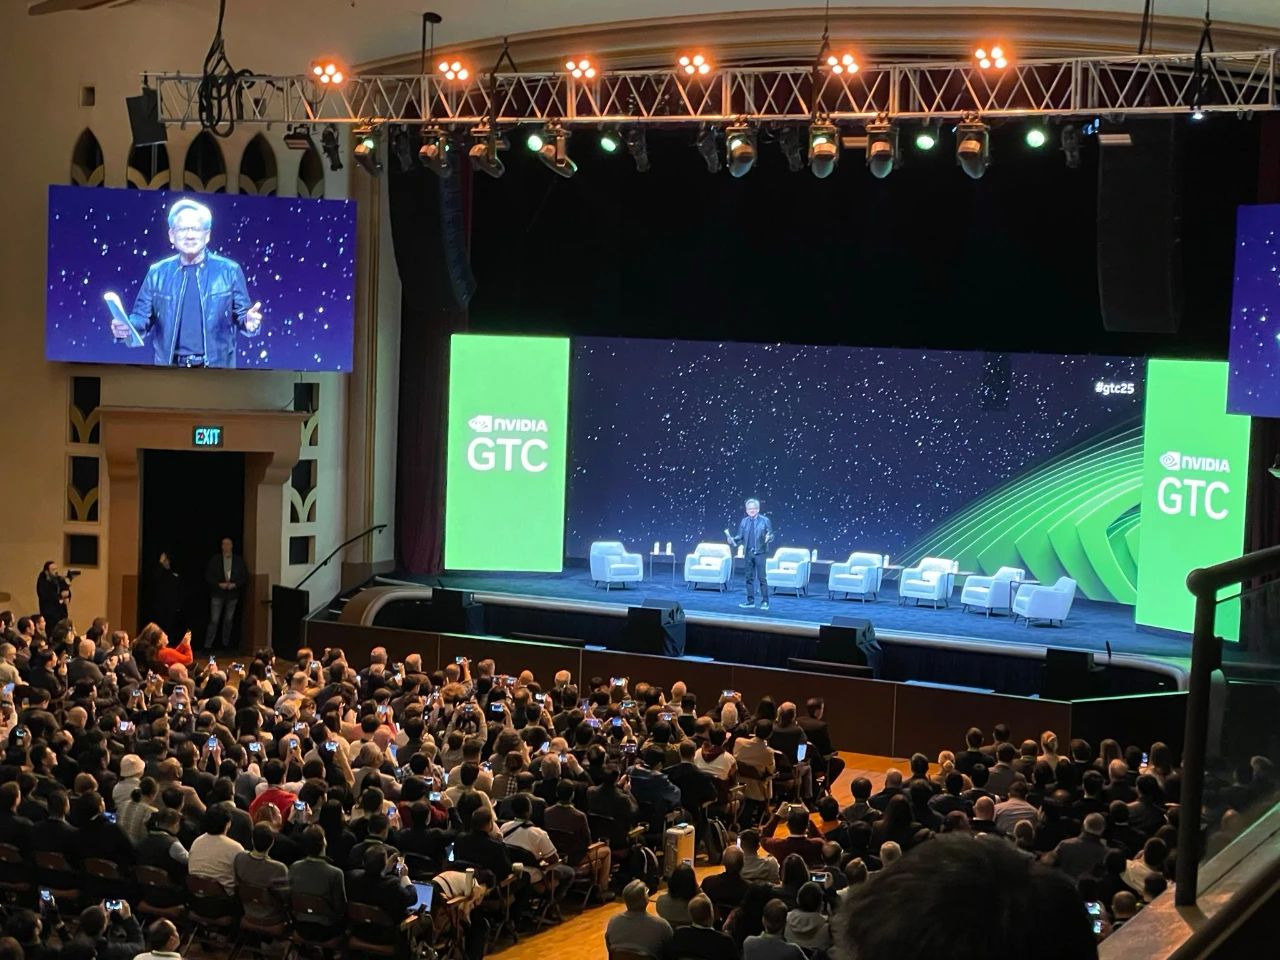
На только что завершившейся конференции GTC 2025 Дженсен Хуан высоко оценил DeepSeek, одновременно подчеркнув, что предыдущее понимание рынка о том, что эффективные модели DeepSeek снизят спрос на чипы NVIDIA, ошибочно; будущий спрос на вычисления будет только расти, а не уменьшаться.
DeepSeek как звездный продукт прорыва в алгоритмах, какая же связь у него с поставками вычислительных мощностей NVIDIA, я хочу сначала обсудить значение вычислительных мощностей и алгоритмов для развития отрасли.
Симбиотическая эволюция вычислительных мощностей и алгоритмов
В области AI повышение вычислительных мощностей обеспечивает основу для работы более сложных алгоритмов, позволяя моделям обрабатывать большие объемы данных и изучать более сложные паттерны; в то время как оптимизация алгоритмов позволяет более эффективно использовать вычислительные мощности, повышая эффективность использования вычислительных ресурсов.
Симбиотические отношения между вычислительными мощностями и алгоритмами переформировывают ландшафт индустрии AI:
Дифференциация технических путей: такие компании, как OpenAI, стремятся создавать сверхкрупные кластеры вычислительных мощностей, в то время как такие компании, как DeepSeek, сосредотачиваются на оптимизации эффективности алгоритмов, формируя разные технические школы.
Реконструкция цепочки индустрии: NVIDIA стала доминирующим игроком в области вычислительных мощностей AI благодаря экосистеме CUDA, в то время как провайдеры облачных услуг снижают порог развертывания через услуги эластичных вычислительных мощностей.
Корректировка распределения ресурсов: центр тяжести НИОКР предприятий ищет баланс между инвестициями в аппаратную инфраструктуру и разработкой эффективных алгоритмов.
Возвышение сообщества открытого исходного кода: модели с открытым исходным кодом, такие как DeepSeek, LLaMA, позволяют делиться результатами инноваций алгоритмов и оптимизации вычислительных мощностей, ускоряя итерацию и распространение технологий.
Технические инновации DeepSeek
Популярность DeepSeek безусловно неразрывно связана с ее техническими инновациями, я объясню это простым языком, чтобы большинство людей могло понять.
Оптимизация архитектуры модели
DeepSeek использует комбинированную архитектуру Transformer+MOE (Mixture of Experts) и внедрила механизм многоголового латентного внимания (Multi-Head Latent Attension, MLA). Эта архитектура похожа на суперкоманду, где Transformer отвечает за обработку рутинных задач, а MOE похожа на группу экспертов в команде, у каждого эксперта есть своя область специализации, когда возникает специфическая проблема, ее обрабатывает наиболее компетентный эксперт, это может значительно повысить эффективность и точность модели. Механизм MLA позволяет модели более гибко фокусироваться на различных важных деталях при обработке информации, далее повышая производительность модели.
Инновации в методах обучения
DeepSeek предложила фреймворк обучения смешанной точности FP8. Этот фреймворк похож на интеллектуальный распределитель ресурсов, он может динамически выбирать подходящую точность вычислений в соответствии с потребностями разных этапов процесса обучения. Когда требуются вычисления высокой точности, он использует более высокую точность, чтобы обеспечить точность модели; а когда можно допустить более низкую точность, он снижает точность, тем самым экономя вычислительные ресурсы, повышая скорость обучения и уменьшая потребление памяти.
Повышение эффективности вывода
На этапе вывода DeepSeek внедрила технологию прогнозирования нескольких токенов (Multi-token Prediction, MTP). Традиционные методы вывода работают шаг за шагом, каждый шаг прогнозирует только один токен. Технология MTP может одновременно прогнозировать несколько токенов, тем самым значительно ускоряя скорость вывода, а также снижая стоимость вывода.
Прорыв в алгоритмах обучения с подкреплением
Новый алгоритм обучения с подкреплением DeepSeek GRPO (Generalized Reward-Penalized Optimization) оптимизировал процесс обучения модели. Обучение с подкреплением похоже на оснащение модели тренером, тренер направляет модель учиться лучшему поведению через вознаграждения и наказания. Традиционные алгоритмы обучения с подкреплением в этом процессе могут потреблять большое количество вычислительных ресурсов, в то время как новый алгоритм DeepSeek более эффективен, он может уменьшить ненужные вычисления, гарантируя повышение производительности модели, тем самым достигая баланса между производительностью и стоимостью.
Эти инновации не являются изолированными техническими точками, а формируют полную техническую систему, снижая потребность в вычислительных мощностях по всей цепочке от обучения до вывода. Обычные потребительские видеокарты теперь также могут запускать мощные модели AI, значительно снижая порог применения AI, позволяя большему количеству разработчиков и предприятий участвовать в инновациях AI.
Влияние на NVIDIA
Многие считают, что DeepSeek обошла слой Cuda, тем самым избавившись от зависимости от NVIDIA. На самом деле, DeepSeek непосредственно проводит оптимизацию алгоритмов через слой PTX (Parallel Thread Execution) NVIDIA. PTX — это язык промежуточного представления между кодом высокого уровня CUDA и фактическими инструкциями GPU, оперируя этим уровнем, DeepSeek может осуществить более тонкую настройку производительности.
Влияние это на NVIDIA двустороннее, с одной стороны, DeepSeek на самом деле еще глубже связана с оборудованием NVIDIA и экосистемой CUDA, снижение порога применения AI может расширить общий размер рынка; с другой стороны, оптимизация алгоритмов DeepSeek может изменить структуру спроса рынка на чипы высокого класса, некоторые модели AI, которые изначально требовали для запуска GPU типа H100, теперь могут эффективно работать на A100 или даже потребительских видеокартах.
Значение для индустрии AI Китая
Оптимизация алгоритмов DeepSeek предоставила путь технического прорыва для индустрии AI Китая. На фоне ограничений на чипы высокого класса, "программное обеспечение компенсирует аппаратное обеспечение" снизила зависимость от топовых импортных чипов.
На верхнем уровне эффективные алгоритмы снизили давление потребности в вычислительных мощностях, позволяя провайдерам вычислительных услуг продлевать цикл использования оборудования через оптимизацию программного обеспечения, повышая возврат на инвестиции. На нижнем уровне оптимизированные модели с открытым исходным кодом снизили порог разработки приложений AI. Множество малых и средних предприятий без необходимости в больших ресурсах вычислительных мощностей также могут разрабатывать конкурентоспособные приложения на основе модели DeepSeek, что породит появление большего количества решений AI в вертикальных областях.
Глубокое влияние на Web3+AI
Децентрализованная AI Infra
Оптимизация алгоритмов DeepSeek предоставила новый импульс инфраструктуре Web3 AI, инновационная архитектура, эффективные алгоритмы и более низкая потребность в вычислительных мощностях сделали возможными децентрализованный вывод AI. Архитектура MoE естественно подходит для распределенного развертывания, разные узлы могут хранить разные экспертные сети, без необходимости хранения полной модели на едином узле, это значительно снижает требования к хранению и вычислениям одного узла, тем самым повышая гибкость и эффективность модели.
Фреймворк обучения FP8 далее снижает потребность в вычислительных ресурса высокого класса, позволяя большему количеству вычислительных ресурсов присоединиться к сети узлов. Это не только снижает порог участия в децентрализованных вычислениях AI, но и повышает вычислительную мощность и эффективность всей сети.
Multi-Agent System
Оптимизация интеллектуальных торговых стратегий: через совместную работу агент анализа данных рынка в реальном времени, агент прогнозирования краткосрочных колебаний цен, агент выполнения транзакций в цепи, агент надзора за результатами транзакций и т.д., помогает пользователям получать более высокую прибыль.
Автоматическое выполнение смарт-контрактов: агент мониторинга смарт-контрактов, агент выполнения смарт-контрактов, агент надзора за результатами выполнения и т.д. работают совместно, реализуя автоматизацию более сложной бизнес-логики.
Управление персонализированным инвестиционным портфелем: AI в соответствии с предпочтениями риска пользователя, инвестиционными целями и финансовым состоянием, помогает пользователям в реальном времени находить лучшие возможности для стейкинга или предоставления ликвидности.
"Мы можем видеть только очень короткое будущее, но достаточно, чтобы обнаружить, что там много работы предстоит сделать." DeepSeek именно в условиях ограничений вычислительных мощностей, через инновации алгоритмов ищет прорыв, открывая дифференцированный путь развития для индустрии AI Китая. Снижение порога применения, продвижение интеграции Web3 и AI, снижение зависимости от чипов высокого класса, расширение возможностей финансовых инноваций, эти влияния сейчас переформировывают ландшафт цифровой экономики. Будущее развитие AI больше не является только гонкой вычислительных мощностей, а гонкой симбиотической оптимизации вычислительных мощностей и алгоритмов. На этой новой трассе инноваторы, такие как DeepSeek, используют китайскую мудрость, чтобы переопределить правила игры.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 @iobc_capital











