


Помимо заработка и нарративов, что еще Crypto может сделать для AI?
Автор: Павел Парамонов
Перевод: TechFlow
Основатель Curve Finance @newmichwill недавно в твите заявил, что основная цель криптовалюты заключается в DeFi (децентрализованных финансах), а для ИИ (искусственного интеллекта) криптовалюта вообще не нужна. Хотя я согласен с тем, что DeFi является важной частью крипто-индустрии, я не разделяю мнение о том, что ИИ не нуждается в криптовалюте.
С появлением ИИ-агентов многие из них обычно выпускают собственные токены, что создает ложное впечатление, будто пересечение криптовалют и ИИ ограничивается только этими агентами. Другая важная, но упускаемая из виду тема — это «децентрализованный ИИ», который напрямую связан с обучением самих моделей ИИ.
Меня не устраивает определенное нарративное восприятие, при котором большинство пользователей слепо полагает, что популярность чего-либо автоматически означает его важность и полезность. А в худшем случае они считают, что единственная цель таких нарративов — максимально выжать ценность (иными словами, заработать деньги).
Обсуждая децентрализованный ИИ, мы прежде всего должны задать себе вопрос: зачем ИИ нужна децентрализация? и какие последствия это несет?
Как показывает практика, идея децентрализации практически всегда неразрывно связана с концепцией «согласования стимулов» (incentive alignment).
В сфере ИИ существует множество фундаментальных проблем, которые можно решить с помощью криптографии и блокчейн-технологий. Более того, некоторые механизмы не только решают существующие проблемы, но и повышают доверие к ИИ.
Итак, почемуИИ нужна криптовалюта?
1. Высокие вычислительные затраты ограничивают участие и инновации
Независимо от удачи, крупные модели ИИ требуют огромных вычислительных ресурсов, что естественным образом ограничивает участие многих потенциальных пользователей. Чаще всего моделям ИИ требуются массивные объемы данных и реальная вычислительная мощность, которые одному человеку практически не под силу обеспечить.
Эта проблема особенно остро стоит в разработке ПО с открытым кодом. Контрибьюторам недостаточно просто потратить время на обучение моделей; им также необходимо предоставить вычислительные ресурсы, что снижает эффективность разработки.
Да, отдельные пользователи могут выделять значительные ресурсы для запуска моделей ИИ, подобно тому как пользователи распределяют вычислительные мощности для работы собственных нод блокчейна.
Однако это не решает проблему кардинально, так как вычислительной мощности все равно недостаточно для выполнения соответствующих задач.
Независимые разработчики или исследователи не могут участвовать в создании крупных моделей ИИ, таких как LLaMA, лишь потому, что не могут покрыть затраты на обучение: требуются тысячи GPU, дата-центры и дополнительная инфраструктура.
Для понимания масштаба приведу следующие данные:
→ Элон Маск сообщил, что для обучения новейшей модели Grok 3 использовалось 100 тысяч GPU Nvidia H100.
→ Стоимость каждого чипа составляет около 30 000 долларов США.
→ Общая стоимость чипов для обучения Grok 3 оценивается примерно в 3 миллиарда долларов США.
Эта проблема в некоторой степени напоминает процесс создания стартапа: у человека может быть время, технические навыки и план действий, но изначально не хватает ресурсов для воплощения идеи.
Как отмечает @dbarabander, традиционные проекты ПО с открытым кодом требуют от контрибьюторов лишь времени, тогда как проекты ИИ с открытым кодом нуждаются во времени и огромных ресурсах, таких как вычислительная мощность и данные.
Положиться исключительно на добрую волю и усилия волонтеров недостаточно для мотивации достаточного количества людей или команд предоставить эти дорогостоящие ресурсы. Дополнительные механизмы стимулирования являются необходимым условием для привлечения участников.
2. Криптография — лучший инструмент для согласования стимулов
Под согласованием стимулов (Incentive Alignment) подразумевается создание правил, при которых участники, внося вклад в развитие системы, одновременно получают личную выгоду.
В помощи системам добиться такого согласования криптология имеет бесчисленные успешные примеры. Наиболее яркий случай — отрасль DePIN (децентрализованные физические инфраструктурные сети), которая идеально соответствует этой философии.
Например, такие проекты, как @helium и @rendernetwork, стали эталоном, реализовав согласование стимулов через распределенные сети узлов и GPU.
Почему бы нам не применить эту модель в сфере ИИ, чтобы сделать экосистему более открытой и доступной?
На практике мы можем это сделать.
В основе развития Web3 и крипто-технологий лежит понятие «права собственности».
Вы владеете своими данными, у вас есть собственная система вознаграждений, и даже просто владея определенными токенами, вы получаете долю в сети. Предоставление права собственности поставщикам ресурсов мотивирует их делиться активами с проектами в ожидании доли от успеха сети.
Чтобы сделать ИИ более массовым, криптография предлагает оптимальное решение. Разработчики смогут свободно обмениваться архитектурами моделей между проектами, а поставщики вычислений и данных будут получать долю владения (вознаграждение) за предоставление своих ресурсов.
3. Согласование стимулов тесно связано с верификацией
Если представить децентрализованную систему ИИ с должным согласованием стимулов, она должна наследовать некоторые свойства классических механизмов блокчейна:
-
Сетевой эффект.
-
Низкие начальные требования: узлы получают компенсацию из будущих доходов.
-
Механизмы штрафования (Slashing): наказание злонамеренных участников.
Особо следует отметить механизм штрафования: он требует верификации. Если невозможно доказать, кто является злоумышленником, наказать его будет нельзя, что сделает систему крайне уязвимой для мошенников, особенно в условиях кросс-командной работы.
В децентрализованных системах ИИ верификация критически важна, поскольку у нас отсутствует единый центральный узел доверия. Вместо этого мы стремимся к системе, не требующей доверия, но поддающейся проверке. Вот несколько компонентов, где необходима верификация:
-
Фаза тестирования阶段 (Benchmark Phase): система превосходит другие в определенных метриках (например, x, y, z).
-
Фаза вывода阶段 (Inference Phase): корректность функционирования системы, то есть этап «мышления» ИИ.
-
Фаза обучения阶段 (Training Phase): правильность процесса обучения или настройки модели.
-
Фаза данных阶段 (Data Phase): корректность сбора данных системой.
В настоящее время сотни команд строят проекты на базе @eigenlayer, но я недавно заметил, что интерес к ИИ вырос значительно больше обычного, и задумался, насколько это соответствует изначальному видению рестейкинга (Restaking).
Любая система ИИ, стремящаяся достичь согласования стимулов, должна быть верифицируемой.
В данном контексте механизм штрафования тождественен верификации: если децентрализованная система способна наказывать злоумышленников, значит, она умеет выявлять и подтверждать факт их недобросовестных действий.
Если система верифицируема, ИИ сможет использовать криптографию для доступа к глобальным вычислительным и Daten-ресурсам, создавая более масштабные и мощные модели. Ведь большее количество ресурсов (вычисления + данные) обычно приводит к созданию лучших моделей (по крайней мере, в нынешней технологической парадигме).
Команда @hyperbolic_labs уже продемонстрировала потенциал совместного использования вычислительных ресурсов. Любой пользователь может арендовать GPU для обучения более сложных моделей ИИ, чем те, что он способен запустить дома, причем на гораздо меньших затратах.
Как сделать верификацию ИИ одновременно эффективной и доказуемой?
Кто-то может возразить, что сейчас существует множество облачных решений для аренды GPU, которые уже решают проблему с вычислительными ресурсами.
Однако облачные решения вроде AWS или Google Cloud чрезмерно централизованы и используют так называемую «стратегию списков ожидания» (Waitlist Strategy), искусственно создавая иллюзию высокого спроса для завышения цен. Такое поведение характерно для олигополистической среды данной отрасли.
Фактически колоссальный объем ресурсов GPU простаивает в дата-центрах, майнинговых фермах и даже в руках частных лиц, хотя они могли бы использоваться для вычислительного участия в обучении моделей ИИ, вместо чего просто пропадают впустую.
Возможно, вы слышали о проекте @getgrass_io, который позволяет пользователям продавать корпорациям неиспользуемую полосу пропускания, тем самым предотвращая растрату ресурсов и получая соответствующие вознаграждения.
Я вовсе не утверждаю, что вычислительные ресурсы безграничны, но любую систему можно оптимизировать для достижения взаимной выгоды: с одной стороны, открыть более конкурентный рынок для тех, кому нужно больше мощностей для обучения моделей ИИ, а с другой — гарантировать адекватное вознаграждение тем, кто предоставляет эти ресурсы.
Команда Hyperbolic создала открытый рынок GPU. Здесь пользователи могут арендовать видеокарты для обучения моделей ИИ, экономя до 75% затрат, а владельцы GPU монетизируют простаивающие мощности и зарабатывают на этом.
Ниже приведено описание принципа его работы:
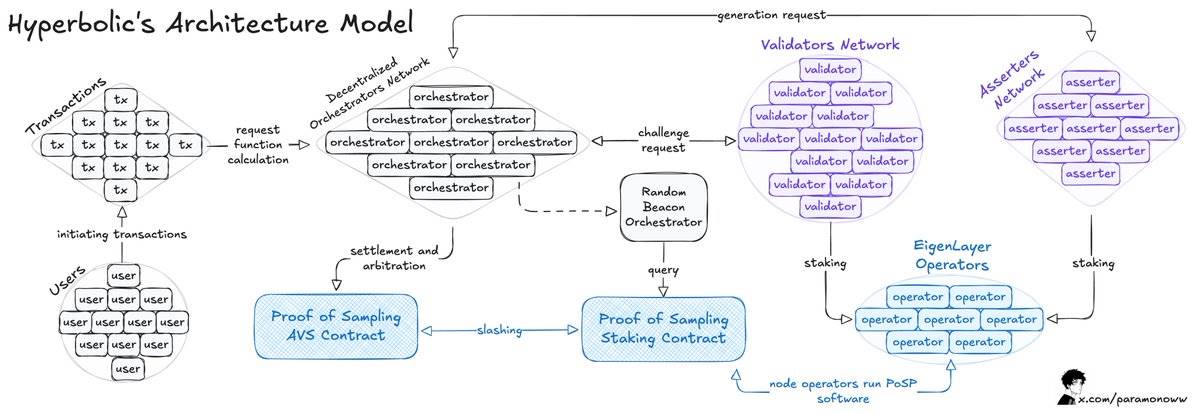
Hyperbolic организует подключенные GPU в кластеры и узлы, обеспечивая масштабируемость вычислительных мощностей в соответствии с потребностями.
Основа данной архитектурной модели — протокол «Proof of Sampling» (Доказательство выборки), предполагающий обработку через выборку данных: случайный отбор и верификация сэмплов снижают общую нагрузку и потребность в вычислениях.
Основная сложность возникает в процессе вывода ИИ (Inference): каждое выполнение задачи в сети должно проходить верификацию, причем желательно минимизировать дополнительные вычислительные накладные расходы других механизмов.
Как я уже упоминал, если действие подлежит проверке, то при выявлении нарушения правил его обязательно нужно наказать (применить слэшинг).
Внедряя модель AVS (Adaptive Verification System, Система адаптивной верификации), Hyperbolic усиливает доказуемость всей системы. В рамках этой архитектуры верификаторы назначаются случайно для проверки выходных данных, что обеспечивает согласование стимулов: при таком механизме недобросовестность становится невыгодной.
Для обучения и совершенствования модели ИИ необходимы два ключевых ресурса: вычислительная мощность и данные. Аренда мощностей уже стала решением, однако нам по-прежнему необходимо получать данные откуда-то вовне, причем они должны быть разнообразными, чтобы избежать возможных смещений в работе модели.
Верификация разнородных данных для ИИ
Чем больше данных, тем лучше модель; однако проблема заключается в необходимости их разнообразия. Это одна из главных трудностей перед моделью ИИ.
Протоколы обработки данных существуют уже десятки лет. Независимо от того, публичные данные или приватные, брокеры собирают их различными путями: иногда платя за них, иногда бесплатно, после чего продают для извлечения прибыли.
Проблемы, возникающие при поиске подходящих данных для моделей ИИ, включают точки отказа (Single Point of Failure), цензуру и отсутствие способа доверительно доставлять достоверную информацию для «питания» модели без необходимости слепого доверия.
Итак, кому нужны такие данные?
В первую очередь, исследователям и разработчикам ИИ, которые стремятся обучать и применять свои модели на основе реальных и релевантных входных данных.
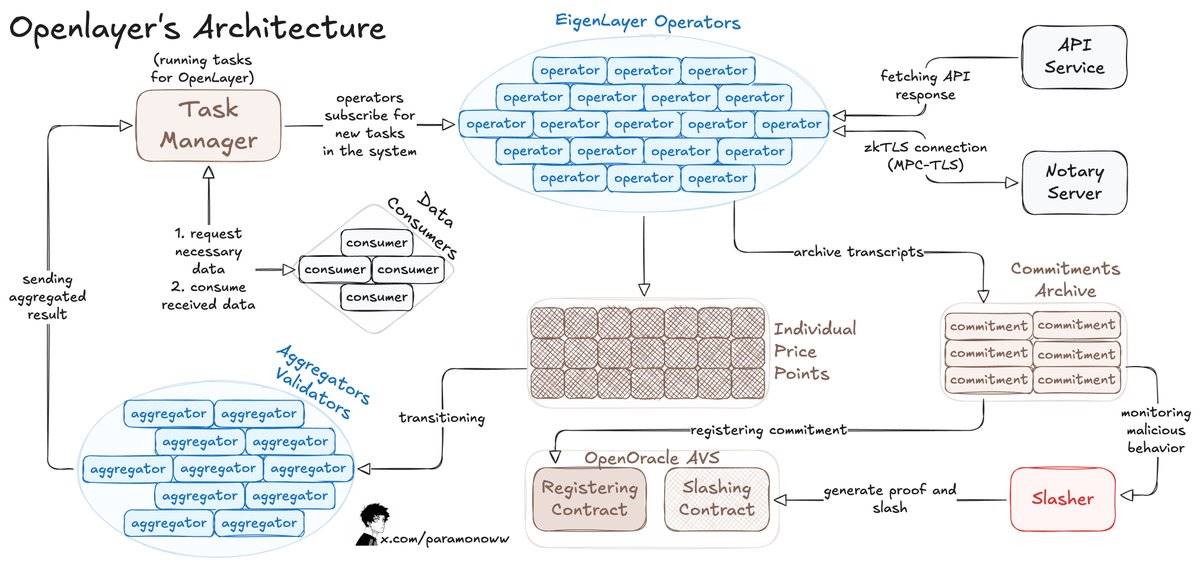
Например, OpenLayer разрешает любому пользователю без разрешения добавлять потоки данных в систему или модель ИИ, при этом платформа фиксирует каждый доступный источник в проверяемом виде.
OpenLayer также применяет протокол zkTLS (Zero-Knowledge Transport Layer Security), детально разобранный в моих предыдущих материалах. Этот протокол гарантирует, что данные, отправляемые оператором, действительно получены из заявленного источника (доказуемость).
Принцип работы OpenLayer выглядит следующим образом:
-
Потребители данных направляют запросы смарт-контракту OpenLayer и извлекают результаты, используя API, схожий с основными оракулами данных (через контракты on-chain или off-chain).
-
Операторы регистрируются через EigenLayer, обеспечивают заложенные активы для защиты AVS OpenLayer и развертывают программное обеспечение AVS.
-
Операторы подписываются на задания, обрабатывают и отправляют данные в OpenLayer, параллельно сохраняя исходные ответы и доказательства в децентрализованном хранилище.
-
Для результатов с вариативностью агрегаторы (специализированные операторы) приводят выходные данные к единому стандарту.
Разработчики могут запрашивать у любого веб-сайта актуальные данные и интегрировать их в сеть. Если вы занимаетесь созданием проектов, связанных с ИИ, вы получите доступ к надежной информации в режиме реального времени.
Разобрав процесс вычислений ИИ и способы получения верифицируемых данных, перейдем к двум ключевым компонентам моделей ИИ: самим вычислениям и их проверке.
Вычисления ИИ должны проходить верификацию для гарантии корректности
В идеале узлы обязаны доказывать свой вклад в вычисления, чтобы поддерживать стабильную работу системы.
В худшем случае узлы могут фиктивно декларировать предоставление вычислительных мощностей, фактически не выполняя никакой реальной работы.
Требование подтверждения вклада гарантирует, что будут признаны лишь легитимные участники, что предотвращает вредоносную активность. Подобный механизм очень напоминает классический Proof of Work (PoW), различаясь лишь типом выполняемой работы.
Даже внедрив надлежащее согласование стимулов, если узлы не смогут беспрепятственно подтвердить выполнение конкретных задач, они могут получить вознаграждения, несоразмерные реальному вкладу, что спровоцирует несправедливое распределение бонусов.
Неспособность сети оценить фактический вычислительный вклад может привести к тому, что некоторым узлам будут поручены задачи, превышающие их возможности, в то время как остальные мощности останутся простаивать, что неизбежно повлечет падение эффективности или сбои системы.
Подтверждая вычислительный вклад, сеть может измерять усилия каждого узла с помощью стандартизированных метрик (например, FLOPS — операций с плавающей запятой в секунду). Такая методология позволяет распределять вознаграждения исходя из реально выполненной работы, а не просто на основе факта присутствия ноды в сети.
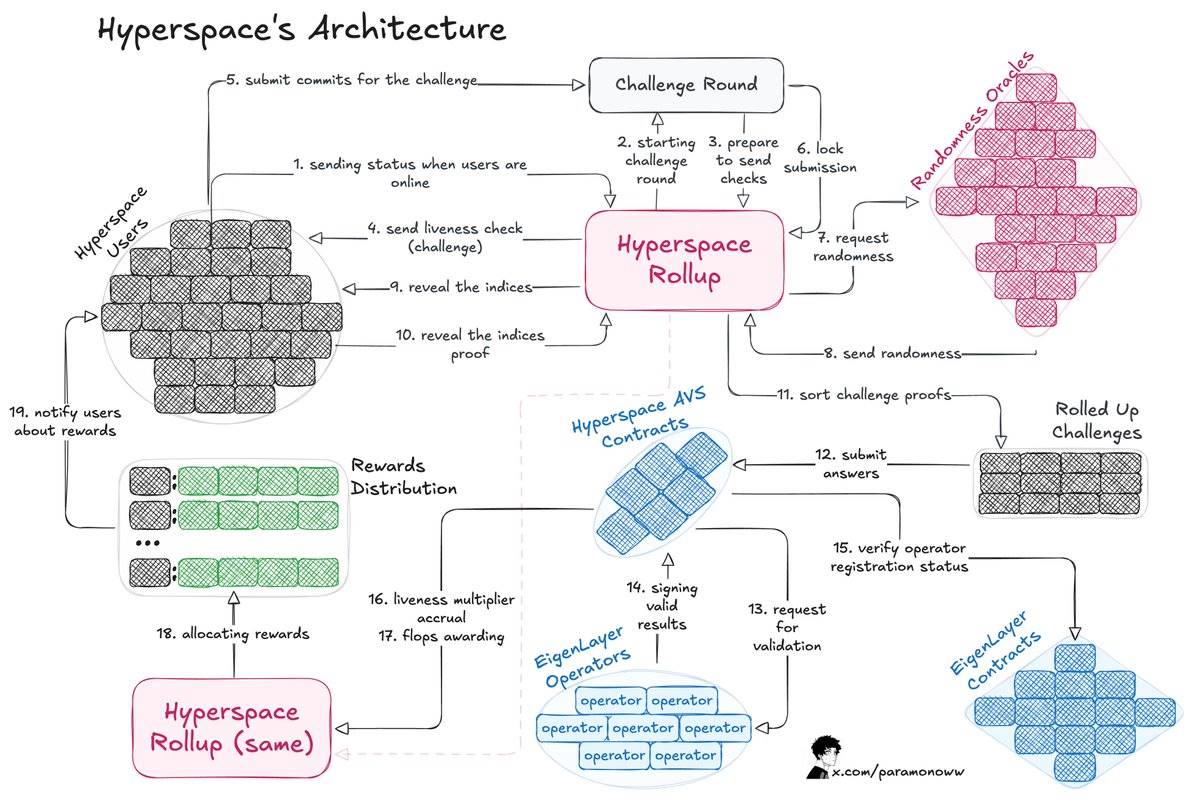
Команда @HyperspaceAI разработала систему «Proof-of-FLOPS» (Доказательство FLOPS), позволяющую узлам арендовать неиспользуемые вычислительные мощности. Взамен они получают «flops»-очки, которые выступают универсальной валютой всей сети.
Принцип действия данной архитектуры выглядит следующим образом:
-
Процесс начинается с выдачи челленджа пользователю, на который тот отвечает отправкой обязательства (commitment).
-
Rollup Hyperspace управляет всем процессом, гарантируя безопасность отправленных данных и извлекая энтропию (случайные числа) из оракула.
-
Пользователь публикует индекс, завершая цикл вызова.
-
Операторы проверяют ответы, передают верифицированные результаты в контракт Hyperspace AVS, после чего подтверждают их через контракт EigenLayer.
-
Рассчитывается множитель активности (Liveness Multipliers), и пользователю начисляются очки flops.
Подтверждение вычислительного вклада формирует четкую картину возможностей каждого узла, что позволяет системе интеллектуально распределять задачи: сложные вычисления ИИ поручаются высокопроизводительным нодам, а более легкие — узлам с меньшими характеристиками.
Наиболее интригующим аспектом является достижение полной доказуемости системы, позволяющее любому участнику подтвердить правильность выполненных работ. Как видно из приведенной ранее схемы архитектуры, система AVS от Hyperspace непрерывно генерирует вызовы, запрашивает случайные числа и выполняет многоступенчатый процесс верификации.
Операторы могут смело интегрироваться в систему благодаря проверке результатов и справедливому разделению наград. При выявлении ошибочных ответов злоумышленники будут безусловно наказаны (slashing).
Существует множество важных причин для верификации результатов вычислений ИИ:
-
Стимулирование присоединения новых узлов и предоставления ими ресурсов.
-
Справедливое распределение вознаграждений пропорционально затраченным усилиям.
-
Обеспечение прямой поддержки конкретных моделей ИИ.
-
Эффективное распределение задач на основе способности узлов к верификации.
Децентрализация и доказуемость в ИИ
Как отметил @yb_effect, понятия «децентрализованность» (Decentralized) и «распределенность» (Distributed) совершенно разные. Распределенная архитектура лишь означает физическое размещение оборудования в разных локациях, но сохранение единой централизованной точки подключения.
Децентрализация же подразумевает отсутствие единственного главного узла, способность процесса обучения устойчиво реагировать на сбои, что полностью аналогично архитектуре большинства современных блокчейн-сетей.
Для обеспечения истинной децентрализации сетей ИИ потребуется комплекс внедрения различных решений, однако очевидно одно: нам нужна верификация подавляющего большинства процессов и данных.
При создании собственной модели ИИ или автономного агента вы обязаны убедиться в том, что каждый компонент и каждая зависимость прошли независимую проверку.
Инференс, обучение, данные, оракулы — всё это поддается верификации. Такой подход не только интегрирует крипто-вознаграждения, совместимые со стимулами, в ИИ-систему, но и делает ее значительно честнее и эффективнее.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 @paramonoww











