


Последнее интервью Дэвидa Луаня, одного из первых сотрудников OpenAI: DeepSeek не изменил нарратив технологий ИИ
Автор: MD
Издание: Минлян компания

Недавно в подкасте венчурного фонда Redpoint «Unsupervised Learning» партнеры Redpoint Джейкоб Эфрон и Дэвид Луан провели интервью. Они рассмотрели с технической точки зрения вдохновляющие уроки, которые DeepSeek преподнесла исследованиям и практике в области больших языковых моделей, а также поделились размышлениями о текущих ограничениях ИИ-моделей и потенциальных направлениях их преодоления.
Дэвид Луан — один из первых сотрудников OpenAI. Окончив Йельский университет в 2009 году, он начал карьеру в компании iRobot, работая над робототехникой, затем работал в ряде других компаний (включая Microsoft), пока в 2017 году не присоединился к находившейся на ранней стадии развития OpenAI. В то время команда исследователей насчитывала всего 35 человек. В ходе интервью он также отметил, что его мотивацией для работы в ИИ-компании стал интерес к робототехнике, и он считает, что “главное ограничение роботов заключается в уровне интеллекта лежащих в основе алгоритмов”.
В 2020 году Дэвид Луан покинул OpenAI и перешел в Google, однако не остался там надолго. Вместе с двумя коллегами, которых он встретил в период работы в Google, он основал компанию Adept и занял пост генерального директора. А в августе прошлого года он присоединился к Amazon в качестве руководителя лаборатории AGI в Сан-Франциско.
Ниже представлен перевод основного текста интервью, подготовленный редакцией «明琅 компания» (с некоторыми сокращениями):
Ограничения больших моделей и ценность обучения с подкреплением
Джейкоб: Дэвид Луан является руководителем лаборатории AGI от Amazon. Ранее он был соучредителем и генеральным директором компании Adept, которая привлекла более 400 миллионов долларов на разработку ИИ-агентов. Во время своей работы в должности вице-президента по инженерии в OpenAI он принял участие во множестве ключевых прорывов. Меня зовут Джейкоб Эфрон.
Сегодня в эфире мы с Дэвидом обсудим множество интересных тем, включая мое отношение к DeepSeek, прогнозы относительно будущих улучшений моделей, наше обсуждение текущего состояния агентов, способов обеспечения их надежности и сроков повсеместного внедрения. Он также рассказал несколько забавных историй об ранних днях OpenAI и уникальной корпоративной культуре, там царившей. Это будет очень интересное общение, поскольку нам с Дэвидом известно уже более десяти лет. Я уверен, слушателям понравится. Дэвид, спасибо, что согласились стать нашим гостем.
Дэвид: Благодарю за приглашение. Нам предстоит очень интересный разговор, ведь мы знакомы уже более десяти лет.
Джейкоб: Помню, когда ты только начинал работу в OpenAI, мне это показалось интересным шагом, но я не был уверен, что это разумный выбор для твоей карьеры. Потом стало очевидно, что ты всегда видишь возможности раньше других.
Дэвид: Мне сильно повезло, потому что я всегда интересовался робототехникой, и (на тот момент) главным ограничением роботов было качество интеллекта базовых алгоритмов. Поэтому я занялся искусственным интеллектом, и действительно круто наблюдать, как эти технологии развиваются в течение нашей жизни.
Джейкоб: Сегодня я хочу обсудить с тобой много тем. Начну с самой горячей новости последних недель. Очевидно, реакция на DeepSeek была колоссальной. Об этом много говорят, рынки рушатся. Некоторые утверждают, что это плохо сказывается на OpenAI и Anthropic. Мне кажется, сейчас эмоции немного улеглись после первоначальной паники. Но мне интересно, какие выводы аудитории относительно влияния этого события считаются верными, а какие нет?Как ты оцениваешь объективность мнений, возникающих в этих обсуждениях?
Дэвид: Я прекрасно помню то утро, все следили за новостями о DeepSeek. Проснулся, смотрю на телефон — пять пропущенных звонков. Подумал: что случилось в этот раз? Предпоследний раз такое было при крахе SVB (Silicon Valley Bank), когда инвесторы звонили мне, чтобы вывести средства из SVB и First Republic Bank. Тогда я сразу понял, что произошло что-то серьезное. Проверил новости и узнал, что рынки рушатся из-за выпуска DeepSeek R1.Я сразу осознал, что все вокруг неправильно понимают суть происходящего. DeepSeek совершили невероятный прорыв, но они являются частью более широкого нарратива — сначала мы учимся делать новые большие модели умнее,, а затем учимся делать их эффективнее.
Так что это настоящий переломный момент. Заблуждение людей заключается в том, что возможность достигать большего интеллектуального уровня за меньшую стоимость вовсе не означает отказ от стремления к нему. Наоборот, вы будете использовать больший объем интеллекта. Как только рынок это осознает, мы снова вернемся к рациональному мышлению.
Джейкоб: Учитывая, что, по крайней мере, базовые модели, похоже, были обучены на базе OpenAI, и можно заставить базовые модели DeepSeek вести себя почти так же, как ChatGPT, используя различные техники, каковы перспективы с учетом того факта, что работает дистилляция знаний? Перестанут ли OpenAI и Anthropic столь открыто публиковать свои модели в будущем?
Дэвид: Думаю, произойдет следующее. Люди всегда хотят создавать наиболее интеллектуальные модели, но иногда эти модели не всегда оптимальны с точки зрения эффективности рассуждений. . Поэтому, думаю, мы все чаще будем видеть, хотя люди могут открыто об этом не говорить, как модели будут обучаться внутри лабораторий в виде огромных “учительских моделей” (teacher models), которые используют все доступные вычислительные ресурсы.Затем они будут попытаться сжать их в компактные, эффективные модели, пригодные для использования клиентами.
Сейчас я вижу главную проблему так: я представляю сферы применения ИИ как концентрические круги сложности. Внутренний круг может быть простейшим, например, обычная болтовня с базовой языковой моделью, чего мы легко добились еще в GPT-2. А каждый следующий уровень интеллекта, будь то умение считать в уме, программировать, агенты или даже разработка лекарств, требует все более продвинутых моделей.Но каждый предыдущий уровень интеллекта становится настолько дешевым, что его можно квантовать (quantize, снижение числовой точности модели для экономии ресурсов).
Джейкоб: Это наводит меня на мысль о тренде тестовых вычислений (test-time compute). Это выглядит как крайне перспективное направление, особенно в таких легко проверяемых областях, как программирование и математика. Насколько далеко эта парадигма может нас завести?
Дэвид: Есть целый ряд статей и подкастов, документирующих мои многолетние дискуссии о том, как построить AGI (Общий Искусственный Интеллект).
Джейкоб: Давай добавим свежую perspectives в эти дискуссии.
Дэвид: Сейчас мы можем доказать, что вели диалог именно в этот момент. Но еще в 2020 году, когда мы начали замечать появление GPT-2, а GPT-3, возможно, уже разрабатывалась или была завершена, мы начали думать о GPT-4. Мы жили в мире, где люди не были уверены, нужно ли просто предсказывать следующий токен (next token prediction), чтобы решить все задачи AGI.
Моя позиция и позиция некоторых моих окружения фактически звучит как «нет».Причина в том, что если модель обучается предсказывать следующий токен, она по сути наказуема за открытие новых знаний, поскольку эти знания отсутствуют в обучающей выборке. Поэтому нам необходимо посмотреть на другие известные парадигмы машинного обучения, способные реально открывать новые знания.Мы знаем, что обучение с подкреплением (RL) может это делать, RL способно к поиску нового, верно? Да, или как AlphaGo, что, возможно, впервые показало широкой публике, что с помощью RL можно открывать новое знание. Вопрос всегда стоял в том, когда же мы объединим большие языковые модели (LLMs) с RL, чтобы создать систему, обладающую всеми знаниями человечества и способную строить на их основе.
Джейкоб: Тогда скажи, сможет ли такая парадигма тестовых вычислений позволить нам строить модели для областей, где сложно провести проверку, вроде медицины или юриспруденции?Или же мы станем невероятно успешны в программировании и математике, но так и не сможем рассказать шутку?
Дэвид: Это предмет для горячих дебатов, у меня на этот счет довольно четкое мнение.
Джейкоб: Каков твой ответ?
Дэвид: Способность этих моделей к обобщению гораздо выше, чем принято думать.. Все говорят: «Я пробовал GPT-1, он будто бы лучше справлялся с математикой, но ждал, пока он порассуждает, он оказывался чуть слабее ChatGPT или других моделей.»На мой взгляд, это лишь временные небольшие отклонения на пути к созданию более мощных систем. Сегодня мы уже наблюдаем признаки, указывающие на то, что четкая проверка правильности решения проблемы моделью (как мы видели в случае с DeepSeek) действительно приводит к переносу навыков на несколько размытые задачи в смежных областях. Думаю, все активно работают над этим, моя команда и другие тоже пытаются разрешить сложнейшие задачи с учетом человеческих предпочтений.
Джейкоб: Да. И тебе всегда нужна возможность создать модель для проверки, например, «ох, это хороший юридический совет» или «это хорошая медицинская диагностика», что очевидно намного сложнее, чем проверить математическое доказательство или код на работоспособность.
Дэвид: Я считаю, что мы используем разрыв между качеством работы таких моделей — способность одних и тех же наборов весов нейронной сети оценивать, насколько хорошо они выполнили задачу, по сравнению с их способностью генерировать правильный ответ. Мы всегда видим, что эти модели сильнее в оценке того, “насколько хорошо выполнена задача”, чем в “генерации хороших ответов”. Отчасти мы используем это, применяя некоторые инструменты RL, чтобы научить их самостоятельно чувствовать, хорошо ли они справились.
Джейкоб: Какие исследовательские вопросы нужно решить, чтобы наконец выпустить такие модели?
Дэвид: Вопросы слишком многочисленны, но я, пожалуй, перечислю три ключевых. Во-первых, первый вопрос заключается в том, что вам действительно нужно знать, как организовать процессы и структуру, чтобы надежно создавать модели.
Я всегда говорю моей команде и людям, с которыми работаю:если вы управляете современной ИИ-лабораторией сегодня, ваша задача — не создание самих моделей, а построение завода, способного гарантированно их производить. Когда вы думаете об этом так, это полностью меняет фокус ваших инвестиций. Пока мы не добьемся воспроизводимости, я считаю, прогресс ограничен. Мы недавно прошли путь от алхимии к индустриализации, изменился сам подход к сборке этих моделей. Без этого фундамента модели не будут работать.
Я думаю, следующий важный аспект таков:нужно двигаться медленно, чтобы двигаться быстро. Но это первый пункт. Я всегда считал, что людей тянет к алгоритмам, потому что они выглядят крутыми и сексуальными. Но если посмотреть на то, что действительно движет всем этим процессом,на деле это инженерные проблемы. Например, как организовывать вычисления в масштабах кластеров, чтобы гарантировать их бесперебойную работу в течение длительного времени?Если узел падает, вы не должны терять слишком много времени на повторение своих задач. Для продвижения границ масштаба это настоящая проблема.
Сейчас вся область обучения с подкреплением (RL) скоро войдет в мир, где будет множество дата-центров, каждый из которых будет проводить огромные объемы вывода (inference) на базовых моделях, возможно, тестировать их в новых средах, принесенных клиентами, учиться их совершенствовать и возвращать эти новые знания в центральную точку, чтобы модель становилась умнее.
Джейкоб: Есть люди вроде Янна ЛеКуна, которые недавно постоянно критиковали ограничения больших языковых моделей (LLMs). Хочу, чтобы ты резюмировал эту критику для наших слушателей, а затем поделился своим мнением о тех, кто говорит, что эти модели никогда не смогут мыслить по-настоящему оригинально.
Дэвид: У нас уже есть контрпример. AlphaGo демонстрирует оригинальное мышление. Если оглянуться на ранние проекты OpenAI, мы использовали RL для игры во флеш-игры. Если вы относитесь к соответствующему поколению, вы наверняка помните MiniClip и подобные вещи. Это были подростковые забавы, но наблюдать, как они стали фундаментом для ИИ, действительно здорово.Тогда мы изучали, как использовать наши алгоритмы для одновременного прохождения этих игр,и вы быстро замечаете, как они учились проходить уровни невероятно быстро,используя уязвимости, проникая сквозь стены и другими способами, которые люди никогда не применяли.
Джейкоб: Что касается проверки, то она сводится в основном к поиску хитрых способов верификации для разных областей.
Дэвид: Вам достаточно просто использовать модель.
Как создавать надежные агенты
Джейкоб: Я хочу переключить тему на мир агентов. Как бы ты описал текущее состояние этих моделей?
Дэвид: Я по-прежнему безумно воодушевлен агентами. Это возвращает меня к 2020–2021 годам, когда вышли первые поистине мощные модели, такие как GPT-4. Когда вы тестируете эти модели, вы ощущаете огромный потенциал — они способны писать отличные рэп-треки, блеснуть остроумием в перепалках, успешно складывать числа в пределах трех знаков. Но стоит попросить их «помочь мне заказать пиццу», как они начинают имитировать шаблонные ответы служб поддержки Domino's Pizza,абсолютно не способны выполнить реальную задачу. Очевидно, это обнажает серьезный недостаток этих систем, правда?
С тех пор я твердо уверен, что проблему агентов необходимо решать. Еще работая в Google, мы начали исследовать тему, которую позже стали называть "инструментальным использованием" — как показать большим языковым моделям (LLM) интерфейсы управления, чтобы они могли автономно принимать решения о действиях. Хотя академическое сообщество всегда называло это "агентами", широкая публика тогда не имела единого понимания. Для этого мы попытались придумать новый термин "большая модель действий" (Large Action Model) взамен "большой языковой модели" (Large Language Model), что вызвало определенные дискуссии. Но в итоге индустрия выбрала термин "агент" (Agent), который ныне ужасно злоупотребляется и утратил свое изначальное значение, что печально,,но все равно круто быть одной из первых современных азиатских компаний, исследующих эту область.
Когда мы запускали Adept, самые лучшие open-source LLM тогда демонстрировали посредственные результаты. Поскольку мультимодальных LLM (например, LLM с входными изображениями, как будущая GPT-4v) тогда не существовало, нам пришлось начинать подготовку собственных моделей с нуля. Пришлось делать абсолютно всё с нуля, это напоминало ситуацию, когда в 2000 году вы открываете интернет-компанию и вынуждены звонить в TSMC, чтобы заказать производство собственных чипов. Это было просто безумие.
Поэтому весь путь обучения заключался в следующем: большие языковые модели без сегодняшних технологий RL по своей сути являются поведенческими клонерами, которые просто копируют то, что видят в обучающих данных,а значит, как только они сталкиваются с неизведанной ситуацией, их способность к обобщению резко падает, а поведение становится непредсказуемым. По этой причине Adept всегда фокусировалась на полезном интеллекте (useful intelligence). Что означает полезность? Это не выпуск крутого демо, которое станет вирусным в Twitter. Это передача технологий пользователям, чтобы они больше не тратили силы на рутинную работу, которой обязаны заниматься большинство офисных работников, например, перетаскивание файлов на компьютере. Таким образом, эти специалисты озабочены надежностью. Один из наших ранних кейсов был таким: сможем ли мы помогать людям обрабатывать счета?
Джейкоб: Всем нравится обработка счетов (смех). Для универсальных моделей это кажется естественным стартом.
Дэвид: Это отличный вариант "Hello World". В то время никто толком такими вещами не занимался, поэтому мы выбрали очевидный пример "Hello World". Мы сделали несколько проектов, включая Excel. Если система семь раз из десяти удаляет треть записей в вашем QuickBooks, вы никогда больше ею не воспользуетесь. Надежность все еще остается проблемой. Даже сегодня системы вроде Operator впечатляют, кажется, превосходят другие облачные агентные системы. Но посмотрите на оба этих проекта — они сосредоточены на сквозном выполнении задач, например, вы вводите «Хочу, чтобы ты помог мне найти 55 мест для выходного отдыха», и оно пытается выполнить это задание.Но сквозная надежность здесь крайне низка,требуется массовое вмешательство человека. Мы все еще не достигли точки,когда предприятия смогут по-настоящему довериться этим системам и настроить их по принципу "запустил и забыл".
Джейкоб: Нам нужно решить эту проблему. Возможно, объясни нашим слушателям,какая фактически работа стоит за превращением существующей базовой мультимодальной модели в большую модель действий?
Дэвид: Я могу обсудить это на более высоком уровне абстракции, но в целом требуется две вещи. Первая — инженерная: как представить то, что можно сделать, в понятной для модели форме. Например, вот API, которые можно вызывать, вот элементы UI, с которыми можно взаимодействовать. Давайте обучим его немного пониманию принципов работы Expedia.com (прим.: сайт бронирования путешествий) или SAP. Это часть исследовательской инженерии. Первый шаг — наделить модель осознанием собственных возможностей и базовым инструментарием действий.
Вторая часть — самая интересная, как научить ее планированию, рассуждению, перепланированию, следованию инструкциям пользователя, а также умению инферить реальные потребности пользователя и выполнять задачи ради них. Это сложная научно-исследовательская проблема, которая сильно отличается от обычной работы с языковыми моделями,потому что стандартные задачи языковых моделей сводятся к “давайте сгенерируем текст”,даже современные задачи логического вывода, такие как математические задачи, имеют однозначный финальный ответ.
Так что это скорее одношаговый процесс, даже если включает многоступенчатое мышление, он просто предоставляет вам ответ. Это совершенно иной процесс многошагового принятия решений с обратной связью, требующий прогнозирования последствий ваших действий и понимания, что кнопка удаления может быть опасной. Всё это должно быть заложено в базовую конфигурацию.
Затем вы помещаете это в песочницу, чтобы система училась в собственных условиях. Лучшая аналогия такова: Андре Карпати (Andrej Karpathy, прим. OpenAI founding team member, founded Eureka Labs in 2024) однажды сказал, что современное обучение ИИ напоминает организацию учебника. Сначала у вас полное объяснение физического процесса, затем примеры задач. Первая часть — предварительное обучение, примеры задач — супервизорное тонкое настраивание, а последний шаг — открытые вопросы, ответы на которые, может быть, даны в конце учебника.Мы просто следуем этому процессу.
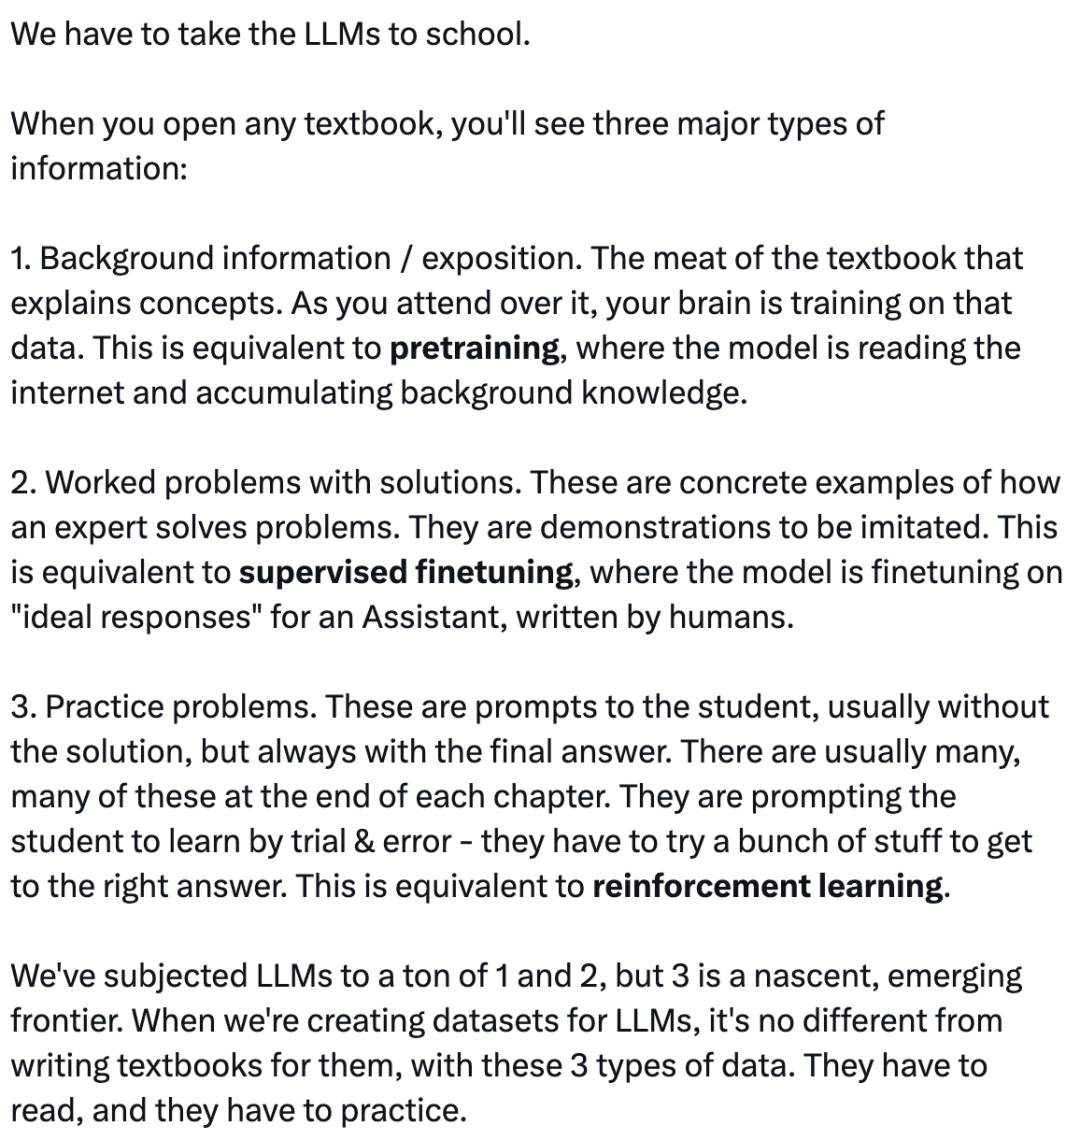
Описание Андре Карпати для больших моделей (Источник: X.com、明琅公司)
Джейкоб: Думаю, вы определенно много размышляли о том, как эти агенты действительно выйдут в мир. У меня есть несколько вопросов. Прежде всего, ты упоминал, что одна из проблем — заставить модели понимать, к чему у них есть доступ.Как в долгосрочной перспективе модели будут взаимодействовать с браузерами и программами?Это будет похоже на человеческое взаимодействие? Или только через код? Существуют ли иные методы?
Дэвид: Если мне придется комментировать эту область, я думаю, что сейчас главная проблема заключается в том, что люди совершенно лишены креативности в вопросах взаимодействия с этими становящимися всё умнее большими моделями и агентами.Вы помните, когда iPhone только вышел, App Store тоже появился, и люди начали создавать различные приложения, например, нажимающие кнопку для отрыжки или запрокидывающие телефон, чтобы налить пиво в рот. Наши интерфейсы сейчас именно такие, ощущаются ужасно, ведь общение в чате — это суперограниченный и низкопропускной канал взаимодействия, по крайней мере в некоторых аспектах.Например, я совсем не хочу тратить семь раундов диалога, чтобы выбрать начинку для своей пиццы.
Эта нехватка креативности вызывает у меня разочарование. Частично это связано с тем, что талантливые продуктовые дизайнеры, способные помочь нам решить эти проблемы, пока не до конца понимают ограничения подобных моделей.Ситуация быстро меняется, но до сих пор те, кто двигает технологический прогресс вперед, часто воспринимают свой продукт как “я предоставляю здесь черный ящик”, вместо “я создаю здесь определенный пользовательский опыт”.
Когда ситуация изменится, я буду ждать появления таких систем, которые при взаимодействии с агентом фактически будут синтезировать мультимодальный пользовательский интерфейс, перечислять информацию, необходимую от пользователя, и создавать общее контекстное поле (Context) между человеком и ИИ, вместо нынешней парадигмы, когда вы просто переписываетесь с ним. Скорее всего, это будет напоминать совместную работу над компьютером, глядя на экран вместе, скорее параллельно, чем вертикально.
Джейкоб: Ты упоминал, что Operator сейчас впечатляет, но порой несовершенен. Как думаешь, когда же у нас появятся надежные агенты?
Дэвид: Я считаю Operator выдающимся достижением, просто всей отрасли пока не хватает последнего кусочка головоломки.
Джейкоб: Думаю, учитывая историю автономного вождения, возможно, ещё в 1995 году проводились демонстрации, когда машина могла преодолевать 99% расстояния по стране целиком на автопилоте.
Дэвид: Да.
Джейкоб: Нам придётся ждать ещё 30 лет?
Дэвид: Не думаю. Я считаю, что инструменты у нас уже есть.
Джейкоб: Ты ранее говорил, что AGI (Общий Искусственный Интеллект) на самом деле недалеко.
Дэвид: В сфере агентов главным ориентиром для меня служит способность дать агенту любую задачу во время обучения, вернуться через несколько дней и увидеть, что она выполнена на 100%. Да, подобно тому, как человеческий труд обеспечивает повышение надежности на 5%, этот агент уже научился решать поставленную задачу.
Джейкоб: Как ты отмечал ранее, когда ты создавал Adept, по-настоящему open-source моделей не существовало, не говоря уже о мультимодальных open-source моделях. Думаете ли вы, что если сегодня кто-то начнет компанию вроде Adept, сможет ли стартап добиться успеха здесь? Или же окончательное продвижение мяча вперед будет происходить за счет компаний-разработчиков базовых моделей и гипермасштабируемых облачных провайдеров?
Дэвид: У меня большие сомнения по этому поводу.Но моя текущая точка зрения такова: лично я считаю, что AGI на самом деле не за горами.
Джейкоб: Когда ты говоришь об AGI, как ты определяешь этот термин?
Дэвид: Одна часть определения — модель, способная выполнять любую полезную задачу на компьютере, которую выполняет человек. Мне также нравится другое определение: модель, способная учиться и осваивать эти задачи с той же скоростью, что и человек. Я думаю, что оба варианта недолго осталось ждать, но я также не считаю, что они мгновенно проникнут в общество. Как мы знаем, согласно закону Амдала (Amdahl's Law), как только вы по-настоящему ускоряете какой-либо один процесс, остальные становятся узким горлышком, и общая скорость ускорения оказывается меньше ожидаемой.
Поэтому, думаю, случится следующее: технология у нас появится, но способность людей эффективно использовать её сохранится еще на длительное время. Мои многие коллеги называют это «overshoot возможностей» (Capability overhang), огромным дисбалансом между возможностями и их применением.
Джейкоб: Есть ли у тебя какие-либо предварительные размышления о факторах ускорения, которые могут возникнуть после получения таких возможностей?
Дэвид: Думаю, это зависит от людей. Это вопрос того, как совместно проектировать взаимодействие с моделями и как ими пользоваться. Это вопрос социального принятия. Например, представьте, завтра появляется модель, которая говорит: “Я изобрела совершенно новый способ делания вещей, все должны его начать использовать.” Людям нужно прийти к соглашению с ней и решить, действительно ли это лучшее решение. Процесс интеграции займет не так мало времени, как мы предполагаем.
Джейкоб: Как ты сказал, даже если лаборатории первыми создают эти модели, у стартапов может возникнуть возможность преодолеть разрыв между возможностями моделей и тем, что конечные пользователи реально хотят получить при взаимодействии.
Дэвид: Я практически уверен, что это именно так и случится. Ведь в конечном счете я твердо верю, что в мире с AGI человеческие отношения имеют огромное значение. В конечном итоге понимание клиентов и близость к ним для выявления их реальных потребностей будет важнее, чем простое обладание инструментом, которым владеют многие другие лаборатории.
Джейкоб: Как ты видишь использование компьютеров людьми в ближайшие десять лет? Все эти модели соответствуют твоим определениям AGI. Буду ли я всё ещё сидеть перед компьютером? Каким ты видишь будущее взаимодействие людей с этими технологиями?
Дэвид: Думаю, у нас появятся новые инструменты для взаимодействия с компьютерами. Сегодня по-прежнему есть люди, использующие командную строку, верно? Подобно тому, как продолжают пользоваться графическим интерфейсом (GUI). В будущем люди по-прежнему будут использовать голосовые интерфейсы. Но я думаю, что люди начнут применять больше ambient computing (окружающих вычислений). И мне кажется, важным метрическим показателем должно стать коэффициент рычага (leverage), который человек получает на единицу затраченной энергии при взаимодействии с компьютером. Я полагаю, по мере развития этих систем этот показатель будет только расти.
Джейкоб: Может, немного расскажи о мире моделей будущего, будем ли мы в конечном итоге иметь специализированные модели для конкретных областей?
Дэвид: Давайте рассмотрим гипотетическую модель эксперта по праву. Вы можете ожидать, что этот гипотетический правовой эксперт будет обладать определенными базовыми знаниями о мире.
Джейкоб: Многие студенты юридических факультетов сначала получают общую степень бакалавра.
Дэвид: Именно. Поэтому я думаю, появятся нишевые модели, но не стоит упускать из виду общий контекст — просто признаем факт существования специализированных моделей. Я полагаю, они возникнут по техническим причинам, но также и по политико-регуляторным причинам.
Джейкоб: Это интересно, что ты имеешь в виду?
Дэвид: Это похоже на ситуацию, когда некоторые компании категорически не хотят, чтобы их данные смешивались. Представьте, что вы большой банк, у вас отделы продаж и трейдинга, инвестиционно-банковское подразделение. AI-сотрудники или LLM поддерживают эти подразделения. Как и сегодня сотрудники разных отделов не могут свободно обмениваться информацией, так и модели не должны передавать знания друг другу через свои веса.
Джейкоб: Что еще нужно решить? Что касается моделей, кажется, ты полон уверенности, что если мы просто масштабируем текущие вычислительные мощности, мы сможем очень близко подойти к решению необходимых задач.Есть ли другие масштабные технические вызовы, требующие преодоления для дальнейшего увеличения интеллектуального потенциала моделей?
Дэвид: На самом деле, я не согласен с идеей:что достаточно просто перенести существующие технологии на вычислительный кластер будущего через два года, и всё чудесным образом заработает. Хотя масштаб по-прежнему останется ключевым фактором, моя уверенность исходит из оценки текущих открытых проблем — необходимости оценить степень сложности их решения. Например, существуют ли сверхзадачи, которые невозможно решить без революционных инноваций? Например, полная замена алгоритма градиентного спуска (注:gradient descent,当前深度学习模型参数优化的核心算法,通过计算损失函数的负梯度方向迭代更新参数), или необходимость полагаться на квантовые компьютеры для достижения AGI. Но я не считаю эти пути неизбежными.
Джейкоб: Когда появляются новые модели, как ты их оцениваешь? Есть ли у тебя фиксированные вопросы для тестов, или как ты определяешь качество новых моделей?
Дэвид: Моя методология оценки базируется на двух ключевых принципах: Методологическая простота (Methodological Simplicity): это одна из самых захватывающих черт глубокого обучения — когда исследование сопровождается документацией с описанием метода (что в сегодняшних условиях становится редкостью), достаточно осмотреть реализацию, чтобы зачастую обнаружить решение проще и эффективнее традиционных подходов. Такие прорывы обычно попадают в канон глубинного обучения (deep learning canon), даруя момент озарения: “Это действительно демонстрирует красоту алгоритма”.
Несоответствие бенчмарков (Benchmark Misalignment): существующий хайп (hype) в отрасли привел к тому, что множество бенчмарков отошли от реальных потребностей моделей, хотя в процессе НИОКР им уделяется чрезмерное внимание. Эти тесты по сути представляют собой игру. Сложность оценки и измерения严重低估了 — они заслуживают большей академической репутации и ресурсов по сравнению со многими текущими направлениями исследований.
Фактическая дифференцированная технологическая база минимальна
Джейкоб: Похоже, у каждого есть свои внутренние бенчмарки, которые они не публикуют открыто, например, тем, которому они больше доверяют. Можно видеть, как модели OpenAI показывают лучшие результаты во многих тестах по программированию, но все используют модели Anthropic, так как знают, что те лучше. Видеть эволюцию этой отрасли очень интересно. Хочу услышать твои мысли о недавних событиях в Amazon и взгляды на роль компании в более широкой экосистеме.
Дэвид: Да, Amazon — очень интересное место. На самом деле, я многому научился там. Amazon всерьез стремится к созданию систем общего интеллекта, особенно универсальных агентов.Круто то, что все сотрудники Amazon понимают: сама вычислительная нагрузка трансформируется из знакомых нам фундаментальных элементов в вызовы больших моделей или крупных агентов, которые, возможно, станут важнейшими элементами вычислений будущего. Люди очень беспокоятся об этом, что прекрасно.
Интересно, что я руковожу бизнес-подразделением агентов в Amazon. Круто видеть, насколько глубоко агенты проникают в такую крупную компанию, как Amazon. Питер (Peter, прим.) и я открыли новую исследовательскую лабораторию для Amazon в Сан-Франциско. Это во многом обусловлено тем, что многие топ-менеджеры Amazon искренне верят: необходимы новые прорывы в исследованиях, для решения основных вопросов, ведущих к AGI, о которых мы говорили ранее.
Джейкоб: Следите ли ты за какими-либо альтернативными архитектурами или более авангардными областями исследований?
Дэвид: Позволь подумать. Я всегда слежу за тем, что может помочь лучше сопоставить обучение моделей с вычислениями.Можем ли мы использовать больше вычислений более эффективно?Это дает огромный мультипликативный эффект тому, что мы можем делать. Но на самом деле я трачу больше времени на изучение дата-центров и чипов, поскольку считаю это крайне увлекательным. Сейчас происходят интересные движения в этой сфере.
Джейкоб: Похоже, одним из главных драйверов развития моделей является аннотирование данных, и очевидно, все лаборатории вкладывают туда огромные деньги. В парадигме тестовых вычислений это всё ещё релевантно?
Дэвид: Я думаю сразу о двух задачах, решаемых аннотированием данных. Первая — обучение модели основам выполнения задачи путем клонирования человеческого поведения. Имея качественные данные, вы можете эффективнее стимулировать модели раскрывать паттерны, уже встречавшиеся им в процессе предварительного обучения. Затем я полагаю, вторая задача — научить модель различать хорошее и плохое выполнение сложных задач с неоднозначными критериями. Я считаю, обе эти задачи по-прежнему крайне важны. ……
Джейкоб: Ты находишься в авангарде этой области уже десятрок лет. Нашлась ли вещь, изменившая твое мнение за последний год?
Дэвид: Я постоянно размышлял о формировании культуры команды.Мы всегда знали об этом, но теперь я убежден ещё сильнее: найм по-настоящему умных, энергичных людей с внутренней мотивацией, особенно находящихся в начале карьеры, на самом деле является важным двигателем нашего успеха. В этой индустрии каждые несколько лет лучшие стратегии меняются. Поэтому люди, чересчур адаптировавшиеся к прошлым лучшим практикам, на самом деле замедлят ваш темп.Поэтому я считаю, что по сравнению с моими прежними взглядами, делать ставку на новичков оказалось выгоднее.
Еще одна вещь, поменявшая мое мнение: раньше я считал, что в создании ИИ существует настоящая долгосрочная техническая дифференциация, на основе которой можно непрерывно накапливать преимущество.Я думал, если вы отлично разбираетесь в текстовом моделировании, это естественным образом поможет вам победить в мультимодальном направлении. Если вы сильны в мультимодальности, вы станете лидерами в рассуждениях и агентах... Эти преимущества должны были накапливаться. Но на практике я видел малый объем накопленного опыта. Я думаю, все пытаются схожие идеи.
Джейкоб: Другими словами, просто потому что вы первыми сделали прорыв в А, это не означает автоматического преимущества в В. Например, прорыв OpenAI в языковых моделях не гарантирует обязательно прорыва в логическом выводе.
Дэвид: Они связаны между собой, но это не означает обязательной победы в следующей возможности.
Когда роботы попадут в дома
Джейкоб: Я хочу спросить, ты изначально пришел в ИИ через робототехнику. Так что, каково твое видение текущей ситуации в области ИИ-роботов сегодня?
Дэвид: Ситуация похожа на мою оценку цифровых агентов: я думаю, у нас уже есть множество сырья. И мне кажется интересным, что цифровые агенты дают нам шанс решить некоторые сложные проблемы до того, как физические агенты перейдут в стадию активного развертывания.
Джейкоб: Расскажи подробнее, как надежность цифровых агентов может распространиться на физических?
Дэвид: Приведу простой пример. Предположим, вам нужно перепланировать склад. У вас есть физический агент, и вы просите его рассчитать оптимальный план перестановки склада. Обучение в физическом мире или даже в симуляторах роботов было бы затруднительно. Но если вы уже достигли этого в цифровом пространстве и обладаете всеми рецептами обучения и знаниями корректировки алгоритмов для обучения на симуляционных данных, это как будто вы уже проходили тренировочные колеса для выполнения этой задачи.
Джейкоб: Это интересно. Мне кажется, когда люди думают о роботах, есть два крайних мнения. Кто-то считает, что законы масштабирования, обнаруженные нами в языковых моделях, найдут своё отражение и в робототехнике, мы стоим на пороге грандиозных перемен.Часто можно услышать, как Дженсен Хуанг (Jensen Huang, основатель Nvidia) говорит об этом. Другие считают, что это как машины с автопилотом 1995 года: отличная демонстрация, но потребуется долгое время, прежде чем это станет по-настоящему рабочим. Где ты находишься на этом спектре?
Дэвид: Я возвращаюсь к тому, что упоминал ранее. Больше всего меня уверенным делает наша способность создавать обучающие формулы,позволяющие выполнить задачу на 100%. Мы способны реализовать это в цифровом пространстве.Несмотря на наличие вызовов, в конечном итоге навыки транслируются и в физическое пространство.
Джейкоб: Когда мы увидим роботов у себя дома?
Дэвид: Думаю, это снова возвращается к вопросу, который я уже затрагивал. Множество проблем упираются не в построение моделей (modeling), а в диффузию (diffusion) моделей — их распространение и адаптацию.
Джейкоб: А как насчет видео-моделей? Очевидно, сейчас многие входят в эту область, это новый фронт, требующий понимания моделей мира и физики для более открытого исследования. Может, расскажешь, что ты наблюдаешь в этой области и каково твое мнение?
Дэвид: Я очень воодушевлен этим направлением. Я думаю, оно решает одну из основных проблем, о которых мы ранее упоминали: сегодня мы можем заставить reinforcement learning работать в задачах с верификаторами (Verifier), например, доказательстве теорем.
Затем мы обсуждали, как расширить это на область цифровых агентов, где у вас нет верификатора, но есть надежный симулятор, так как я могу запустить тестовую среду приложения и обучить агента его использованию. Но я думаю, оставшаяся основная проблема заключается в том, что происходит, когда нет явного верификатора или четкого симулятора. Я считаю, моделирование мира (World modeling) — это наш ответ на этот вопрос.
Путь организационного роста OpenAI
Джейкоб: Отлично. Хочу немного сместить тему в сторону OpenAI и твоего времени там. Очевидно, ты участвовал в очень специфический период истории компании и сыграл важную роль во многих успехах. Думаю, в будущем мы увидим множество анализов культуры OpenAI, того, что особенного было в ту эпоху, когда разрабатывались GPT-1 до GPT-4. Как думаешь, какие выводы сделают те аналитики? Что сделало эту организацию такой успешной?
Дэвид: Когда я присоединился к OpenAI, исследовательское сообщество всё еще было очень маленьким. Это был 2017 год, OpenAI существовала чуть больше года. Я знал основателей и некоторых первых сотрудников, которые искали человека, способного размыть границы между исследованиями и инженерией, и я идеально подходил под эту роль.
Так что присоединение к OpenAI было большой удачей. В команде было всего 35 человек, но все они исключительно талантливы, они многое работали в сфере суперкомпьютеров, плюс были и другие выдающиеся специалисты, которых я могу перечислять по одному. Все они были чрезвычайно квалифицированными людьми для того времени.
Интересно, что изначально моя заключалась в помощи OpenAI в масштабировании инфраструктуры от маленькой группы к большей. Но быстро моя работа начала трансформироваться в поиск стратегии дифференцированных исследований, позволяющей принимать верные решения в машинном обучении для этого периода. Мы осознали раньше других, что предыдущая модель исследований — «ты и твои лучшие трое друзей пишете статью, меняющую мир» — подошла к концу. Нам действительно пришлось задуматься о новой эпохе, пытаясь решить крупные научные цели с помощью более крупных команд, объединяющих исследователей и инженеров, независимо от того, определяется ли academia решением как «новое». Мы готовы брать на себя ответственность за это. Когда GPT-2 выпустили впервые, люди сказали: «Похоже на Трансформер». «Да, это Трансформер». И мы этим гордились.
Джейкоб: Так почему же ты изначально решил присоединиться к OpenAI?
Дэвид: Я был очень взволнован, потому что хотел стоять на переднем крае исследований. Выбор тогда стоял между OpenAI, DeepMind и Google Brain. ... Как я уже упоминал ранее, ставка на людей с сильной внутренней мотивацией, особенно начинающих карьеру, оказалась чрезвычайно успешной стратегией. Есть много других людей, определивших ту область, у которых не было PhD или 10 лет опыта.
Джейкоб: Ты заметил общие черты среди этих выдающихся исследователей? Что делает их такими исключительными? Чему ты научился о том, как составлять команды для достижения целей?
Дэвид: В значительной степени это внутренняя мотивация и интеллектуальная гибкость.. Был один парень, который был невероятно увлечен и включен в исследование, которое он проводил в нашей команде — не буду называть его имя. Примерно спустя полтора месяца я провел с ним индивидуальную беседу, и он вдруг сообщил, что переехал в район залива, чтобы присоединиться к нам, но еще не успел подключить Wi-Fi или свет в своей квартире. Он тратил все свое время в офисе, проводя эксперименты, что для него было совершенно не важно.
Джейкоб: Эта страсть впечатляет. Ранее я слышал, как ты упоминал, что Google не смог сделать прорыв с GPT, несмотря на то, что Трансформер был изобретен в Google. Было ясно, насколько велик потенциал этой технологии, но Google как целое очень трудно собрался вокруг неё. Каково твое мнение по этому поводу?
Дэвид: Это заслуга Ильи (Ilya Sutskever, прим.), нашего научного лидера в базовых исследованиях, который впоследствии способствовал появлению GPT, CLIP и DALL·E. Я помню, как он часто приходил в офис, как миссионер, рассказывая людям: «Ребята, я думаю, эта статья важна».**Он подталкивал людей экспериментировать с Трансформерами.
Джейкоб: Вы считаете, что те базовые ИИ-компании, которые сейчас делают много вещей, приведут ли к появлению другого «рецепта» в какой-то момент будущего?
Дэвид: Я считаю, что терять фокус очень опасно.
Джейкоб: Ты, вероятно, один из крупнейших фанатов Nvidia и Jensen (黄仁勋). Помимо общеизвестных достижений, как ты думаешь, есть ли у Nvidia какие-то вещи, о которых мало говорят, но которые на самом деле крайне важны для этой компании?
Дэвид: Я очень уважаю Дженсена, настоящий легенд. Кажется, он принимал множество верных решений на протяжении долгого времени. Последние годы были гигантским переломным моментом для Nvidia, когда они **интернализировали технологии связи (interconnects)** и **решили строить бизнес вокруг систем**. Это был очень мудрый шаг.
Джейкоб: Обычно мы в конце интервью делаем быстрый раунд вопросов. Как ты считаешь, в этом году развитие моделей будет более активным, менее активным или таким же, как в прошлом?
Дэвид: На первый взгляд может показаться, что прогресс примерно одинаковый, но на деле его больше.
Джейкоб: Как ты считаешь, что в индустрии ИИ сейчас переоценено, а что недооценено?
Дэвид: Переоценено — это дискурс типа “навыки мертвы, мы все погибли, больше не покупайте чипы”. Недооценено — то, как мы по-настоящему решим проблемы гипермасштабного моделирования, чтобы модели могли учиться на них.
Джейкоб: Дэвид, это был невероятно потрясающий разговор. Я думаю, многие захотят узнать больше о твоей работе в Amazon и увлекательных проектах, над которыми ты работаешь. Где люди могут найти больше информации?
Дэвид: По вопросам работы в Amazon, следите за страницей Amazon SF AI Lab. На самом деле я редко пользуюсь Twitter, но собираюсь вернуться. Так что можете подписаться на мой аккаунт в Twitter: @jluan.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News











