


Ян Чжилинь и Лян Вэньфэн, их статьи совпали
I
В тот же день, когда Маск выпустил Grok-3, обученный на 200 тысячах карт, в техническом сообществе были опубликованы две статьи, представляющие собой «противоположный» путь к чуду, сотворенному грубой силой Маска.
В списках авторов этих двух статей есть各自 одно знакомое всем имя:
Лян Вэньфэн, Ян Чжилинь.
18 февраля DeepSeek и Moonshot AI почти одновременно выпустили свои последние статьи, и темы напрямую «столкнулись» — обе бросают вызов самому核心的 механизму внимания архитектуры Transformer, делая его более эффективным для обработки более длинного контекста. Что еще интереснее, имена звездных основателей технологического направления обеих компаний появились в их соответствующих статьях и технических отчетах.
Статья, выпущенная DeepSeek, называется: «Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention».
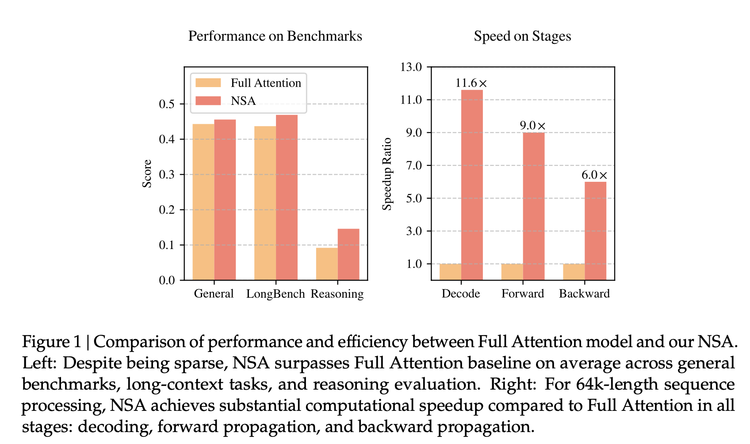
Согласно статье, предложенная ею новая архитектура NSA (Native Sparse Attention) в бенчмарках показывает точность такую же или более высокую по сравнению с полным механизмом внимания; при обработке последовательности из 64 тысяч токенов скорость может увеличиться до 11,6 раза, обучение также более эффективно и требует меньше вычислительных мощностей; отлично проявляет себя в задачах с сверхдлинным контекстом (например, суммаризация книг, генерация кода, задачи рассуждения).
По сравнению с алгоритмическими инновациями, которыми ранее все восхищались, на этот раз DeepSeek протянула руку к модификации самого核心ного механизма внимания (attention).
Transformer является основой процветания всех больших моделей сегодня, но его核心ный алгоритм — механизм внимания — все еще имеет врожденные проблемы: если использовать метафору чтения, традиционный «полный механизм внимания» для понимания и генерации читает каждое слово в тексте и сравнивает его со всеми остальными словами. Это приводит к тому, что чем длиннее текст, тем сложнее обработка, технология тем больше тормозит и даже может崩溃.
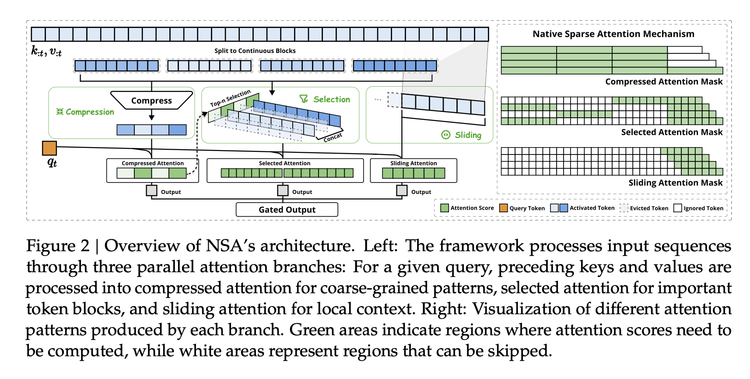
Ранее академическое сообщество постоянно предлагало различные идеи решения, NSA通过 инженерную оптимизацию и эксперименты в реальной среде собрала архитектурное方案, состоящее из трех этапов, которое можно использовать на этапе обучения:
Оно включает: 1) семантическое сжатие — вместо просмотра каждого слова, они делятся на группы, то есть «блоки», сокращая длину последовательности до 1/k при сохранении глобальной семантики, одновременно вводится позиционное кодирование для снижения потери информации,进而 снижая вычислительную сложность с O(n²) до O(n²/k).
2) динамический выбор — модель с помощью某种 механизма оценки баллов выбирает из текста наиболее важные слова и проводит для них вычисления с细粒度. Эта стратегия выборки по важности позволяет сохранить 98% информации с细粒度 при уменьшении объема вычислений на 75%.
3) скользящее окно — если первые два этапа это суммаризация и выделение главного, то скользящее окно это просмотр информации ближайшего контекста, что позволяет сохранить связность, а благодаря технологии повторного использования видеопамяти на уровне hardware частота доступа к памяти может быть снижена на 40%.
Ни одна из этих идей не является изобретением DeepSeek, но это можно представить как работу в стиле ASML — эти технические элементы уже существовали, разбросанные повсюду, но инженерно их объединили в масштабируемое方案, новую алгоритмическую архитектуру, чего раньше никто не делал. Теперь кто-то с помощью мощных инженерных возможностей создал «литографический станок», который другие могут использовать для обучения моделей в реальной промышленной среде.
В статье, выпущенной в тот же день Moonshot AI, предлагается архитектура, очень一致ная по核心ной идее: MoBA. (MoBA: MIXTURE OF BLOCK ATTENTION FOR LONG-CONTEXT LLMS)
Из названия видно, что она также использует метод превращения «слов» в блоки. После «разрезания на блоки», в MoBA есть gating network, похожая на «интеллектуального фильтра», которая отвечает за выбор Top-K блоков, наиболее релевантных одному «блоку», и вычисляет внимание только для этих выбранных блоков. В процессе реальной реализации MoBA также сочетает оптимизационные средства FlashAttention (который делает вычисление внимания более эффективным) и MoE (смесь экспертов).
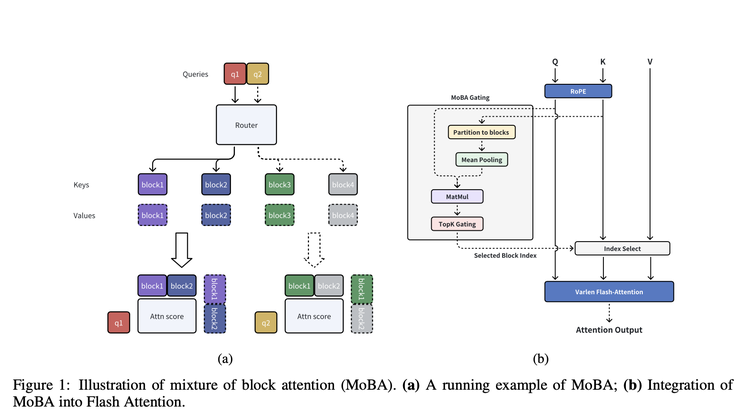
По сравнению с NSA, она больше подчеркивает гибкость, не полностью отходя от самого mainstream полного механизма внимания сегодня, а разработала способ свободного переключения, позволяющий этим моделям переключаться между полным и稀疏 механизмами внимания, предоставляя больше пространства для адаптации существующим моделям с полным вниманием.
Согласно статье, вычислительная сложность MoBA становится очевидно преимущественной с увеличением длины контекста. В тесте с 1M токенов MoBA быстрее полного внимания в 6,5 раза; при 10M токенов ускорение составляет 16 раз. Более того, она уже используется в продукте Kimi для обработки потребностей обычных пользователей в сверхдлинном контексте.
Важной причиной внимания к созданию Moonshot AI Ян Чжилинем изначально было влияние его статей и количество цитирований, но до статьи K1.5 его последнее исследование в виде статьи остановилось в январе 2024 года. Хотя Лян Вэньфэн фигурирует как автор в самых важных отчетах о технологиях моделей DeepSeek, списки авторов этих отчетов практически эквивалентны списку сотрудников DeepSeek, почти все там перечислены. А в статье NSA авторов всего несколько человек. Из этого видно важность этих двух работ для основателей этих двух компаний, а также значение для понимания их технических путей.
Еще одна деталь, подтверждающая эту важность, заключается в том, что некоторые пользователи обнаружили, что запись о提交 статьи NSA на arXiv показывает, что она была提交 16 февраля, и提交щим был сам Лян Вэньфэн.
II
Это не первый раз, когда Moonshot AI и DeepSeek «сталкиваются». Одновременно с выпуском R1, Kimi редко выпустила технический отчет K 1.5, ранее эта компания не prioritized внешнюю демонстрацию своих технических размышлений. В то время эти две статьи одновременно нацелились на модели рассуждения, движимые RL.事实上, внимательно прочитав эти два технических отчета, в статье K1.5 Moonshot AI поделилась более подробной информацией о том, как обучать модель рассуждения, даже исключительно с точки зрения информативности и детальности, она выше статьи R1. Но впоследствии волна DeepSeek затмила不少 обсуждений самой этой статьи.
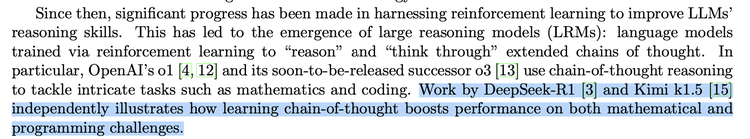
Подтверждением может служить недавно выпущенная OpenAI статья, объясняющая способности рассуждения моделей серии o, где одновременно упомянуты имена DeepSeek R1 и Kimi k1.5. «DeepSeek-R1 и Kimi k1.5通过 независимые исследования показали, что использование метода обучения цепочке рассуждений (CoT) может значительно улучшить综合表现 моделей в решении математических задач и программировании». То есть, это две модели рассуждения, которые OpenAI сама выбрала для сравнения.
«Самое удивительное в этой архитектуре больших моделей, по моему мнению, заключается в том, что она, кажется, сама указывает направление движения, позволяя разным людям с разных углов прийти к схожим направлениям развития».
Поделился профессор Университета Цинхуа Чжан Минсин, участвовавший в ключевых исследованиях MoBA, на Zhihu.
Он также привел интересное сравнение.
«DeepSeek R1 и Kimi K1.5 оба указывают на ORM based RL, но R1 начинает с Zero, более «чисто» или «less structure», выпущена раньше, одновременно开源模型.
Kimi MoBA и DeepSeek NSA снова оба указывают на learned sparse attention, который может обратно передаваться, на этот раз MoBA более «less structure», выпущена раньше, одновременно开源代码».
Последовательные «столкновения» этих двух компаний помогают людям лучше понять развитие технологии обучения с подкреплением через сравнение, а также направление эволюции механизма внимания для более эффективного и длинного текста.
«Так же, как совместное рассмотрение R1 и K1.5 позволяет лучше понять, как обучать Reasoning Model, совместное рассмотрение MoBA и NSA позволяет лучше понять с разных сторон нашу уверенность в том, что sparsity в Attention должна существовать и может быть изучена через端到端 обучение», — написал Чжан Минсин.
III
После выпуска MoBA, Сюй Синьжань из Moonshot AI также заявила в социальных сетях, что это работа, над которой трудились полтора года, и теперь разработчики могут использовать ее из коробки.
Однако выбор момента для открытого исходного кода неизбежно будет обсуждаться в «тени» DeepSeek. Интересно, что сегодня, когда все активно интегрируют DeepSeek и открывают свои модели,外界, кажется, в первую очередь думает о Moonshot AI, обсуждения о том, подключится ли Kimi и будет ли модель открыта, не прекращаются, Moonshot AI и Doubao, кажется, стали двумя оставшимися «исключениями».
И теперь看来, влияние DeepSeek на Moonshot AI по сравнению с другими игроками является более устойчивым, оно принесло вызовы во всем: от технического пути до борьбы за пользователей: с одной стороны, это доказало, что даже при переходе к конкуренции продуктов, возможности基础模型 все еще являются самыми важными; кроме того, сегодня становится все более очевидной другая цепная реакция: комбинация поиска WeChat от Tencent и Yuanbao, используя импульс DeepSeek R1, восполняет пропущенную ранее маркетинговую кампанию, в конечном итоге также нацеливаясь на Kimi и Doubao.
Стратегия ответа Moonshot AI становится заметной. Среди них открытый исходный код — обязательный шаг. И, похоже, выбор Moonshot AI заключается в том, чтобы действительно соответствовать стратегии открытого исходного кода DeepSeek — в настоящее время многие открытые исходные коды, появившиеся после DeepSeek, больше похожи на реактивную реакцию, они все еще используют предыдущую стратегию открытого исходного кода периода Llama для追随.事实上, открытый исходный код DeepSeek уже отличается от предыдущего, это больше не оборонительный открытый исходный код в стиле Llama, чтобы disrupt закрытых конкурентов, а конкурентная стратегия, которая может принести явную выгоду.
Недавно появились сообщения, что внутри Moonshot AI «ставят целью результаты SOTA (state-of-the-art)», что, похоже, является стратегией, наиболее близкой к этой новой модели открытого исходного кода, открывать нужно самую сильную модель, самый сильный архитектурный метод, что, наоборот, принесет желаемое влияние на стороне приложений.
Согласно статьям обеих компаний, MoBA уже используется в моделях и продуктах Moonshot AI, NSA也一样, это даже позволяет外界 иметь более четкие ожидания относительно следующих моделей DeepSeek. Таким образом, следующим пунктом наблюдения является то, будут ли Moonshot AI и DeepSeek снова «сталкиваться» с下一代 моделями, обученными с помощью MoBA и NSA соответственно, и снова в форме открытого исходного кода — возможно, это тот узел, которого ждет Moonshot AI.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News







