«Сервер занят» у DeepSeek сводит всех с ума — что же на самом деле происходит за этим?
Источник изображения: сгенерировано ИИ Boundless
Частые ответы DeepSeek «Сервер занят, пожалуйста, попробуйте позже» доводят пользователей повсюду до белого каления.
Ранее малоизвестный широкой публике DeepSeek стал известен благодаря запуску 26 декабря 2024 года языковой модели V3, конкурирующей с GPT-4o. 20 января DeepSeek выпустила языковую модель R1, конкурирующую с OpenAI o1. После этого благодаря высокому качеству ответов, генерируемых в режиме «глубокого размышления», а также инновационным сигналам о возможном резком снижении затрат на предварительное обучение моделей, компания и приложение彻底 вышли в мейнстрим. Впоследствии DeepSeek R1 постоянно сталкивалась с перегрузками: функция поиска в интернете периодически выходила из строя, а в режиме глубокого размышления часто появлялось предупреждение «Сервер занят». Такие явления вызвали большое беспокойство у множества пользователей.
Более десяти дней назад DeepSeek начала испытывать перебои в работе серверов. 27 января в полдень на официальном сайте DeepSeek несколько раз отображалось сообщение «веб-страница/API deepseek недоступны». В тот же день DeepSeek стала самым скачиваемым приложением для iPhone в выходные дни, обойдя ChatGPT в американском регионе рейтинга загрузок.
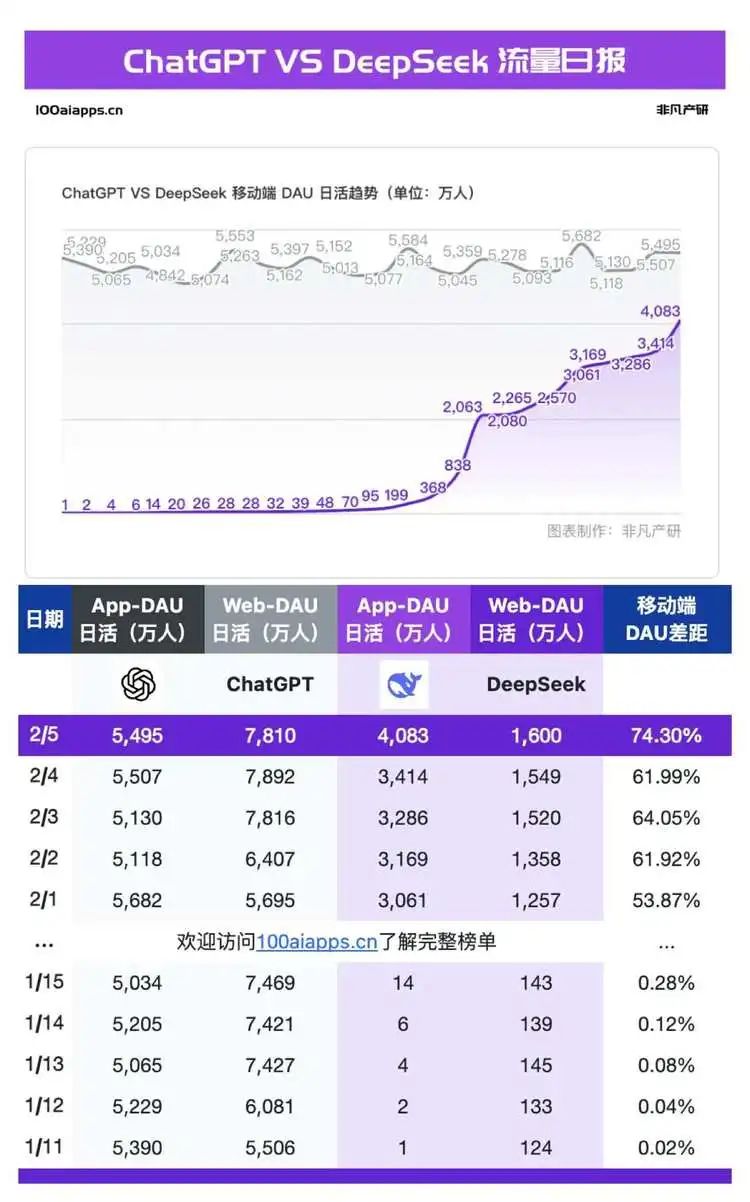
5 февраля мобильному приложению DeepSeek исполнилось 26 дней, дневная аудитория превысила 40 миллионов, дневная аудитория мобильного приложения ChatGPT составила 54,95 миллиона, что составляет 74,3% от показателей DeepSeek. Практически одновременно с выходом DeepSeek на крутую кривую роста посыпались жалобы на занятость ее серверов. Пользователи по всему миру начали сталкиваться с неудобствами, когда сервис падал после нескольких вопросов. Стали появляться различные альтернативные способы доступа, например, сайты-заменители DeepSeek, которые纷纷 запустили крупные облачные провайдеры, производители чипов и инфраструктурные компании. Повсюду появились руководства по личному развертыванию. Однако беспокойство людей не утихло: почти все важные производители глобального уровня заявили о поддержке развертывания DeepSeek, но пользователи повсюду продолжают жаловаться на нестабильность сервиса.
Что же стоит за этим?
1. Люди, привыкшие к ChatGPT, не могут мириться с недоступностью DeepSeek
Недовольство людей «занятостью серверов DeepSeek» проистекает из того, что ранее ведущие ИИ-приложения, в основном ChatGPT, редко сталкивались с задержками.
С момента запуска сервиса OpenAI, хотя ChatGPT и пережил несколько инцидентов простоя уровня P0 (самый серьезный уровень аварий), в целом он относительно надежен, уже нашел баланс между инновациями и стабильностью и постепенно стал ключевым компонентом, подобным традиционным облачным сервисам.
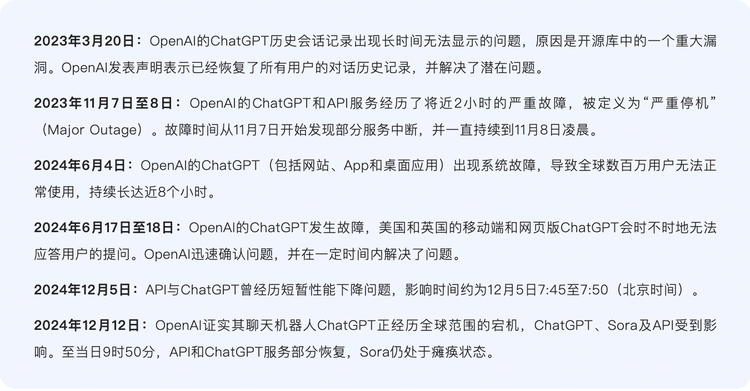
Количество массовых сбоев ChatGPT не так велико
Процесс вывода ChatGPT относительно стабилен и включает два этапа: кодирование и декодирование. На этапе кодирования входной текст преобразуется в векторы, содержащие семантическую информацию входного текста. На этапе декодирования ChatGPT использует ранее сгенерированный текст как контекст и через модель Transformer генерирует следующее слово или фразу, пока не будет сгенерировано полное утверждение, соответствующее запросу. Сама большая модель относится к архитектуре Decoder (декодер). Этап декодирования — это процесс вывода токенов за токеном (минимальная единица обработки текста большой моделью). Каждый запрос к ChatGPT запускает процесс вывода.
Например, если спросить ChatGPT: «Как у тебя сегодня настроение?», ChatGPT закодирует это предложение, сгенерирует представления внимания для каждого слоя. На основе представлений внимания всех предыдущих токенов предсказывается первый выходной токен «У». Затем происходит декодирование, «У» добавляется к «Как у тебя сегодня настроение?», получается «Как у тебя сегодня настроение? У», формируется новое представление внимания, затем предсказывается следующий токен: «меня». Затем по циклу первого, второго шага в итоге получается «Как у тебя сегодня настроение? У меня хорошее настроение.»
Инструмент оркестрации контейнеров Kubernetes является «закулисным командиром» ChatGPT, он отвечает за планирование и распределение ресурсов сервера. Когда наплыв пользователей полностью превышает возможности плоскости управления Kubernetes, это приводит к полному параличу системы ChatGPT.
Общее количество случаев паралича ChatGPT не слишком велико, но за этим стоят мощные ресурсы, поддерживающие его стабильную работу. Мощные вычислительные способности стоят за поддержанием стабильности, и это то, что люди упускают из виду.
Как правило, поскольку объем данных, обрабатываемых при выводе, часто меньше, требования к вычислительной мощности не так высоки, как при обучении. Некоторые отраслевые эксперты оценивают, что в нормальном процессе вывода большой модели основную часть видеопамяти занимают веса параметров модели, примерно более 80%. Реальность такова, что среди нескольких моделей, встроенных в ChatGPT, размеры моделей по умолчанию меньше, чем 671B у DeepSeek-R1. Кроме того, ChatGPT обладает гораздо большим количеством GPU-мощностей, чем DeepSeek, естественно демонстрируя более стабильную работу, чем DS-R1.
DeepSeek-V3 и R1 — это обе модели на 671B. Процесс запуска модели — это процесс вывода. Вычислительный резерв при выводе должен соответствовать количеству пользователей. Например, для 100 миллионов пользователей нужны видеокарты для 100 миллионов пользователей. Это не только огромно, но и независимо от вычислительного резерва при обучении, не связано с ним. Судя по информации из различных источников, запас видеокарт и вычислительных мощностей DS явно недостаточен, поэтому частые задержки.
Это сравнение непривычно для пользователей, адаптировавшихся к плавному опыту ChatGPT, особенно сейчас, когда их интерес к R1 растет.
2. Задержки, задержки и еще раз задержки
Более того, при тщательном сравнении ситуации OpenAI и DeepSeek очень различаются.
У первой есть поддержка Microsoft. Как эксклюзивная платформа OpenAI, облачный сервис Microsoft Azure оснащен ChatGPT, генератором изображений DALL-E 2, инструментом автоматического кодирования GitHub Copilot. Впоследствии эта комбинация стала классической парадигмой Cloud+AI и быстро распространилась, став отраслевым стандартом. Вторая, хотя и является стартапом, в большинстве случаев полагается на собственные центры обработки данных, подобно Google, а не на сторонних провайдеров облачных вычислений. Гуйсинжэнь, проверив общедоступную информацию, обнаружил, что DeepSeek ни на каком уровне не начинала сотрудничество с производителями облачных услуг или чипов (хотя во время праздника Весны облачные провайдеры纷纷 объявили о запуске моделей DeepSeek на своих платформах, они не проводили никакого сотрудничества в истинном смысле этого слова).
Кроме того, DeepSeek столкнулась с беспрецедентным ростом пользователей, что означает, что у нее было меньше времени на подготовку к стрессовым ситуациям, чем у ChatGPT.
Хорошая производительность DeepSeek обусловлена общей оптимизацией на уровне оборудования и системы. Материнская компания DeepSeek, High-Flyer Quant, еще в 2019 году потратила 200 миллионов на создание суперкомпьютерного кластера Firefly-1. К 2022 году они тихо накопили десятки тысяч видеокарт A100. Для более эффективного параллельного обучения DeepSeek самостоятельно разработала框架 обучения HAI LLM. Отрасль считает, что кластер Firefly, возможно, использует от нескольких тысяч до десятков тысяч высокопроизводительных GPU (таких как NVIDIA A100/H100 или отечественные чипы) для обеспечения мощных параллельных вычислительных способностей. В настоящее время кластер Firefly поддерживает обучение моделей DeepSeek-R1, DeepSeek-MoE и других. Эти модели показывают результаты, близкие к уровню GPT-4, в сложных задачах, таких как математика и код.
Кластер Firefly представляет собой путь исследования DeepSeek в области новых архитектур и методов, что также заставило外界 считать, что благодаря таким инновационным технологиям DS снизила стоимость обучения. Можно обучить R1, производительность которого сопоставима с топ-моделями ИИ, используя лишь долю вычислительных мощностей самых передовых западных моделей. SemiAnalysis после расчетов указала, что DeepSeek фактически обладает огромным резервом вычислительных мощностей: DeepSeek всего накопила 60 000 карт NVIDIA GPU, включая 10 000 A100, 10 000 H100, 10 000 «специальной версии» H800 и 30 000 «специальной версии» H20.
Это, казалось бы, означает, что количество карт для R1 достаточно. Но на самом деле, как модель вывода, R1 конкурирует с O3 от OpenAI. Такие модели вывода требуют развертывания большего количества вычислительных мощностей для этапа ответов. Однако что выше: вычислительные мощности, сэкономленные DS на стороне стоимости обучения, или резко возросшие вычислительные мощности на стороне стоимости вывода, в настоящее время неясно.
Стоит отметить, что DeepSeek-V3 и DeepSeek-R1 — это большие языковые модели, но способы их работы различаются. DeepSeek-V3 — это модель инструкций, подобная ChatGPT, которая получает подсказки и генерирует соответствующий текст для ответа. Но DeepSeek-R1 — это модель рассуждений. Когда пользователь задает вопрос R1, она сначала выполняет большой процесс рассуждений, а затем генерирует окончательный ответ. Среди токенов, сгенерированных R1, сначала появляется большой процесс цепочки мыслей. Перед генерацией ответа модель сначала объясняет проблему,分解 проблему. Все эти процессы рассуждений быстро генерируются в виде токенов.
По мнению Вэнь Тинцаня, вице-президента YaoTu Capital, aforementioned огромный резерв вычислительных мощностей DeepSeek относится к этапу обучения. На этапе обучения вычислительная мощность команды может быть запланирована, ожидаема, и нехватка вычислительных мощностей маловероятна. Но вычислительная мощность вывода имеет большую неопределенность, поскольку в основном зависит от масштаба пользователей и объема использования, относительно более эластична. «Вычислительная мощность вывода будет расти по определенному закону, но поскольку DeepSeek стала продуктом феноменального уровня, масштаб пользователей и объем использования взрывно выросли за короткое время. Это привело к взрывному росту спроса на вычислительные мощности на этапе вывода, поэтому возникли задержки».
Гуй Цзан, активный дизайнер продуктов моделей и независимый разработчик на Jike, согласен, что количество карт является основной причиной задержек DeepSeek. Он считает, что DS, как мобильное приложение с самым высоким количеством загрузок в 140 рынках по всему миру, текущие карты无论如何 не выдержат, даже новые карты не помогут, потому что «для создания облака из новых карт нужно время».
«Часовая стоимость запуска чипов, таких как NVIDIA A100, H100, имеет справедливую рыночную цену. С точки зрения стоимости вывода токенов, DeepSeek более чем на 90% дешевле аналогичных моделей o1 от OpenAI. Это не сильно отличается от расчетов людей. Поэтому сама архитектура модели MoE не является самой главной проблемой. Но количество GPU, принадлежащих DS, определяет максимальное количество токенов, которое они могут производить и предоставлять в минуту. Даже если можно использовать больше GPU для обслуживания пользователей через вывод, а не для исследований предварительного обучения, предел существует». Чэнь Юньфэй, разработчик нативного ИИ-приложения Cat Fill Light, придерживается аналогичного мнения.
Некоторые отраслевые эксперты также упомянули Гуйсинжэню, что суть задержек DeepSeek заключается в том, что частное облако не было хорошо настроено.
Хакерские атаки являются еще одним фактором,驱动 задержки R1. 30 января СМИ узнали от компании кибербезопасности Qi An Xin, что интенсивность атак на онлайн-сервисы DeepSeek внезапно возросла. Количество команд атак увеличилось в сотни раз по сравнению с 28 января. Лаборатория Xlab Qi An Xin наблюдала участие как минимум 2 ботнетов в атаках.
Но у таких задержек самого сервиса R1 есть看起来比较 очевидное решение — предоставление услуг третьими сторонами. Это также наиболее оживленная сцена, которую мы наблюдали во время праздника Весны — различные производители纷纷 развернули услуги, удовлетворяя спрос людей на DeepSeek.
31 января NVIDIA объявила, что NVIDIA NIM уже можно использовать с DeepSeek-R1. Ранее NVIDIA под влиянием DeepSeek за одну ночь потеряла в капитализации почти 600 миллиардов долларов. В тот же день пользователи облака AWS Amazon могли развернуть новейшую базовую модель DeepSeek R1 на своей платформе искусственного интеллекта Amazon Bedrock и Amazon SageMaker AI. Впоследствии новые игроки в области ИИ-приложений, включая Perplexity и Cursor, также массово подключили DeepSeek. Microsoft опередила Amazon и NVIDIA,率先 развернув DeepSeek-R1 на облачном сервисе Azure и GitHub.
С 1 февраля, четвертого дня Нового года, к ним присоединились Huawei Cloud, Alibaba Cloud, Volcengine от ByteDance и Tencent Cloud. Они обычно предоставляют услуги развертывания всех моделей и размеров DeepSeek. Затем последовали производители ИИ-чипов, такие как Biren Technology, Vastai Technologies, Ascend, MetaX. Они заявили, что адаптировали оригинальную версию DeepSeek или версии дистилляции меньшего размера. Со стороны программных компаний Yonyou, Kingdee и другие подключили модель DeepSeek в некоторых продуктах для усиления возможностей продукта. Наконец, терминальные производители, такие как Lenovo, Huawei, Honor, подключили модель DeepSeek в некоторых своих продуктах, используя ее как персональный помощник на устройстве и для интеллектуальных кабин автомобилей.
На сегодняшний день DeepSeek благодаря своей собственной ценности привлекла всеобъемлющий и огромный круг друзей, включая облачных провайдеров, операторов, брокеров и национальные платформы, такие как Национальная платформа суперкомпьютерного интернета. Поскольку DeepSeek-R1 является полностью открытой моделью, все подключенные провайдеры услуг стали бенефициарами модели DS. Это, с одной стороны, значительно повысило известность DS, но одновременно вызвало более частые явления задержек. Провайдеры услуг и сама DS все больше被困于 наплывом пользователей, и ни те, ни другие не нашли ключевой трюк для решения проблемы стабильного использования.
Учитывая, что оригинальные версии двух моделей DeepSeek V3 и R1 имеют до 671 миллиарда параметров и подходят для запуска в облаке, сами облачные провайдеры обладают более достаточными вычислительными мощностями и способностями вывода. Они запустили услуги развертывания, связанные с DeepSeek, чтобы снизить порог использования для предприятий. После развертывания модели DeepSeek они предоставляют API модели DS对外. По сравнению с API, предоставляемым самой DS, считалось, что это может обеспечить лучший опыт использования, чем официальный DS.
Но в реальности проблемы опыта работы самой модели DeepSeek-R1 не были решены ни в одном из сервисов. Внешний мир считает, что провайдерам услуг не хватает карт, но на самом деле они развернули R1. Разработчики часто反馈 о нестабильности опыта реакции, частота完全 сопоставима с R1. Это больше связано с тем, что количество карт, которое может быть выделено для вывода R1, также не слишком велико.
«Популярность R1 остается на высоком уровне. Провайдеры услуг должны учитывать другие подключенные модели. Карт, которые можно предоставить для R1, очень мало. Популярность R1 высока. Кто бы ни запустил R1 и предоставил ее по относительно низкой цене, будет сметен». Гуй Цзан, дизайнер продуктов моделей и независимый разработчик, объяснил причину Гуйсинжэню.
Оптимизация развертывания моделей — это широкая область, охватывающая множество этапов. От завершения обучения до фактического развертывания на оборудовании задействована работа на многих уровнях. Но для инцидента с задержками DeepSeek причина может быть проще, например, слишком большая модель и недостаточная подготовка к оптимизации перед запуском.
Перед запуском популярной большой модели возникают технические, инженерные, бизнес-вызовы и вызовы со стороны многих сторон. Например, согласованность данных обучения и данных производственной среды, влияние задержки данных и实时性 на эффект вывода модели, эффективность онлайн-вывода и чрезмерное占用 ресурсов, недостаточная способность обобщения модели, а также инженерные аспекты, такие как стабильность сервиса, интеграция API и системы.
Многие популярные большие модели перед запуском уделяют большое внимание оптимизации вывода. Это связано с проблемами времени вычислений и памяти. Первое относится к слишком большой задержке вывода, что приводит к плохому пользовательскому опыту и даже неспособности удовлетворить требования по задержке, то есть явлениям задержек. Второе относится к большому количеству параметров модели, что потребляет видеопамять, и даже одна карта GPU не может ее вместить, что также приводит к задержкам.
Вэнь Тинцань объяснил причину Гуйсинжэню. Он сказал, что провайдеры услуг сталкиваются с вызовами при предоставлении услуг R1. По сути, структура модели DS特殊, модель слишком большая + архитектура MoE (Mixture of Experts, эффективный способ вычислений). «(Провайдерам) нужно время на оптимизацию, но у рыночной ажиотажа есть временное окно. Поэтому все сначала запускают, а потом оптимизируют, а не запускают после полной оптимизации».
Для стабильной работы R1 сейчас ключевым является резерв и способность оптимизации на стороне вывода. DeepSeek нужно найти способ снизить стоимость вывода, снизить количество токенов за один вывод карты.
В то же время задержки также показывают, что резерв вычислительных мощностей самой DS, вероятно, не так велик, как утверждала SemiAnalysis. Фонд High-Flyer нуждается в картах, команда обучения DeepSeek также нуждается в картах. Карт, которые можно выделить для пользователей, всегда было немного. Судя по текущей ситуации развития, в краткосрочной перспективе у DeepSeek, возможно, не будет мотивации тратить деньги на аренду сервисов, чтобы затем бесплатно предоставлять пользователям лучший опыт. Они, скорее всего, сначала прояснят бизнес-модель C-end первой волны, а затем рассмотрят вопрос аренды сервисов. Это также означает, что задержки будут продолжаться еще некоторое время.
«Им大概 нужно два шага: 1) внедрить механизм оплаты, ограничив использование модели бесплатными пользователями; 2) найти сотрудничество с провайдерами облачных услуг, используя чужие ресурсы GPU». Временное решение, предложенное разработчиком Чэнь Юньфэем, имеет широкий консенсус в отрасли.
Но на данный момент DeepSeek, кажется, не слишком спешит с этой проблемой «сервер занят». Как компания, стремящаяся к AGI, DeepSeek, кажется, не хочет слишком фокусироваться на этом наплыве пользовательского трафика. Возможно, пользователям в будущем еще долгое время придется привыкать к интерфейсу «Сервер занят».
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News