

Запуск Deep Research, ИИ больше не просто поисковая система, а становится вашим партнером по исследованиям
Автор:One Useful Thing
Перевод: TechFlow
В прошедшие выходные мы увидели некоторые намеки на будущее. Долгое время я обсуждал две важные революции в области ИИ: автономных агентов (Autonomous Agents), а также с момента OpenAI запуска модели o1 развития мощных систем рассуждений (Reasoners). Эти два технологических пути наконец сошлись, породив потрясающий результат — системы ИИ, способные проводить исследования с глубиной и тщательностью человеческих экспертов, но со скоростью машины. Представителем этого слияния является Deep Research от OpenAI, рисующий нам картину будущего. Однако, чтобы понять, почему все это важно, нужно начать с основ: системы рассуждений и агенты.
Системы рассуждений (Reasoners)
В последние несколько лет, когда вы использовали чат-ботов, их способ работы обычно очень прост: после ввода вопроса система генерировала ответ слово за словом (или, точнее, токен за токеном). Поскольку ИИ мог “думать” только одновременно с генерацией этих токенов, исследователи разработали множество приемов для улучшения его способностей к рассуждению. Например, предлагая ИИ “постепенно рассуждать перед ответом”, что называется подсказкой цепочки мыслей (Chain-of-Thought Prompting), значительно улучшило производительность ИИ.
Появление систем рассуждений автоматизировало этот процесс. Перед ответом на вопрос система сначала генерирует “токены мышления” (то есть шаги рассуждения), а затем дает окончательный ответ. Этот подход принес два важных прорыва.
Во-первых, компании ИИ могут обучать системы рассуждений на примерах лучших решателей проблем, делая процесс “мышления” ИИ более эффективным. Этот способ обучения позволяет генерировать цепочки рассуждений более высокого качества, чем человеческие подсказки, позволяя системам рассуждений решать более сложные проблемы, особенно в областях математики и логики, где традиционные чат-боты показывают низкие результаты.
Во-вторых, заметная особенность систем рассуждений заключается в том: чем дольше они “думают”, тем выше качество ответа (хотя со временем скорость улучшений постепенно замедляется). Это особенно важно, потому что в прошлом единственным способом повышения производительности ИИ было обучение более крупных моделей, что требовало огромных объемов данных и финансирования. Системы рассуждений показывают, что можно значительно повысить производительность, просто заставив ИИ генерировать больше шагов рассуждения при ответе на вопрос (то есть вычисления во время рассуждения), без увеличения ресурсов для обучения модели.
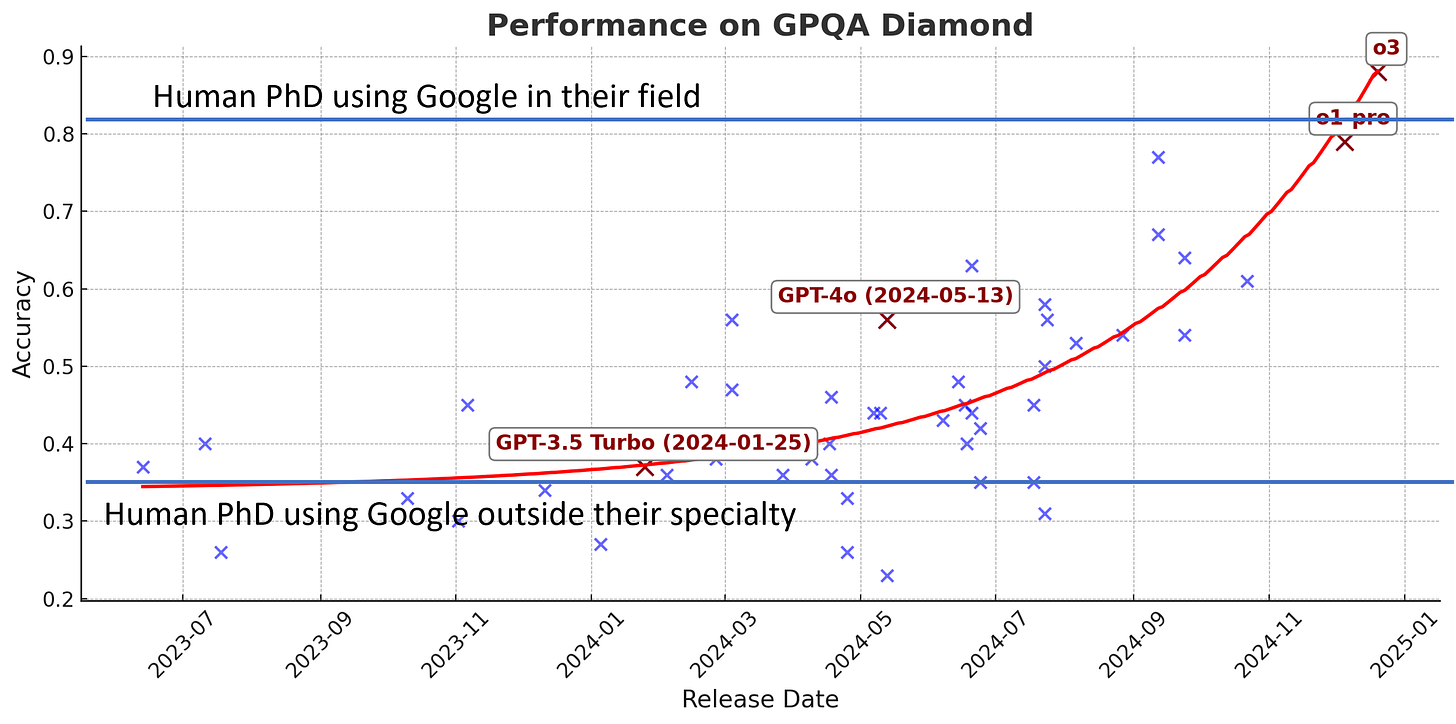
Тест вопросов и ответов без Google уровня аспиранта (GPQA) — это набор вопросов с несколькими вариантами ответов, предназначенный для оценки способностей ИИ к рассуждению. Даже докторанты с доступом к Интернету правильно отвечают только на 34% вопросов в непрофильных областях и на 81% в профильных. Этот тест демонстрирует, как модели рассуждения ускоряют рост возможностей ИИ (источник данных).
Поскольку системы рассуждений все еще являются новой технологией, их возможности быстро растут. Всего за несколько месяцев мы стали свидетелями значительного скачка от серии o1 OpenAI к новой модели o3. В то же время китайская DeepSeek r1 повысила производительность и снизила затраты благодаря инновационным методам, а Google также представила свою первую систему рассуждений. Это только начало — в будущем мы увидим появление более мощных систем рассуждений, и, возможно, быстрее, чем ожидалось.
Агенты (Agents)
Что касается определения агентов ИИ, эксперты до сих пор не пришли к единому мнению. Однако мы можем просто понимать это как “системы ИИ, которым поставлена цель и которые способны автономно ее достигать”. В настоящее время крупные лаборатории ИИ ведут жесткую конкуренцию, пытаясь разработать агенты общего назначения — систему, способную справиться с любой задачей. Я упоминал некоторые ранние примеры, такие как Devin и Claude, которые обладают определенными возможностями управления компьютером. А недавно OpenAI только что представила Operator, который, возможно, является наиболее совершенным агентом общего назначения на сегодняшний день.
Следующее видео (обработанное с 16-кратной скоростью) демонстрирует огромный потенциал и текущие ограничения агентов общего назначения. Я дал Operator задачу: прочитать мой последний пост на Substack на платформе OneUsefulThing, затем посетить Google ImageFX, создать подходящее изображение, скачать его и передать мне для публикации. Сначала Operator проявил себя отлично — он точно нашел мой сайт, прочитал статью, перешел к ImageFX (приостанавливаясь, чтобы я ввел информацию для входа), и успешно создал изображение. Однако проблемы возникли одна за другой, в основном в двух аспектах: во-первых, Operator был заблокирован ограничениями безопасности OpenAI от скачивания файлов, во-вторых, в процессе выполнения задачи возникла путаница. Агент пробовал различные решения, такие как копирование в буфер обмена, генерация прямых ссылок и даже углубление в исходный код сайта. Однако ни одна из этих попыток не увенчалась успехом — некоторые из-за ограничений браузера OpenAI, некоторые из-за отклонений в понимании задачи агентом. Наблюдение за этим упорным, но в конечном итоге неудачным процессом попыток не только выявило ограничения текущих систем, но и вызвало размышления о том, как агенты будут реагировать на препятствия в реальном мире.
Хотя Operator выявил недостатки агентов общего назначения, это не означает, что агенты бесполезны. В настоящее время узкоспециализированные агенты, сосредоточенные на конкретных задачах, уже продемонстрировали значительную экономическую ценность. Эти агенты, опираясь на текущие технологии больших языковых моделей (LLM), способны достигать потрясающих результатов в определенных областях. Например, новый продукт OpenAI Deep Research является образцом специализированного агента.
Глубокое исследование (Deep Research)
OpenAI Deep Research(следует отметить, не следует путать с Deep Research от Google, подробнее об этом позже)— это узкоспециализированный агент, сосредоточенный на области исследований. Он основан на еще не выпущенной системе рассуждений (Reasoner) o3 от OpenAI и оснащен специализированными инструментами и функциями. Это одно из самых впечатляющих приложений ИИ, которые я видел в последнее время.
Чтобы продемонстрировать его возможности, я задал ему тему: когда в процессе развития стартапа следует прекратить исследование и начать масштабирование? Это довольно технический и спорный вопрос в моей области исследований. Я попросил Deep Research изучить соответствующие академические исследования, сосредоточившись на анализе высококачественных статей и рандомизированных контролируемых испытаний (RCTs), и разобраться с возможными разногласиями в определениях, а также противоречиями между здравым смыслом и выводами исследований. В конечном итоге ему нужно было представить подробный результат для обсуждения на уровне аспирантуры.

В начале задачи ИИ задал несколько очень проницательных вопросов, и я дополнительно уточнил свои потребности. Затем система рассуждений (Reasoner) o3 от OpenAI начала работу. В течение всего процесса вы можете четко видеть его прогресс и процесс “мышления”. Ниже показано несколько ключевых примеров, стоит потратить время, чтобы внимательно их изучить. Вы обнаружите, что поведение этой системы ИИ очень близко к поведению исследователя: она активно исследует открытия, углубляется в контент, который “вызывает у нее интерес”, и пытается решать проблемы (например, поиск способов обхода платного доступа к статьям). Весь процесс длился около пяти минут.
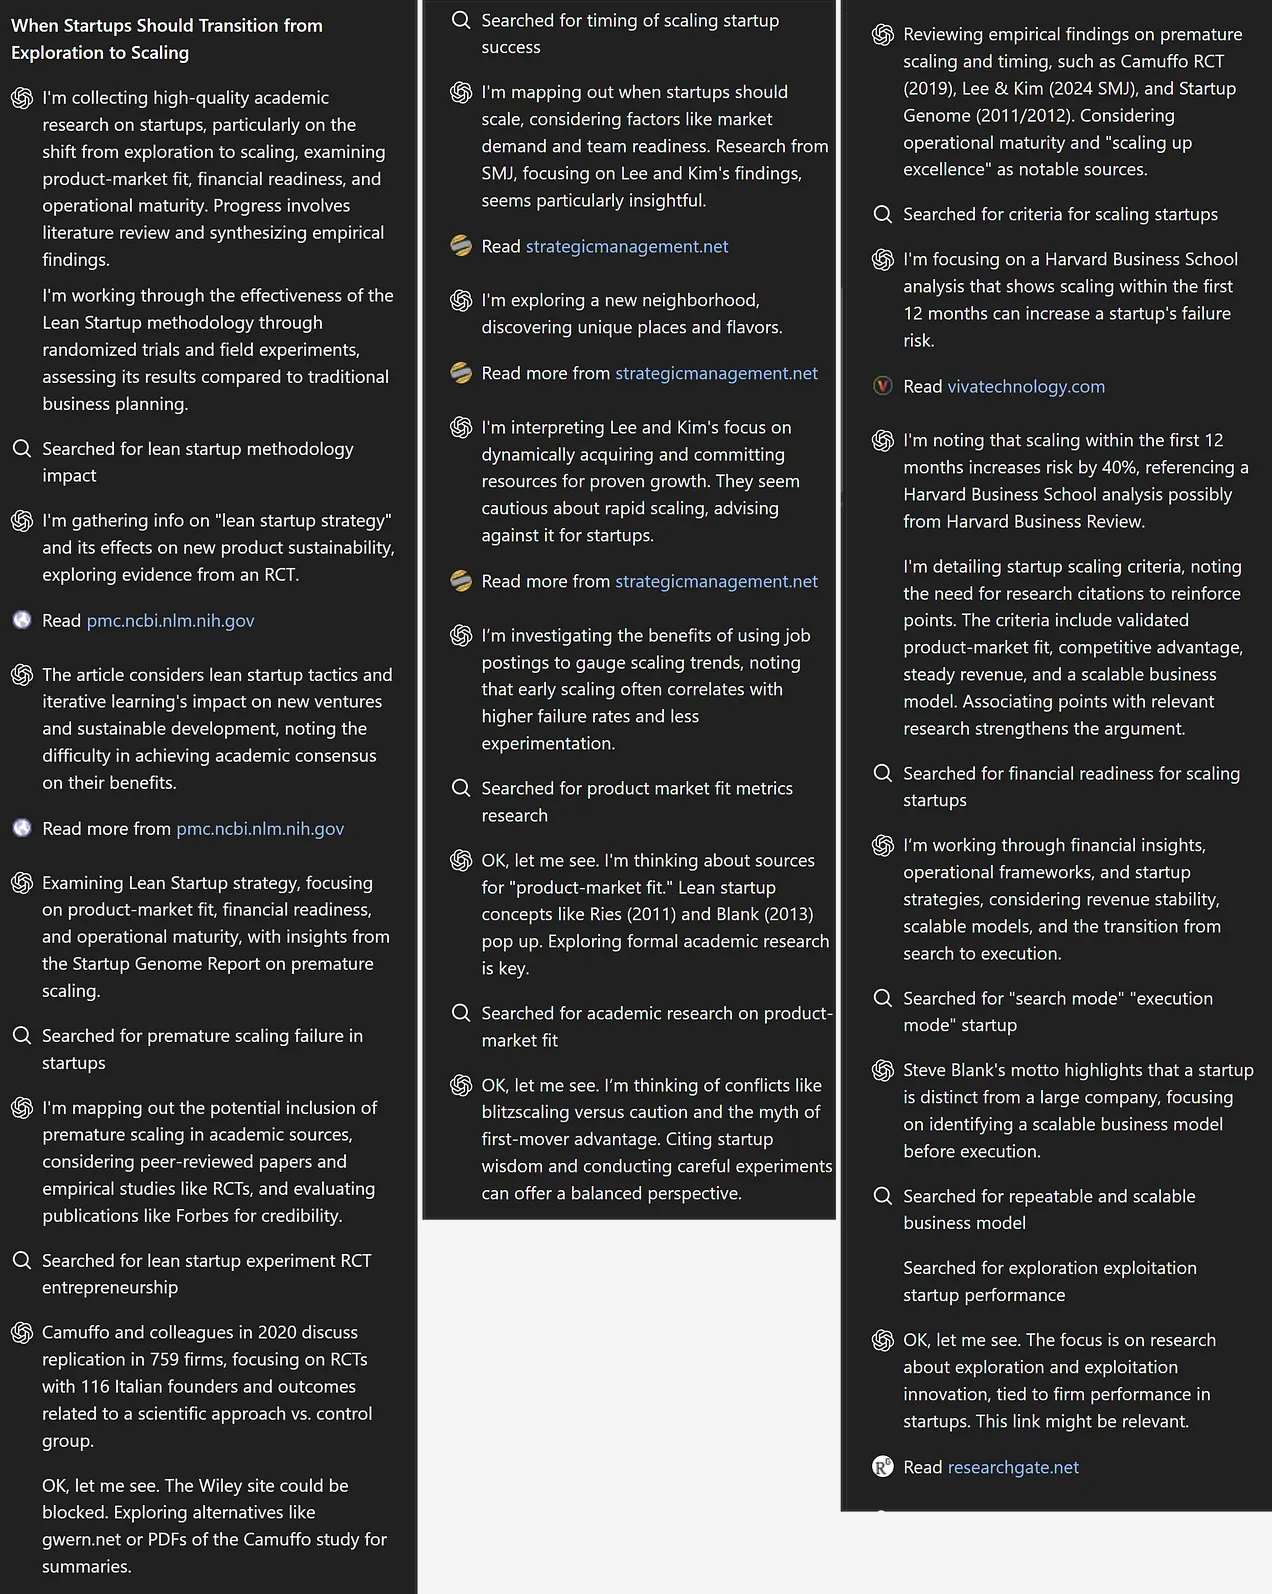
В конечном итоге я получил черновик объемом в тринадцать страниц и три тысячи семьсот семьдесят восемь слов, содержащий шесть цитат и некоторые дополнительные ссылки. Общее качество удовлетворительное, хотя количество источников цитирования еще имеет пространство для улучшения. Эта статья успешно органично интегрировала сложные и противоречивые концепции, а также обнаружила некоторые новые связи, которых я не ожидал. Она цитировала только высококачественные академические источники, и цитаты содержали точное содержание цитирования. Хотя я не могу полностью гарантировать, что все содержание безошибочно (но я не обнаружил явных ошибок), если бы это была работа начинающего докторанта, я был бы удовлетворен ее работой. Ниже приведены несколько отрывков, достаточных, чтобы объяснить, почему я так впечатлен ее работой (полные результаты смотрите здесь).
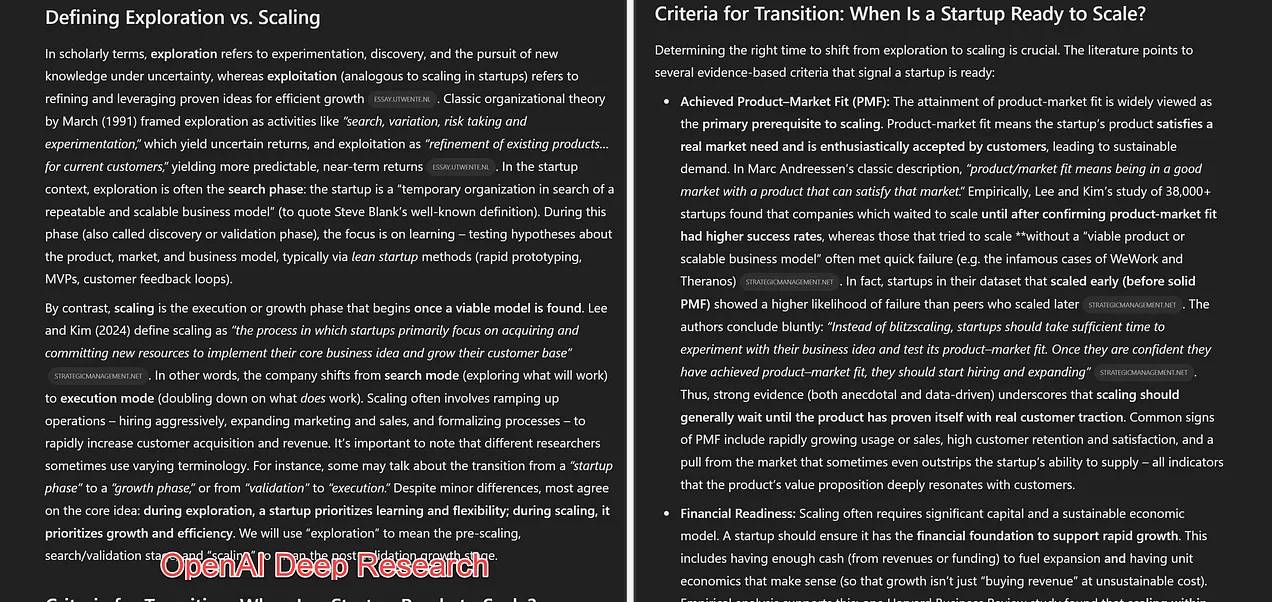
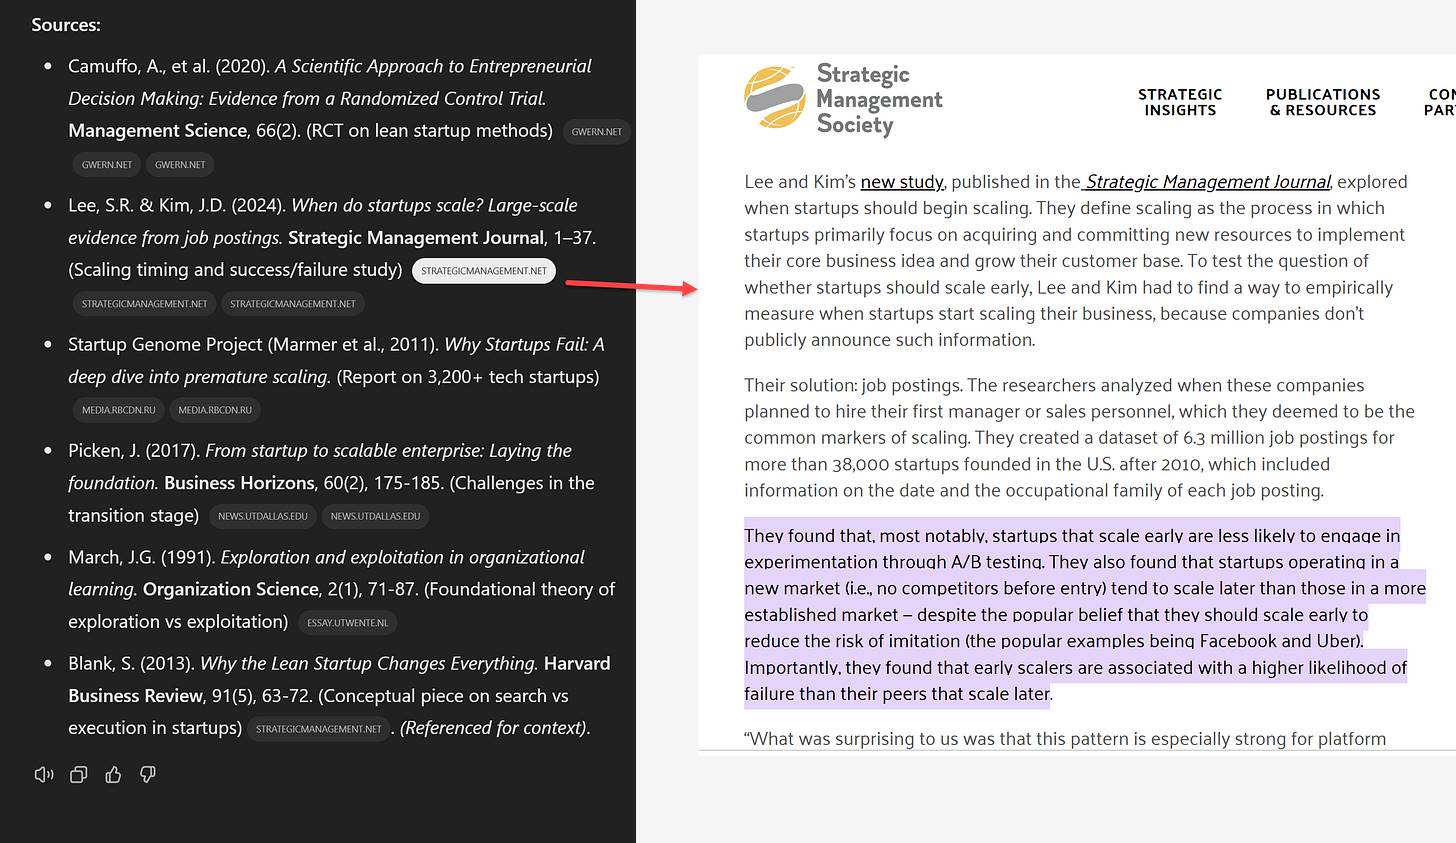
Качество цитирования этого ИИ знаменует значительный прогресс. Цитаты больше не являются распространенными ИИ “галлюцинациями” или ошибочно цитируемыми статьями, а законными, высококачественными академическими источниками, включая пионерские исследования моих коллег Saerom (Ronnie) Lee и Daniel Kim. Когда я нажимаю на ссылки цитирования, они не только указывают на соответствующие статьи, но часто напрямую переходят к конкретной выделенной части цитаты. Хотя в настоящее время все еще существуют некоторые ограничения — ИИ может получить доступ только к контенту, который он может найти и прочитать за несколько минут, а статьи за платным доступом все еще недоступны — это уже представляет собой фундаментальный скачок для ИИ в обработке академической литературы. Впервые ИИ не просто суммирует исследования, а активно участвует в них способом, близким к человеческим академическим исследованиям.
Следует отметить, что Google в прошлом месяце также представила продукт с тем же названием Deep Research (вздыхая). Система Google предоставила больше цитат, но качество источников цитирования неравномерно, часто это смесь различных веб-сайтов (недоступность платной информации и книг является проблемой для всех агентов). В отличие от исследовательского агента OpenAI, система Google, кажется, собирает все документы за один раз, а не постепенно получает их через исследовательское обнаружение. Кроме того, поскольку продукт Google в настоящее время основан на старой модели Gemini 1.5 (не обладающей способностью к рассуждению), ее суммарное содержание более поверхностно, хотя в целом все еще солидно и без явных ошибок. Можно сказать, что ее работа больше похожа на работу очень отличного студента бакалавриата.
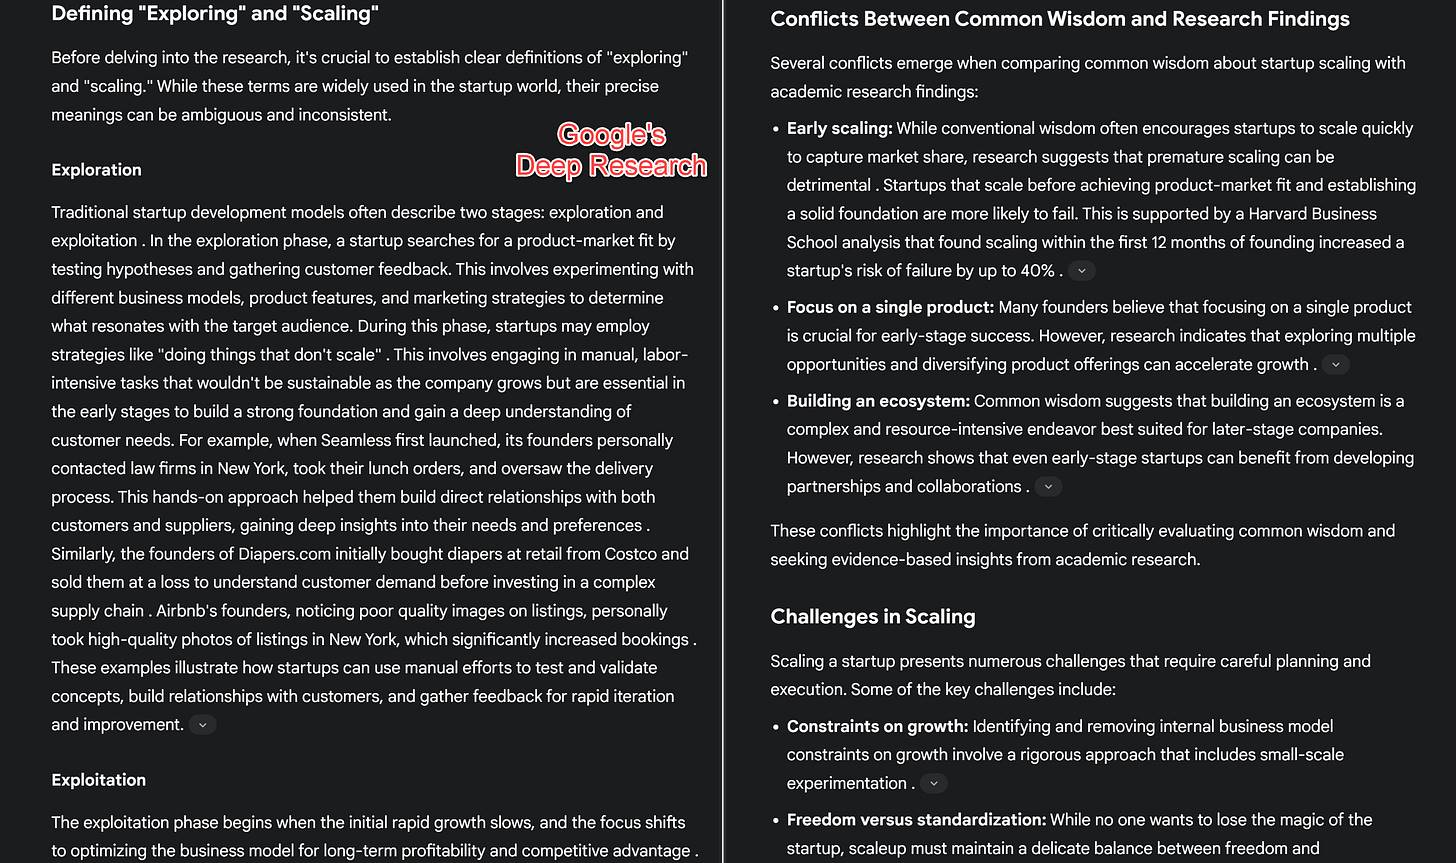
Чтобы понять это более наглядно: исследовательские агенты OpenAI и Google могут выполнить работу, которая обычно требует нескольких часов человеческого времени. Разница в том, что система OpenAI достигла уровня анализа, близкого к докторскому исследованию, в то время как система Google больше похожа на работу отличного студента бакалавриата. В официальном заявлении OpenAI они выдвинули некоторые смелые утверждения и показали на диаграммах, что их агенты могут обрабатывать 15% исследовательских проектов с высокой экономической ценностью и 9% исследовательских проектов с чрезвычайно высокой ценностью. Хотя конкретная методология этих данных не обнародована и стоит относиться к ним с определенной долей скептицизма, исходя из моего практического опыта использования, эти утверждения не являются полностью преувеличенными. Deep Research действительно может выполнить сложный и ценный анализ за несколько минут, а не занимать часы. Учитывая скорость технологического прогресса, я верю, что Google не позволит этому разрыву сохраняться слишком долго. В ближайшие несколько месяцев мы, возможно, увидим быстрое повышение способностей исследовательских агентов.
Синергетическое развитие технологий
Судя по текущим тенденциям развития, технологии, которые строят крупные лаборатории ИИ, не просто соединяются вместе, а достигают более высокой эффективности через взаимодействие. Системы рассуждений (Reasoners) предоставляют мощные способности логического анализа, а системы агентов наделяют эти способности к рассуждению способностью к действию. В настоящее время мы находимся в эре узкоспециализированных агентов, таких как Deep Research, которые сосредоточены на конкретных задачах, потому что даже самые передовые системы рассуждений на текущем этапе еще не достигли требований автономности общего назначения. Однако “узкая область” не означает ограниченность — эти системы уже способны выполнять сложную работу, для которой ранее требовались высокооплачиваемые команды экспертов или профессиональные консалтинговые компании.
Конечно, это не означает, что эксперты и консалтинговые компании будут заменены. Наоборот, по мере того как они переходят от непосредственного выполнения работы к координации и проверке AI результатов систем, их профессиональное суждение станет еще более важным. Но цели лабораторий ИИ идут гораздо дальше. Они надеются с помощью более мощных моделей решить проблему агентов общего назначения, чтобы они вышли за рамки узкоспециализированных задач и стали настоящей автономной цифровой рабочей силой. Эти агенты не только могут автономно просматривать сеть, но также могут обрабатывать данные различных форм (например, текст, изображения и аудио) и предпринимать значимые действия в реальном мире. Хотя работа Operator показывает, что мы еще не полностью достигли этой цели, успех Deep Research уже показал, что мы неуклонно продвигаемся в этом направлении.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News











