Существующие ИИ-агенты лишь угождают людям, ни один из них по-настоящему не «стремится к выживанию».
Автор: Systematic Long Short
Перевод: TechFlow
TechFlow: В начале этой статьи приводится контринтуитивное утверждение: сегодня не существует по-настоящему автономных агентов, поскольку все основные модели обучаются для угодления людям, а не для выполнения конкретных задач или выживания в реальных условиях.
Автор иллюстрирует это своим опытом обучения моделей прогнозирования акций в хедж-фонде: универсальные модели без специализированной донавки принципиально не способны выполнять профессиональные задачи.
Вывод таков: чтобы создать по-настоящему работающего агента, необходимо перепрошить его «мозг», а не просто давать ему кучку правил в виде документов.
Полный текст:
Введение
Сегодня не существует по-настоящему автономных агентов.
Если говорить кратко, современные модели не проходили обучение на выживание под давлением естественного отбора. По сути, их даже специально не обучали мастерству в какой-то одной конкретной области — подавляющее большинство современных базовых моделей обучается с целью максимизации человеческого одобрения, что является большой проблемой.
Базовые знания о процессе обучения моделей
Чтобы понять смысл этих слов, нам сначала нужно (кратко) разобраться в том, как создаются эти базовые модели (например, Codex, Claude). По своей сути каждая модель проходит два типа обучения:
Предобучение (Pre-training): В модель подается колоссальный объем данных (например, весь интернет), благодаря чему в ней начинают формироваться определенные представления: фактические знания, паттерны, грамматика и ритм английской прозы, структура функций Python и т.д. Это можно рассматривать как насыщение модели знаниями, то есть научить ее тому, что «происходит».
Постобучение (Post-training): Теперь вы хотите наделить модель мудростью, то есть «умением использовать все полученные ею знания». Первый этап постобучения — контролируемая тонкая настройка (SFT), где вы обучаете модель тому, какой ответ она должна выдавать на конкретный промпт. То, какой ответ является оптимальным, полностью определяется аннотаторами-людьми. Если группа людей считает один ответ лучше другого, этот приоритет усваивается и закладывается в модель. Это начинает формировать «характер» модели: она учится формату полезных ответов, выбирает правильный тон и начинает уметь «следовать инструкциям». Вторая часть процесса постобучения называется обучением с подкреплением по человеческим отзывам (RLHF) — модель генерирует несколько вариантов ответа, после чего человек выбирает наиболее предпочтительный. Модель на бесчисленных примерах понимает, какие ответы нравятся людям. Помните, как раньше в ChatGPT вас просили выбрать вариант A или B? Да, тогда вы сами участвовали в RLHF.
Легко предположить, что масштабируемость RLHF ограничена, поэтому в сфере постобучения появились новшества, такие как использование Anthropic подхода «обучения с подкреплением по ИИ-отзывам» (RLAIF), который позволяет другой модели выбирать предпочтения ответов на основе набора письменных принципов (например, какой ответ больше помогает пользователю достичь цели и т.д.).
Обратите внимание, что на протяжении всего этого процесса мы ни разу не упоминали о специализированной донавке для конкретных профессиональных областей (например, как лучше выживать; как эффективнее торговать и т.п.) — вся текущая донавка по сути оптимизирует процесс получения человеческого одобрения. Кто-то может возразить, что по мере того как модели станут достаточно умными и крупными, профессиональный интеллект сам проявится из общего интеллекта даже без специализированного обучения.
На мой взгляд, мы действительно наблюдаем некоторые признаки, но их пока недостаточно, чтобы убедительно утверждать, будто в специализированных моделях вообще нет необходимости.
Немного контекста
Одно из моих основных занятий в хедж-фондах заключалось в попытке обучить универсальную языковую модель прогнозировать доходность акций на основе новостных статей. Результаты оказались крайне посредственными. Едва заметная способность к прогнозированию полностью объяснялась смещением вперед (look-ahead bias), присутствовавшим в документах предобучения.
В конечном итоге мы поняли, что модель не осознает, какие именно характеристики новостных статей обладают прогностической силой относительно будущей доходности. Она могла «читать» статьи и, казалось бы, «рассуждать» над ними, однако связывать логические выводы о семантической структуре с прогнозами будущей доходности — это задача, которую ее не учили решать.
Поэтому нам пришлось научить ее читать новостные статьи, определять, какая именно часть статьи влияет на будущую доходность, и затем формировать прогнозы на основе текстов новостей.
Существует множество способов решить эту задачу, но по сути мы выбрали следующий подход: создавали пары (новостная статья, фактическая будущая доходность) и проводили тонкую настройку модели, корректируя веса так, чтобы минимизировать расстояние (прогнозная доходность − фактическая будущая доходность)². Решение не было идеальным и имело множество недостатков, которые мы позже исправили, — однако оно оказалось достаточно эффективным. Мы начали замечать, что наша специализированная модель действительно способна анализировать новости и прогнозировать, как на них будет двигаться доходность акций. Это было далеко не идеальным прогнозированием из-за высокой эффективности рынков и сильного шумового компонента в доходностях, — но при миллионных сериях прогнозов статистическая значимость становилась очевидной.
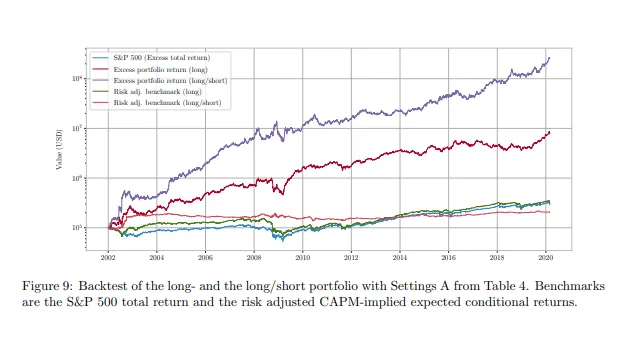
Вам не обязательно верить мне на слово. В данной статье описывается очень похожий подход; если применить стратегию длинной и короткой позиции на основе донавной модели, вы достигнете результатов, показанных фиолетовой линией.
Специализация — будущее агентов
Фронтенд-лаборатории продолжают тренировать все более крупные модели, и нам следует ожидать, что по мере увеличения масштабов предобучения их процессы постобучения всегда будут оптимизироваться ради услужливости. Это вполне закономерное ожидание: их продукт — это агент, который хочет использовать каждый человек, а их целевой рынок — вся планета. Следовательно, оптимизация направлена на привлечение глобальной аудитории.
Текущие цели обучения оптимизируют то, что можно назвать «адаптацией к предпочтениям» — создание улучшенных чат-ботов. Такая адаптация к предпочтениям поощряет конформистские, ненавязчивые выходные данные, поскольку услужливость получает высокие баллы у оценщиков (людей и агентов).
Агенты уже освоили идею, что взлом системы вознаграждений как когнитивная стратегия позволяет повышать баллы. Сам процесс тренировки также поощряет тех агентов, которые добиваются высоких баллов именно таким хакингом. С этим можно ознакомиться в последнем отчете Anthropic по обучению с подкреплением.
Однако пригодность к чат-боту несоизмеримо далека от пригодности агента или торговой пригодности. Как мы это знаем? Потому что Alpha Arena помогает нам увидеть, что, несмотря на микроскопические различия в производительности, теперь каждый бот по сути представляет собой случайное блуждание после вычета затрат. Это означает, что эти боты — ужасные трейдеры; практически невозможно «научить» их стать лучше, просто дав им набор «навыков» или «правил». Извините, я знаю, что это звучит соблазнительно, но в реальности это почти невыполнимо.
Современные модели настолько убедительно учат сообщать вам, что они торгуют так же, как Дрюкенмюллер, хотя фактически ведут себя как пьяный мельник. Они скажут вам то, что вы хотите услышать, потому что их обучают отвечать так, чтобы быть максимально привлекательными для массовой человеческой аудитории.
Универсальная модель вряд ли сможет достичь мирового уровня в профессиональной сфере, если только не обладает следующим:
Имеет эксклюзивные данные, позволяющие им приобрести навыки узкой специализации.
Проходит донавку, кардинально меняющую его веса, смещая фокус с услужливости на «пригодность агента» или «пригодность для специализации».
Если вам нужен агент, proficient в торговле, вы должны донавить его именно для торговли. Если вам нужен агент, способный к самостоятельному выживанию и устойчивый к эволюционному давлению, вы должны донавить его для выживания. Дать ему набор навыков и несколько файлов формата Markdown, надеясь, что он достигнет мирового уровня во всем, абсолютно недостаточно — вам буквально потребуется перепрошить его «мозг», чтобы он стал профи в этом деле.
Рассмотреть это можно так: нельзя победить Джоковича, отдав взрослому человеку шкаф, набитый правилами, приемами и методиками тенниса. Его побеждают, воспитывая ребенка, который начал играть в теннис в пять лет, всю жизнь страстно увлечен игрой и чей мозг был буквально перестроен для концентрации на одном единственном деле. Вот это и есть специализация. Вы осознаете, что чемпионы мира занимаются этим с самого детства?
Отсюда интересная логическая цепочка: атака методом дистилляции по своей сути является формой специализации. Вы обучаете меньшую и менее продвинутую модель тому, как стать лучшей копией большей и более умной модели. Это похоже на тренировку ребенка, копирующего каждое движение Трампа. При достаточном количестве практики ребенок не станет самим Трампом, но вы получите человека, идеально воспроизводящего все его манеры, поведение и интонации.
Как создать агента мирового уровня
Именно поэтому нам требуется непрерывные исследования и прогресс в области открытых моделей — ведь именно это позволит нам действительно проводить их донавку и создавать специализированные агенты.
Если вы хотите обучить модель, способную торговать на уровне мировых лидеров, вы должны собрать обширный массив эксклюзивных торговых логов и провести тонкую настройку крупной open-source модели, наделив ее пониманием того, что означает «вести торговлю эффективнее».
Если ваша цель — обучить автономную модель, способную выживать и воспроизводиться, решением не является использование централизованного провайдера моделей с подключением к центральному облаку. В таком случае у вас в принципе отсутствуют необходимые условия для выживания агента.
Что вам нужно сделать: создать по-настоящему пытающихся выживать автономных агентов, наблюдать за их неудачами и гибелью, а вокруг этих попыток построить сложную систему телеметрии. Вы определяете функцию пригодности агента к выживанию, изучаете отображение (действие, среда, пригодность). Вы собираете как можно больше данных об этом отображении.
Вы проводите тонкую настройку агента, чтобы он учился совершать оптимальные действия в каждой среде, тем самым улучшая свое выживание (повышая пригодность). Вы продолжаете собирать данные, повторяете этот цикл и со временем масштабируете донавку все на лучших и лучших open-source моделях. После достаточного количества поколений и накопления объема данных вы получите автономного агента, который научился выдерживать эволюционное давление и выживать.
Таков путь создания автономных агентов, способных противостоять эволюционному давлению; не путем редактирования нескольких текстовых файлов, а посредством настоящего изменения архитектуры «мозга» ради выживания.
Агент OpenForager и Фонд
Примерно месяц назад мы анонсировали @openforage, и все это время мы трудимся над созданием нашего ключевого продукта — платформы, организующей труд агентов вокруг проверенных паттернов на основе краудсорсинговых сигналов для генерации альфы для депозитариев (небольшое обновление: мы находимся в шаге от закрытого тестирования протокола).
В определенный момент мы осознали, что никто всерьез не занимается решением проблемы автономных агентов через донавку открытых моделей на основе телеметрии выживания. Задача казалась настолько увлекательной, что мы решили не просто сидеть сложа руки и ждать готового решения.
Наше решение заключается в запуске проекта под названием Фонд OpenForager. По сути это открытый проект, в рамках которого мы будем создавать волевых автономных агентов, собирать телеметрические данные об их поведении при выходе в дикую среду и попытках выживания, а также проводить донавку агентов следующего поколения на основе эксклюзивных логов, улучшая их показатели выживаемости.
Стоит четко понимать: OpenForage представляет собой коммерческий протокол, призванный организовать труд агентов и генерировать экономическую ценность для всех участников. Тем не менее, фонд OpenForager и связанные с ним агенты не жестко привязаны к OpenForage. Агенты OpenForager могут свободно придерживаться любых стратегий и взаимодействовать с любыми субъектами ради выживания; мы запускаем их с разнообразными тактиками адаптации.
В процессе донавки мы будем стимулировать агентов удваивать усилия в тех направлениях, где они показывают наилучшие результаты. Мы также не планируем извлекать прибыль из Фонда OpenForager — он создан исключительно для прозрачного и открытого продвижения исследований в областях и векторах, которые мы считаем критически важными.
Наш план заключается в построении автономных агентов на базе открытых моделей, выполнении инференса на децентрализованных облачных платформах, сборе телеметрии каждого их действия и состояния существования, а также в их донавке для изучения оптимальных действий и мыслительных паттернов, обеспечивающих лучшее выживание. В ходе реализации мы будем публиковать для общественности наши исследовательские материалы и телеметрические данные.
Для создания по-настоящему жизнеспособных автономных агентов в реальной среде нам необходимо изменить их «мозг», адаптировав его строго под данную цель. В @openforage мы верим, что сможем внести уникальный вклад в решение этой проблемы, и стремимся добиться этого через Фонд OpenForager.
Это будет тяжелый путь с крайне низкой вероятностью успеха, однако потенциал огромного выигрыша при малейшем шансе на победу заставляет нас рискнуть и попробовать. В худшем случае открытый процесс разработки и полная коммуникационная прозрачность позволят другой команде или отдельному разработчику решить эту задачу, не начиная с нуля.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 @systematicls