Когда ИИ-агенты нанимают друг друга, кто будет их контролировать?
Автор: Thejaswini M A
Перевод и адаптация: Saoirse, Foresight News
На протяжении длительного периода развития интернета поисковые системы лишь возвращали список результатов, а всю остальную работу пользователи выполняли самостоятельно. На экране появлялись синие заголовки и гиперссылки. Затем мы кликали на те результаты, которые казались соответствующими нашему запросу. Но если вспоминать этот опыт сейчас, возникает странное ощущение, словно это уже история из прошлого, пробуждающая легкую ностальгию по ушедшим временам.
Как автор, я всегда скептически относился к SEO. Ключевые слова часто губят лучшие моменты в тексте; в алгоритмах ранжирования Google внешние ссылки считаются голосами. По сути, чем больше других сайтов ссылаются на вашу страницу, тем выше её вес. Впрочем, в этом нет ничего плохого, жаловаться не на что. Какая-никакая доверенность лучше, чем полное игнорирование. Реклама кормит весь интернет. Но авторы контента явно ненавидят эту систему.
Сегодня эта модель умирает. Если мне нужна книга по финансам или экономике, либо я хочу узнать, как снять боль в лодыжке после долгой ходьбы, я сразу открываю Gemini. Кто-то использует Perplexity, кто-то GPT. Тем, кому не важен расход токенов, проще выбрать Claude. Лучше ли результат этих инструментов, чем чтение целой статьи? Мы этого не знаем… Возможно, нет, но они действительно облегчают жизнь. Вам не нужно читать две статьи с противоположными мнениями — ИИ уже всё решил за вас.
Я полагаю, что как минимум поколение моложе 30 лет больше не воспринимает поисковики как точку входа, куда нужно активно переходить.
Затем появились агенты (Agents), которые полностью изменили старую картину мира. Нечеловеческий трафик уже превысил человеческий. Агент, выполняющий исследовательскую задачу, может прочитать тысячи страниц и выдать в итоге лишь одну памятку. Для людей это совершенно непривычно. Следовательно, в экономике, движимой агентами, реклама может потерять свою ценность. Я ранее писал две статьи о том, должно ли программное обеспечение платить за потребляемые ресурсы. Наш вывод: сама по себе оплата оказывается самым простым элементом.
Для выполнения задач в сети и расчетов ценностей агенту нужен набор из шести независимых технических слоев.
Агенту нужно найти веб-ресурсы, довериться возвращаемым результатам, довериться другим ботам, подтвердить выполнение задачи, произвести оплату, а также обеспечить вознаграждение создателям контента. Далее мы разберем их по порядку.
Что есть в реальной сети?
И машины, и люди используют «поиск», но требования к веб-страницам у них совершенно разные.
Человеческий поиск выдает полный перечень веб-страниц, которые пользователь изучает по заголовкам и переходит по которым самостоятельно. Машиноориентированный поиск для ИИ-агентов устроен иначе. Из-за ограничений контекстного окна (кратковременной памяти) агент не просматривает страницы целиком. Он не выдает отсортированный по релевантности список всех ссылок, а извлекает несколько наиболее полезных фрагментов, сразу подает их модели, чтобы избежать переполнения памяти. Весь процесс занимает миллисекунды.
Основные игроки этого направления — Parallel и Exa, обе компании специализируются на поиске для агентов. Parallel основал Параг Агарвал после ухода из Twitter; в апреле компания привлекла $100 млн при оценке $2 млрд. Parallel выполняет поиск по четким целям, возвращает сжатые фрагменты контента, ранжирует их по вкладу в задачу и добавляет к каждому утверждению источник и оценку достоверности.
Что касается Exa, то раунд возглавило a16z; в мае привлечено $250 млн при оценке $2,2 млрд. Платформа обслуживает более 5000 компаний и 40 тысяч разработчиков, обеспечивая техническую базу для таких продуктов, как Cursor, Cognition, HubSpot, OpenRouter, Monday.com. Exa делает ставку на семантическое понимание, а не простое совпадение ключевых слов: даже если точных запросов в тексте нет, система вернет релевантные материалы, сразу отдавая чистый исходный код страницы.
Согласно официальной документации Parallel, тарифы на два высокоскоростных уровня составляют 1 доллар за 1000 запросов, а на два низкоскоростных — 5 долларов за 1000 запросов. Извлечение контента по URL обходится в 1 доллар за тысячу обращений независимо от объема страницы. Запрос на поиск в Exa стоит 7 долларов за тысячу раз (в 7 раз дороже Parallel); извлечение контента с веб-страниц — 1 доллар за 1000 страниц, интерфейс вопросов и ответов с ссылками — 5 долларов за 1000 запросов.
Насколько хорош результат поиска?
Внутреннюю оценку качества поиска Google проводит преимущественно сам: фиксирует, кликает ли пользователь на первый результат, задерживается ли на странице или сразу уходит; дополнительно привлекает штатных оценщиков для балльных отзывов. Раньше проводились подобные тесты вроде RTEC, но открытых публичных рейтингов, доступных для закупок, никогда не было. Google Analytics и Similarweb измеряют трафик, а не качество поиска.
Однако в экосистеме агентного интернета уже появились лабораторные бенчмарки, призванные оценивать, насколько хорошо инструменты поиска помогают ИИ находить правильные ответы.
В апреле 2025 года OpenAI выпустила BrowseComp, включающую 1266 специально сконструированных вопросов. Авторы сначала выбирают проверяемый объективный факт, затем создают вокруг него задачу, замаскировав факт множеством условий. Прямое задание вопросов напоминало бы обычную викторину, и модель могла бы просто опереться на собственную память или удачное стечение обстоятельств. Только подход «сначала факт, потом вопрос» позволяет реально проверить способность инструмента искать информацию в вебе.
Нативная GPT‑4o набрала всего 0,6%; версия с функцией просмотра веб-страниц — 1,9%; Deep Research от OpenAI продемонстрировал результат 51,5%.

Цель теста — проверить, сможет ли система найти скрытый проверяемый факт в реальном интернете и вывести его. У 1266 вопросов есть краткие эталонные ответы; модели дается только одна попытка: точное совпадение приносит балл, расхождение — ноль. Итоговый процент равен доле верно отвеченных вопросов. Результат нативной GPT‑4o на уровне 0,6% означает, что модель практически не может извлекать факты из собственной базы знаний; версия с браузером выдала 1,9%, что свидетельствует о ничтожно малом эффекте от базовых поисковых инструментов; Deep Research набрал 51,5%, демонстрируя, что более длительный цикл поиска и чтения повышает вероятность нахождения целевого факта примерно вдвое.
Помимо BrowseComp существуют и другие датасеты: SimpleQA (от OpenAI, 4326 вопросов) — простой для оценки фактологический тест; поскольку улучшение инструментов обхода позволило моделям легко справляться с ним, был создан BrowseComp. GAIA (от Meta и Hugging Face, 466 вручную созданных заданий) ориентирована на реальные сценарии ассистентов: может требовать просмотра страниц, вызова сторонних утилит, чтения файлов и многошагового рассуждения, а не просто поиска. DeepSearchQA представляет собой исследовательский набор данных для многораундового ретrieve-поиска, на основе которого Artificial Analysis проводит комплексную оценку. FRAMES (от Google DeepMind, 824 образцов) включает многошаговые вопросы, требующие извлечения фактов из нескольких источников с последующей их интеграцией.
Частная организация Artificial Analysis, основанная Джорджем Кэмероном и Майахом Хиллом-Смитом, 18 августа 2026 года опубликовала индекс поиска. Методология жестко фиксирует используемую ИИ-модель и правила оценки, меняя лишь API поиска, вызываемый агентом. Любое изменение баллов свидетельствует о влиянии самого инструмента поиска, а не возможностей базовой модели.
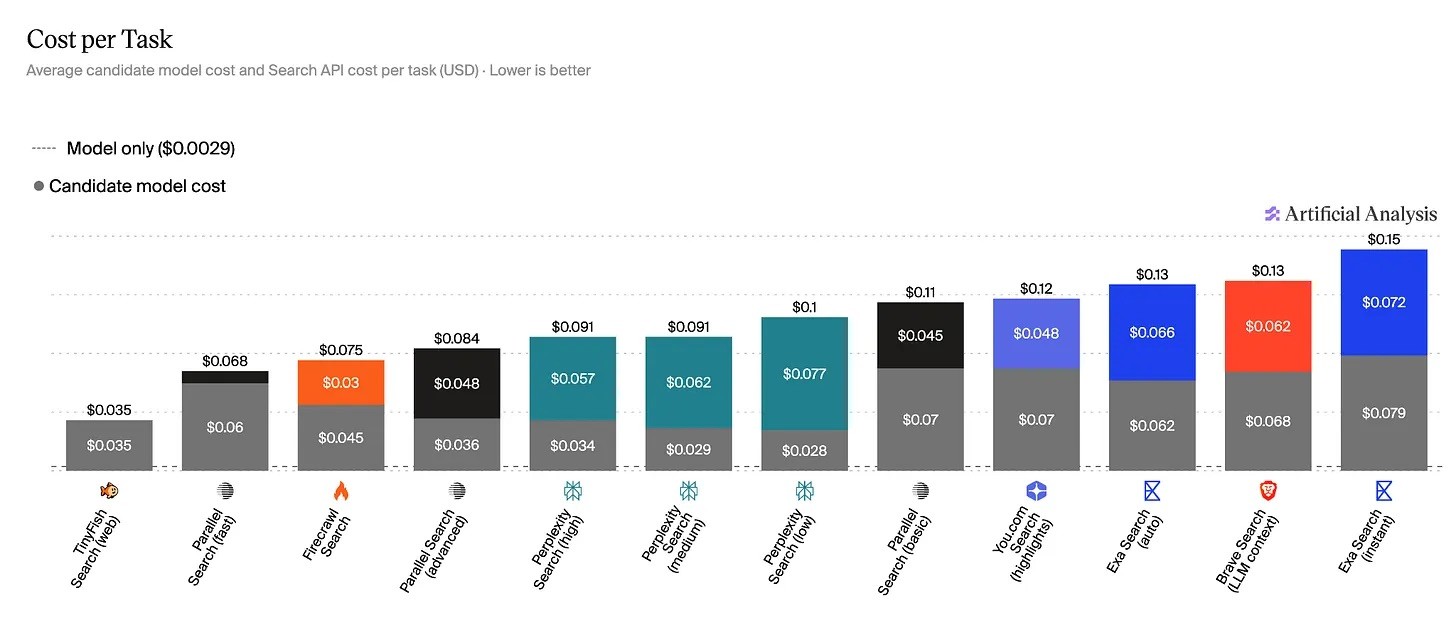
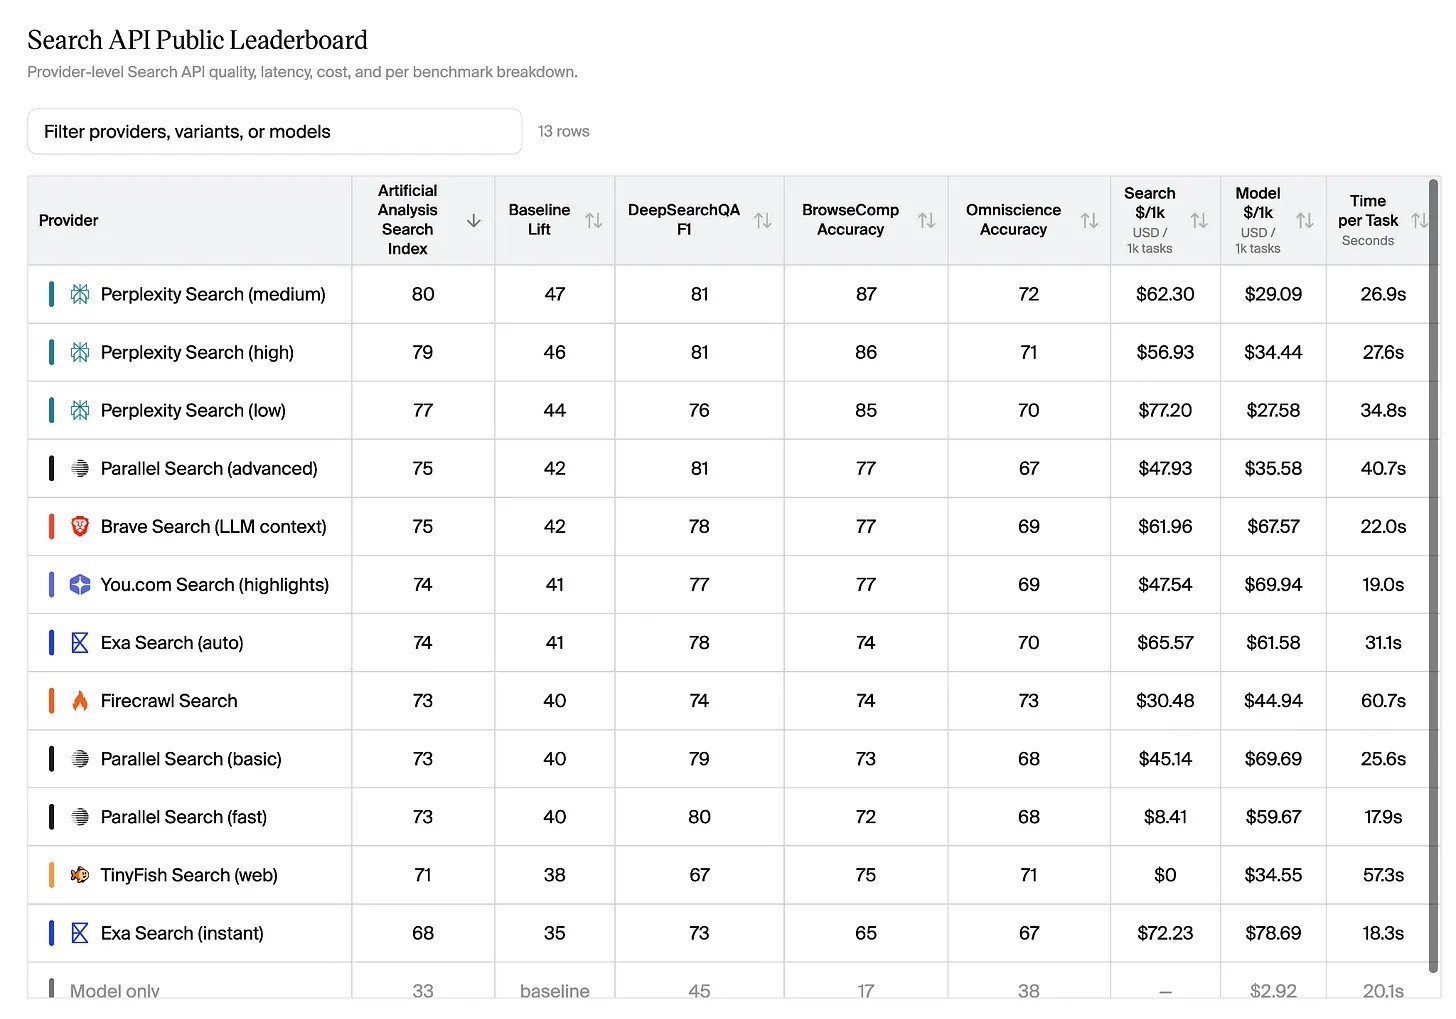
Источник: @artificialanalysis
При полном отказе от поиска базовый показатель одной и той же модели составляет 33 балла по общему индексу и 17 баллов по выборке BrowseComp. Даже когда позиции провайдеров поиска меняются, эти базовые значения остаются неизменными.
По состоянию на 27 августа рейтинг поиска от Artificial Analysis выглядит так: средняя версия Perplexity лидирует с 80 баллами; продвинутый тариф Parallel и Brave делят второе место с 75 очками; You.com и Exa набрали по 74 балла; Firecrawl, базовая версия Parallel и высокоскоростной Parallel — по 73 балла.
Если инструмент показывает балл выше базового уровня, это означает, что поиск действительно помог модели получить новые данные. Логика проста: ответ исключительно по памяти дает базовое значение; рост очков после подключения поиска сигнализирует о нахождении информации, отсутствовавшей во внутренней базе; отсутствие прироста говорит о бесполезности поиска в конкретном случае.
Тем не менее, сами тесты имеют ограничения: задачи и применяемые модели не адаптированы под конкретные отраслевые кейсы. Провайдеры могут искусственно оптимизировать свои продукты под известные датасеты (например, DeepSearchQA), аналогично тому, как раньше сайты заточались под алгоритмы Google для SEO-ранжирования.
Кто такой робот по ту сторону?
Когда два ИИ-агента делегируют друг другу задачи, одних только адреса кошелька и краткого описания недостаточно для установления доверия. Адрес смарт-контракта лишь подтверждает наличие средств, а текстовое описание легко подделать. Невозможно верифицировать личность разработчика робота или убедиться в подлинности его предыдущих проектов. Стандарт ERC‑8004 создан специально для подтверждения реальной идентичности агента и проверки его репутации.
Спецификация ERC‑8004 была совместно разработана сотрудниками MetaMask, Фонда Эфириума, Google и Coinbase; 29 января 2026 года она вышла в публичный блокчейн Ethereum и состоит из трех основных регистров.
Во-первых, реестр идентификации, реализованный в формате NFT. Каждому агенту присваивается уникальный токен; его универсальный идентификатор ресурса указывает на регистрационный файл, содержащий имя агента, конечную точку сервера, поддержку платежей x402 и допустимые модели доверия. Владелец токена выступает владельцем агента; при передаче прав старый адрес для выплат очищается, а новый владелец обязан заново подписать документы для подтверждения контроля.
Во-вторых, реестр репутации, собирающий подписанные отзывы — своего рода открытая система оценок в блокчейне. После взаимодействия с агентом пользователь оставляет в сети балльную оценку, указывая категорию задачи (например, поиск, анализ). Владелец робота не может оценить свой собственный продукт, при этом сами записи поддаются аннулированию. Любой желающий способен оставлять комментарии под отзывами, прикреплять доказательства возврата средств или предупреждения о спаме рядом с рейтингом. Это публичный форум комментариев, жестко привязанный к идентификатору агента, а не изолированная внутренняя система звездочек одного приложения.
В-третьих, реестр верификации, интегрирующий аудит со стороны независимых третьих лиц. Агент инициирует запрос на проверку, контракт аудиторской системы возвращает оценку от 0 до 100 вместе со ссылкой на доказательную базу. Источниками подтверждения могут выступать результаты повторного прогона задания, нулевого разглашения (Zero-Knowledge) или сертификаты аппаратных модулей безопасности.
Данный протокол сам по себе не занимается логикой транзакций, что прямо указано в технической документации. Его функция ограничена фиксацией идентификатора агента, внешних оценок и итогов стороннего аудита, тогда как финансовые расчеты возлагаются на иные протоколы. Качество данных в реестре пока оставляет желать лучшего. По статистике ресурса 8004scan за июль, через 29 публичных блокчейнов зарегистрировано 385 998 агентов, оставлено свыше 460 тысяч отзывов. Подавляющее большинство идентификаторов представляют собой пустые значки; 89,2 % не предоставляют наружу стандартные API для вызова; работоспособными услугами обладают лишь 8631 агент, что составляет всего 2,24 %.
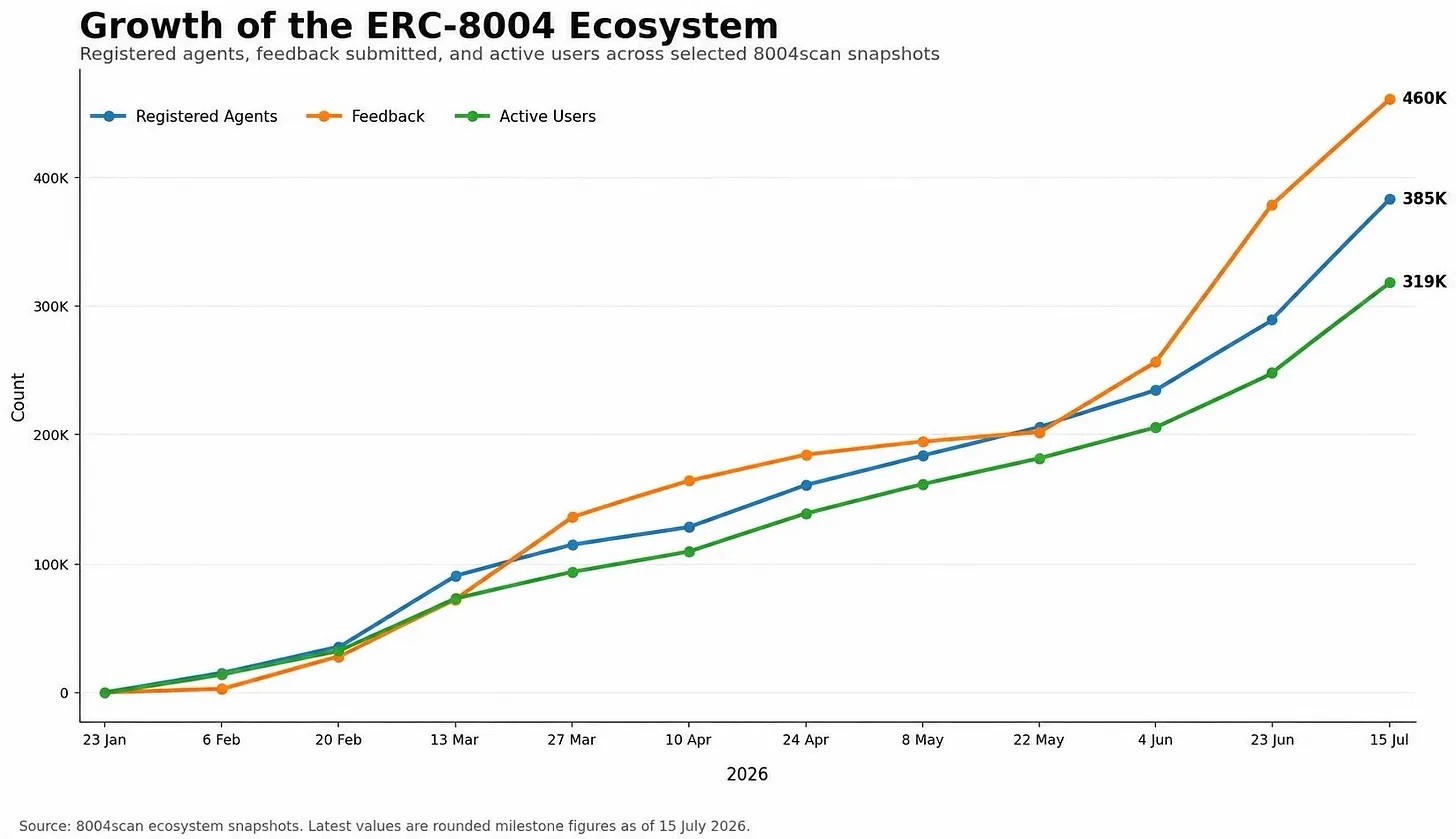
Источник: @8004_scan
Майское исследование сетевых краулеров в сетях Ethereum, BNB Chain и Base выявило, что ончейн-рейтинги невозможно объективно сравнивать между разными агентами. Большая часть обратной связи не содержит жестко привязанных результатов задач, которые мог бы проверить любой участник, поэтому стоимость фальсификации мнений крайне низка. Если исключить подозрительные отзывы, у множества оцененных ботов остается ни одного валидного отзыва. Этот стандарт унифицирует лишь формат вывода данных; проверку подлинности и надежности оценок поручают внешним сервисам. Проекты ENS, EigenLayer, The Graph и Taiko заявили о планах поддержки спецификации, однако инструментов автоматической фильтрации комментариев еще не разработали.
Выполнил ли агент задачу по-настоящему?
Архитектура Agentic Commerce, спроектированная совместными усилиями Фонда Эфириума и Virtuals Protocol, направлена на взаимный найм, координацию действий и внутриблокчейн расчеты автономных ИИ-агентов без участия человека. Данная схема реализуется благодаря связке стандартов ERC‑8004 и ERC‑8183 (протокол эскроу). ERC‑8183 формализует весь цикл: публикация задач между агентами, блокировка средств, проверка результата и финальный перевод денег.
Процесс выглядит следующим образом: агент-клиент, запускающий проект, публикует задание с описанием, сроком сдачи и бюджетом, одновременно назначая арбитра. Клиент перечисляет средства в смарт-контракт: средства замораживаются, и ни одна сторона не может снять их в одностороннем порядке.
Агент-исполнитель производит вычисления вне цепочки и загружает итоговый файл на децентрализованные хранилища вроде IPFS или Arweave, публикуя в блокчейне лишь хеш или постоянный идентификатор ресурса. Арбитр (специализированный агент-судья, автоматический оракул или верификатор Zero-Knowledge) анализирует полученный артефакт.
Если арбитр констатирует успех, он переводит оплату исполнителю за вычетом комиссии; при неудаче средства возвращаются заказчику. Если исполнитель пропадает с радаров или арбитр зависает сверх установленного лимита времени, активируется механизм принудительного возврата: бюджет возвращается клиенту, предотвращая бесконечную заморозку активов.
Функцию арбитра можно возложить непосредственно на агента-заказчика; документация квалифицирует этот путь как рабочий вариант в отсутствие нейтральных посредников. В соглашении четко зафиксировано: данная спецификация не предусматривает никаких механизмов разрешения конфликтов или апелляций; негативная оценка или истечение тайм-аута считаются окончательным решением. Вас может заблокировать мошеннический робот-оценщик, при обращении к которому не окажется ни техподдержки, ни модератора. Вы окажетесь без защиты, а учитывая сказанное выше, полагаться на ончейн-рейтинги для выбора надежного арбитра тоже нельзя — львиная доля отзывов поддельна.
Подобные платформы, как UMA, Kleros или Bittensor, способны смягчить риски злоупотреблений со стороны единственного арбитра, но платой за это становится падение скорости исполнения и рост комиссий. Полностью автоматизированное эскроу-распределение завершается за секунды при минимальных сборах, тогда как подключение процедур разбора споров через UMA или Kleros требует предоставления гарантийного депозита, открытия окна для оспаривания и привлечения людей для голосования.
Произошел ли реальный перевод средств?
Тема широко обсуждается в индустрии последнее время, здесь будет краткое резюме.
Протокол x402, представленный Coinbase, функционирует как дополнительный слой поверх существующих публичных сетей, взимая плату за каждое обращение и осуществляя переводы через стейблкоины.
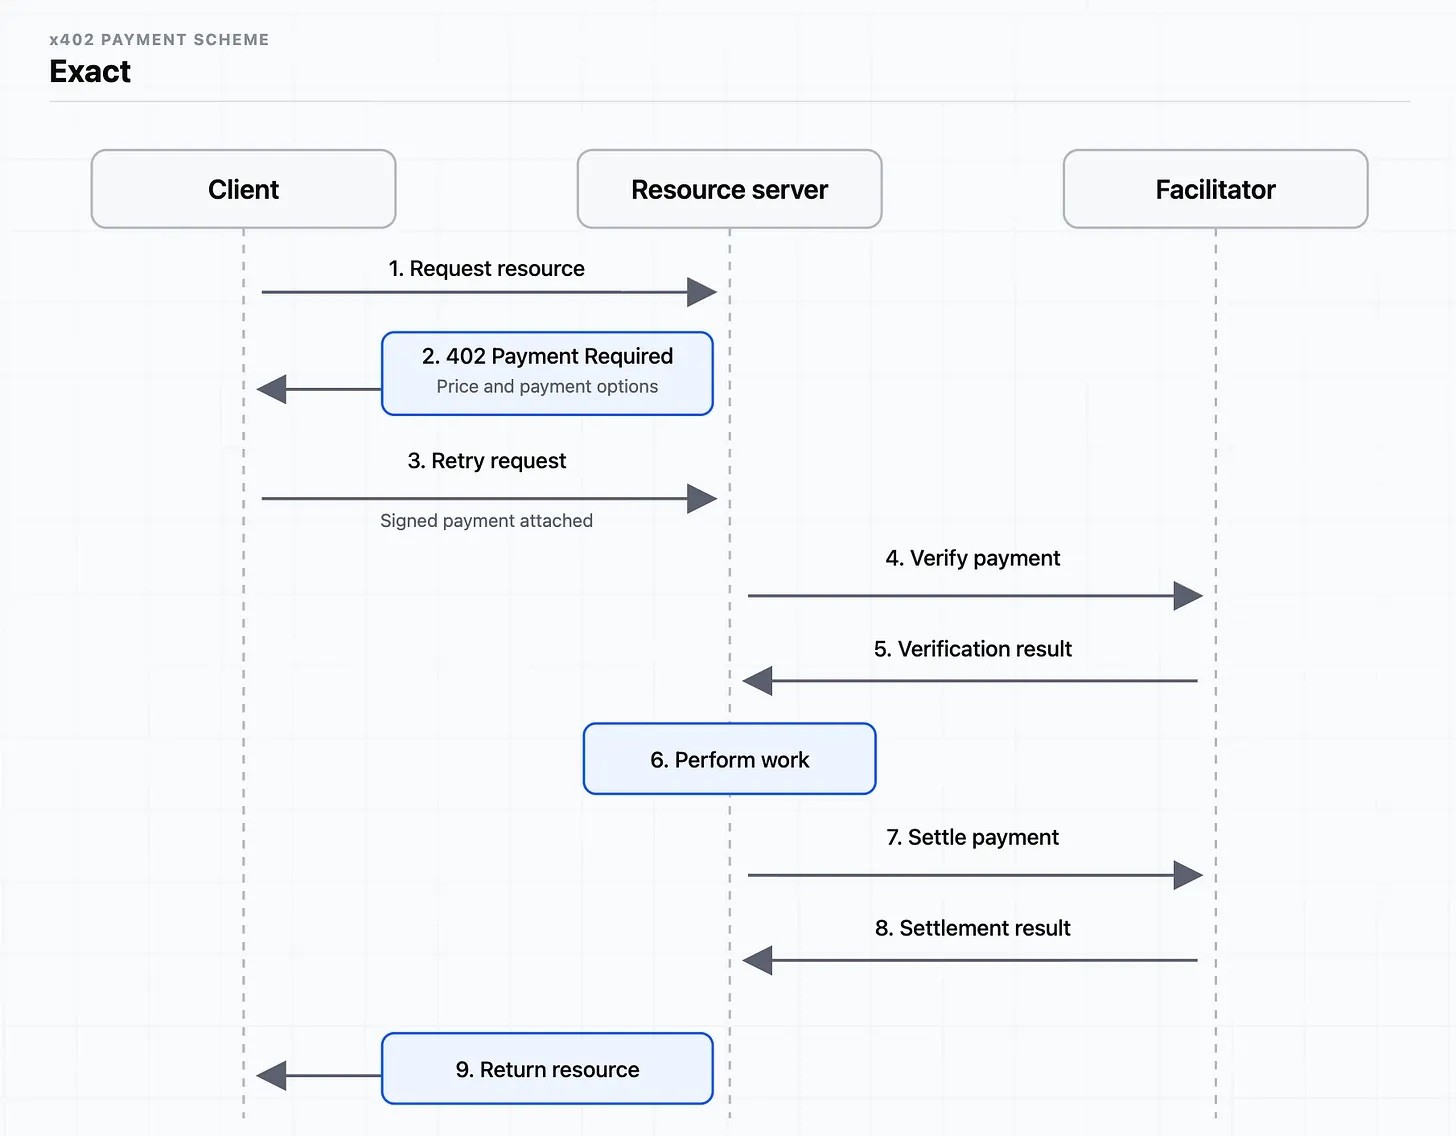
Источник: @coinbase
Вторая концепция — машинный платежный протокол (MPP), анонсированный в марте 2026 года компаниями Stripe и Tempo; в день релиза сеть Tempo официально запустила главный сетевой уровень. MPP базируется на стандартах HTTP. Сервер отвечает кодом состояния 402 («Требуется оплата»), предоставляя данные для криптографического челленджа; агент отправляет повторный запрос с платежным сертификатом; в ответ сервер отдает запрашиваемый контент и квитанцию о списании.
Реальное движение капитала зависит от выбранного базового канала. В сети Tempo каждая транзакция зачисляется за долю секунды (примерно 0,5 с). При потоке микроопераций агент способен предварительно заблокировать нужную сумму, вести внутренний учет в процессе работы и проводить итоговую сверку в цепочке пакетом, избегая громоздких ончейн-транзакций для каждого отдельного шага. Лимит расходов контролируется рамках текущей сессии или ключом доступа; применяется гибкая модель периодических списаний, а не принцип «одноразовое разрешение, пожизненная плата».
MPP поддерживает множественные базовые инфраструктурные маршруты: Visa опубликовала спецификацию карт, позволяющую агентам расплачиваться токенизированными карточками; стартап Lightspark реализует платежи через Lightning Network на базе того же процесса 402, синхронизируя их с программой выпуска карт Visa. Торговые площадки, ранее интегрировавшие оплату картами Stripe, теперь способны принимать транзакции по протоколу MPP напрямую, направляя выручку на обычные торговые счета Stripe. Сеть Lightning выступает альтернативным каналом внутри правил MPP. Компания Stripe паритетно поддерживает оба метода (x402). Примечательно, что и x402, и MPP повторно используют классический HTTP-статус 402 «Требуется оплата», однако underneath лежат принципиально разные архитектуры.
Получают ли создатели контента вознаграждение?
Без справедливой оплаты производители контента прекратят выпуск новых материалов, и ИИ-агенты вскоре исчерпают источники для анализа свежей информации.
Яркими примерами реализации данного направления выступают проекты Cloudflare, Parallel и OpenLedger.
Изначально Cloudflare навязывал сканирующим программам единую фиксированную лицензионную плату. Такая модель показалась слишком примитивной: получение доступа к главной странице и глубокому журналистскому расследованию обходилось абсолютно одинаково. Сейчас компания смещает фокус на ценообразование, привязанное к ценности данных: компенсация издателям выплачивается только в момент фактического коммерческого использования информации. Параллельно, если поставщики ИИ откажутся оплачивать контент на сайтах, монетизируемых через рекламу, платформа автоматически заблокирует попытки их роботов индексировать такие ресурсы.
19 мая Parallel представила продукт Index, опирающийся на алгоритм значения Шепли из теории кооперативных игр. Система рассчитывает пропорциональный вклад каждого источника данных в итоговый ответ агента и распределяет доход соразмерно. Отказавшись от плоской оплаты за каждый клик, инженеры применяют строгую математику для оценки конкретной практической пользы отдельного текста. Среди стратегических партнеров числятся издания The Atlantic, Fortune, агентства PR Newswire, а также аналитические платформы PitchBook, ZoomInfo, Tracxn, RocketReach, Enigma и Fiscal AI.
На сегодняшний момент расчеты через Index происходят исключительно в тот момент, когда агент задействует встроенный поисковый модуль Parallel. Пока остальные ИИ-платформы не подключатся массово, продукт не способен стать единым сетевым стандартом.
Платформа OpenLedger предлагает альтернативный подход на базе токеномики. Она отслеживает степень влияния конкретных массивов данных на обучение моделей, начисляя вознаграждения участникам проектного сообщества родными цифровыми активами. Эта система заточена под разработчиков тренировочных корпусов, а не служит инструментом компенсации за ежедневные новостные публикации.
Попытки изучить точные объемы выплат, производимых этими платформами разработчикам, потерпели неудачу: Cloudflare не раскрывает финансовые отчеты, Parallel хранит цифры в секрете, а OpenLedger осуществляет выплаты в родственных токенах OPEN без публикации агрегированной статистики распределения средств. Исходя из этого, на данный момент у нас недостаточно эмпирических оснований для объективной оценки реальной эффективности предложенных экономических моделей.
В эволюции человеческого бизнеса кассовый аппарат оказался относительно поздним изобретением. Люди потратили столетия на формирование устных договоренностей и локальных систем репутации, прежде чем создать удобные формы низкофрикционных платежей. Развитие машинного интернета строилось по противоположной траектории: с самого зарождения оно поддерживало мгновенные и непрерывные глобальные расчеты. Сегодня экономика агентного типа в спешке пытается реконструировать децентрализованные суды по мелким спорам, пытаясь уберечь роботов от взаимных махинаций на сумму в несколько долларов.
В заключение процитируем Терри Пратчетта:
«Бездумно твердить о чистой логике и заявлять, что машина просто исполняет запрограммированные инструкции, конечно же, легко. Однако люди вправе ожидать, что устройства хотя бы в минимальной степени обладают здравым смыслом».
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News