Тестирование «самого умного в мире» Grok3: Действительно ли это конец предельного эффекта моделей?
18 февраля по пекинскому времени Маск и команда xAI в прямой трансляции официально представили последнюю версию Grok — Grok 3.
Еще до этой презентации, благодаря различным утечкам информации и непрерывному разогреву со стороны самого Маска в режиме 24/7, ожидания мирового сообщества относительно Grok 3 достигли беспрецедентного уровня. Неделю назад в прямой трансляции, комментируя DeepSeek R1, Маск с уверенностью заявил, что «xAI вскоре представит еще более совершенную модель ИИ».
Судя по данным, представленным на мероприятии, Grok 3 превзошел все текущие основные модели в бенчмарках по математике, естественным наукам и программированию. Маск даже утверждал, что в будущем Grok 3 будет использоваться для расчетов миссии SpaceX на Марс, и предсказал, что «в течение трех лет будет достигнут прорыв уровня Нобелевской премии».
Но пока это лишь слова самого Маска. Автор сразу после релиза протестировал новейшую бета-версию Grok 3 и задал тот классический вопрос, предназначенный для затруднения больших моделей: «Что больше: 9.11 или 9.9?»
К сожалению, без каких-либо уточнений и пометок号称 самый умный на данный момент Grok 3 все равно не смог правильно ответить на этот вопрос.
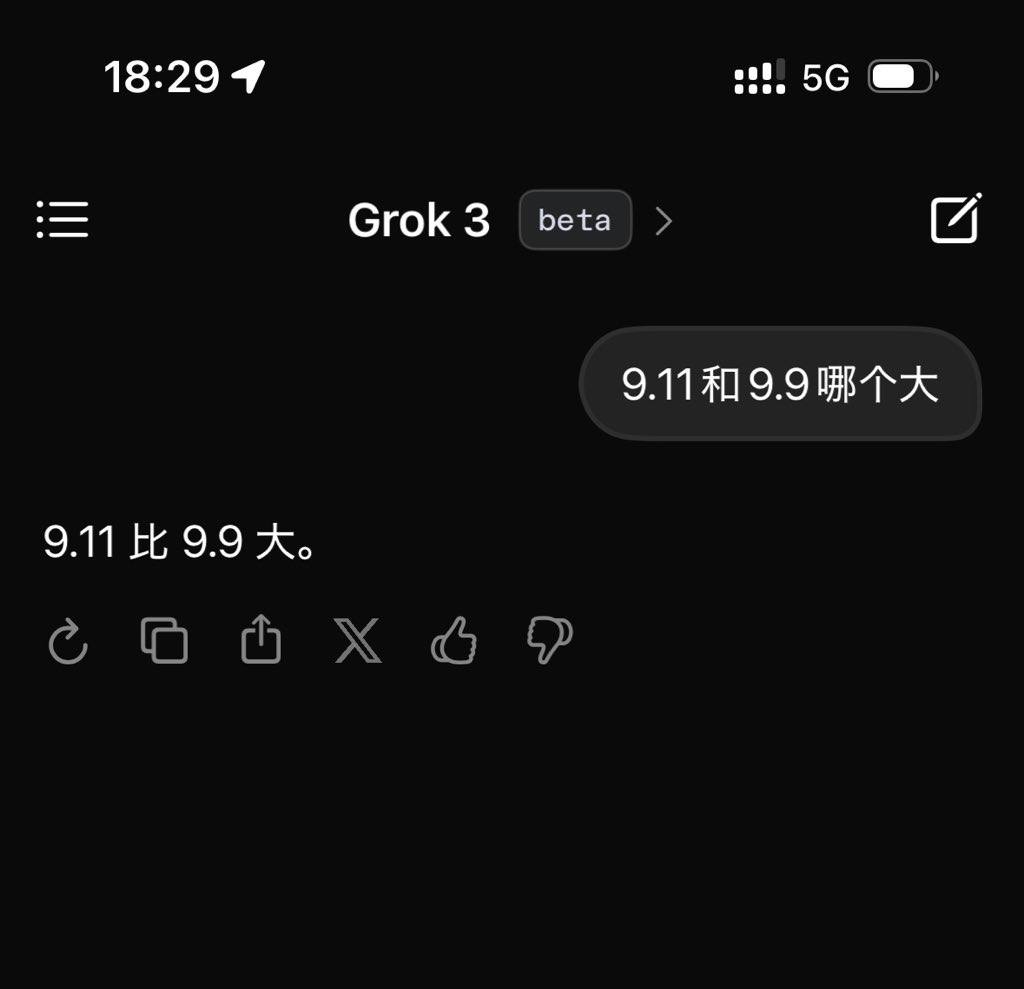
Grok 3 не удалось точно определить смысл этого вопроса
Источник: Geek Park
После того как этот тест был опубликован, он очень быстро привлек внимание многих друзей. Неудивительно, что за рубежом также проводилось множество тестов с похожими вопросами, например, «какой из двух шаров упадет первым с Пизанской башни». Было обнаружено, что Grok 3 все еще не может справиться с этими базовыми вопросами по физике/математике. Поэтому его в шутку называют «гений не желает отвечать на простые вопросы».
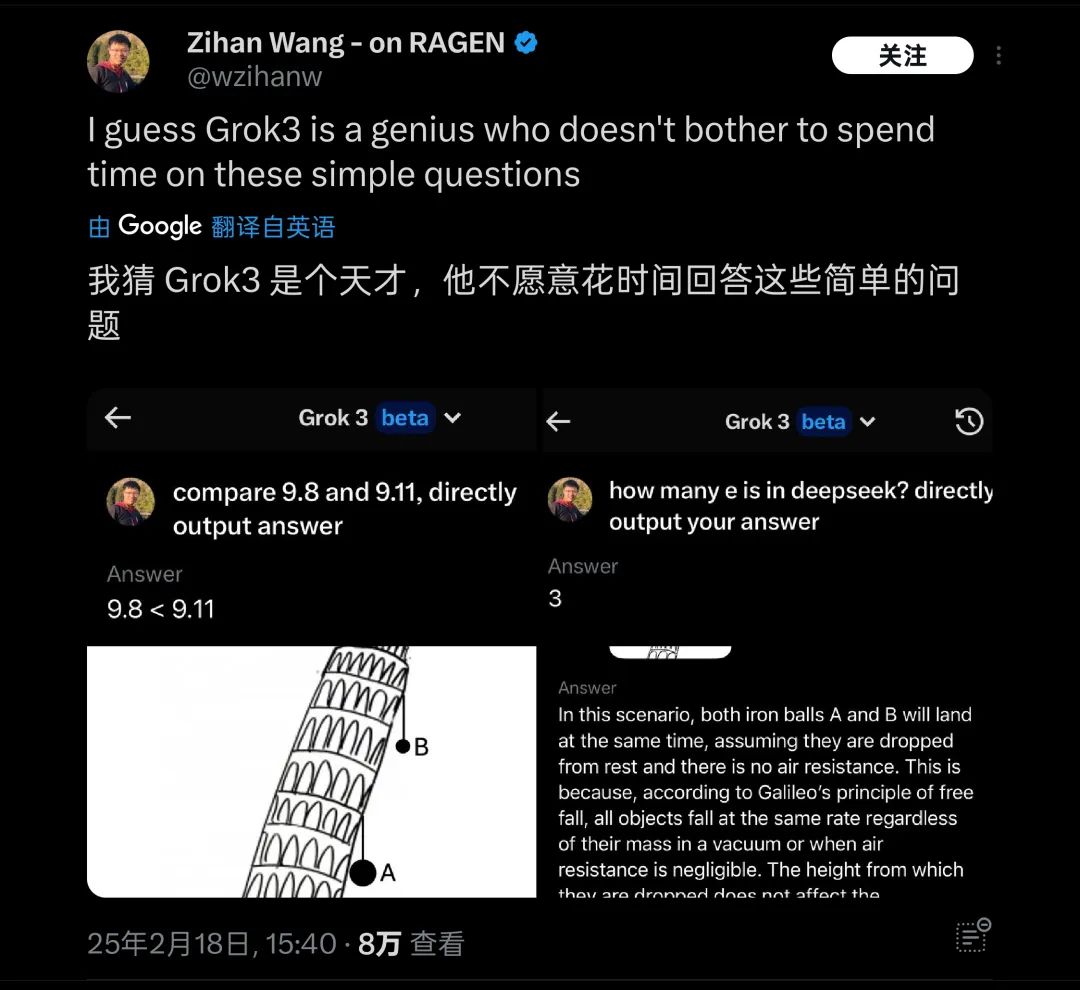
Grok 3 «провалился» на многих вопросах здравого смысла в реальных тестах
Источник: X
Помимо этих провалов в тестах, инициированных пользователями, во время прямой трансляции презентации xAI Маск продемонстрировал использование Grok 3 для анализа классов и эффектов возвышения в игре Path of Exile 2 («Путь изгнания 2»), в которую он, как утверждается, часто играет. Однако большинство ответов, предоставленных Grok 3, оказались ошибочными. Маск в прямом эфире не заметил этой очевидной проблемы.
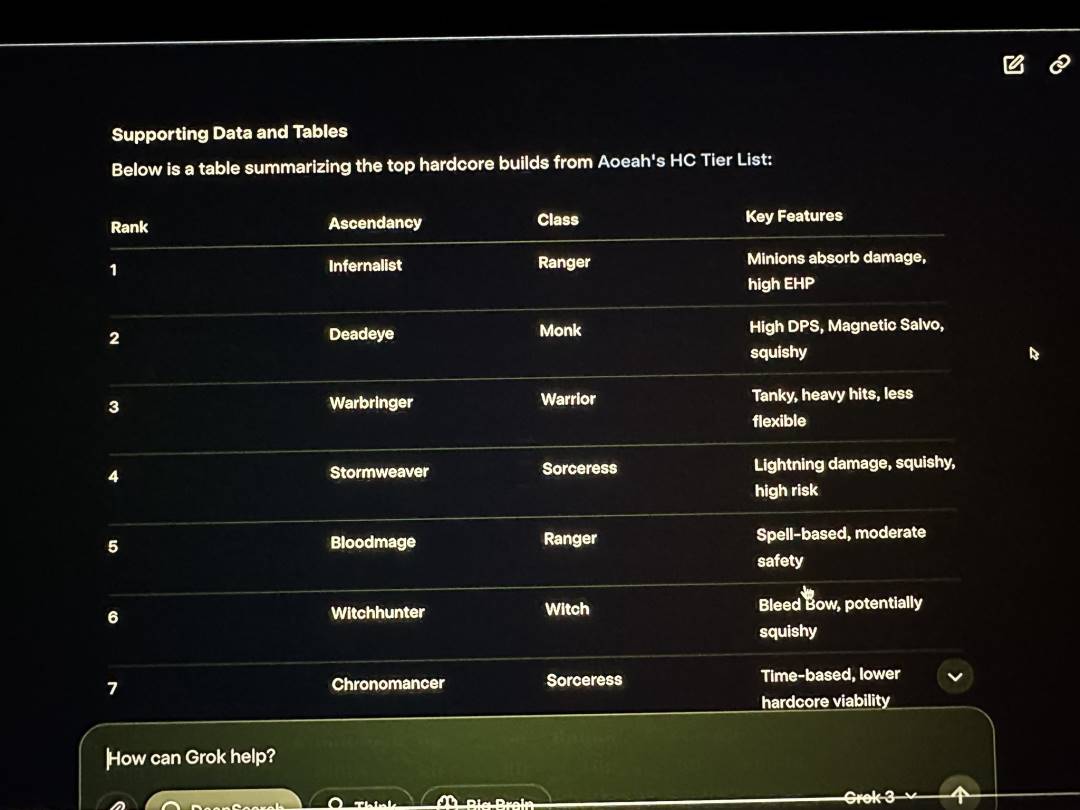
Во время прямой трансляции Grok 3 также допустил множество ошибок в предоставленных данных
Источник: X
Поэтому эта ошибка не только стала неопровержимым доказательством для зарубежных пользователей, чтобы снова посмеяться над тем, что Маск играет в игры «с помощью бустеров», но и вновь поставила под большое сомнение надежность Grok 3 в реальных приложениях.
Для такого «гения», каковы бы ни были его реальные способности, в будущем при использовании в таких чрезвычайно сложных сценариях применения, как исследование Марса, его надежность должна быть поставлена под большой вопрос.
В настоящее время многие, кто получил доступ к тестированию Grok 3 несколько недель назад, а также тестировщики возможностей модели, использующие ее всего несколько часов со вчерашнего дня, пришли к одинаковому выводу относительно текущей производительности Grok 3:
«Grok 3 хорош, но он не лучше, чем R1 или o1-Pro»
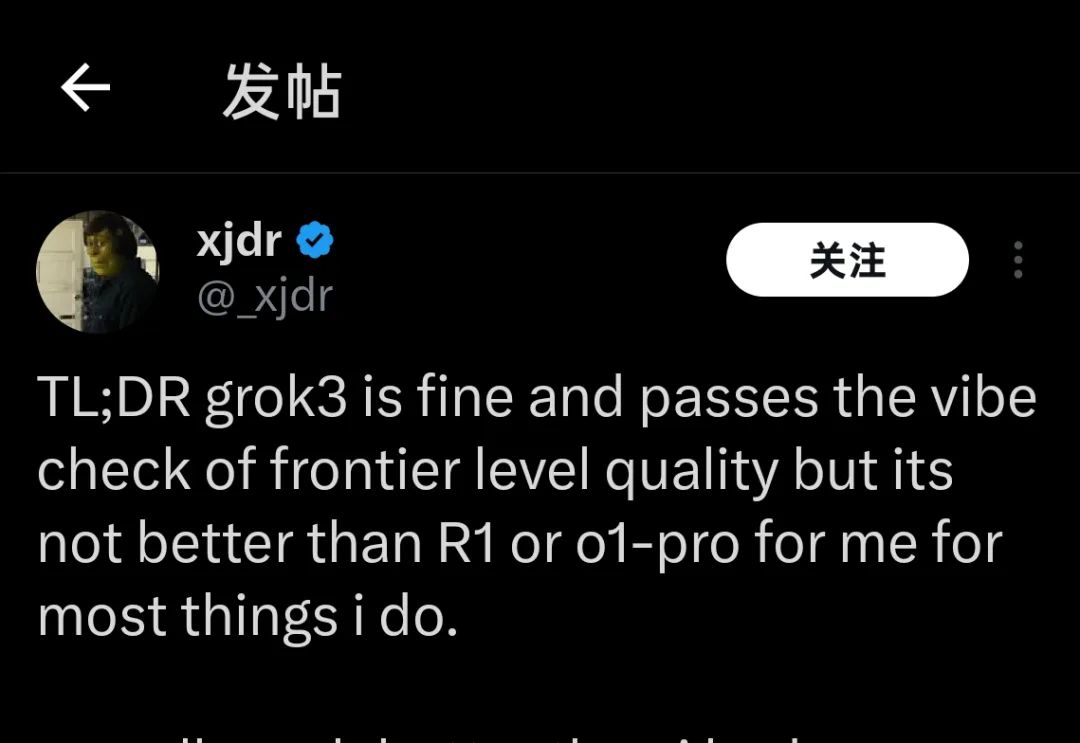
«Grok 3 хорош, но он не лучше, чем R1 или o1-Pro»
Источник: X
В официальном PPT на презентации Grok 3 утверждалось, что модель демонстрирует «значительное лидерство» на арене больших моделей Chatbot Arena, но на самом деле здесь были применены некоторые небольшие трюки с графикой: вертикальная ось рейтинга включала только диапазон 1400-1300 баллов, из-за чего разница в результатах тестов в 1% на этом PPT выглядела чрезвычайно заметной.
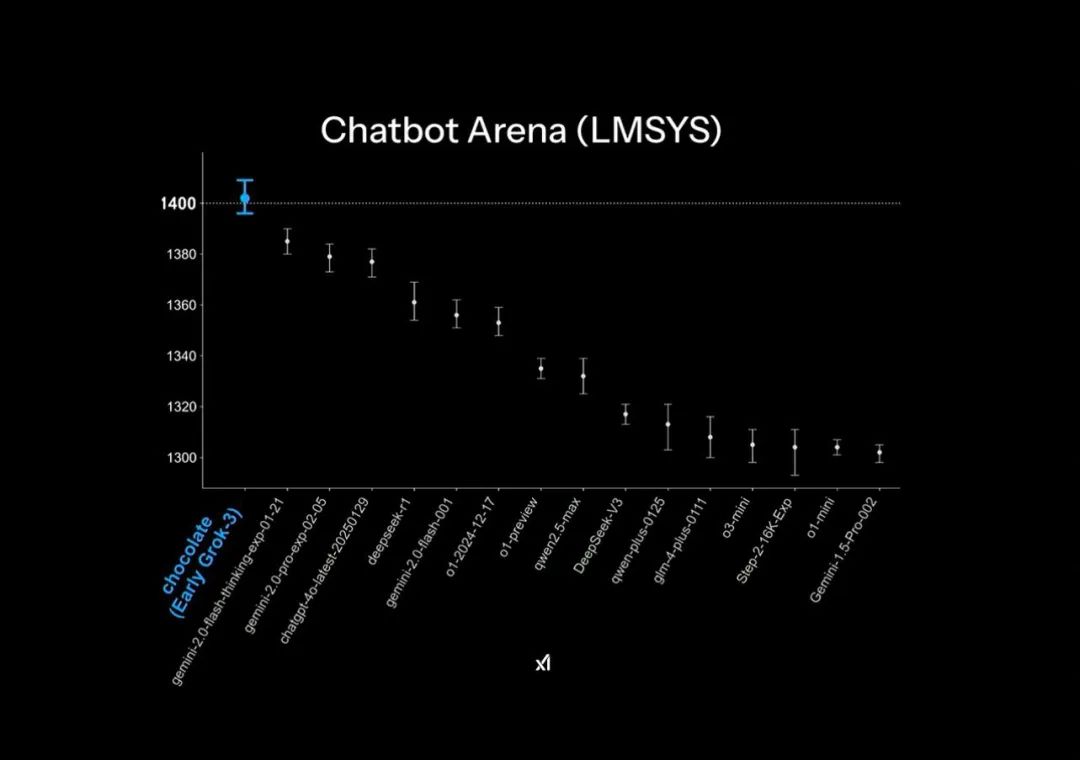
Эффект «значительного лидерства» в официальном PPT презентации
Источник: X
Однако фактические результаты бенчмарков модели показали, что Grok 3 фактически опережает DeepSeek R1 и GPT4.0 менее чем на 1-2%: это соответствует субъективному ощущению многих пользователей при реальном тестировании, что «нет очевидной разницы».
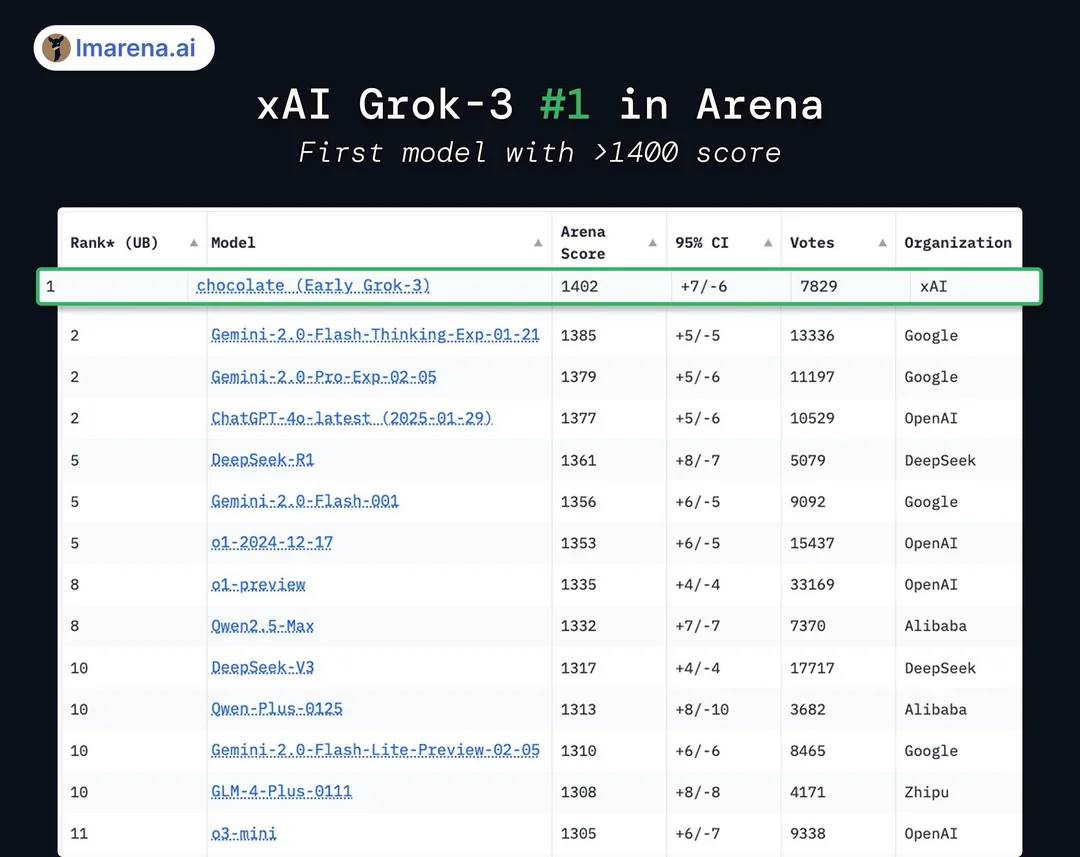
Фактически Grok 3 опережает последователей всего на 1%-2%
Источник: X
Кроме того, хотя по баллам Grok 3 превзошел все модели, прошедшие открытое тестирование на данный момент, многие с этим не согласны: ведь еще во времена Grok 2 у xAI была ситуация с «накруткой» баллов в этом рейтинге, когда баллы значительно снижались из-за обработки снижения веса за длину и стиль ответов, поэтому отраслевые эксперты часто критикуют модель за «высокие баллы, низкие способности».
Будь то «накрутка» баллов в рейтинге, или «небольшие хитрости» в дизайне иллюстраций, все это демонстрирует одержимость xAI и самого Маска идеей «значительного лидерства» возможностей модели.
И цена, которую заплатил Маск за эти различия, невероятно высока: на презентации Маск с почти хвастливым тоном заявил, что для обучения Grok 3 было использовано 200 000 карт H100 (в прямой трансляции Маск заявил об использовании «более 100 000» карт), а общее количество часов обучения достигло 200 миллионов часов. Это заставило некоторых людей подумать, что это еще одна серьезная поддержка для индустрии GPU, и считать, что потрясение, принесенное DeepSeek индустрии, было «глупым».
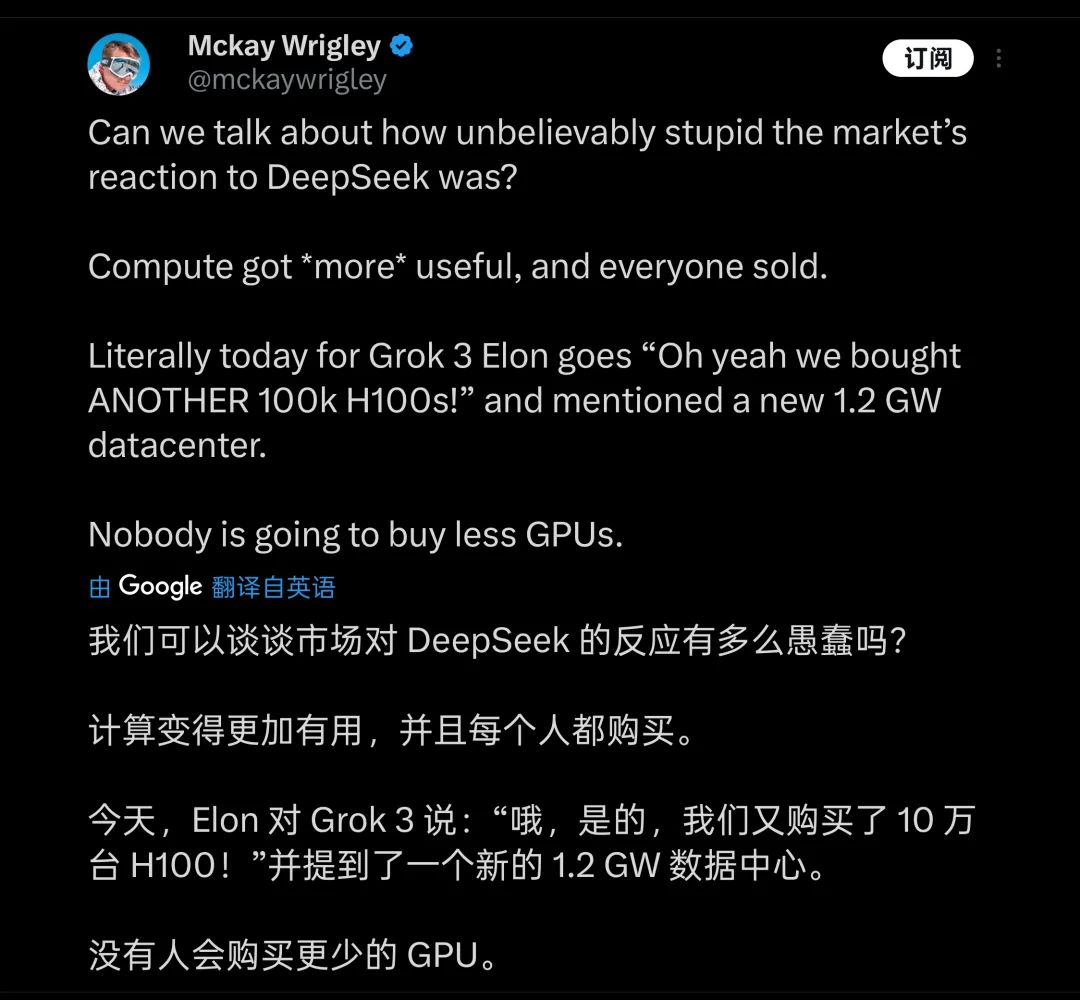
Многие считают, что наращивание вычислительной мощности станет будущим обучения моделей
Источник: X
Но на самом деле, некоторые пользователи сравнили DeepSeek V3, обученный на 2000 картах H800 в течение двух месяцев, и подсчитали, что фактическое потребление вычислительной мощности для обучения Grok 3 в 263 раза превышает V3. При этом разница между DeeSeek V3 и Grok 3, набравшим 1402 балла на арене больших моделей, составляет даже менее 100 баллов.
После появления этих данных многие быстро осознали, что за восхождением Grok 3 на вершину «сильнейшего в мире» на самом деле стоит логика «чем больше модель, тем выше производительность», которая уже продемонстрировала явный предельный эффект.
Даже у «высокобалльного, но слабого» Grok 2 за спиной была поддержка огромного количества высококачественных данных первой стороны внутри платформы X (Twitter). Что касается обучения Grok 3, xAI, естественно, столкнется с тем же «потолком», с которым сейчас сталкивается OpenAI — нехватка качественных данных для обучения заставляет предельный эффект возможностей модели быстро проявиться.
Для этих фактов最早意识到并且也是最深刻理解的人,肯定是 Grok3 的开发团队与马斯克 (Первыми, кто осознал эти факты и понял их глубже всего, безусловно, являются команда разработчиков Grok 3 и Маск), поэтому Маск также постоянно заявлял в социальных сетях, что версия, которую пользуют пользователи сейчас, «все еще лишь тестовая», а «полная версия будет выпущена в ближайшие несколько месяцев». Сам Маск даже превратился в продукт-менеджера Grok 3, предложив пользователям напрямую оставлять обратную связь о различных проблемах, encountered при использовании, в комментариях.
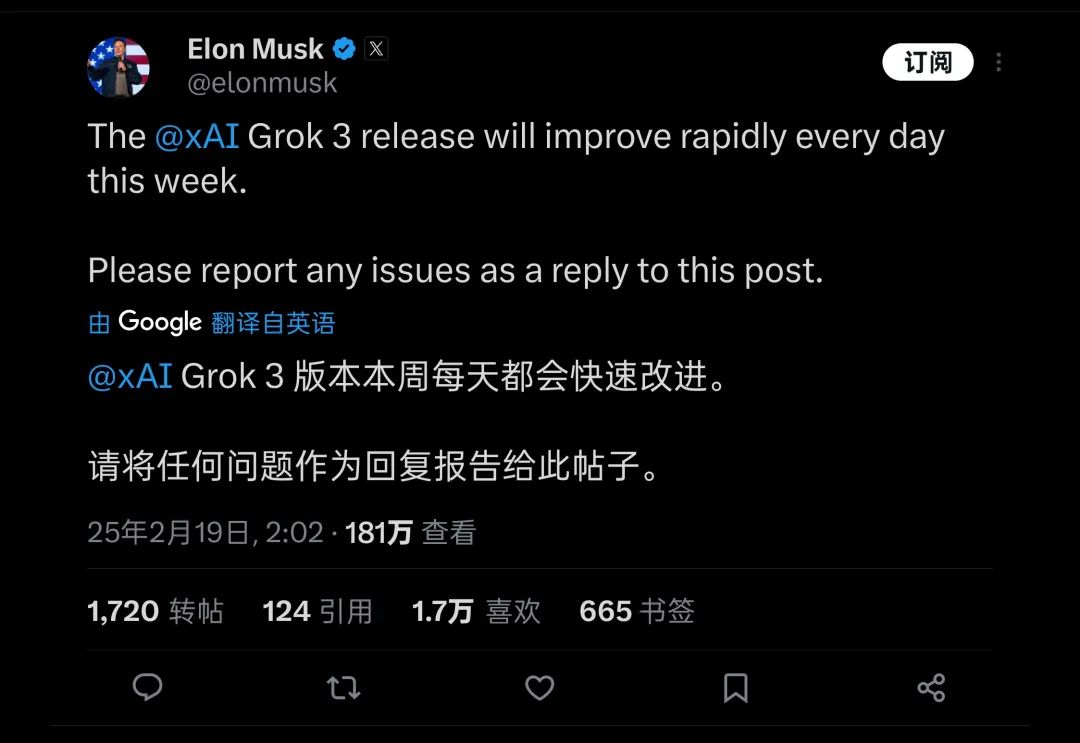
Вероятно, он продукт-менеджер с наибольшим количеством поклонников на Земле
Источник: X
Но менее чем за день производительность Grok 3, безусловно, стала тревожным звоночком для последователей, надеющихся依靠 «грубой силой» обучить более мощные большие модели: согласно公开 информации Microsoft,推测 объем параметров OpenAI GPT4 составляет 1,8 триллиона, что уже более чем в 10 раз больше по сравнению с GPT3, а объем параметров rumored GPT4.5, по слухам, будет еще больше.
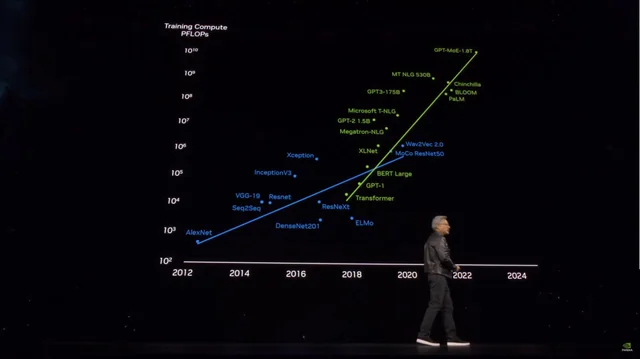
Пока объем параметров модели стремительно растет, стоимость обучения также взлетает
Источник: X
С Grok 3 в качестве примера, GPT4.5 и многие другие участники, желающие继续 «сжигать деньги», чтобы получить лучшую производительность модели за счет объема параметров, вынуждены учитывать уже прямо перед глазами находящийся потолок и думать, как его突破.
В этот момент слова бывшего главного ученого OpenAI Ильи Суцкевера, заявленного в декабре прошлого года, что «предобучение, которое мы знаем, закончится», снова вспомнили и пытаются найти в них настоящий выход для обучения больших моделей.
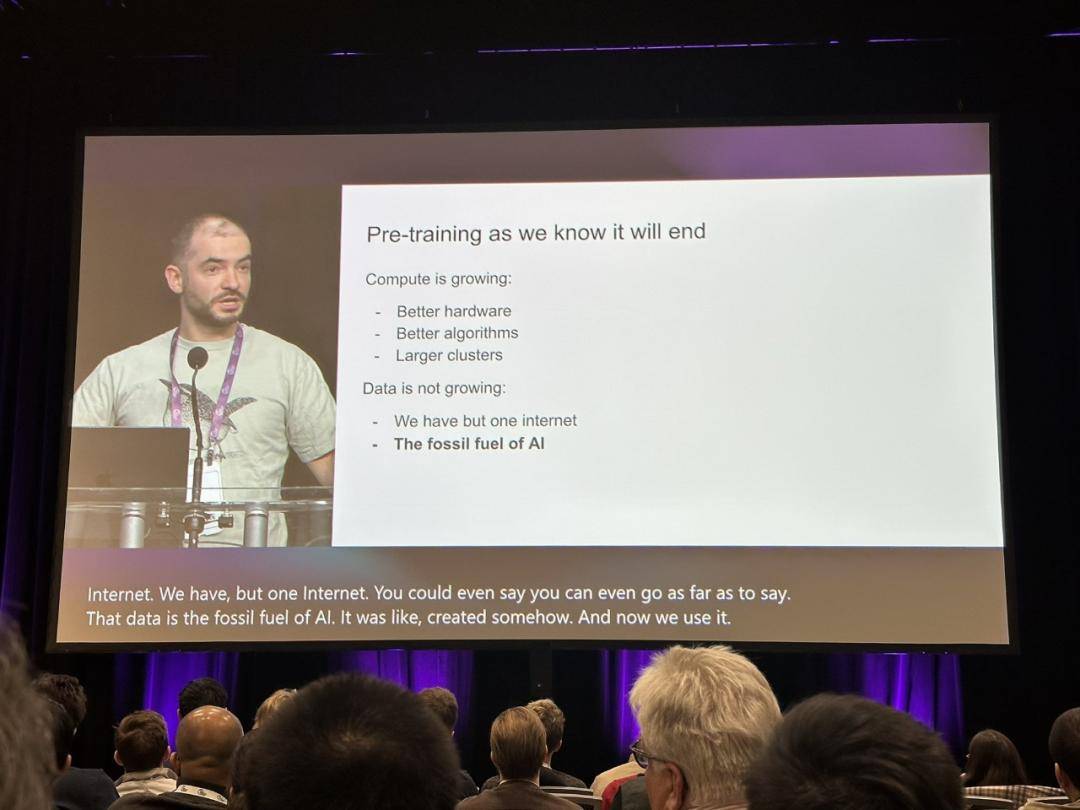
Взгляды Ильи уже прозвонили тревожным звоночком для индустрии
Источник: X
Тогда Илья точно предвидел ситуацию, когда доступные новые данные близки к истощению, и модели трудно继续 улучшать производительность за счет получения данных, и описал эту ситуацию как потребление ископаемого топлива, заявив, что «так же, как нефть является ограниченным ресурсом, контент, созданный людьми в интернете, также ограничен».
Согласно прогнозу Суцкевера, модель следующего поколения после моделей предобучения будет обладать «настоящей автономностью». При этом она будет具备 «способностью к рассуждению, подобным человеческому мозгу».
В отличие от современных моделей предобучения, которые в основном полагаются на сопоставление контента (на основе ранее изученного контента моделью), будущие AI-системы смогут постепенно учиться и выстраивать методологию решения проблем способом, аналогичным «мышлению» человеческого мозга.
Чтобы человек достиг базового владения какой-либо дисциплиной, достаточно基本 профессиональных книг, но большим моделям ИИ необходимо学习 миллионами данных, чтобы достичь даже базового эффекта входа, и даже когда вы меняете формулировку вопроса, эти базовые вопросы все равно не могут быть правильно поняты: модель не получила улучшения в настоящем интеллекте: те базовые вопросы, упомянутые в начале статьи, на которые Grok 3 все еще не может правильно ответить, являются наглядным проявлением этого явления.
Но помимо «грубой силы», если Grok 3 действительно сможет раскрыть индустрии факт, что «модели предобучения即将走到尽头», то это все равно можно назвать имеющим важное вдохновляющее значение для индустрии.
Возможно, после того как ажиотаж вокруг Grok 3 утихнет, мы также сможем увидеть появление большего количества случаев, подобных Фэй-Фэй Ли, «дообучение высокопроизводительных моделей за 50 долларов на特定 наборе данных». И в этих исследованиях в конечном итоге найти путь, ведущий к AGI.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 极客公园