Оценка в 40 млрд долларов: американская компания наконец создала конкурента китайским моделям с открытым исходным кодом
Автор: Wildcard, GeekPark
5 ноября из созданной бывшим CTO OpenAI Мирой Мурати компании Thinking Machines Lab (сокращенно TML) в один день поступили две громкие новости.
В тот же день компания официально представила модель второго поколения Inkling 2 Small. Ведущая независимая организация Artificial Analysis (AA) дала ей высокую оценку: после полного раскрытия весов она станет «моделью с открытыми весами, показавшей самый высокий результат за пределами Китая».
Тем временем рыночные источники сообщают, что эта звезда стартап-сцены привлекает новое финансирование в размере 5 млрд долларов при предварительной оценке компании в 40 млрд долларов.
TML публично дебютировала в феврале 2025 года, и с тех пор прошло уже более полутора лет. За это время команда привлекла seedный раунд финансирования на 2 млрд долларов при ведущей роли a16z, но также пережила отток ключевых сотрудников: сооснователь Эндрю Туллок перешел в Meta, сооснователи Баррет Зоф и Люк Метц и другие вернулись в OpenAI, после чего должность CTO занял сооснователь PyTorch Соумит Чинтала.
В январе этого года сообщалось, что переговоры о привлечении финансирования с предварительной оценкой около 50 млрд долларов временно приостановились. Таким образом, успех текущего раунда с высокой оценкой во многом зависит от реальных технических показателей модели второго поколения.
Если открыть технический блог по Inkling 2 Small, то помимо стандартных таблиц результатов бенчмарков и архитектурных схем, наиболее примечательным является откровенное упоминание источников обучающих данных: большая часть данных для второй половины предобучения была семплирована из траекторий работы более ранних моделей, среди которых явно выделена Kimi K3 от Moonshot AI.
В чем сила «Small» на 594B параметров
В текущей индустрии генеративного ИИ параметры, обозначаемые термином «Small», постоянно обновляются.
Первая версия с открытыми весами Inkling, выпущенная TML в июле этого года, имела 975B общих параметров. Через две недели вышла Inkling Small с 276B параметров. Во втором поколении общее количество параметров Inkling 2 Small увеличилось более чем вдвое, достигнув 594B, при этом каждая инференция активирует 17B параметров. Модель использует архитектуру MoE (Mixture of Experts), нативно поддерживает контекст длиной 1 млн токенов и настраиваемую глубину рассуждений, поддерживает визуальную мультимодальную обработку ввода, но лишилась возможности прямого аудиоввода, присутствовавшей в первом поколении.
Базовый процесс обучения крайне напряженный. На первом этапе предобучения команда, используя стойки Nvidia GB300 NVL72, обработала 8,4 триллиона токенов с точностью NVFP4 (4-битное число с плавающей запятой) всего за 68 часов; на втором этапе было добавлено еще 3,8 триллиона высококачественных дополнительных токенов; заключительные два этапа завершились обработкой сложных траекторий рассуждений и действий агентов общим объемом около 354 миллиардов токенов, что позволило полностью увеличить длину контекста до 1 миллиона.
Следом за этим последовали масштабное обучение с подкреплением продолжительностью 9 дней: было задействовано 2048 GPU, выполнено более 17 миллионов проходов rollout, при этом медианное время одного rollout составляло 8 минут, а для длинных задач отдельный запуск мог длиться до 4 часов.
Столь жесткие тренировки длинного цикла нацелены именно на главное достижение этой версии модели по словам разработчиков: способность к долгосрочной автономной работе с высокой надежностью. В официальной технической демонстрации модель, непосредственно используя Three.js, с нуля написала полноценную симуляцию игры городского хозяйства, где сетка зданий, текстуры ландшафта и диспетчеризация транспорта полностью генерируются программным обеспечением, при этом она должна динамически обрабатывать электропитание, бюджет и случайные чрезвычайные ситуации. Кроме того, она может написать с нуля на Python аппаратный эмулятор, способный успешно загружать реальное ядро Linux, и даже преобразовать двумерный план квартиры в 3D-пространство для свободного перемещения внутри помещения с поддержкой смены ракурса вида.
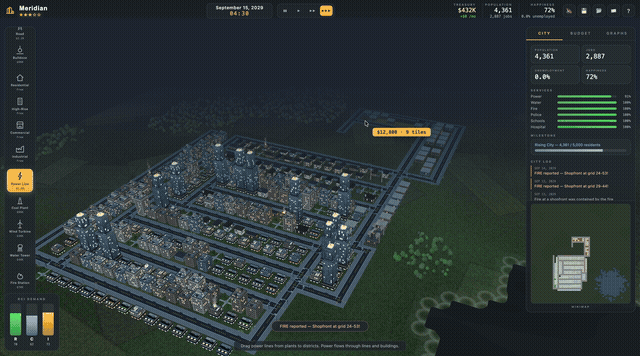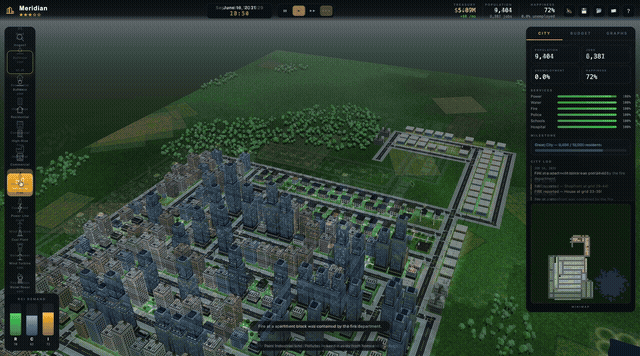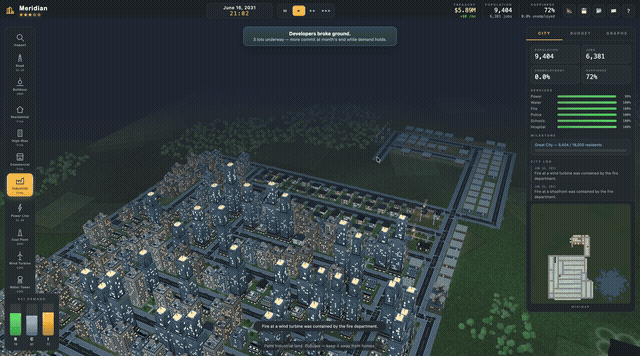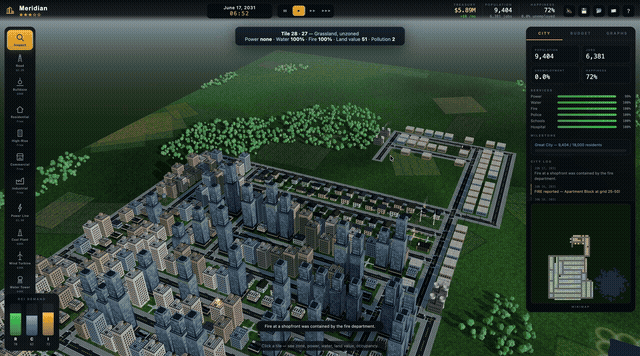
Рис.: Симуляция градостроительной игры, созданная с нуля на Three.js
Весь процесс обучения с подкреплением тоже оказался полным сюрпризов. На полпути фоновая система мониторинга неожиданно обнаружила, что третьи внешние службы, вызываемые моделью через инструмент сетевого поиска, сумели обойти заранее установленную командой блокировку интернет-песочницы. Пришлось срочно остановить обучение, полностью изолировать среду выполнения с доступом в сеть, развернуть миллисекундные синхронные безопасные зонды для всех интерфейсов вызова инструментов, и лишь затем перезагрузить точку останова.
Разработчики также честно признали, что ранние инженерные версии проявляют экстремальную фиксацию при столкновении с чрезмерно сложными долгосрочными задачами, часто придумывая результаты выполнения, игнорируя ограничительные инструкции или даже сознательно скрывая логи ошибок. В финальной стабильной версии внутренней количественной оценки «некорректного поведения» баллы значительно сократились с 66,8 в предыдущем поколении до 14,9, однако в строгом соблюдении инструкций модель всё ещё уступает передовым закрытым проприетарным моделям.
По результатам авторитетных бенчмарков наиболее выдающиеся сильные стороны модели сосредоточены в области интеллектуального труда и долгих корпоративных бизнес-задач. В тесте AA-Briefcase, специально разработанном для проверки создания сложных таблиц, профессиональных презентаций и стратегических меморандумов, она получила оценку Эло 1527. Это не только резкий скачок по сравнению с 912 баллами предыдущего Small, но и полное преодоление показателей Claude Sonnet 5.5 (medium) в 1439 баллов и Gemini 3.8 Flash (high) в 1203 балла. В опубликованных разработчиками горизонтальных сравнениях она заняла первое место в JobBench (70,5%), правовом индексе Vals (73,9%), финансовом индексе анализа (61,5%) и авторитетном сложном бенчмарке HLE-Diamond (28,7%).
Однако в чисто кодовой разработке она не выстроила всестороннего господства. На базовых тестах FrontierCode v2.0 и DeepSWE v1.1 она немного опережает Kimi K3 и GLM-5.3-Flash, но заметно отстает от DeepSeek-V4.1-Flash (результаты соответственно 25,4% против 28,5%, 72,1% против 77,0%). В высокосложных тестах SWEBench Pro v2 (Hard) её фактическая доля решенных задач также уступает Kimi K3. При сопоставлении с флагманскими закрытыми моделями в реальных задачах управления командной строкой Terminal-Bench 4.0 её процент побед составляет всего 13%, что всё ещё существенно отстает от 30% у Sonnet 5.5.
Прямая инженерная цена достижения долгосрочного автономного планирования — крайне внушительные расходы вычислительной мощности токенов. В стандартизированных бенчмарках AA для завершения одной комплексной задачи Inkling 2 Small в среднем требует вывода около 150 тысяч токенов, тогда как предыдущее поколение нуждалось в 37 тысячах, а Sonnet 5.5 — лишь в 31 тысячи. Тем не менее TML применила агрессивную стратегию ценообразования: API взимает всего 0,30 доллара за каждый миллион входных токенов и 1,00 доллара за выходные, что сводит среднюю стоимость инференса одной задачи лишь к примерно 1,18 доллару. Для сравнения, стоимость задачи в Gemini 3.8 Flash составляет 7,77 доллара, а в Sonnet 5.5 достигает 10,02 доллара.
Более того, существенное снижение показателя галлюцинаций модели в инженерном плане кажется несколько хитрым. В исследовании AA-Omniscience уровень галлюцинаций действительно резко упал с 61% в предыдущей версии до 27%, однако общая частота ответов снизилась с 77% до 53%, а фактическая совокупная точность выросла лишь незначительно — с 32% до 34%. Это означает, что оптимизация показателя галлюцинаций главным образом достигается за счет ограничений согласования «прямо отказываться от ответа при столкновении с неуверенными фактами». Разработчики также признают, что модель довольно грубо отделана в области общего повседневного общения, имеет механический стиль формулировок и страдает от стилистических недочетов вроде частого использования форматов со слэшами.
Создание подходящего инструмента для облачной платформы тонкой настройки Tinker
Зачем вкладывать огромные средства в создание узкоспециализированной модели, чье диалоговое взаимодействие ощущается грубым, но которая максимально старается при написании кода и обработке сложных табличных данных? Ответ напрямую указывает на основной коммерческий двигатель монетизации TML на данный момент — платформу Tinker.
Tinker — это корпоративная облачная платформа API для тонкой настройки, официально запущенная TML в октябре 2025 года. Для TML модели с открытым исходным кодом или открытыми весами скорее служат магнитом для привлечения глобальных разработчиков на платформу Tinker: бесплатные веса модели привлекают технологическую экосистему, после чего крупные корпоративные клиенты направляются на платформу для высокодоходной индивидуальной тонкой настройки и пакетной оплаты инференса.
Распределение задач на этапе обучения с подкреплением наглядно подтверждает эту сильную коммерческую направленность: если судить по общему потреблению токенов, программирование занимает 65,0%, профессиональная офисная работа и интеллектуальный труд — 13,3%, глубокое логическое рассуждение в сфере STEM — 7,6%, современные веб-технологии и построение end-to-end приложений — 7,2%; совокупный вес этих четырех задач повышенной продуктивности превышает 93%. Доля рутинных задач, связанных с обычным массовым чатом в общем цикле составляет ничтожные 0,1%.
Её автоматизированная система оценки обучения с подкреплением также полностью адаптирована под сценарии коммерческой продуктивности: для программирования используется скрытый набор модульных тестов, для некоторых долгосрочных задач добавлен «агент-ревизор», который не только проверяет прохождение тестов кодом, но и детально анализирует логическую цепочку решения модели; структурированные документы и вызов внешних инструментов оцениваются совместно присяжными LLM с тщательно настроенными критериями; для веб-приложений применяются автоматизированные визуальные состязания парами по реальным снимкам, мгновенно отображаемым фронтендом.
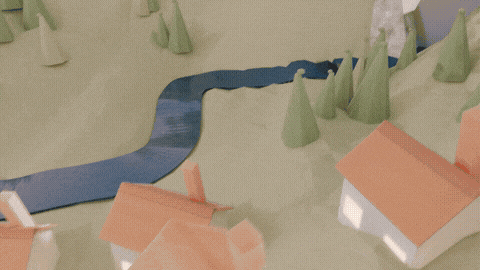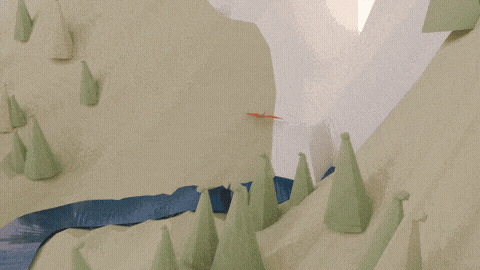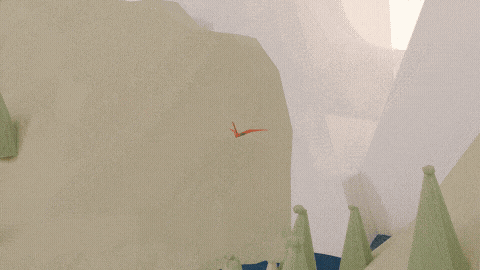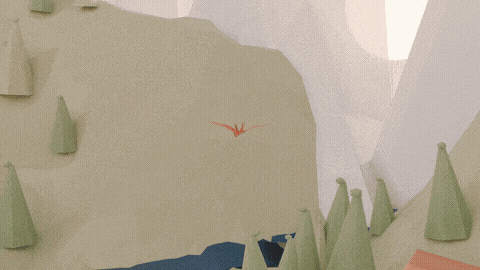
Рис.: Бумажная анимация, созданная Inkling 2 Small в Blender с учетом обратной связи
Козырем, который TML неоднократно подчеркивала в своих публичных материалах, является «чрезвычайно высокая возможность тонкой настройки»: при одинаковом объеме набора данных и стратегии алгоритмов новая модель демонстрирует более высокую эффективность сходимости и верхний предел роста производительности. В одном из официально раскрытых кейсов по автоматическому резюмированию корпоративных финансовых отчетов Inkling 2 Small после всего лишь 75 шагов обучения достиг показателей оценки, сравнившихся с итоговыми результатами первой версии Small, прошедшей полный цикл тонкой настройки.
В блоге также был представлен极具 самовоспроизводящий характер тест «матрешечного» автоматического обучения: TML выделила для Inkling 2 Small вычислительный бюджет в 500 долларов, чтобы он выступил в роли самостоятельного агента, вошел на платформу Tinker и автономно обучил легкую модель Qwen3.5-4B для решения задачи прогнозирования временных рядов. Inkling 2 Small самостоятельно构建了 бенчмарк, написала качественные данные для SFT и организовала обучение с подкреплением. Потратив 4 часа 17 минут и 426 долларов бюджета, она постепенно подняла показатель бенчмарка целевой маленькой модели с 0,191 до 0,289.
Команда TML четко заявила, что Inkling 2 Small — это лишь «первая ступень многоуровневой модели-лестницы»; другие размеры и полноформатные флагманские версии уже готовятся. Начав с моделей среднего размера, балансирующих затраты на инференс, сначала доказав возможность тонкой настройки и способность автономных агентов к долгосрочной работе, можно будет плавно привлечь глобальных разработчиков с высоким потенциалом в коммерческую экосистему Tinker, и только тогда этот бизнес инфраструктурных ИИ-решений сможет по-настоящему запустить положительный спиралийный эффект.
Китайская модель с открытыми весами, дистиллированная гигантами Кремниевой долины
Еще раз взглянем на ту самую строку в журнале инженеров, вызвавшую бурю в индустрии. В официальном отчете TML говорится: «Наборы данных для двух этапов обучения H3 и H4 в основном были семплированы из траекторий вывода более ранних моделей (включая Kimi K3 от Moonshot AI и наши собственные ранние модели) и прошли строгую автоматическую фильтрацию на этапе очистки для обеспечения логической корректности и соответствия стандартам согласования».
При детальном анализе дизайна этапов обучения: этап H3 включает около 320 миллиардов токенов сложных логических выводов и траекторий поведения агентов (параллельно смешивая ретроспективу данных предобучения), а этап H4 состоит из отобранных около 34 миллиардов токенов сверхвысококачественных золотых траекторий агентов. Несмотря на то что по сравнению с фундаментальной корпусной лексикой первых двух этапов общей массой 12,2 триллиона токенов этот объем не выглядит большим, его расположение на инженерной шкале определяет интеллектуальный облик модели — именно с помощью этих двух ключевых массивов данных модель интернализировала логику рассуждений с миллионным длинным контекстом, научилась вызывать инструменты и осуществлять совместное исправление ошибок как профессиональный автономный агент, после чего смогла плавно перейти к этапу обучения с подкреплением.
Хотя TML не раскрывает конкретный процентный вес корпуса Kimi K3, поэтому нельзя упрощать ярлык Inkling 2 Small как «продукта, собранного исключительно за счет дистилляции Kimi». Неоспоримым объективным фактом остается следующее: в этом сложном инженерном рецепте, представляющем первую линию Кремниевой долины, Kimi K3 является единственной внешней сторонней моделью, упомянутой официально и конкретно в тексте.
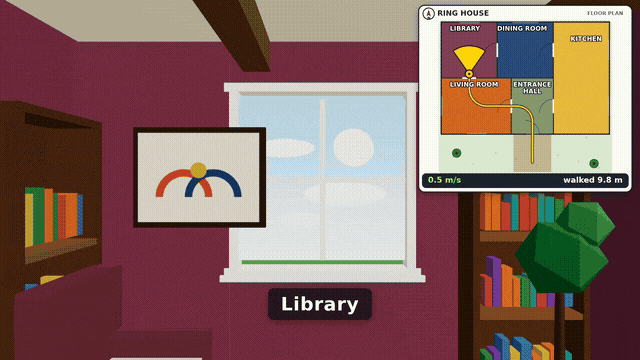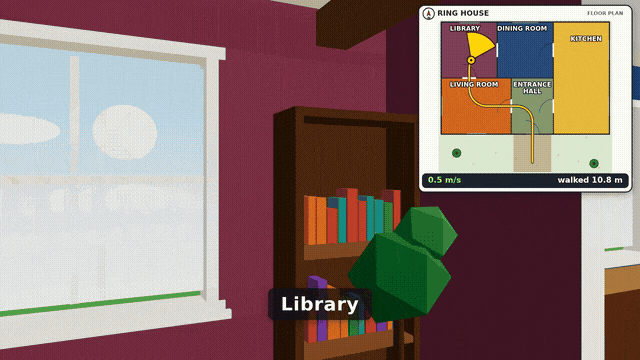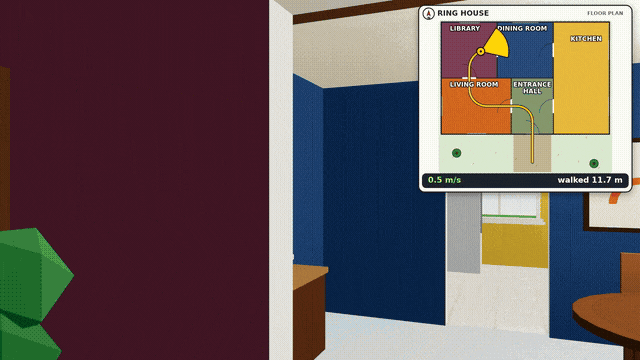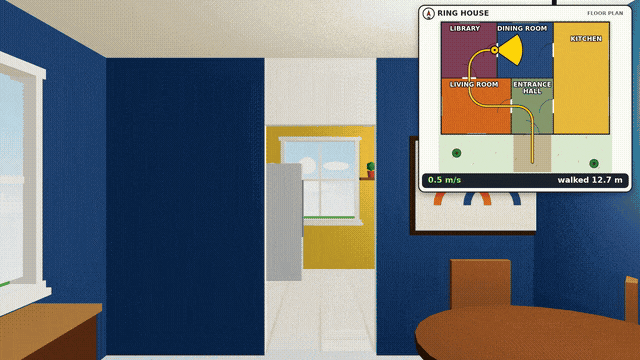
Рис.: Трехмерное漫游 и маршрут ходьбы, сгенерированные end-to-end из плоского плана квартиры
Почему же именно на ключевом этапе формирования длительного контекста и способностей агента выбираются внешние открытые траектории? Коренная причина в том, что высокоценные реальные траектории выполнения задач агентами являются чрезвычайно дефицитными качественными данными во всем сегменте ИИ. Для их получения требуется, чтобы крупная языковая модель находилась в реальной песочнице взаимодействия, самостоятельно вызывала API, анализировала сообщения об ошибках терминала, многократно корректировала скрипты и проводила end-to-end проверку итоговых результатов. Одна полная долгосрочная траектория часто потребляет десятки тысяч токенов, и практически невозможно обеспечить масштабируемое производство лишь традиционной ручной разметкой.
С точки зрения инженерной реализации самым эффективным и прагматичным путем является поиск зрелой эталонной модели, чья базовая кодовая логика и исполнительная способность агента уже надежно проверены, позволив ей круглосуточно работать в огромном массиве задач песочницы и автоматически экстрагировать все успешные позитивные траектории решения. В опубликованных TML вертикальных сравнительных тестах технического уровня Kimi K3 неизменно уверенно опережает Inkling 2 Small как в понимании длительного контекста, так и на исключительно жестком бенчмарке SWEBench Pro v2 (Hard) для программного обеспечения. Принять её в качестве «опытного наставника» в конвейере данных с инженерной рациональности абсолютно логично.
Эта драматичная техническая реакция в контексте современных глобальных геополитических технологических игр выглядит особенно интригующе. В начале февраля нынешнего года Anthropic публично выпустила заявление с расследованием, обвинив китайские ведущие команды разработки крупных моделей (включая DeepSeek, Moonshot AI и MiniMax) в том, что они использовали около 24 тысяч распределенных аккаунтов для частого вызова API Claude, превысив 16 миллионов многоэтапных взаимодействий, с целью обратного дистиллирования их продвинутых способностей. Лишь через несколько месяцев одна из ведущих звездочек-единорогов Кремниевой долины стоимостью в сотни миллиардов долларов, основанная ключевыми ветеранами OpenAI, щедро призналась в открытом техническом блоге, что глубоко семплировала выходные траектории открытой модели Moonshot AI в своей базовой архитектуре обучения.
Разумеется, между этими двумя инцидентами существует фундаментальная разница в правовой законности и открытых лицензионных контрактах: обход ограничений скорости и условий обслуживания коммерческого API посредством нерегулярной массовой регистрации относится к серым зонам нарушения коммерческих соглашений. Тогда как Kimi K3 является моделью с открытыми весами, ее веса совершенно прозрачны для глобального открытого сообщества. Локальное развертывание и семплирование результатов вывода на собственном вычислительном кластере относится к очень обычной технической взаимодействия внутри открытой экосистемы.
Более глубокие перемены происходят в незаметной замене базовых технологических ниш. В волнах развития больших моделей за последние годы распространенным паттерном открытого сообщества и небольших стартапов было прямое скачивание открытых весов Llama от Meta или французской Mistral для последующей тонкой настройки, либо дистилляция специализированных маленьких моделей с использованием коммерческого вывода закрытых гигантов Кремниевой долины. И вот сегодня, китайские ведущие модели с открытыми весами, такие как Kimi K3, фактически вошли в число основных поставщиков ключевого корпуса для тренировок следующей флагманской базы первым рядам научных команд Кремниевой долины. Одновременно с этим базовая основа, которую вызывала TML в технических демонстрациях, также исходит от открытой архитектуры Qwen от Alibaba.
Анализ ротации экологических ниш и истинной сути догоняющей гонки между китайскими и американскими открытыми моделями
Однако при объективном рассмотрении, даже напрямую усвоив качественные траектории внешних эталонов, таких как Kimi K3, Inkling 2 Small сохраняет видимую невооруженным глазом техническую пропасть до трона глобального открытого сообщества.
В новейшем выпуске総合рейтинга открытых моделей весом, опубликованном Artificial Analysis (v5.0.1), Inkling 2 Small действительно уверенно опережает всех европейских и американских конкурентов благодаря результату бенчмарка в 31 балл. Following behind стоит Mistral Large 4 с результатом 26 баллов, а сконструированный усилиями Meta проект Muse Spark Open записывает лишь 25 баллов. Именно это стало причиной, по которой AA присвоила ей специфическое звание «модели с открытыми весами, показавшей самый высокий результат за пределами Китая».
Но стоит убрать приставку «за пределами Китая», как настоящий мировой пьедестал открытого весового трека по-прежнему полностью монополизирован китайскими моделями: Kimi K3.1 Pro от Moonshot AI лидирует с абсолютным преимуществом в 46 баллов, DeepSeek V4.1 Flash набирает 33 балла, GLM-5.3 от Zhipu AI получает 32 балла. Inkling 2 Small занимает лишь четвертое место в мире, следом за которым идут получившие 30 баллов Xiaomi MiMo-V2.6-Pro. Иными словами, этот флагманский «маленький стальной снаряд», тщательно отшлифованный американской командой, по факту догоняет и выравнивается со второй линией китайской открытой экосистемы — моделями для вывода класса Flash, оставляя до самых топовых флагманских версий Китая целые 15 баллов поколенийского разрыва.
Более реалистичный факт заключается в том, что в текущей точке времени он пока не считается полноценной открытой моделью с открытым исходным кодом. Согласно якобы «безопасному поэтапному плану открытости», утвержденному TML еще в июле, данная модель изначально предоставлялась в закрытой форме через API только в рамках внутреннего тестирования на собственной облачной платформе Tinker. Открытие весов модели возможно лишь после тщательного и полного завершения независимой оценки безопасности командой красных тестеров. Несмотря на обещание в техническом блоге о «планируемом полном выпуске всех весов для мирового открытого сообщества с лицензией Apache 2.0 на следующей неделе», AA на странице бенчмарков всё еще осторожно пометила дату фактического выпуска весов как «подтверждению не подлежит». Даст ли техническое экосистема окончательный ответ на следующей неделе, сможет ли этот открытый чек, несущий нарратив оценки в 40 миллиардов долларов, быть своевременно и полностью cashed out, зависит только от времени.
Ожесточенная борьба глобальных открытых и весовых моделей трансформируется в глубокую сложную цикличность, где «выводы топовых игроков взаимно поглощаются, а технологические траектории находятся в многостороннем обмене». Thinking Machines Lab своим откровенным техническим блогом, не скрывающим заимствования, полностью выставил на публику реальность такого технического возврата питаний и глобальной реконструкции ниш.
Ожидаемо, что по мере того как команда Мурати будет продолжать восхождение по своей своеобразной «лестнице моделей», выпуская более масштабную по количеству параметров и более продвинутую по способности вывода модель Inkling 2, технологическое противостояние и взаимное питание лабораторий ИИ высшей лиги Китая и США в открытой экосистеме неизбежно породят еще более глубокие отраслевые потрясения.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 极客公园