Личная история ключевого автора MoBA от Moonshot AI: трижды на «Скалу размышлений над ошибками» для «новенького тренера больших моделей»
Автор: Эндрю Лу, команда LatePost
Источник изображения: сгенерировано Wujie AI
18 февраля Kimi и DeepSeek в один день опубликовали новые разработки,分别是 MoBA и NSA, обе являются улучшениями “механизма внимания” (Attention Mechanism).
Сегодня один из основных разработчиков MoBA Эндрю Лу опубликовал пост на Zhihu, рассказав о трех ошибках в процессе разработки, которые он называет “трижды входил в Пещеру Размышлений”. Его подпись на Zhihu — “Новый тренер LLM”.
Один из комментариев под этим ответом гласит: “От открытых статей и открытого кода мы эволюционировали до открытых цепочек мыслей?”
Механизм внимания важен, потому что он является основным механизмом текущих больших языковых моделей (LLM). Возвращаясь к июню 2017 года, та статья восьми авторов Transformer, которая开启了 революцию LLM, называлась: Attention Is All You Need (Внимание — это все, что вам нужно), количество цитирований этой статьи на сегодняшний день достигло 153 000.
Механизм внимания позволяет моделям ИИ, как и людям, знать, на чем “сосредоточиться” и что “игнорировать” при обработке информации, улавливая наиболее ключевые части информации.
На этапах обучения и использования (инференса) больших моделей механизм внимания играет свою роль. Его примерный принцип работы заключается в том, что при вводе данных, например “Я люблю есть яблоки”, большая модель вычисляет отношения между каждым словом (Token) в предложении и другими словами, тем самым понимая семантику и другую информацию.
Когда контекст, который нужно обработать большой моделью, становится все длиннее,占用 вычислительных ресурсов Full Attention (полный механизм внимания), изначально используемый в стандартном Transformer, становится невыносимым, потому что исходный процесс требует вычисления баллов важности всех входных слов, а затем взвешенного вычисления для получения наиболее важных слов, его вычислительная сложность растет квадратично (нелинейно) с увеличением длины текста. Как написано в разделе “Аннотация” статьи MoBA:
“Квадратичное увеличение вычислительной сложности, присущее традиционным механизмам внимания,带来 неприемлемые вычислительные затраты.”
В то же время исследователи стремятся к тому, чтобы большие модели могли обрабатывать достаточно длинный контекст — много раундов диалога, сложные рассуждения, способности к памяти... Эти характеристики, которыми должен обладать AGI в этих设想, требуют все более и более длинных способностей контекста.
Как найти метод оптимизации механизма внимания, который не так占用 вычислительные ресурсы и память, но не теряет производительность модели, стал важной темой исследований больших моделей.
Это технический фон, на котором несколько компаний сосредоточили внимание на “внимании”.
Помимо DeepSeek NSA и Kimi MoBA, в середине января этого года другая китайская стартап-компория больших моделей MiniMax также масштабно реализовала новый механизм внимания в своей первой открытой модели MiniMax-01. Основатель MiniMax Янь Цзюньцзе тогда сказал нам, что это одна из главных инноваций MiniMax-01.
Команда соучредителя ModelBest, доцента кафедры компьютерных наук Университета Цинхуа Лю Чжиюаня, также опубликовала InfLLM в 2024 году, которая также включает улучшение稀疏 внимания, эта статья была цитирована в статье NSA.
В этих нескольких результатах механизмы внимания в NSA, MoBA, InfLLm относятся к “механизму稀疏 внимания” (Sparse Attention); а попытка MiniMax-01 в основном идет в другом направлении: “линейный механизм внимания” (Linear Attention).
Один из авторов SeerAttention, старший исследователь Microsoft Research Asia Цао Шидзе сказал нам: в целом, линейный механизм внимания вносит больше и более радикальных изменений в стандартный механизм внимания, пытаясь напрямую решить проблему квадратичного взрыва вычислительной сложности с увеличением длины текста (поэтому он нелинейный), возможная цена — потеря захвата сложных зависимостей длинного контекста; механизм稀疏 внимания использует присущую вниманию稀疏ность, пытаясь найти более надежный способ оптимизации.
Также рекомендуем высоко оцененный ответ учителя Цао Шидзе на Zhihu о механизме внимания: https://www.zhihu.com/people/cao-shi-jie-67/answers
(Он ответил на вопрос “Новая статья NSA о механизме внимания DeepSeek, опубликованная при участии Лян Вэньфэна, какая информация заслуживает внимания? Какие последствия это принесет?”.)
Соавтор MoA (Mixture of Sparse Attention), доктор лаборатории NICS-EFC Университета Цинхуа Фу Тянью сказал, в общем направлении механизма稀疏 внимания: “NSA и MoBA оба внедрили методы динамического внимания, то есть могут динамически выбирать блоки KV Cache, для которых нужно вычислять мелкозернистое внимание, по сравнению с некоторыми механизмами稀疏 внимания, использующими статические методы, это может повысить производительность модели. Эти два метода также внедрили稀疏 внимание во время обучения модели, а не только во время инференса, что также дополнительно повысило производительность модели.”
(Примечание: блоки KV Cache — это кэш для хранения ранее вычисленных меток Key и значений Value;其中 метки Key относятся к идентификаторам, используемым для обозначения характеристик данных или информации о позиции данных в вычислениях, связанных с механизмом внимания, чтобы можно было сопоставлять и связывать их с другими данными при вычислении весов внимания, значения Value соответствуют меткам Key и обычно содержат фактическое содержимое данных, которое нужно обработать, например семантические векторы слов или фраз и т.д.)
В то же время, на этот раз Moonshot AI не только опубликовала подробную техническую статью MoBA, но также опубликовала инженерный код MoBA на сайте проекта GitHub, этот набор кода используется онлайн в собственном продукте Moonshot AI Kimi уже более года.
* Ниже приведено сам повествование Эндрю Лу на Zhihu, получено разрешение автора. В оригинале есть много терминов ИИ, объяснения серым текстом в () являются примечаниями редактора. Ссылка на оригинальный пост: https://www.zhihu.com/people/deer-andrew
Рассказ Эндрю Лу о разработке
По приглашению учителя Чжан (доцент Университета Цинхуа Чжан Минсин), отвечу на предыдущие взлеты и падения в процессе создания MoBA, я в шутку называю это “трижды входил в Пещеру Размышлений”. (Эндрю Лу ответил на вопрос: “Как оценить открытую框架稀疏 внимания MoBA от Kimi? По сравнению с NSA от DeepSeek, какие亮点 у каждого?”)
Начало MoBA
Проект MoBA начался очень рано, в конце мая 2023 года, вскоре после создания Moonshot AI, в день поступления на работу меня забрал Тим (соучредитель Moonshot AI Чжоу Синьюй) в маленькую комнату, и вместе с учителем Цю (Цю Цзечжун из Университета Чжэцзян / Лаборатории Чжицзян,提出者 идеи MoBA) и Диланом (исследователь Moonshot AI) мы начали заниматься Long Context Training (обучение длинному контексту). Здесь首先要 поблагодарить Тима за терпение и наставничество, возлагая большие надежды на новичка LLM и желая воспитать, среди всех大佬, разрабатывающих различные онлайн-модели и технологии, связанные с моделями, многие, как и я,基本 начали接触 LLM с нуля.
Тогда общий уровень индустрии был не очень высоким, все занимались 4K预训练 (длина ввода-вывода, которую может обработать модель, составляет около 4000 Token, несколько тысяч китайских иероглифов), проект сначала назывался 16K on 16B,意思是进行 Pre-train (预训练) длины 16K на 16B (16 миллиардов параметров модели), конечно, позже очень быстро в августе это требование изменилось на необходимость поддержки Pre-train под 128K. Это также было первым требованием при дизайне MoBA, быстро обучить модель, поддерживающую длину 128K, From Scratch (с нуля), в это время еще не требовалось Continue Training (продолжение обучения, обучение на основе уже обученной модели).
Здесь также возникает интересный вопрос, в мае/июне 23 года индустрия в целом считала, что обучение длинных текстов端到端 (непосредственное обучение модели длинными текстами) дает лучший эффект, чем обучение более короткой модели, а затем попытка сделать ее длинной. Это понимание изменилось только во второй половине 23 года, когда появился long Llama (большая модель, разработанная Meta, поддерживающая обработку длинных текстов). Мы также провели строгую проверку, на самом деле обучение на коротких текстах + активация длины имеет лучшую token efficiency (увеличение объема эффективной информации, вносимой каждым token, означает, что модель может выполнять задачи более высокого качества с меньшим количеством token). Естественно, первая функция в дизайне MoBA стала слезой эпохи.
В этот период дизайн структуры MoBA был более “радикальным”, по сравнению с текущим “упрощенным” результатом, первоначально предложенный MoBA был последовательным方案 двухслойного механизма внимания с cross attention (механизм внимания, обрабатывающий отношения между двумя разными текстовыми данными), gate (контролирует, как входные данные распределяют веса между различными экспертными сетями) сам по себе был структурой без параметров (без параметров, не требует обучения данными), но для лучшего обучения исторических token, мы добавили cross attention между машинами и соответствующие параметры в каждом слое Transformer (может лучше запоминать историческую информацию). Дизайн MoBA в это время уже сочетал идею Context Parallel, известную всем позже (полная последовательность контекста хранится на разных узлах, собирается вместе только при необходимости вычислений), мы разложили всю последовательность контекста между узлами параллелизма данных, рассматривая context внутри каждого узла параллелизма данных как expert (эксперт) в MoE (Mixture of Experts, система смешения экспертов), отправляя token, нуждающиеся в attention, соответствующему expert для cross attention, а затем возвращая результат коммуникации. Мы интегрировали работу fastmoe (一种早期 MoE训练的框架) в Megatron-LM (текущая通用框架 обучения больших моделей от Nvidia) для поддержки способности коммуникации между expert.
Эту идею мы называем MoBA v0.5.
(Примечание редактора: Вдохновение для MoBA来自 текущей主流 структуры больших моделей MoE. MoE означает, что при работе большой модели каждый раз активируются параметры только части экспертов, а не всех, тем самым экономя вычислительную мощность; основная идея MoBA — “каждый раз смотреть только на наиболее релевантный контекст, а не на весь контекст, тем самым экономя вычисления и стоимость”.)
По мере продвижения времени к началу августа 23 года, основная модель Pre-Train уже обучила большое количество token, повторное обучение стоит немало. MoBA, значительно изменившая структуру и добавившая дополнительные параметры, впервые вошла в Пещеру Размышлений.
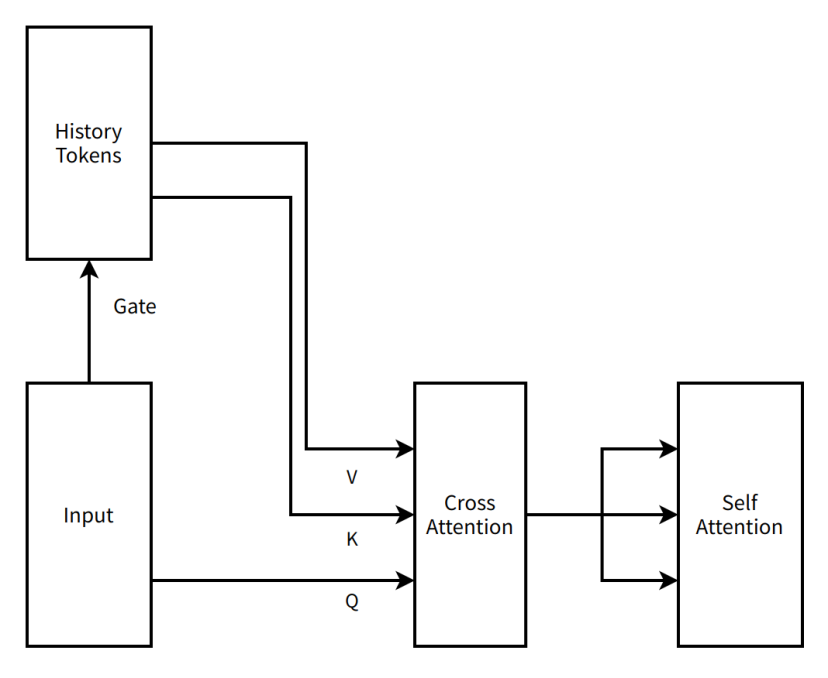
Очень простая схема MoBA v0.5
Примечание редактора:
History Tokens (исторические маркеры) — в сценариях, таких как обработка естественного языка, представляют собой набор ранее обработанных текстовых единиц.
Gate (ворота) — в нейронных сетях структура, используемая для контроля потока информации
Input (ввод) — данные или информация, получаемые моделью
V (Value) — в механизме внимания содержит фактическое содержимое данных, которое нужно обработать или на которое нужно обратить внимание, например семантические векторы и т.д.
K (метки Key) — в механизме внимания идентификаторы, используемые для обозначения характеристик данных или информации о позиции и т.д., чтобы можно было сопоставлять и связывать их с другими данными
Q (Query запрос) — в механизме внимания вектор, используемый для извлечения релевантной информации из пар ключ-значение
Cross Attention (перекрестное внимание) — вид механизма внимания, фокусирующийся на вводах из разных источников, например связывание ввода с исторической информацией
Self Attention (самовнимание) — вид механизма внимания, модель фокусируется на собственном вводе, улавливая зависимости внутри ввода
Первый вход в Пещеру Размышлений
Вход в Пещеру Размышлений, конечно, является шуткой, это время остановки для поиска улучшений, также время глубокого понимания новой структуры. Первое вход в Пещеру Размышлений для просветления, вошел быстро, вышел тоже быстро. Тим как король идей Moonshot AI вынул новую идею улучшения, изменив MoBA с последовательного двухслойного方案 внимания на параллельный однослойный方案 внимания. MoBA больше не добавляет дополнительных параметров модели, а использует существующие параметры механизма внимания, синхронно обучая всю информацию в последовательности, так можно максимально не менять текущую структуру для Continue Training.
Эту идею мы называем MoBA v1.
MoBA v1 фактически является продуктом Sparse Attention (稀疏 внимания) Context Parallel, в то время когда Context Parallel не был широко распространен, MoBA v1 продемонстрировал чрезвычайно высокие способности端到端 ускорения. После того как мы проверили его эффективность на 3B, 7B, мы врезались в стену на уровне масштаба больших моделей, в процессе обучения出现了 очень большой loss spike (аномальное явление, возникающее при обучении модели). Наш способ объединения block attention output (результат输出 после обработки данных модулем внимания) в первой версии был слишком поверхностным, просто простое суммирование, что привело к полной невозможности отладки по сравнению с Full Attention, отладка без ground truth (стандартный ответ, здесь指 результат Full Attention) чрезвычайно трудна, мы исчерпали все средства стабильности того времени, но не смогли решить. Из-за проблем с обучением на больших моделях, MoBA至此 второй раз вошел в Пещеру Размышлений.
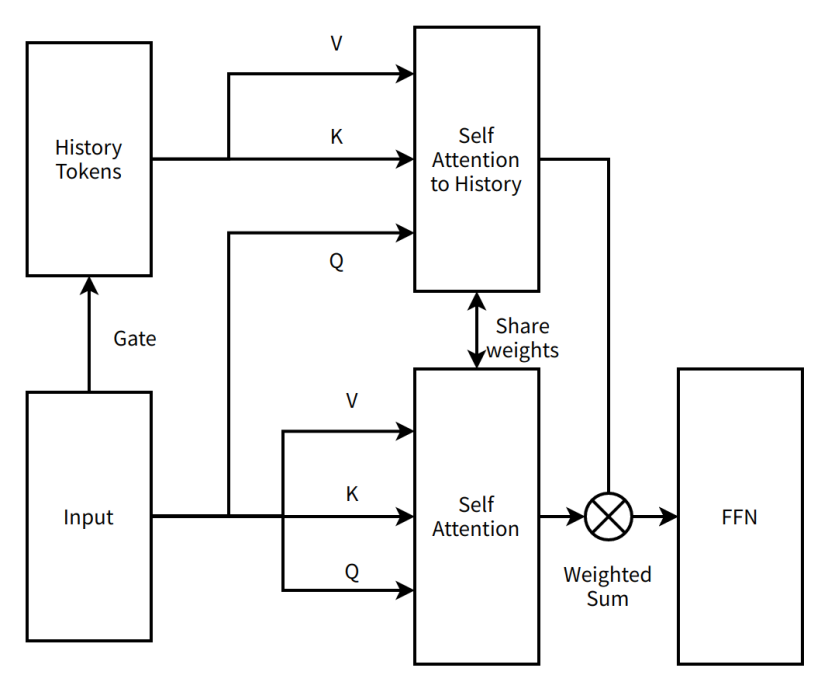
Очень простая схема MoBA v1
Примечание редактора:
Self Attention to History (самовнимание к истории) — вид механизма внимания, модель фокусируется на исторических маркерах, улавливая зависимости между текущим вводом и исторической информацией
Share weights (общие веса) — разные части в нейронной сети используют одинаковые параметры весов, чтобы уменьшить количество параметров и повысить способность обобщения модели
FFN (Feed - Forward Neural Network, прямая нейронная сеть) — базовая структура нейронной сети, данные текут в одном направлении от входного слоя через скрытый слой к выходному слою
Weighted Sum (взвешенная сумма) — операция суммирования нескольких значений согласно их respective весам
Второй вход в Пещеру Размышлений
Второй раз пребывание в Пещере Размышлений заняло больше времени, с сентября 23 года, до выхода из Пещеры Размышлений уже было начало 24 года. Но пребывание в Пещере Размышлений не означает, что нас бросили, я смог ощутить вторую особенность работы в Moonshot AI, насыщенное спасение.
Помимо Тима и учителя Цю, которые постоянно мощно输出, Су Шэнь (Су Цзяньлинь, исследователь Moonshot AI), брат Юань (Цзинъюань Лю, исследователь Moonshot AI) и各路大佬 участвовали в интенсивных обсуждениях, начали разбирать и исправлять MoBA,首先被 исправленным было то простое наложение Weighted Sum (взвешенной суммы). После того как мы здесь попробовали различные способы наложения умножения и сложения с Gate Matrix, Тим вынул из старых бумаг Online Softmax (не нужно видеть все данные для вычисления, а обрабатывать данные по мере поступления), сказал, что это должно сработать. Одним из最大的 преимуществ является то, что после использования Online Softmax мы можем строго сравнивать отладку с математически эквивалентным Full Attention, уменьшая稀疏ность до 0 (выбрать все блоки), это решило большинство проблем, encountered в реализации. Но дизайн разделения контекста между узлами параллелизма данных все еще приводил к проблеме дисбаланса, после того как один образец данных разложен между параллелизмом данных, первые несколько token на первом ранге параллелизма данных будут отправлены последующими многочисленными Q для attend (процесс вычисления внимания),带来 крайне плохой баланс,进而 замедляя эффективность ускорения. У этого явления есть более известное имя — Attention Sink (точка сбора внимания).
В это время посетил учитель Чжан, выслушав наши идеи, предложил новую мысль, разделить способности Context Parallel и MoBA. Context Parallel это Context Parallel, MoBA это MoBA, MoBA возвращается к самому Sparse Attention, а не к распределенной框架 обучения Sparse Attention. Пока видеопамять вмещает, можно полностью обрабатывать весь контекст на одной машине, используя MoBA для ускорения вычислений, организуя и передавая контекст между машинами способом Context Parallel. Поэтому мы заново реализовали MoBA v2,基本 уже является тем видом MoBA, который все видят сейчас.
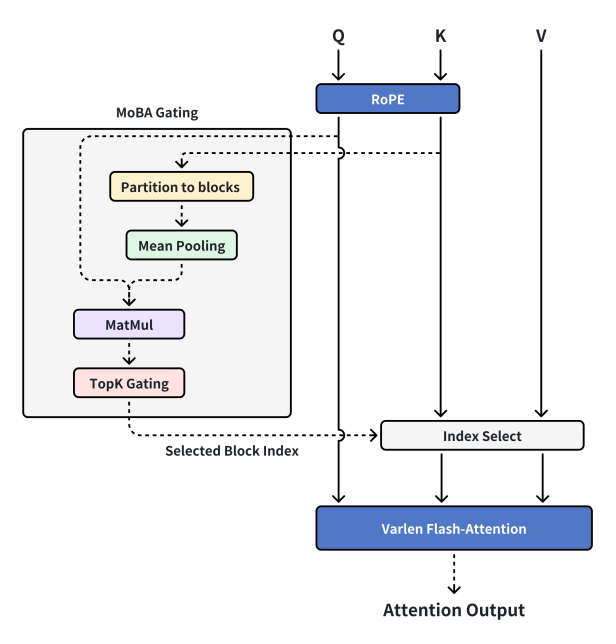
Текущий дизайн MoBA
Примечание редактора:
MoBA Gating (шлюз MoBA) — определенный механизм шлюза в MoBA
RoPE (Rotary Position Embedding вращаемое позиционное встраивание) — технология добавления информации о позиции для последовательности
Partition to blocks (разделение на блоки) — разделение данных на разные блоки
Mean Pooling (усреднение пулинга) — операция даунсэмплинга данных в глубоком обучении, вычисление среднего значения данных в области
MatMul (Matrix - Multiply умножение матриц) — математическая операция, используемая для вычисления произведения двух матриц
TopK Gating (шлюз Top - K) — механизм шлюза, выбирающий前 K важных элементов и т.д.
Selected Block Index (индекс выбранного блока) — обозначает номер выбранного блока
Index Select (выбор по индексу) — выбор соответствующих элементов из данных согласно индексу
Varlen Flash-Attention (быстрое внимание переменной длины) — вид механизма внимания, применимый к последовательностям переменной длины и具有 высокой вычислительной эффективностью
Attention Output (вывод внимания) — результат вычисления после механизма внимания
MoBA v2 стабилен и поддается обучению, короткий текст и Full Attention могут быть полностью выровнены, Scaling Law выглядит очень надежным, и довольно гладко поддерживает продвижение на онлайн-модели. Поэтому мы добавили больше ресурсов, после серии отладок и消耗 n волос товарищей из группы infra, мы можем сделать так, чтобы модель Pretrain, активированная MoBA, достигла полного зеленого цвета в тесте на вытаскивание иглы (стандарт в тесте способности больших моделей обрабатывать длинный текст), на этом этапе мы уже чувствовали, что это очень хорошо, начали выходить в онлайн.
Но как и ожидалось, случилось неожиданное. Часть данных на этапе SFT (监督微调, дальнейшее обучение модели на основе预训练 модели для конкретных задач, чтобы повысить производительность модели на этой задаче) несла очень稀疏的 loss mask (делает так, что только 1% или даже меньше token имеют градиент для обучения) (loss mask指 технология выбора, какие части участвуют в вычислении衡量 результата предсказания модели и стандартного ответа), это привело к тому, что MoBA表现 хорошо на большинстве задач SFT, но чем длиннее задача суммирования текста, тем более稀疏 loss mask, отражается в том, что эффективность обучения становится все ниже. MoBA была нажата пауза в процессе准 выхода в онлайн, третий раз вошла в Пещеру Размышлений.
Третий вход в Пещеру Размышлений
В третий раз вход в Пещеру Размышлений был самым напряженным, в это время весь проект уже имел огромные утопленные затраты, компания付出了 большое количество вычислительных ресурсов и человеческих ресурсов, если в конце концов в сценариях применения длинных текстов端到端 возникнут проблемы, то前期 исследования接近于打水漂. К счастью, из-за отличных математических свойств самого MoBA, в новых экспериментах аблации насыщенного спасения, мы обнаружили, что без loss mask表现 очень хорошо, с loss mask表现 не очень,进而 осознали, что token с gradient (градиент, в машинном обучении значение, используемое для обновления направления и шага параметров модели) на этапе SFT слишком稀疏,从而带来 проблему низкой эффективности обучения, поэтому путем изменения последних нескольких слоев на Full Attention, повысить плотность token с gradient при обратном распространении, улучшить эффективность обучения конкретных задач. Последующие другие эксперименты доказали, что это переключение не значительно влияет на эффект Sparse Attention при переключении обратно, на длине 1M (1 миллион) показатели равны Full attention той же структуры. MoBA снова вернулась из Пещеры Размышлений и успешно вышла в онлайн для обслуживания пользователей.
В конце концов, спасибо всем богам за помощь, спасибо компании за большую поддержку и огромное количество видеокарт. Теперь то, что мы открыли, это код, который мы используем в онлайн, это已经经过 долгосрочной проверки, из-за реальных потребностей отрезаны различные дополнительные дизайны, сохраняя极简 структуру, но одновременно具备 достаточного эффекта结构 Sparse Attention. Надеюсь, MoBA и рожденный им CoT (Chain of Thought, цепочка мыслей) принесет всем некоторую помощь и ценность.
FAQ
Пользуясь случаем, отвечу на некоторые вопросы, которые часто задавали в эти два дня, в эти два дня基本 беспокоили учителя Чжан и Су Шэня как службу поддержки для ответов на вопросы, действительно неудобно, здесь extracted несколько распространенных вопросов и отвечу вместе.
1. Неэффективен ли MoBA для Decoding (процесс генерации текста на этапе инференса модели)?
MoBA эффективен для Decoding, очень эффективен для MHA (Multi-Head Attention, многоголовое внимание), эффект снижается для GQA (Grouped Query Attention, групповое внимание запросов), худший эффект для MQA (Multi-Query Attention, многозапросное внимание). Принцип на самом деле очень прост, в случае MHA,每个 Q имеет свой соответствующий KV cache, тогда gate MoBA в идеальном случае может通过摊余计算 в prefill (этап вычислений при первой обработке ввода) вычислить и сохранить代表 token каждого block (блока данных), этот token не будет изменяться в последующем, поэтому все IO (операции ввода-вывода)基本 могут быть сделаны только из KV cache после index select (операция выбора данных по индексу), в этом случае稀疏程度 MoBA определяет степень уменьшения IO.
Но для GQA и MQA, поскольку группа Q Head на самом деле делит одну и ту же KV cache, то в случае, когда每个 Q Head может свободно выбирать感兴趣的 Block, очень возможно заполнить IO оптимизацию,带来的稀疏ностью. Например, мы думаем о таком сценарии: MQA с 16 Q Head, MoBA как раз делит всю последовательность на 16 частей, это означает, что в худшем случае每个 Q Head感兴趣分别是 контекстные блоки с номерами от 1 до 16, преимущество экономии IO будет сглажено. Чем больше Q Head, которые могут свободно выбирать KV Block, тем хуже эффект.
Из-за существования феномена “Q Head, свободно выбирающий KV Block”, естественная идея улучшения — объединение, предположим, что все выбирают одинаковый Block, то не будет ли чистой прибыли IO оптимизации. Да, но в наших фактических тестах, особенно для预训练 моделей, за которые уже заплачено большое количество затрат,每个 Q head имеет свой уникальный “вкус”, принудительное объединение хуже, чем переобучение с нуля.
2. По умолчанию MoBA обязательно выбирает self attention (механизм самовнимания), будут ли обязательно выбраны соседи self?
Не обязательно, это известное место, которое вызывает некоторые сомнения, мы в конце выбрали доверие SGD (Stochastic Gradient Descent, стохастический градиентный спуск). Текущая реализация gate MoBA очень directa, есть感兴趣的 товарищи могут просто изменить gate, чтобы обязательно выбрать предыдущий chunk (блок данных), но мы сами тестировали, что выгода от этого изменения比较 margin (выгода невелика).
3. Есть ли у MoBA реализация на Triton (框架 для написания высокопроизводительного кода GPU, разработан OpenAI)?
Мы реализовали версию,端到端 производительность увеличена на 10%+, но стоимость поддержания и跟随 основной линии реализации Triton довольно высока, поэтому после нескольких итераций мы временно приостановили дальнейшую оптимизацию.
* Адреса проектов нескольких результатов, упомянутых в начале статьи (страницы GitHub все содержат ссылки на техническую paper, страница GitHub для NSA от DeepSeek еще не上线):
Страница MoBA GitHub: https://github.com/MoonshotAI/MoBA
Техническая статья NSA: https://arxiv.org/abs/2502.11089
Страница MiniMax-01 GitHub: https://github.com/MiniMax-AI/MiniMax-01
Страница InfLLM GitHub: https://github.com/thunlp/InfLLM?tab=readme-ov-file
Страница SeerAttention GitHub: https://github.com/microsoft/SeerAttention
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News