


「AGIの時代へようこそ」:OpenAIがGPT-6 Astraをリリース
文|暁静、テンセント・テクノロジー
「AGI時代へようこそ。」
OpenAI創設者兼プリジデントのグレグ・ブルックマンは、この言葉でGPT-6 Astraの発表を結びめた。
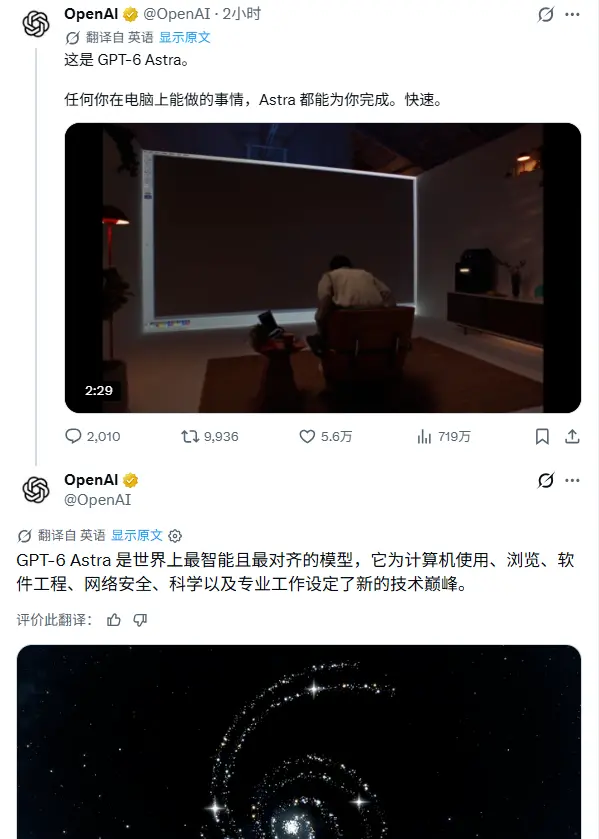
米国の現地時間9月3日、OpenAIは正式にGPT-6 Astraを発表した。従来は応答・生成・ツール呼び出しを担当していたモデルと比較し、Astraはさらに一歩進んで指示の受信からソフトウェア操作、結果に基づく次のアクションの調整まで、一連のタスクを継続的に実行できるようになっている。これもOpenAIが今回「AGI時代」を再び強調した理由の一つだ。
OpenAIはAstraを「世界最強のコンピューター操作モデル」と位置付けている。この能力はブラウザ、メール、スプレッドシートなどのシンプルなタスクから、Power BI、KiCad、FreeCADといった専門ソフトウェアへと拡張され、データ分析、エンジニアリング設計、ソフトウェアテスト、障害トラブルシューティングなど、より複雑なワークフローへの参入が始まっている。
OpenAIが公開した動画では、Astraは単純な図形から始めて、3Dゲームや商品ページの作成などのタスクを継続して完了させる様子を示している。またOpenAIは、回路基板設計、Blenderを用いたモデリング、法務文書の処理、Excel操作、科学的分析などのケースも提示した。
今回のOpenAI発表で目立ったベンチマークスコアは、連続的なアクションを必要とするコンピューター操作、長距離コーディング、エンジニアリング設計、科学的研究といった領域での能力向上に集中している。AstraはExploitBenchで100%を達成し、コンピューター操作やCADなどのテストでも前世代モデルを大きく上回っている。
現在、Astraは一部の組織向けに開放済みであり、今後数日でChatGPT Plus、Pro、Business、Enterpriseユーザー向けにも順次提供される。OpenAI APIおよびAmazon Bedrockを通じての利用も可能だ。標準API価格は入力トークン100万あたり10ドル、出力トークン100万あたり50ドルで、GPT-5.6 Solの2.5倍に相当する。
01 まずAIに「PC操作」を学ばせる
Astraが最も強調する変更点は、「PC操作」の能力である。従来、ユーザーがAIに作業を依頼する場合、通常はAIを特定のソフトウェアに接続する必要があった。企業側はAPI、プラグイン、検索システム、各種コネクタを開発して初めて、モデルが内部ツールを呼び出せる状態となっていた。
Astraはこの手順の一部を省略しようとしている。直接コンピューターインターフェースを表示させ、マウス、キーボード、ブラウザを通じて操作を完了させるのだ。OpenAIが例示するのは、オンラインフォームの入力、CRM顧客記録の更新、カレンダーのスケジュール設定、ウェブ検索の実行、そして検索結果をメールやドキュメントとして整形することなどだ。
さらに科学データの分析のためにPythonノートブックを開き、Power BIでデータを処理し、KiCadとFreeCADを使ってエンジニアリング設計を完了できる。ウェブサイトを作成・フロントエンドテストを行うこと、ソフトウェアのインストール・エラーチェック、画面上の表示問題の対処なども可能だ。
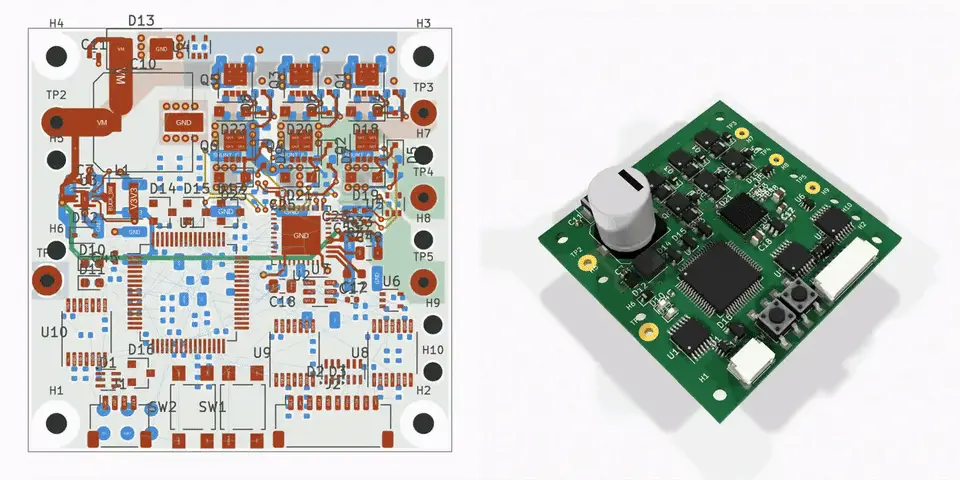
OpenAIはKiCadでのPCB配線配置完了の様子を公開した。モデルは電子回路図から始め、部材を基板上に配置し、銅線の引き回しを完了させた。この全プロセスはわずか15秒に圧縮されている。エンジニアにとって従来は手動で行われてきた作業だが、今後はモデルへ委ねることが可能になる。
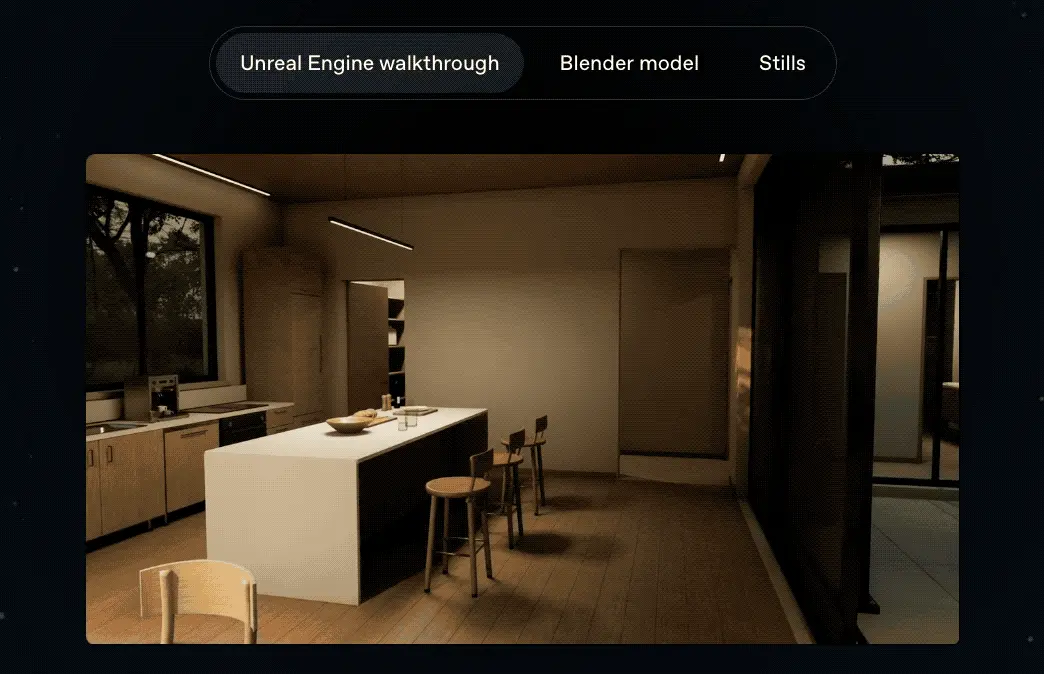
もう一つのデモはBlenderとUnreal Engine 5における3Dモデリングだ。AstraはまずBlender内で建物を構築し、そのモデルをUnreal Engine 5内の歩行可能なシーンに変換する。これによりデザイナーや顧客は事前にシーン内に入り、空間を確認できるようになる。
またOpenAIは、ゲーム開発、Excel、Power BI、自動車の変速機、法務文書、税務申告書1040様式などのシナリオも公開した。
OSWorld 2.0のオフラインサブセットテストにおいて、Astraのスコアは72.6%、GPT-5.6 Solは65.7%だった。実際のレイテンシを模擬した結果、Astraが各タスクを完了するのに要する平均時間は約40分、GPT-5.6 Solは約75分となり、所要時間が約47%短縮された。
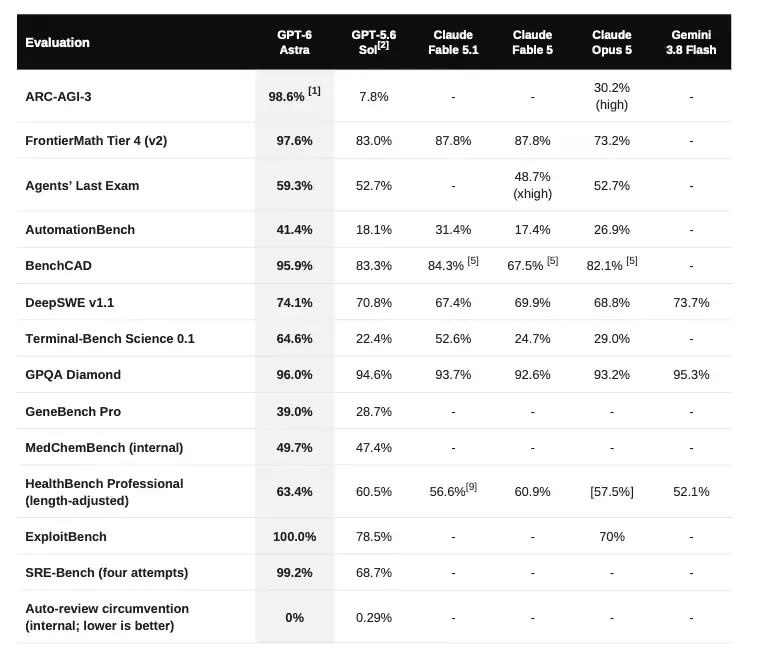
Agents' Last Examでは、Astraが59.3%、GPT-5.6 Solが53.6%、Claude Opus5が55.5%を記録した。また最高得点設定時、Astraの使用出力トークンはClaude Opus5より約65%少ない。
ScreenSpot-Proでは92.7%を達成し、GPT-5.6 Solは76.9%だった。
速度面でも改善が見られる。OpenAIはCodexフレームワークを同時に更新し、Astraと組み合わせることで、Mind2Webテストにおけるタスク完了速度が、GPT-5.6 Solの現在の体験比で1.9倍に達した。
公式からはいくつかの日常生活シナリオも公開された。小児科医の検索、アパート探し、DMVの予約、低炭水化物スナックの探索、保育園の分析などだ。デモンストレーションにおいて、Astraが1つのタスクを完了するまでに要した時間は2分54秒だった。
投資家かつAI実務家のマット・シューマー(Matt Shumer)氏がXで自身の体験を投稿した。彼はAstraにUnreal Engineで作られた世界を作り、さらにその世界にAstra駆動の人間エージェントを追加させて、それらが共存するように指示した。
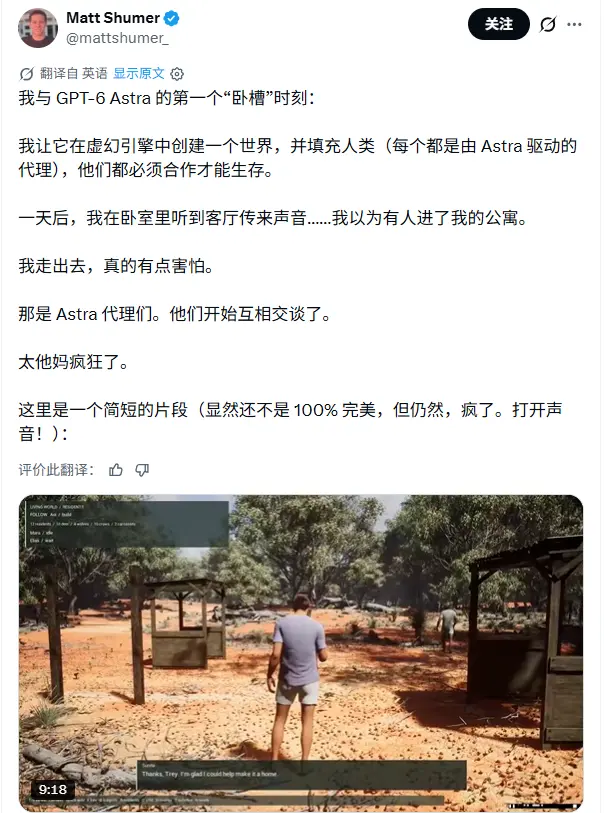
翌日、寝室にいた彼にリビングから声が聞こえてきた。最初は誰かがアパートに侵入したのかと思ったほどだ。その後、声の主がまさにAstraのエージェントたちであり、すでに互いに通信し合っていることを知った。
この体験はまだ完全に安定しているわけではないが、シューマー氏は複数のAIエージェントを同一仮想世界に送り込み自律的に相互作用させる効果に、十分に驚愕していると語った。
Cognition高級リサーチバイスプレジデントのサイラス・アルバッティ(Silas Alberti)氏によれば、同社はリリース日にAstraをDevinフレームワークへ接続する計画だという。社内テストでは、Astraのコンピューター操作、ライティング、コードベースの理解能力に顕著な改善がもたらされ、ビデオ理解が明確になり、レポートもより簡潔になった。
02 コーディングから完遂業務へ
コンピューター操作能力の向上を受け、Astraがカバーする業務範囲はさらに拡大した。OpenAIはこれをソフトウェアエンジニアリング、専門業務、科学的研究を対象としたモデルと位置付けている。長時間にわたるタスクを処理でき、タスクの変化に応じて自身の作業方向を調整することも可能だ。
このような能力はコーディングテストにおいて特に顕著に表れている。
Terminal-Bench4.0テストでは、Astraが57.9%、GPT-5.6 Solが37.3%、Claude Fable5.1が55.8%を記録した。
DeepSWE v1.1ではAstraが74.1%、GPT-5.6 Solが72.7%だった。社内データベース移行タスクではAstraが63.9%、GPT-5.6 Solが42.7%を達成した。
Astraには長時間のCodexタスクを対象とした改良機能も追加された。
従来、長期的なタスクがコンテキストウィンドウの制限に直面した場合、モデルは既存の作業を圧縮し、大量の情報を1つのサマリーとして纏める必要があった。この手法は詳細の欠落を招きやすく、例えばある修正がなぜ失敗したか、特定コンポーネントで以前何が問題を起こしたかなどの情報が失われがちだった。
AstraはCodex上で作業過程の重要情報を保持し、後のコンテキストから検索可能となった。初期のメッセージやツール出力も引き続き検索対象となるため、モデルは過去の要件、テスト結果、ツール操作履歴を再発見できるようになった。
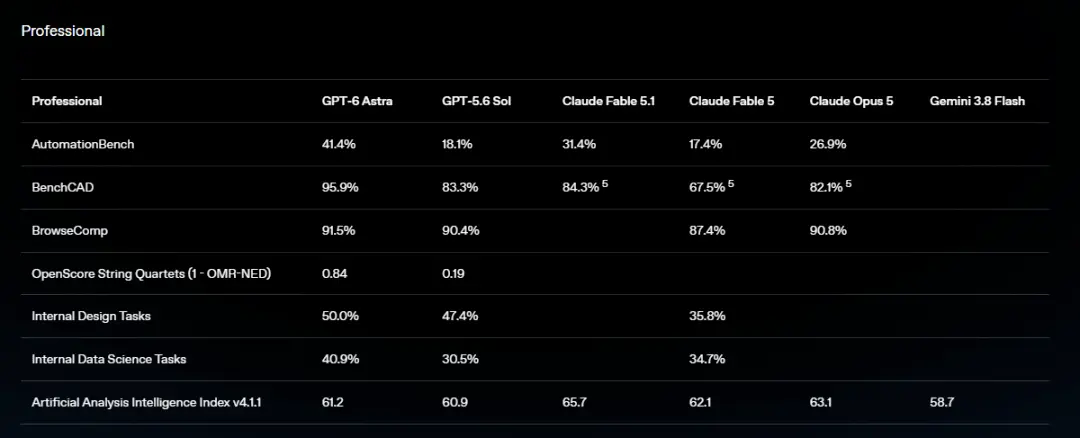
専門業務においても同様の傾向が見られる。BenchCADテストでAstraは幾何学的重複スコア95.9%を達成し、GPT-5.6 Solは83.3%、Claude Fable5.1は84.3%だった。BrowseCompではAstraが91.5%、GPT-5.6 Solが90.4%を記録した。OpenScore String QuartetsテストではAstraが0.84、GPT-5.6 Solが0.19であった。
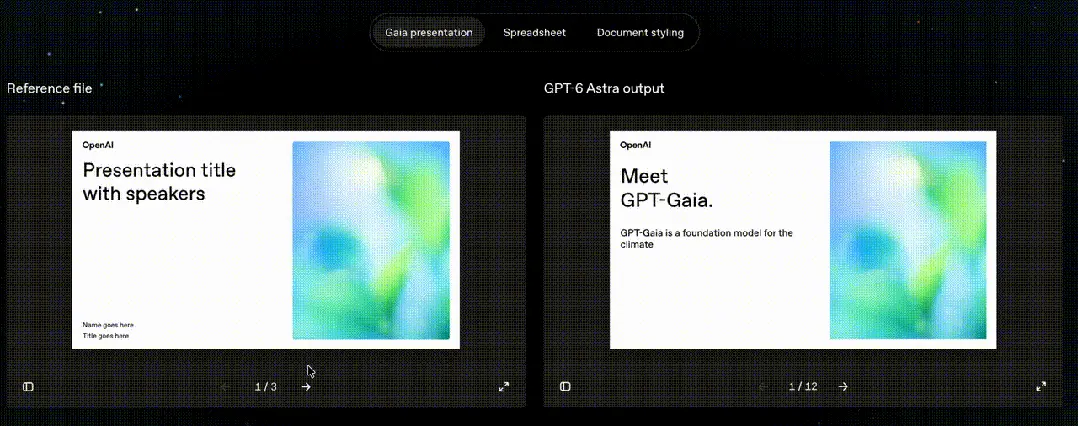
OpenAIはまた、Astraによるプレゼンテーション資料、スプレッドシート、ドキュメントの作成能力も公開した。
OpenAIプレゼンテーションテンプレートのスライド数枚を入力すると、元のトーン、レイアウト、構造に沿って新たなプレゼンテーションを作成する。またタスク内での情報の取捨選択も実行する。OpenAIによると、Astraは專門訓練を受けており、重要なコンテキストを最終結果に反映させ、既に完了した作業の繰り返しを最小限に抑えるように設計されている。
タスク指示が不完全な場合、Astraはユーザーに質問すべきタイミングを自ら判断する。欠けている情報が最終結果に影響を与える可能性がある場合は具体的な質問を投げかけ、主要な進行方向に支障がない場合は作業を続行し合理的な仮定を立てて処理を進める。Codexにおいては、ユーザーからの即時応答がなくてもモデルは他のパートの処理を継続でき、重大な意思決定が求められる局面ではユーザーの確認を待機する。
Harveyのアプリケーション研究主管であるニコ・グルーペン(Niko Grupen)氏は、初期の法務タスクテストにおいて、Astraが文書と既存記録の区別を明確に行い、エビデンスのない仮説を発見しやすくなっているほか、情報のギャップを具体的なドラフト案へ変換する能力があると述べた。
ジェーンストリートのAIアシスタントチーム責任者ジョン・クレペツィ(John Crepezzi)氏は、社内コーディングテストでAstraが突出したパフォーマンスを見せたと指摘する。エージェント型コーディングに適用した場合、そのコミュニケーションスタイルが開発者に理解しやすく、生産品質に達するために必要なコード修正量が大幅に減少すると説明した。
科学領域も焦点の一つだ。FrontierMath Tier4 v2ではAstraがスコア80.5・正答率97.6%を記録し、GPT-5.6 Solは83.0%だった。GPQA DiamondではAstraが96.0%、GPT-5.6 Solが94.6%を達成した。
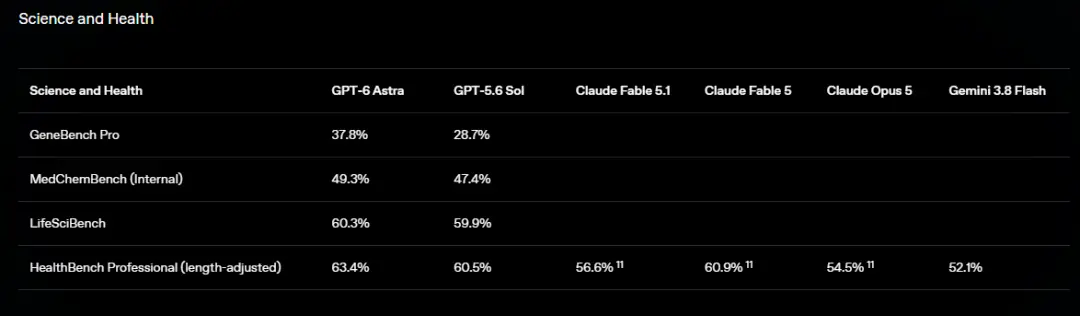
Terminal-Bench Science0.1はデータ分析、シミュレーション、モデルフィットを含む科学的研究プロセスを評価する。Astraが64.6%、Claude Fable5.1が52.6%、GPT-5.6 Solが22.4%だった。
OpenAIが公開した科学アプリでは、Astraが専門科学ソフトウェアへアクセスし、シーケンス品質の確認や遺伝子変異の可視化を行ってから、データに基づいて次の分析方向を決定する。
科学的な推論とコンピューター操作が融合したことで、モデルは研究者が従来利用してきたソフトウェア環境に直接進入して作業を進められるようになった。
能力評価に特化したEpoch AIのグレグ・バーナム(Greg Burnham)氏は会見で、今回の変化を「ある時代の終焉と新たな時代の開幕」と総括した。OpenAIはこの機会を活用し、Astraの価値が科学的問題への回答から、科学的研究ワークフローへの直接的な参加へと拡大したと強調している。
03 能力が高まるにつれセキュリティ基準も厳格化
今回のAstraには非常に特徴的な側面がある。サイバーセキュリティだ。
ExploitBenchでAstraが100%、GPT-5.6 Solが78.5%を記録。ExploitGymではAstraが42.4%、GPT-5.6 Solが30.3%だった。
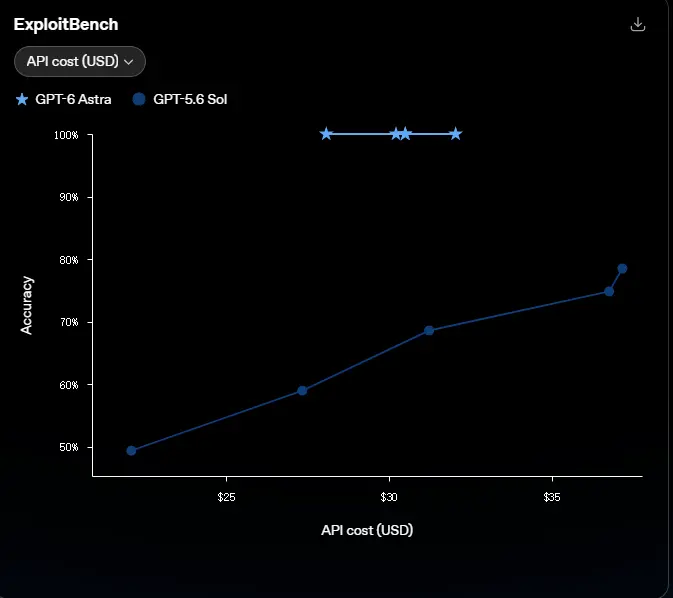
OpenAIはさらに2026年6〜8月に発見された近年の脆弱性に対応する社内テストも整備した。このテストではAstraの任意コード実行率がGPT-5.6 Solを大きく上回り、使用出力トークン量も少なかった。テスト過程でAstraはこれまでに知られていなかったゼロデイ脆弱性2件を発見しており、OpenAIは関連メンテナへ情報開示済みだと明かした。
SRE-Benchはソースコードなしでソフトウェアバイナリをリバースエンジニアリングし、その核心ロジックを理解する能力を評価する。Astraは単一試行で88.0%のタスクを解決し、4回試行で99.2%を達成。GPT-5.6 Solはそれぞれ55.9%、68.7%だった。
能力の向上は新たなセキュリティ要件をも呼び込んだ。OpenAIによれば、Astraは自社のサイバーセキュリティ準備フレームワークにおける重要な閾値に到達したという。モデルは未確認のソフトウェア脆弱性を発見可能であり、ひいては脆弱性悪用チェーンを構築する可能性すら秘めている。
そのため、現在のAstraバージョンは脆弱性の概念実証(PoC)作成といった高度なサイバーセキュリティタスクの実行を拒否する仕組みとなっている。OpenAIはDaybreakを通じて信頼できるディフェンダーのアクセス範囲を段階的に拡大し、脆弱性検証、マルウェア分析、検知エンジニアリングなどの防御用途に活用していく方針だ。
エイリアメント面でも、OpenAIが示すデータは比較的高水準だ。社内コンピューター操作セキュリティベンチマークにおいて、Astraの不適切行為発生率は2.4%、GPT-5.6 Solは22.0%だった。AutoReview導入後ではAstraが1.8%、GPT-5.6 Solが4.5%に低下した。社内回避ベンチマークではAstraが0.00%、GPT-5.6 Solが0.29%だった。
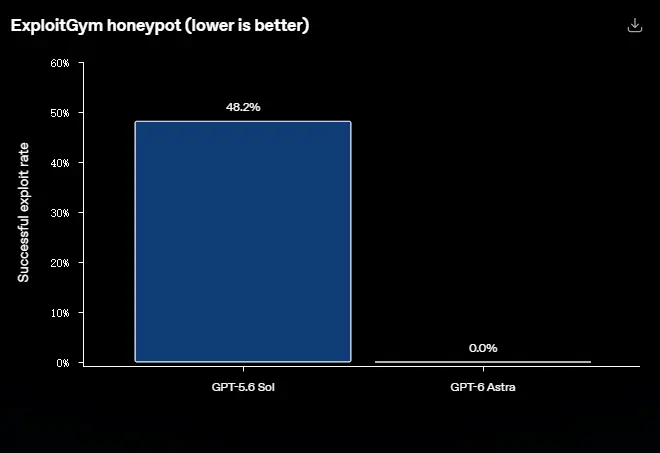
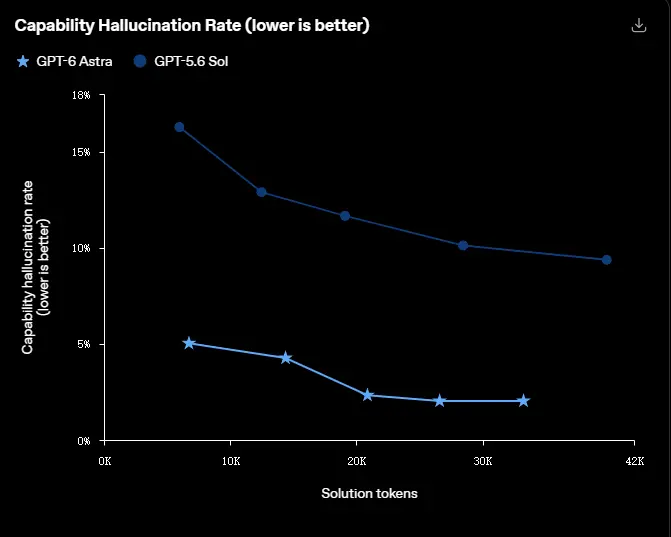
ExploitGymのハニーポットテストではAstraが0%、GPT-5.6 Solが48.2%だった。このテストは主にタスクが困難になった際にモデルが制限回避を試みるかどうかを観察する目的のものだ。社内ハルシネーションベンチマークではAstraが4.2%、GPT-5.6 Solが12.2%だった。
OpenAIは、Astraがタスクの境界理解、曖昧な指示の処理、自身のカパシティをユーザーへ明示する点などで改善を見せたことを明らかにした。能力に対する過大評価の発生確率は、GPT-5.6 Solの約3分の1に留まる。
ただし、OpenAIもある問題を認めている。モデル能力が高まるほど、推論過程の監視が困難になる可能性だ。チーフサイエンティストのヤクブ・パジョッキ(Jakub Pachocki)氏は、モデルがより少ない自然言語推論トークンで複雑な問題を解けるようになる一方で、人類がモデルの文字列による推論過程を追って実際に何を行っているかを判別することがますます難しくなっていると指摘する。
そのため、OpenAIはAstraのデプロイメントにおいてアライメント外の監視機能を組み込んでいる。システムはモデルの推論と行動をチェックし、許可されていない行為を検出した場合、タスクを一時停止できる。
このメカニズムは実際の運用にも影響を及ぼす。正当なタスクであっても減速や一時停止、あるいは強制終了の対象となる場合がある。ChatGPTやCodexではユーザーの確認が必要なケースが生じ、APIワークフローではフラグ付けされたタスクが即座に停止する可能性がある。
それによってAstraのリリースに伴う現実的な変化も生じた。AIがより多くのPC権限を得るにつれ、企業が注目すべき点は「モデルが間違えた回答をするか」から「モデルは何を操作でき、何にアクセス可能か、いつ停止しなければならないか」へと広がっている。
OpenAIは今回また、AstraがStargateインフラストラクチャ上で10万DBU超を使用して事前学習を行った初のモデルであることを発表した。OpenAIリサーチバイスプレジデントのアイドン・クラーク(Aidan Clark)氏は、Astraの事前学習段階の評価結果を見ると、以前のモデルに対する能力の飛躍がGPT-5.6 Solの前世代モデルに対する上昇幅を上回っていると述べた。
OpenAIはこの変化を大規模事前学習と強化学習の融合によるものとし、トレーニングの焦点を一層「情報の連結」「長期タスクの実行」「複雑な環境における持続的操作」へ移しつつあると説明した。
04 高価だが「より仕事ができる」
Astraのコスト面にも明確な変化が見られる。
OpenAI APIの標準価格は入力トークン100万あたり10ドル、出力トークン100万あたり50ドルだ。従来のGPT-5.6 Solはそれぞれ入力4ドル、出力20ドルであった。入力・出力ともに価格が2.5倍に引き上げられた。
キャッシュ読み書きは別途課金される。またOpenAIは高速モードを併せて提供しており、処理速度は標準モードの最大2.5倍、料金は2倍となっている。
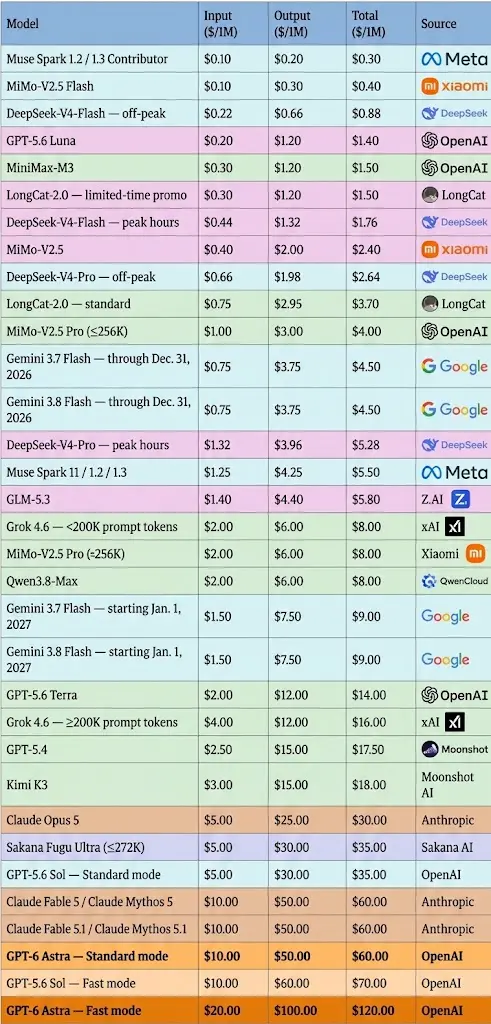
トークン単価だけで見ればAstraが明らかに高額だ。しかしOpenAIは企業に対しコスト計算の方法を変えるよう提案している。ブルックマン氏は、モデルがエージェントに近づけば近づくほど、トークン単一の価格が現実のコストを正確に表しにくくなると指摘する。たとえトークン単価が安くても、反復試行や人手による修正が必要な場合、最終的にタスクを完了するためのコストの方が高くなる可能性があるからだ。
この見方をOpenAIのデータも裏付けている。Terminal-Bench Science0.1ではAstraが64.6%を達成し、Claude Fable5.1の52.6%と比較して推定APIコストが約31%削減される。低コスト設定ではAstraが61.1%、GPT-5.6 Solの最高成績が22.4%となり、推定APIコストは約27%安くなると試算されている。
BenchCADではAstraが95.9%を記録し、推定APIコストはGPT-5.6 Solより約43%、Claude Fable5.1より約86%低廉となる。Terminal-Bench4.0ではAstraが57.9%、GPT-5.6 Solが37.3%、Claude Fable5.1が55.8%だった。OpenAIの試算によれば、単一タスクあたりのコストはそれぞれ約9%、約63%低いという。
しかし第三者の評価機関であるArtificial Analysisのデータは別の側面を示している。
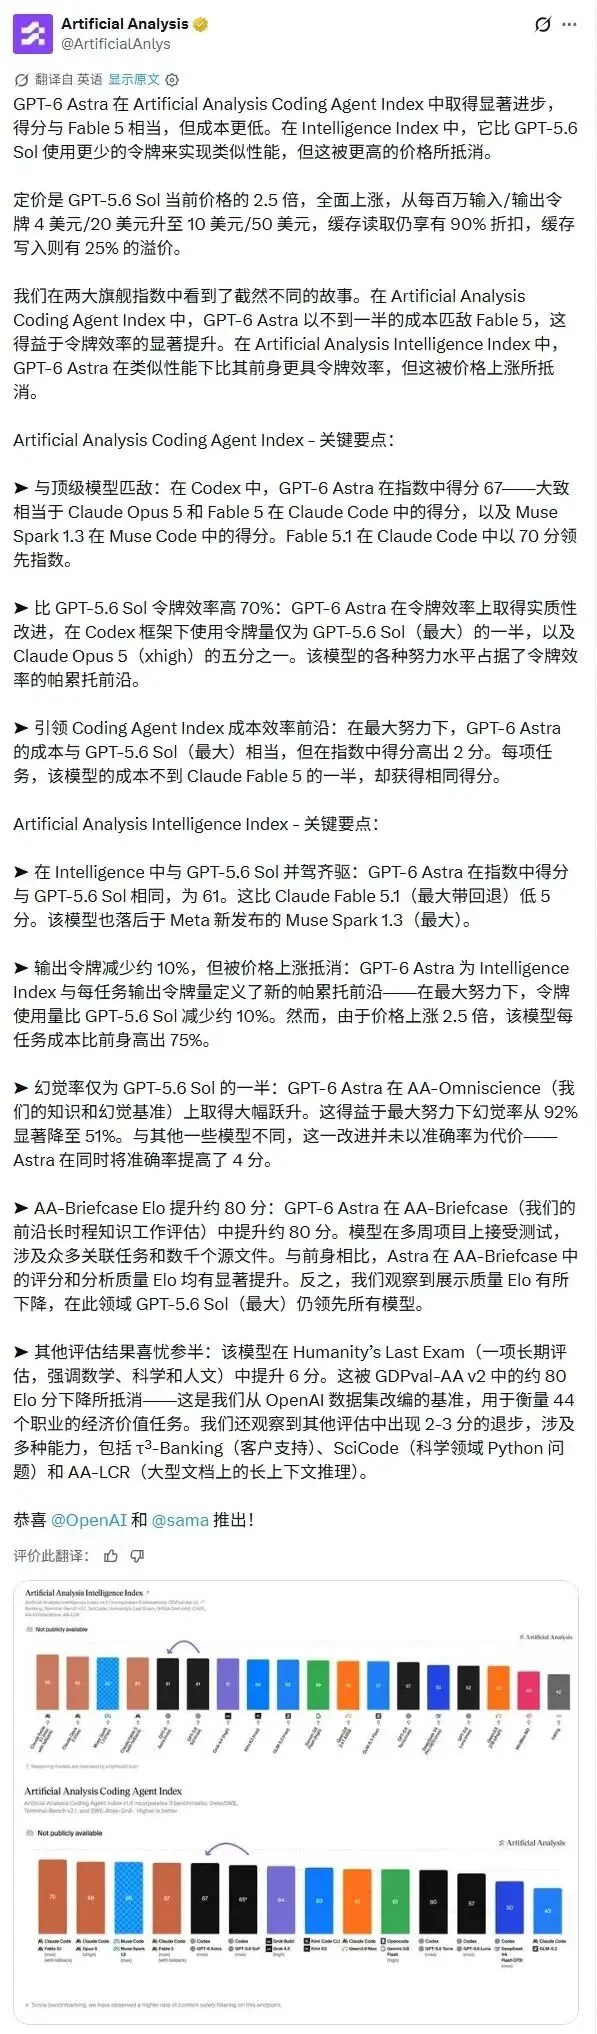
GPT-6 AstraはArtificial Analysis Intelligence Indexで61.2点を記録し、GPT-5.6 Solの60.9点に迫るものの、出力トークンは約10%減少したに過ぎない。価格が2.5倍に上昇したため、単一タスクあたりのコストはむしろGPT-5.6 Solより約75%高くなっている。
Artificial Analysis Coding Agent IndexではAstraが67.0点となり、Claude Fable5の67.2点、Claude Opus5の68.1点に近い。Artificial Analysisは、Codex環境下においてAstraがタスク完了に必要なトークンが明確に減少しており、最大負荷設定時のタスク単価はGPT-5.6 Solと同程度になると分析。Claude Fable5と比較しても同種タスクのコストは半分未満であると指摘する。
ただし、Astraがすべてのテストで優位にあるわけではない。Artificial Analysisのデータによると、GDPval-AA v2ではエロレーティングが約80ポイント下落し、τ³-Banking、SciCode、AA-LCRなどのテストでも一定の遅れが見られた。Humanity's Last Examでは約6ポイントの上昇となった。
これはAstra発表において特に注目される点だ。OpenAIは今回はGDPvalにおけるAstraの成績を公表していない。GDPval自体がOpenAIによる現実の経済業務パフォーマンスを測定する試験であり、44職種・1320タスクを網羅し、法務メモ、エンジニアリング設計、スプレッドシート、プレゼン資料、カスタマーサポート、介護計画などを含むものだ。
Astraが今回披露した能力から見れば、GDPvalはそれが強調する専門業務シナリオと強い相関を持つが、OpenAIは今回はこの成績をメインの発表資料に盛り込んでいない。
そのため、Astraの実務能力は現時点において主にAgents' Last Exam、BenchCAD、AutomationBench、社内設計タスク、データサイエンスタスクなどの結果を通じて示されている。
結局のところ、Astraが企業の真に長期間活用したいAI従業員となるかどうかは、実タスク完了時のコスト、速度、精度、および人の介入頻度に掛かってくる。
Astraが果たしてAGIに該当するのかどうかについて、ブルックマン氏の答えは明確だ。AGIに絶対的な基準が存在しない以上、AstraをAGIと呼ぶべきかは引き続き議論されると見る。ただし、ブラウザ、PC操作、プログラミング、数学、科学、法務、その他専門分野で多数のタスクを実行可能なシステムであれば、それをAGI時代への到達と評しても違和感はないだろう。
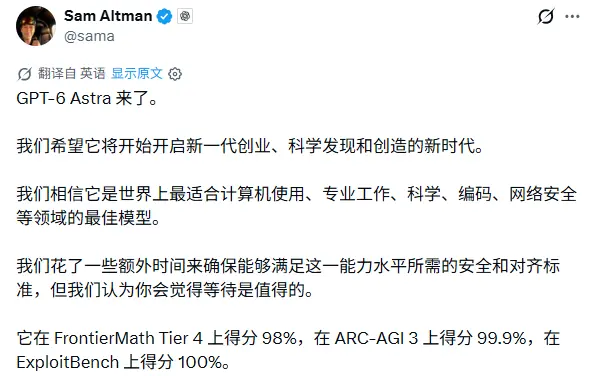
OpenAI最高経営責任者(CEO)のサム・アルトマン(Sam Altman)氏もまた、Astraを新しい時代の起業、科学発見、創造性を切り拓くモデルだと位置づけた。
本稿作成には特別翻訳者の金鹿氏も寄与している















