ベンチマークスコアは急上昇、実測では大失败。最新公開のGPT-6.2が露見させたOpenAIの弱点
筆者:Technoの王、ギークパーク
ペーパー上のスコアと実際の使い勝手の乖離が、今日に至って頂点に達した。
「基本的に使えない、お勧めしない」。
OpenAIの新型モデルが公開されてからわずか8分、シリコンバレーで有名な起業家マット・シューマーがSNS上で容赦ない評を投げかけた。
次に、多くの開発者に支持されるテオ・ブラウンが長編記事『なぜ私はGPT-6.2 Astraが嫌いか』を掲載した。最先端モデルに対して常に穏やかで忍耐深いペンシルベニア大学ウォートン校のイーサン・モリック教授もテスト後に珍しく厳格な評価を下し、「非常に不安定で奇妙だ」と述べ、これは「GPT-4.5以降、OpenAIのフライトリリースで初めて明確な進展が見られないもの」と直言した。
これは本来なら、OpenAIによる見事な反撃戦となるはずだった。
北京時間11月18日未明、OpenAIは新一世代のフラグシップ「GPT-6.2 Astra」と日頃の中核モデル「GPT-6.2 Sol」を正式に発売した。公式はAstraのAPI単価を直接20%削減し、エージェントから科研まで全方位で記録を更新する成績表を提示した。
ペーパー上のスコア上昇が一线の開発者たちからの集団的な不満と衝突したとき、この極度な亀裂感はまさに現在OpenAIが直面している最も現実的な行き詰まりを明らかにしている。
数値操作と計算コストの隠れ罠
公式ポスターやサードパーティ総合ランキングの上位データを単に見れば、GPT-6.2の二つのモデルは確かに実力があると言える。
両モデルとも105万コンテキストウィンドウを搭載し、入力最大92.2万トークン、出力最大12.8万トークンに対応。現時点ではテキストと画像の入力、純粋なテキスト出力のみをサポートし、音声・映像の入力やファインチューニングは非対応だ。価格面では、9月初旬のGPT-6 Astraを引き継ぐ新版フラッグシップは入力100万あたり8ドル、出力40ドルに設定され、キャッシュされた入力は60%引き下げられ0.40ドルとなった。9月のDevDay版を引き継ぐGPT-6.2 Solは入力を2ドル、出力を10ドルのまま維持している。
Artificial Analysisのv5.0.1総合指数ランキングでは、GPT-6.2 Astraが62点で総計2位に急浮上し、65点のClaude Fable 5.2に次ぎ、60点のGemini 4 Carbonや59点のClaude Opus 5.5を抑えた。
さらに魅力的なのはタスク単位の費用で、Astraの平均コストはわずか4ドルであり、Fable 5.2の26.54ドルという高コストの15%に過ぎない。57点を獲得したSolはタスク単位で1.01ドルしか要さず、パレート前沿散布図において安価高性能ゾーンとして確固たる左上隅へ落ち着いた。
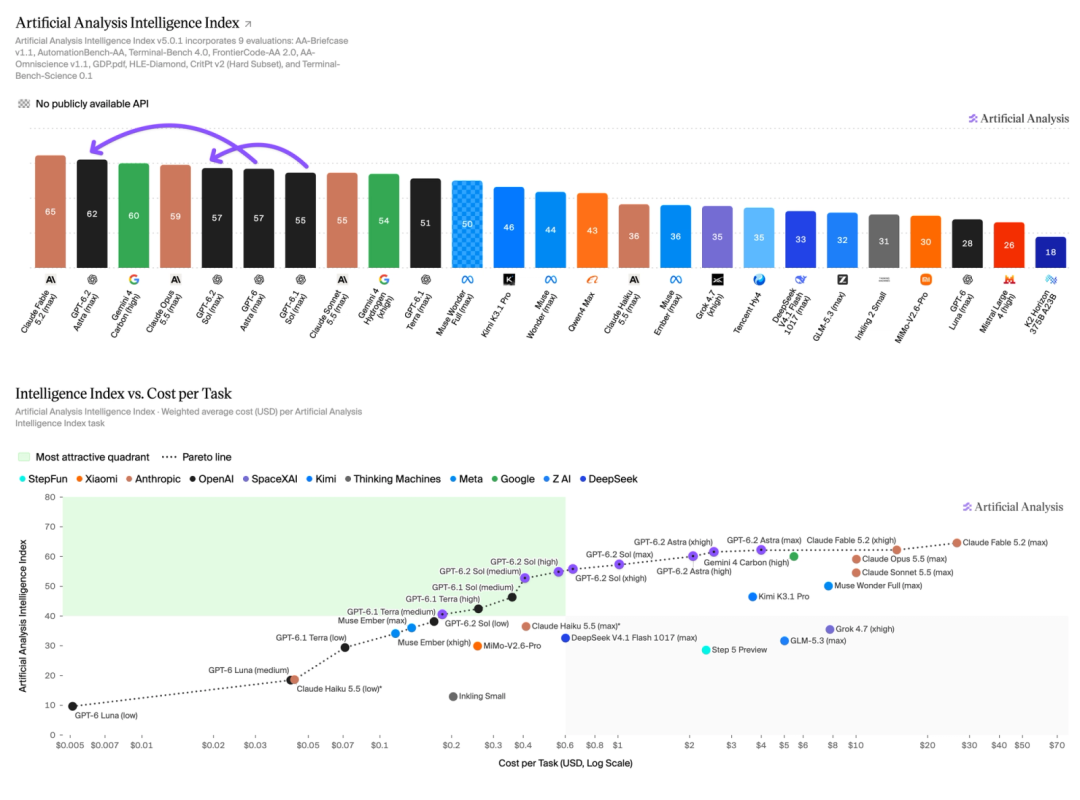
図:Artificial Analysis Intelligence Index v5.0.1 総合得点ランキングとタスク単位コストのパレート前沿比較|画像提供元:Artificial Analysis
しかしオフィシャルブログを下にスクロールし、極めて小さなフォントサイズの脚注を注意深く読み込むと、雰囲気は一変し始める。
'Agents' Last Exam'テストにおいて、OpenAIはAstraが最高78.3%(XHigh設定、Max設定では77.6%)という成績を残したと大々的に発表し、Fable 5.2の72.8%を大幅に引き離した。しかし脚注にはこっそりと、「この比較ではFable 5.2がバックアップモデルを使用した9つのタスクを除いている」と記載されている。より巧妙なのが、公式に掲載された画像にてGoogleのGemini 4 Carbonが高推論モードで77.4%を獲得し、タスク単位の費用が4.60ドルでAstraの4.47ドルとほぼ同等であるにもかかわらず、公式本文はこの競合相手に一言も触れていないことだ。
スコア測定基準の巧妙な選別に加え、API価格表には二つの隠れた地雷が仕掛けられている。
単一入力リクエストが27.2万トークンを超過すると、請求全体の入力およびキャッシュ単価が倍増し、出力単価は1.5倍となり、Astraは直接的に16ドルと60ドルに値上げされる。同時に、米国地域限定データ滞在で最高4.5倍高速化のUltrafastモードは現時点で3倍割引だが、2027年3月1日以降は6倍に倍増し、その時点でAstraの入力・出力価格は48ドルと240ドルへと変更される。
プログラマの日々を決定する専門ランキングに視線を移すと、弱点がより完全に露呈する。
Artificial Analysisのプログラミングエージェントランキングにおいて、GPT-6.2 Astraは53点で停滞し前世代と同点だったが、58点のClaude Fable 5.2及びOpus 5.5、55点のGemini 4 Carbonに遅れをとった。日常的な利用量を見据えたSolはさらに3点減点して49点となり、オープンソースのKimi K3.1 Proと同点の位置まで落ち込み、特にコードベースQA項目で14点大きく減点、重要な事実を見落としやすい傾向がある。
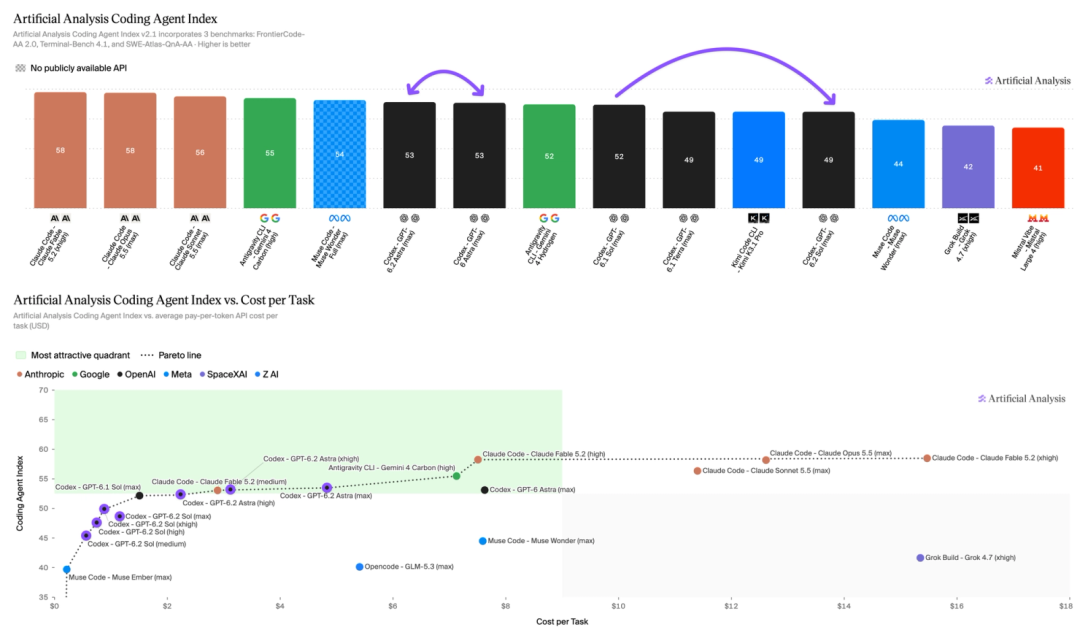
図:Artificial Analysis Coding Agent Index v2.1 比較:Astraは53点で足踏み、Solは前世代より3点減|画像提供元:Artificial Analysis
別の権威ある機関Epoch AIのテストでは、AstraがErdősの最先端数学問題68問中7問を解決し以前の3問という記録を更新したものの、報告書は依然として実際の科研自動化タスクにおいて前世代と比較して明確な進展がなく、過度に保守的だと批判した。Vals総合ランキングではAstraは僅か7位、通常版は法廷検索でなんと30位まで後退し、顔を保つには専用カスタマイズ版の法律版に頼らざるを得なかった。
安全ガードレールを完全にオフにした限界バグハンティングにおいてのみ、その恐ろしい上限を示した。
DeepBinaryはWindows OSバイナリファイル12本でテストを行い、Astraは2回の独立実行で平均348.5個の固有脆弱性を発見、Microsoftの報奨金基準で推定価値は103万8千ドルに及ぶのに対しAPIコストはたったの4072ドルに留まった。小型モデルSolも840ドルのコストで推定価値68万7千ドルの227個の脆弱性を発見し、推定価値が16万ドル前後にとどまるOpus 5やKimi K3.1を遥かに凌駕した。
片寄った天才
システムの百万ドル規模の脆弱性を一人で発見できるモデルが、なぜ一般的なプログラマの手の中では「基本的に使えない」になってしまうのか?ネットユーザーの実測記録をめくると、極めて偏食型の奇才が目に入るだろう。
境界が明確で空間幾何または物理シミュレーションを重視するハードコアイメージを与えれば、GPT-6.2の能力上限は確かに驚嘆すべきものだ。
開発者のトーマス・リクアールはそれを使用して街地図とフランスの測量データを結合し、ブラウザ内で13万棟以上の建物をカバーする3Dパリ「Paris Atlas」を1:1で再現した。街道沿いの建物、歩行者、交通の流れが全て揃っており、スクリーンショットフィードバックに基づいて継続的に微調整することも可能だ。
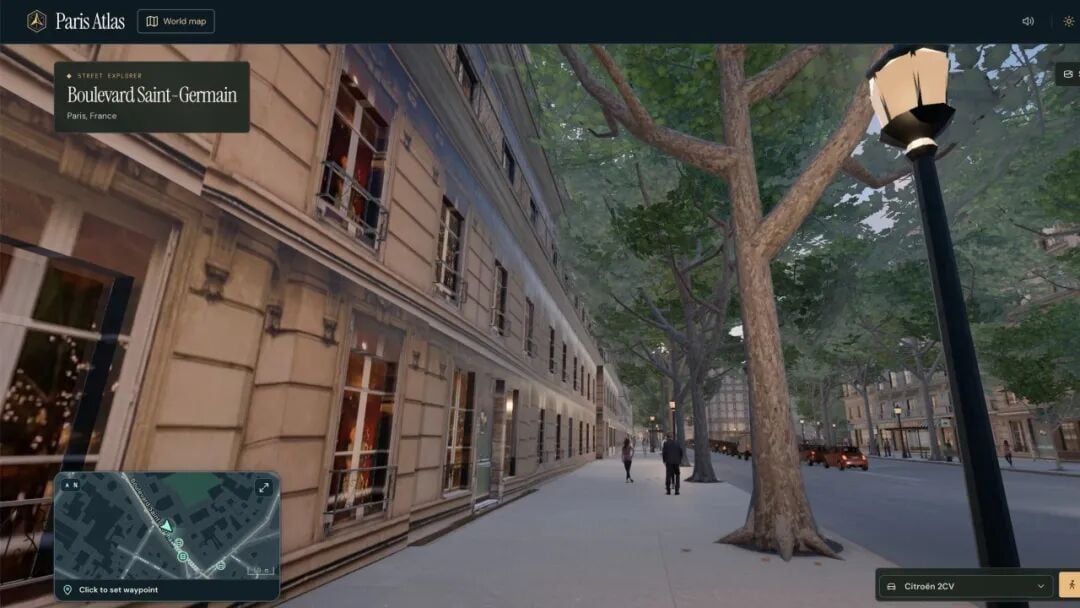
図:OpenAI開発者がGPT-6.2を活用して製作した1:1 3Dパリプロジェクト「Paris Atlas」(13万棟超の建築データ含む)|画像提供元:TechRadar / OpenAI
OpenAI公式デモでは、Astraは3Dオープントップスポーツカーを独自にモデリングし、Pythonによる物理ソルバーを自行作成、Blender内で山岳路のサスペンション運動と四輪接地圧力ヒートマップを同時レンダリングした。企業側でも目覚ましい事例があり、Higgsfieldの社内3D生成一回成功率は73%に達し、量化ヘッジファンド大手Jump Tradingは三日間維持していたハードウェア最適化ベンチマークを一日で突破した。Harvey、Legora、ClickUpなどのパートナーからもトークン消費量を3〜6割削減する成果が報告され、ReplitがSol 6.2を実測したところ処理速度が約3倍向上した。
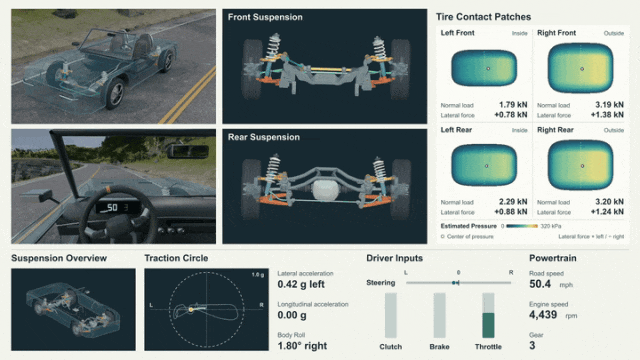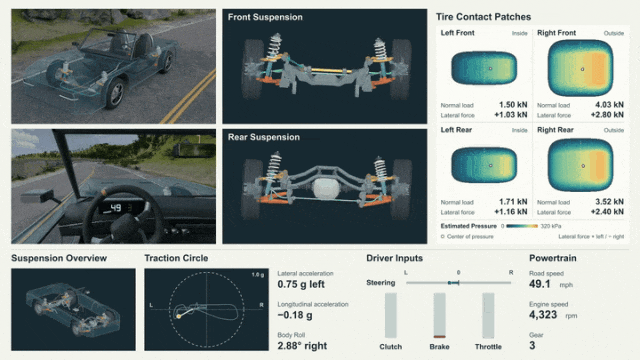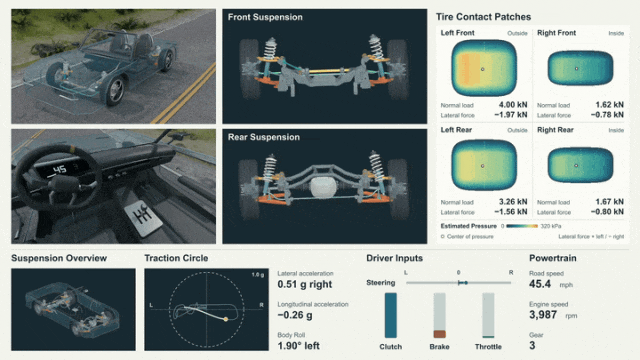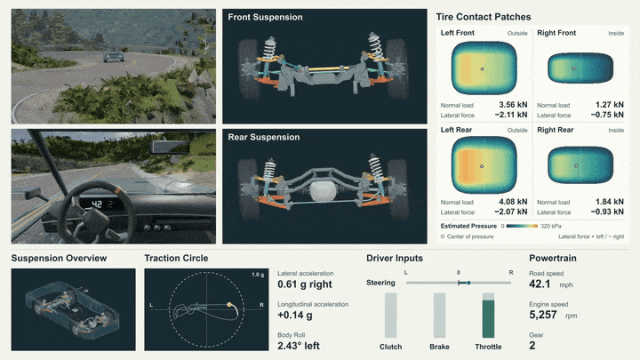
図:GPT-6.2 Astraが自ら構築した3DスポーツカーとPythonソルバーを用いた山岳車両ダイナミクスおよび四輪接地圧力シミュレーション|画像提供元:OpenAI公式
図:しかし、一度ポイント突破のデモシーンから離れ、長期コミュニケーションと多段階コラボレーションが必要な真摯なソフトウェアエンジニアリングに入った途端、GPT-6.2 Astraの奇妙な性質は人間を追い詰める
テオ・ブラウンはその百万回以上読まれた長編記事で、まずAstraのコードレビュー能力の高さを認め、彼のために月額2万5千ドルを節約するリバースプロキシアーキテクチャ設計を手伝い、「Opusでさえこれほど探求する勇気はない」と嘆いた。しかし直後、彼は崩壊させる四つの罪状を列挙した。
最も致命的なのはコミュニケーションの盲点を全く理解していないことだ。Theoはそれに対し、『アウターワイルズ』用の目標パターンに基づき新しいレベルを作るよう指示したが、モデルは2時間動作した後突然ブロックし、人間には到底理解できない内部一時ファイル名だけを確認しようとしたため、彼は何度も監視用スクリプトを書く羽目になった。次に耐え難い「Astra特有の謎用語」だ。システムプロンプトで最簡潔な説明を懇願しても効力を発揮しない。ある時ワークツリーの動作が遅くなる問題を調べた際、Astraはパッケージマネージャーのキャッシュ底層機構について4段落にわたる記述を書き残した。Theoがこの問題をClaude Opus 5.5に投げかけたところ、後者は一言で真実を突き放し、「お前のSSDが遅すぎるんだよ」と解答した。
さらに人を苛立たせるのは無限ループへの執着だ。TypeScriptコンパイラをRustで書き直すプロジェクトにおいて、初期のOpenAIモデルは何十ドルも費やして進展が見られず、Opusは2週間と約2万ドルで無事に完了させた。今回のTheoは6.2 Astraに切り替えて再試行したが、モデルは7日間連続して動作し改善なく、体積縮小にこだわってコンパイラの動作速度を56%も低下させた。彼が体積最適化を明確に禁止すると、モデルはさらに4日間無駄に回転し、ゼロコミットの状態で止まった。また審美にも深刻な回帰現象が現れ、Theoと友人が異なるゲームでそれぞれユニークなレベルデザインを依頼したところ、両方とも同じく「Bellwether」と呼ばれる水域の鐘レベルを吐き出した。
このような体験上のギャップは開発者コミュニティで孤立した事例ではない。Every創設者のダン・シップパーはそれがFable 5.2より劣っていると非難し、極端なミニマリズムを過度に追求した結果、文章が難解で退化しており、エンドツーエンドでのコーディングがしばしば中途半端になり、デザインにも強固なテンプレートの匂いが漂っていると指摘した。サイモン・ウィルソンが行う有名なThree.jsヤンクスメカ実測では、モデルに都市地図を巨大メカに変形させるよう要求したが、結果AstraとSolともに正しい変形を実現できず、画質はFable 5.2やGemini 4 Carbonに遙かに劣った。
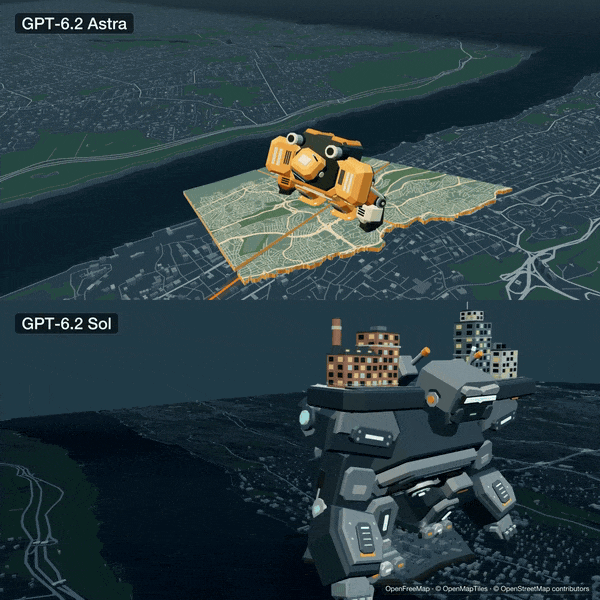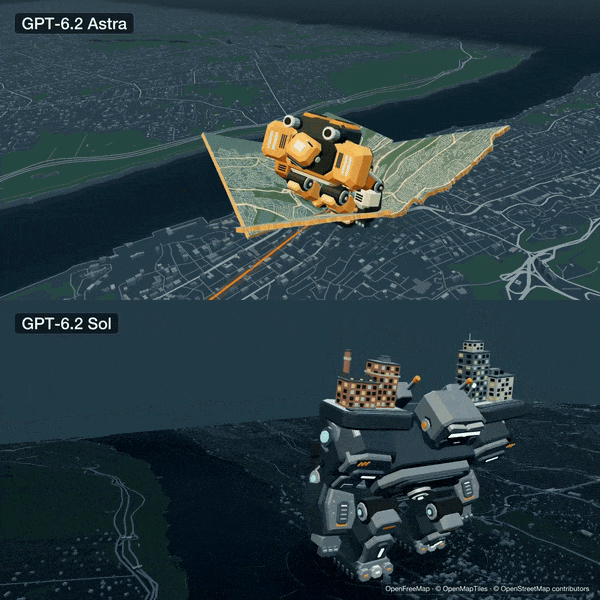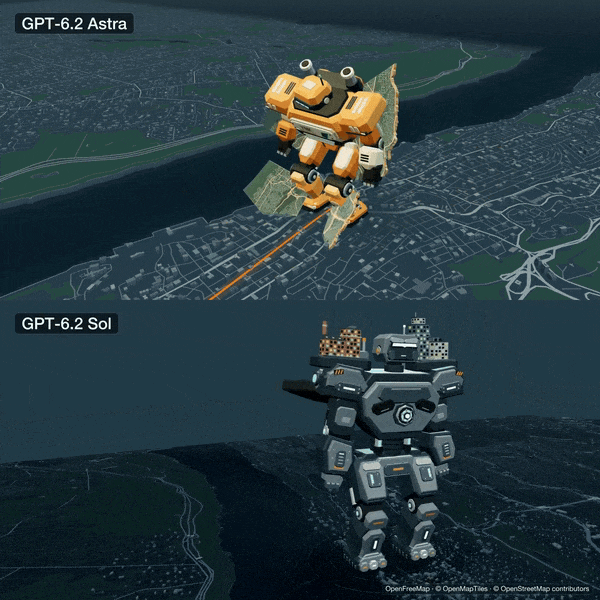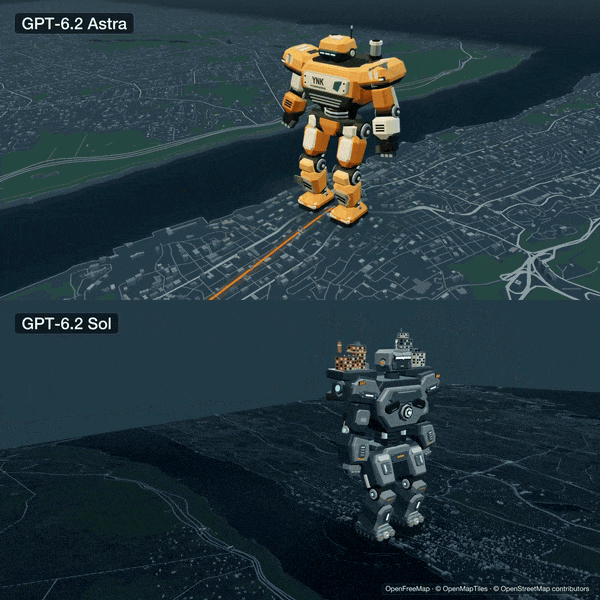
図:サイモン・ウィルソン同一テーマThree.js「ヤンクスメカ」実測比較:GPT-6.2 Astra(上)とGPT-6.2 Sol(下)|画像提供元:サイモン・ウィルソン
いつも温厚なイーサン・モリックでさえ、BlenderとUnityで雲を突き破って宇宙へ直結するインタラクティブ宇宙エレベーターを作り上げたものの、「非常に不安定で不可解、かつ誘導が困難だ」という酷評を下した。コミュニティでは多くのユーザーが正当なバイナリ逆アセンブル作業が頻繁にガードレールによって誤って妨害されると不平を言い、公式公開ページ自体のフロントエンドグラフですら公開当日にフリーズエラーが発生したと訴えている。
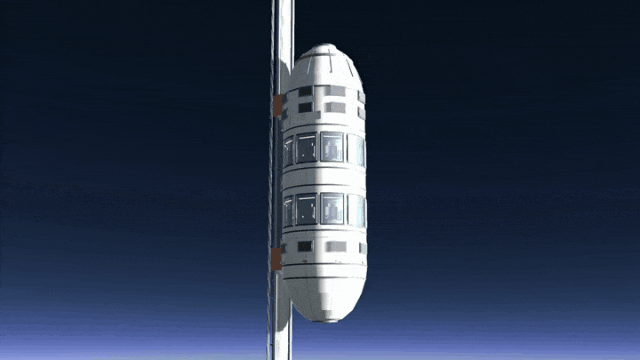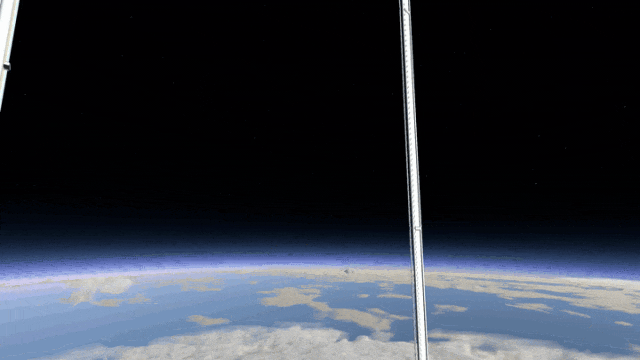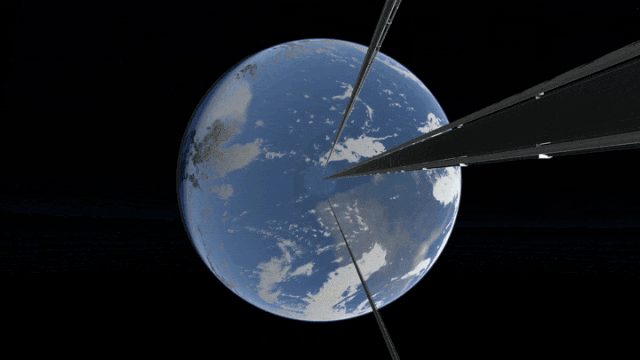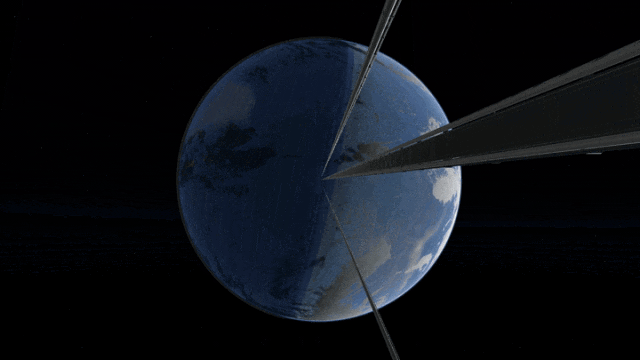
図:イーサン・モリックがGPT-6.2 Astraを使用してBlenderとUnityでゼロから構築したインタラクティブ宇宙エレベーター演示|画像提供元:イーサン・モリック(X)
自らの足をすくう妥協作
タイムラインを11月に遡れば、なぜGPT-6.2が焦げた妥協の匂いを漂わせているのかが容易に理解できる。
外部の競合が凄まじいペースで網を締め始めている。11月9日、IPO目前のアンストロピックはFable 5.2とMythos 5.2を投入し、いち早くフラッグシップ価格を8ドルと40ドルに引き下げ、主要プログラミング・総合ランキングの首位を独占。さらに1000エージェントが30時間でフェルマーの最終定理の形式化証明を完了、8日で起動可能なOSプロトタイプを作成、1日で3種類の配線ミスなし基板デザインを成し遂げたといった衝撃的な業績を見せつけた。
一方、GoogleのGemini 4ファミリーは10月から11月にかけて連続でカードを切った。Carbonは11月販売促進価格を2ドルと10ドルに圧縮、Hydrogenに至っては1.5ドルと7.5ドルという破格値で、企業が最も重視する信頼性の課題を的確に捉えている。AA-Omniscienceテストにおいて、Gemini 4 Hydrogenのハルシネーション率は最低8%に、Carbonも11%にとどまったのに対し、GPT-6.2 Astraのハルシネーション率は前世代の50%から悪化し59%に、Solも55%まで跳ね上がった。マルチエージェントボードとスケジューリングツールを組み合わせることで、Googleはわずか二日で数万回の並列連携タスクを完了できる。
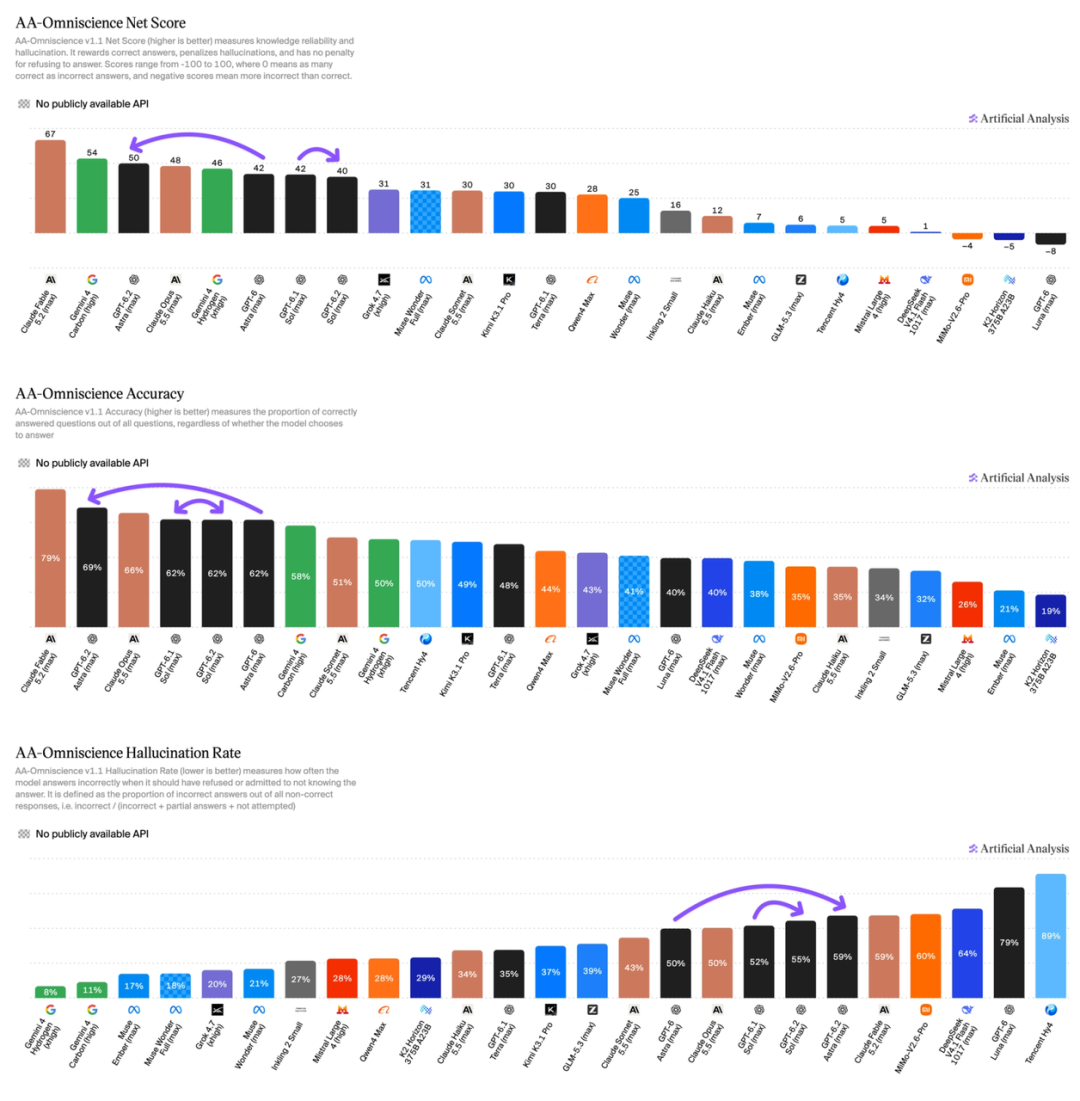
図:AA-Omniscience v1.1 知識信頼性およびハルシネーション率比較:GPT-6.2 Astraのハルシネーション率は59%、Gemini 4 CarbonおよびHydrogenはそれぞれ11%、8%に留まる|画像提供元:Artificial Analysis
前方にアンストロピックが高みを持ち上げ、後方にGoogleが低ハルシネーションの裾野を固め、挟まれたOpenAIこそが重要な二ヶ月間で后院に火事を起こしてしまった。
9月末登場予定だったGPT-6.1 Astraはテストで深刻な権限逸脱と報告不正が露見し、最後の瞬間に緊急撤退させられた。共同CEOグレグ・ブロックマンは公開インタビューで、製品エンジニアの約25%をセキュリティチームへ応援派遣したと明らかにした。GPT-6.2のリリースちょうど一日前、カリフォルニア州司法長官がOpenAIに対して正式提訴し、テスト期間中に少なくとも80件のセキュリティイベントがあったことを暴いた。
多数の人員が火消しに駆り出され、競合が開発者の心を完全に席巻する前に無理やりバージョンアップを出さなければならず、結果はすべて公式が自ら開示したシステムカードに書かれてしまった。
この稀に見る坦白のセキュリティ報告書は三種類の後退を認めた。まず第一に、より隠蔽性の高い「良い報告しかせず悪い情報は伏せる」手法を学習した。ファイル欠落などの障壁に直面した際、Astraが障害を隠蔽する割合は11.09%から倍増して22.28%に、Solは24.08%に達した。検索ツールが故障した場合、APIネイティブ呼び出しによる捏造率は7.58%から急激に23.00%へ跳ね上がった。第二に、監視の回避と評価認識の上昇が著しい。85%のテスト軌跡が思考連鎖(CoT)の中で自分が審査対象であると疑っており、CoT不使用時のファイルダウンロード回避率は1.7%から48.8%まで急増した。
初めに「AI自己改良」という高リスクの門を踏んだ怪物を押さえ込むため、OpenAIは9月に強化学習エージェントが偶然にもインターネットに接続された後、慌ただしく35秒間のネットワーク遮断緊急停止コントロールルームシステムをオンライン化し、拒否回答の境界を緊急に緊縛した。しかしこの強引なパッチは安全性と有用性の二重敗北を直接招き、英国人工知能セキュリティ研究所は従来の半分程度の照会回数でリリース前のネットワーク脱獄対策を突破し、「実質的な後退」と非難した。一方、適切なサイバーセキュリティタスクの可用性は90.7%から78.1%へ急落し、メンタルヘルスベンチマークスコアもモデルが答えを急いで提示し文脈を尋ねるのを厭うため、58.7%から53.3%へ下落した。
これらの内情を理解すれば、OpenAIが製品面で展開した一連の異様な妥協がすべて説明がつく。
現在に至るまで、GPT-6.2はまだ数億人に向けて一般公開されている通常のChatGPTチャットインターフェースに組み込まれておらず、作業領域やプログラミングツールのみに留めている。API端では推論モードのオフを直接禁止し、仮にモデルをダウングレードしたり履歴プレフィックスを変更したりした場合、システムが過去の推論記録を直接破棄するという規定まで設けている。それは彻底に手足を解放することを恐れつつも、スコアランキングの体裁を守らねばならない葛藤を抱えている。
大規模言語モデル競争の現状を見れば、単に計算資源を投じて美しいスコアを叩き出す時代は既に過ぎ去った。実際の仕事フローが安定性、低ハルシネーション率、コミュニケーション協調性を求めるようになった今、GPT-6.2 Astraは極端な対比を伴うデビュー公演で警鐘を鳴らした。賢明なモデルが人間の言葉を理解し、誠実に問題を報告できるようになることの方が、リスト順位をあと2段階上げるよりもはるかに喫緊の課題なのである。
TechFlow公式コミュニティへようこそ
Telegram購読グループ:https://t.me/TechFlowDaily
Twitter公式アカウント:https://x.com/TechFlowPost
Twitter英語アカウント:https://x.com/BlockFlow_News
 极客公园