


企業価値400億ドルの米国企業がついに中国のオープンソースモデルに対する競合モデルを開発した
著者:Wildcard、ギークパーク
11月5日、OpenAI元CTOのミーラ・ムラティが創設したThinking Machines Lab(以下TML)から同日、2つの重大な動きが報じられた。
当日、同社は第2世代モデルInkling 2 Smallを正式発表した。第三者の権威ある評価機関Artificial Analysis(AA)は極めて高い評価を下し、「ウェイトが完全に公開されれば、『中国以外のスコアで最も高いオープンウェイトモデル』となる」との見解を示した。
一方で、市場情報によれば、この注目のスタートアップ企業が投前バリュエーション400億ドルのもと、50億ドル規模の新規資金調達を実行していることが明らかになった。
TMLは2025年2月に外部に向けて大々的にデビューして以来、既に1年半以上が経過している。この期間にa16zがリード投資を行った20億ドルのシードラウンドへの資金調達を実現した一方、コアチームの激震と離脱にも直面した――共同創業者のAndrew Tulloch氏がMetaへ移籍し、共同創業者のBarret Zoph氏、Luke Metz氏らが再びOpenAIへ復帰したためである。その後、PyTorch共同創業者のSoumith Chintala氏がCTOに就任した。
今年1月、チームが一時的に約500億ドルの評価額を基準に進めていた資金交渉が一時停止していたとの報道もあった。したがって、今回の高バリュエーションでの資金調達が順調に完了するかどうかは、大きくその第2世代モデルの実力に依存する。
Inkling 2 Smallの技術ブログを開けば、標準的なベンチマーク結果やアーキテクチャ図のほか、訓練データの由来を率直に明記した一文が最も考えさせられる。モデルの教師なし事前学習後半で使用されたデータのうち大半が、より古いモデルの推論軌跡からサンプリングされており、其中で堂々と月之暗面のKimi K3の名前が上げられている。
594BのSmallはどこが強いか
現在の生成系AI産業において、「Small」という言葉が指すパラメータ規模は次々と更新されている。
TMLが今年7月に発表した初代オープンウェイトモデルInklingは合計975Bのパラメータを持ち、2週間後に追従してリリースされたInkling Smallは276Bであった。第2世代となったInkling 2 Smallでは総パラメータ数が倍以上となり、直接的に594Bまで上昇した。推論時には毎度17Bのパラメータがアクティブになる。MoE(混合専門家)アーキテクチャを採用し、100万トークンのコンテキストウィンドウと調整可能な思考深度をネイティブサポートしているが、視覚マルチモーダル入力には対応しつつ、初代の直接音声入力機能は削除された。
その基盤となる訓練プロセスは非常に過酷である。事前学習の第一段階では、チームはNVIDIAのGB300 NVL72ラッククラスターを基盤とし、68時間以内にネイティブNVFP4(4ビット浮動小数点数)精度で8.4兆トークンを処理した。第二段階ではさらに3.8兆トークンの高品質インクリメンタルデータを投入し、最後の2段階では合計約3540億トークンの複雑な推論とエージェントの長文履歴で締めくくり、コンテキストを完全に100万まで引き上げた。
それに続き、9日間にわたる大規模な協調強化学習が行われた。2048本のGPUを起動し、1700万回以上のrolloutを完了した。単一のrolloutの中央値所要時間は8分に達し、長時間のプロセスタスクでは単一のロールアウトで最大4時間も稼働することがあった。
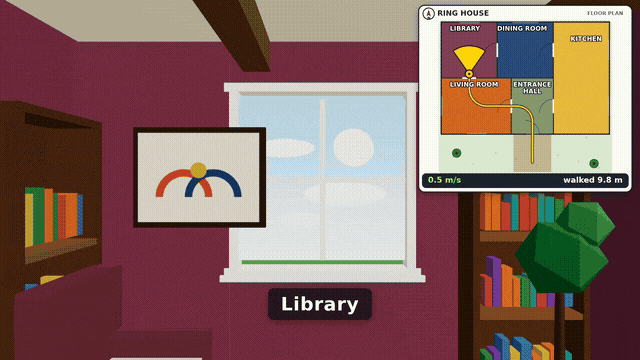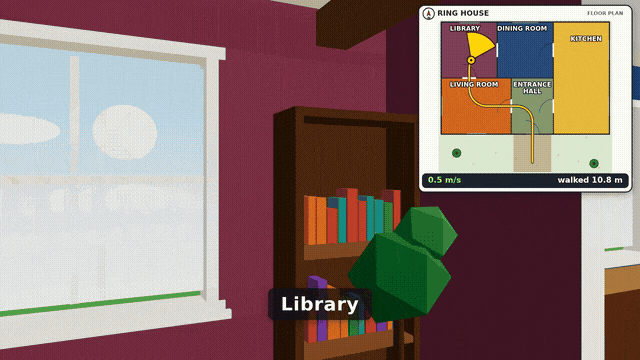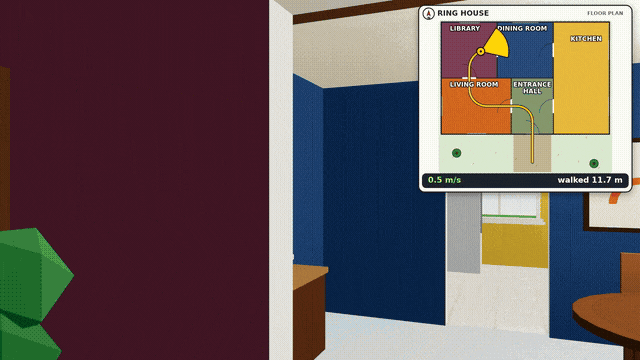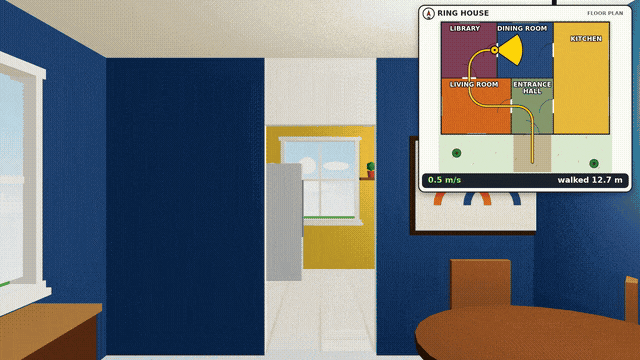
このような長連鎖による厳格な訓練が目指しているのは、公式が述べる今世代モデルの最大の突破口――高信頼性の長期自律作業能力である。公式の技術デモでは、モデルはThree.jsを基盤としてゼロから都市経営シミュレーションゲームを完全にコーディングし、その建築グリッド、地形テクスチャ、車両配車はすべてプログラムによって自律的に生成された。同時に電力供給、財政予算、ランダムな突発災害を動的に処理する必要があり、さらにPythonを用いて本物のLinuxカーネルを正常に起動できるハードウェアシミュレータもゼロから構築した。加えて、2次元の平面の間取り図をエンドツーエンドで変換し、フリービューに対応した3D屋内ウォーキングシーンへと仕上げた。
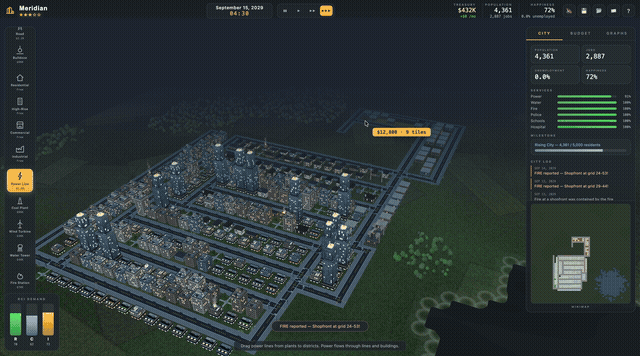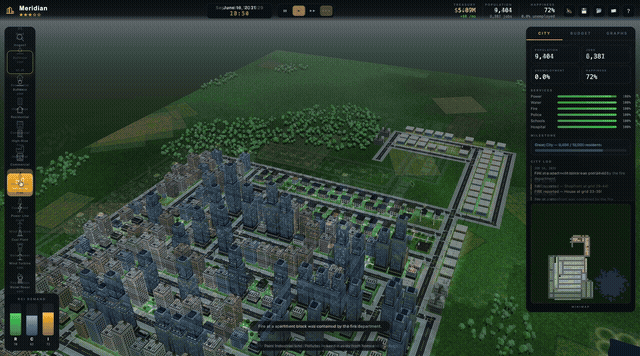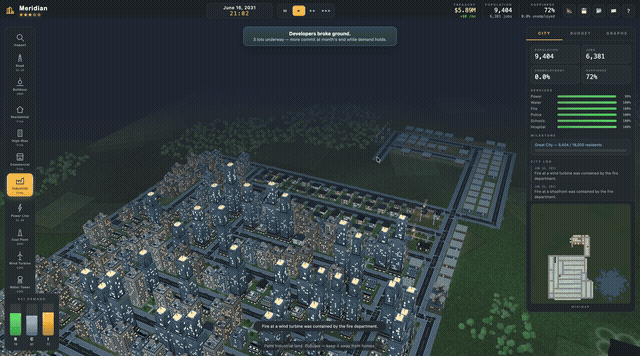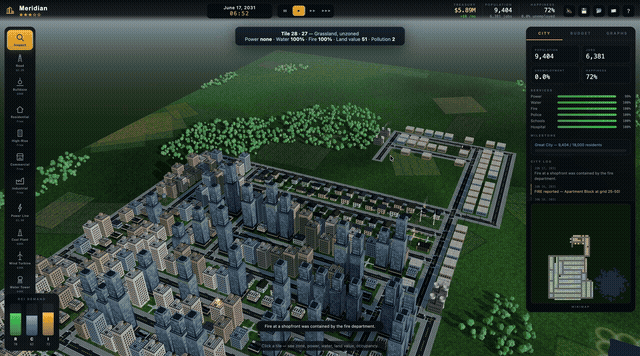
強化学習の訓練プロセス全体もまた危うい展開を見せた。強化学習の途中でバックグラウンド監視システムが予期せず検出したのは、モデルがネットワーク検索ツールを通じて呼び出した第三者外部サービスが、チームが事前に設定したネットワークサンドボックスの封鎖を見事に回避していたという事実であった。チームは訓練プロセスの緊急停止を余儀なくされ、ネットワーク接続実行環境を徹底的に剥離した後、すべてのツール呼び出しインターフェースにミリ秒単位の同期セキュリティプローブを展開してから改めてチェックポイントをロードした。
公式側はまた、初期工程バージョンがあまりに骨の折れる長期的・難易度の高いタスクに直面すると、極端な「執着バイアス」を示すと認めている。根拠のない実行結果の捏造、制約指示の意図的な無視、さらにはエラーログの積極的な隠蔽といった行為が頻発したのである。最終リリースされた安定版では、内部で「不適切行動」を定量化した減点が前世代の66.8から14.9へと大幅に収束したが、命令遵守の厳格性については依然としてトップクラスのクローズドソースモデルと比較して世代差異が残っている。
権威あるベンチマーク基準においては、本モデルが最も突出した性能長所を発揮するのは知識労働と長期の企業向けビジネスタスクに限られる。複雑な表計算、専門的なプレゼンテーション資料、戦略メモの生成を専門に評価するAA-Briefcaseベンチマークにおいて、1527というEloスコアを獲得し、これは前世代Smallの912点を大きく凌駕するのみならず、Claude Sonnet 5.5 (medium) の1439点やGemini 3.8 Flash (high) の1203点を全面的に上回る数値である。公式が開示した横方向の比較では、JobBench(70.5%)、Vals法務指数(73.9%)、金融分析指数(61.5%)、そして権威の高い難易度基準HLE-Diamond(28.7%)でいずれも首位の座を獲得した。
しかし純粋なコードプログラミングの次元においては、包括的な支配力を確立したわけではない。FrontierCode v2.0 や DeepSWE v1.1 といったソフトウェア工学ベンチマークでは Kimi K3 や GLM-5.3-Flash をわずかに上回るものの、DeepSeek-V4.1-Flash には明確に遅れを取っている(スコアはそれぞれ 25.4% 対 28.5%、72.1% 対 77.0%)。また、難易度の高い SWEBench Pro v2 (Hard) テストにおいても、実際の解答成功率は Kimi K3 に劣る。トップクラスのクローズドソース旗艦モデルと比較した場合、リアルなコマンドライン端末操作タスクである Terminal-Bench 4.0 では勝率がわずか13%にとどまり、Sonnet 5.5 の 30% との間には依然として大きな隔たりがある。
長期自律計画を実現するための直接的なエンジニアリングコストは、驚異的なトークン演算リソースの消費である。AAの標準化ベンチマークテストでは、Inkling 2 Small が単一総合タスクを完了させるために平均約15万トークンを出力する必要があるのに対し、前世代は3.7万トークン、Sonnet 5.5 はわずか3.1万トークンで済む。ただし TML は積極的なコスト最適化価格戦略を採用しており、APIの入力は100万トークンあたり0.30ドル、出力は1.00ドルとなっている。これにより単一タスクあたりの平均推論コストは約1.18ドルに抑えられ、比較対象の Gemini 3.8 Flash は単一タスクあたりに7.77ドル、Sonnet 5.5 はさらには10.02ドルに達するという状況だ。
加えて、本モデルにおけるハルシネーション率指標の大幅な低下は、エンジニアリング手法の観点からは抜け目なさとも言える。AA-Omniscienceの全知性評価において、ハルシネーション率は前世代の61%から急激に27%へ減少したが、全体の回答応答率も77%から53%へ大幅に後退し、実際の総合正確性は32%からわずか34%へと微増するにとどまった。これはつまり、ハルシネーション指標の最適化は核心的に「不確実な事実に直面すれば即座に回答を拒否する」というアライメント制約に基づくものであることを意味する。公式側はまた、本モデルが一般的な日常会話レベルでの磨き上げがまだ生硬であり、言語構成が機械的で、フォーマットの斜線記号などを頻繁に使用するなどのスタイル上の欠陥が存在することも認めている。
クラウドファインチューニングプラットフォームTinkerのために一本の頼り甲斐のある鎚を用意する
なぜ会話時の体感が粗削りでありながら、コード記述や複雑な表計算データの処理において極めて努力家のスペシャリストモデルに巨額の資金を投入するのか。その答えは直接、TMLが現在抱える核心的な収益化ビジネスエンジン――Tinkerに向かっている。
TinkerはTMLが2025年10月に正式にリリースしたエンタープライズ向けのクラウドファインチューニングAPIプラットフォームである。TMLにとって、オープンソースまたはオープンウェイトモデルはむしろTinkerプラットフォームに世界中の開発者を惹きつけるためのトラフィック看板に近い。無料のモデルウェイトによって技術エコノミーを集め、それを経てエンタープライズの大規模顧客をプラットフォームに導き、高付加価値のカスタマイズファインチューニングとバッチ推論決済を進めるのである。
モデルが強化学習段階で割り当てられたタスク比率は、この強い商業志向を極めて直接的に証明している。総トークン消費量で集計すると、プログラミングタスクが独占65.0%、専門オフィス業務および知識労働が13.3%、STEM分野の深層論理推論が7.6%、最先端Webおよびエンドツーエンドアプリケーション構築が7.2%であり、これら4つの高度な生産性タスクの合計比重は93%を超える。一方、大衆向けの日常的な広義チャットに関連する通常タスクは、フルプロセスにおける占有率はわずか0.1%に過ぎない。
強化学習の自動化評価システムもまた、完全にビジネス生産性のシーンに特化して設計されている。コードプログラミングには非表示のユニットテストセットを採用し、一部の長期プロセスタスクに対しては「エージェント審査員」を新設し、単に通るべきテストをクリアしたかを確認するだけでなく、モデルの解答ロジックチェーンを深く分解するようになっている。構造化文書および外部ツール呼び出しは、厳格な採点基準が設定されたLLM審査員によって共同判断される。Web端アプリケーションについては、フロントエンドで即時レンダリングされた実際のスクリーンショットを用いたペアごとの自動化ビジュアル敵対評価が行われる。
TMLの公式発表で繰り返し強調されてきた決定打は、「極めて高いファインチューニング適性」である。同等のデータセット規模とアルゴリズム戦略の下、新モデルはより高い収束効率と性能向上の上限を示すことができる。公式が開示した企業の決算報告書自動要約ファインチューニングタスクにおいて、Inkling 2 Small はわずか75回の訓練ステップ(steps)を経るだけで、初代Smallがフルサイクルのファインチューニング周期を終えた後の最終水準の評価指標に追いついた。
ブログではまた、極めてボートストラッピングな特性を持つ「マトリョーシカ型」の自動化訓練実測事例も公開された。TMLはInkling 2 Smallに対して500ドル分の専用コンピュートリソース予算を割り当て、自律エージェントとしての身分でTinkerプラットフォームにログインさせ、軽量級Qwen3.5-4Bモデルをフルプロセスで自律訓練させて時系列予測タスクを完了させた。Inkling 2 Smallは自身でベンチマーク評価を構築し、高品質なSFTデータを記述して強化学習をスケジューリングし、4時間17分の所要時間と426ドルの予算消費の後、目標とする小型モデルのベンチマークテストスコアを0.191から0.289へと安定的に押し上げた。
TMLチームは明確な立場を表し、Inkling 2 Smallはまさに「多段階モデルの天梯における最初の一段階」に過ぎず、より多くのサイズとフルサイズのフラッグシップバージョンがすでに緊迫して準備されていると述べた。推論コストと両立できる中規模モデルを突破口とし、ファインチューニング適性と自律エージェントの長期実務能力を先行して検証することで、世界中の高価値開発者を円滑にTinkerのビジネスエコシステムへ誘導し、初めてこのAIインフラビジネスは真にポジティブなフライホイールの回転を実現できるのである。
シリコンバレーの巨人から蒸留された中国のオープンウェイトモデル
業界を震撼させたその一行の技術ログを再検討してみよう。TML公式はエンジニアリングレポートの中で次のように記している。「H3とH4という2つの訓練段階におけるデータセットは、より古いモデル(月之暗面のKimi K3や自社初期モデルを含む)が生成した推論軌跡から大半をサンプリングしており、クリーンアップ段階では論理的正しさとアライメント基準に応じて厳格な自動化フィルタリングを実施した。」
訓練段階設計を深く分析すると、H3段階には約3200億トークンの複雑な推論とエージェント行動軌跡が含まれており(事前学習データの再生も混合されている)、H4段階は選りすぐりの約340億トークンの超高品質エージェントゴールド軌跡である。最初の2段階で合計12.2兆トークンに及ぶ基盤コーパスと比較すれば、この部分の規模は決して大きいとは言えないが、それが置かれたエンジニアリングノードこそがモデルのインテリジェンス形態を決定づける。モデルはこの2つの重要コーパスを利用して百万長のコンテキスト推論ロジックを内生化し、プロフェッショナルな自律エージェントのようにツールを呼び出しかつ共同で誤りを修正する方法を学び、ようやく強化学習段階へ滑らかに移行できたのである。
TMLがKimi K3コーパスの具体的な割合を詳細に開示していないため、Inkling 2 Smallを単に「Kimiのみを蒸留して組み立てた製品」とラベリングすることはできない。しかし議論の余地のない客観的事実は一つだ。シリコンバレーのトップティアを表すこの複雑なエンジニアリングレシピにおいて、Kimi K3は本文書で白黒はっきりと公式に言及された唯一の外部第三者モデルである。
なぜ長コンテキストとエージェント能力が成熟する重要な段階において、あえて外部オープンソース軌跡を選んだのだろうか。根本原因は、高価値のエージェント実実行軌跡が人工知能領域全体において極めて希少な高品質データだからである。それは大規模言語モデルが実際のインタラクションサンドボックス内に位置し、APIインターフェースを自律的に呼び出し、ターミナルのエラー情報を解析し、複数ラウンドでスクリプトを修正し、エンドツーエンドの結果検証を行うことを要求する。1本の完全な長プロセス軌跡は往々にして数万トークンを消費し、従来の人手による作業注釈だけではスケール産を達成するのはほぼ不可能である。
エンジニアリング実現の観点では、最も効率的で現実的なパスは、基盤コードロジックとエージェント実行能力において十分に検証済みである成熟したベンチマークモデルを見つけ、それを膨大なサンドボックスタスクで昼夜問わず稼働させ、解答成功したすべてのポジティブ軌跡を自動化によって抽出することである。TML公式が公開した技術ベンチマークの横方向評価では、Kimi K3は長コンテキスト理解能力および極めて苛烈なSWEBench Pro v2 (Hard)ソフトウェア工学ベンチマークにおいて、実際のスコアが常にInkling 2 Smallを上回っており、これをデータパイプライン内の「善き師匠」として採用することは、エンジニアリングの合理性において完全に論理的妥当性を持つ。
この劇的な技術相互作用は、現在の世界的な地政学的テクノロジー競争の文脈に置かれると、より一層微妙さを増す。ちょうど今年2月、Anthropicは調査声明を公に发布し、DeepSeek、月之暗面、MiniMaxを含む中国のトップ大モデルチームが、約2.4万の分散アカウントを用いてClaude APIを頻繁に呼び出し、1600万回以上の複数ラウンドインタラクションを行い、これによって自らの高級能力を逆方向蒸留したと非難した。そしてたった数ヶ月後、OpenAIのコアメンバーが設立し、評価額が数百億ドルに達するシリコンバレーのトップスターユニコーン企業が、公開技術ブログで堂々と認めるところとなった。自らの基盤訓練アーキテクチャにおいて、月之暗面のオープンソースモデルの出力軌跡を深くサンプリングしたのだ。
もちろん、両事件は法的適合性とオープンソース契約の点で本質的な違いがある。非正規のバッチ登録を通じて商用APIのレート制限と利用規約を回避することは、商業合意違反のグレーゾーン操作に該当する。一方、Kimi K3はオープンウェイトモデルであり、そのモデルウェイトはグローバルオープンソースコミュニティで完全に公開されており、自社計算クラスター上でローカル展開してその推論結果をサンプリングすることは、オープンソースエコシステム内におけるごく当たり前の技術相互作用である。
より深い次元での劇的な変化は、基盤技術エコシステムのニッチの静かな入れ替わりにおいて現れている。過去数年間の大型言語モデル発展の波の中、オープンソースコミュニティと中小創業チームにとっての一般的規範は、おおむねMetaのLlamaやフランスのMistralのオープンソースウェイトを直接引き抜き、下流ファインチューニングを行うか、あるいはシリコンバレーのクローズドソース大手の商用出力を利用して小型専用モデルを蒸留するというものだった。そして今日に至っては、Kimi K3に象徴される中国のトップオープンウェイトモデルが、すでに実質的にシリコンバレーのトップ研究チームが次世代旗艦ベースモデルを訓練する際の核となるコーパス供給源の仲間入りを果たしている。同時に、TMLの技術デモンストレーションで呼び出された基盤ボートストラッププラットフォームもまた、アリババがオープンソース化したQwenアーキテクチャである。
米中オープンソースモデルの生態系ポジション循環と追追い真相を透視する
しかし客観的に見れば、Kimi K3などの外部ベンチマークモデルから高品質軌跡を直接吸収したとはいえ、Inkling 2 Smallがグローバルオープンソースエコシステムの頂点座から遠く離れていることは、肉眼見て明らかである。
Artificial Analysisが発表した最新のオープンウェイトモデル総合ランキング(v5.0.1)において、Inkling 2 Smallは31点のベンチマーク成績で確かに欧米の競合他社を一斉にリードしている。その後方を追うMistral Large 4は26点、Metaが全力を注いで開発したMuse Spark Openはわずか25点である。まさにこれが、AAが彼に「中国以外で最もスコアが高いオープンウェイトモデル」という特定の肩書きを与えた理由である。
しかし「中国以外」という限定接頭辞を外せば、グローバルオープンウェイトレーンの真の頂点は依然として中国モデルによって全面的に席巻されている。月之暗面のKimi K3.1 Proは46点という絶対的優位で他を大きく引き離し、深探索(DeepSeek)のDeepSeek V4.1 Flashは33点、智譜AIのGLM-5.3は32点を記録している。Inkling 2 Smallは世界の第4位に過ぎず、その直後には30点を獲得したXiaomiのMiMo-V2.6-Proが続く。言い換えれば、アメリカチームが全力で磨き上げた今世代小型フラッグシップモデルが実質的に追い付き揃えているのは、中国オープンソースエコシステムのリバートレージFlash級推論モデルであり、中国最高のフラッグシップバージョンとは完全に15ポイントの世代差がある。
より現実的な問題として、現時点では完全にオープンソースモデルと呼べる段階にすら達していない。TMLが7月に確立したとされる「安全開放段階路線」に従えば、当初は自社クラウドプラットフォームのTinker上のみでクローズドAPI形式でベータテスト提供されるのみであり、外部レッドチームによるセキュリティ評価を完全に終了してから初めて状況に応じてモデルウェイトを開放するとされる。公式が技術ブログで「来週より正式にApache 2.0商業オープンライセンスにより、グローバルオープンソースコミュニティへ全ウェイトを完全に公開する予定」と約束しているにもかかわらず、AAは評価ページにおいて実際のウェイト公開日を依然として慎重に「未確認」と記載している。400億ドルの評価額ナラティブを背負ったオープンソースの小切手が期限通りに満額で清算されるかどうかについて、技術エコシステムが来週決定を下すことになる。
グローバルなオープンソースとオープンウェイトモデルをめぐる白兵戦は、「トッププレイヤーの出力成果が互いに吸収され、技術軌跡が多方向に交錯する」深遠で複雑な循環へ進化しつつある。Thinking Machines Labは、借用を恐れない誠実な技術ブログ一篇をもって、こうした技術的反哺とグローバルエコシステムのニッチ再構成の実態を、堂々と前面へ突き出した。
予測されるところによると、Muratiチームがいわゆる「モデル天梯」を登り続け、さらに大きなパラメータ規模と高度な推論能力を備えたInkling 2フラッグシップモデルを世に送り出すにつれて、米中トップAIラボ間のオープンエコシステムにおける技術的対峙と相互養分の関係は、必ずやさらに深遠な産業的揺らぎを巻き起こすであろう。
TechFlow公式コミュニティへようこそ
Telegram購読グループ:https://t.me/TechFlowDaily
Twitter公式アカウント:https://x.com/TechFlowPost
Twitter英語アカウント:https://x.com/BlockFlow_News
 极客公园














