


뉴로포스 광칩, 1억 1,000만 달러 투자 유치: 동일 전력 대비 연산 성능 GPU의 25배 주장
저자: Sabbir Rangwala
번역: TechFlow
TechFlow导读: 텍사스주 오스틴 소재 스타트업 Neurophos는 실리콘 포토닉스와 메타물질을 활용한 광학 계산 유닛(OCU)을 개발했으며, Gates Frontier가 주도하고 마이크로소프트 벤처 M12 등이 참여한 1억 1,000만 달러 시리즈A 투자를 완료했다. 해당 기사는 그들의 광 핵심부가 칩 내 스위치 없이 작동하며, 동일 크기와 전력 소비 기준 GPU 대비 약 25배의 연산 능력을 달성할 수 있다고 전한다. 또한 OCU가 2028년 상용화되어 2034년까지 약 27억 달러 규모의 시장을 형성할 것으로 전망하는데, 이는 AI 추론의 프리필(pre-fill) 단계에서의 행렬 연산 수요와 데이터센터의 에너지 효율 병목 현상에 대한 강력한 베팅이다.
요약
광학 계산은 1960년대부터 시작되었으며 지난 수십 년 동안 크게 성숙하여, 이제 광 영역에서 직접 계산을 수행합니다. 텍사스주 오스틴을 거점으로 하는 Neurophos는 실리콘 포토닉스와 메타물질을 기반으로 광학 계산 유닛(OCU)을 구현합니다. 회사는 최근 광자 기반 AI 칩 기술 발전을 위해 1억 1,000만 달러 규모의 시리즈A 투자를 유치했습니다. Neurophos의 광학 코어는 내부 스위치 필요 없이 빛의 속도로 즉각적인 계산을 처리하며, 이로 인해 동일한 칩 면적과 전력 소모 대비 GPU보다 월등히 높은 초당 연산 횟수(FLOPS)를 발휘합니다. OCU가 점차 데이터센터 내 GPU 연산 시장을 대체함에 따라 그 잠재적 시장 규모는 매우 방대해질 전망이며, 현재 이 시장은 연간 약 1조 달러에 달합니다.
기존 컴퓨팅은 일반적으로 전자 회로에서 수행됩니다. 트랜지스터, 스위치, 메모리를 통해 디지털 비트가 이동하며 처리되는 방식입니다. 이 방식은 효율성이 뛰어나며 확장성, 크기, 전력 소모, 속도 측면에서 무어의 법칙을 충실히 따랐습니다.
문제는 데이터센터가 방대한 양의 광 데이터를 처리해야 한다는 점입니다. 전통적으로 이러한 데이터는 먼저 전기 영역으로 변환(광자가 비트로 변환)되어야 하며, 이후 다른 채널로 데이터를 전환하고 온라인 검색 및 AI 데이터 스트림의 학습과 훈련에 필요한 계산을 수행해야 합니다. 광-전기-광(OEO) 변환 과정은 손실이 극히 크며, 이는 데이터센터의 에너지 소비와 냉각용수량을 급격히 증가시켜 비용, 정책적 리스크, 기업 이미지 전반에 걸쳐 큰 대가를 치르게 만듭니다. 광 회로 스위칭(OCS) 기술은 실리콘 포토닉스와 메타물질을 활용하여 광 경로를 전환하는 데 진전을 보이며, 이러한 고비용 OEO 변환 의존도를 낮추고 있습니다. 하지만 실제 '연산' 자체는 여전히 보조 장치가 필요합니다. 바로 여기서 Neurophos가 해냅니다. 동사는 실리콘 포토닉스 회로와 메타물질 기술을 활용하여 완전히 광 영역 내에서 계산을 수행합니다.
광학 계산 자체가 새로운 개념은 아닙니다.
그 역사는 1960년대로 거슬러 올라갑니다: 연구자들은 렌즈와 광학 필터가 신호나 파동을 각 주파수 성분으로 분해하는 수학적 연산인 푸리에 변환을 수행할 수 있음을 발견했습니다.
1970년대: 공간 광 변조기(SLM) 기술이 한층 발전하며 프로그래머블 방식으로 광 패턴 생성, 초점 조정, 나아가 레이저 빔의 특정 경로 이동을 가능하게 했습니다.
1980~2000년: 이후 20년간 수많은 학술 연구와 혁신이 쏟아졌지만 상업화에는 성공하지 못했습니다. 주된 이유는 전자 컴퓨팅이 비약적으로 발전한 반면 광학 기술이 아직 실험실 단계에 머물러 있었기 때문입니다. 이후 SLM 기술은 벡터-행렬 곱셈(VMM) 구현에 활용되며 결정적인 돌파구를 마련했습니다.
2000~2025년: 이 25년은 광학 기술이 비로소 성숙하는 시기였습니다. 광 반도체, 실리콘 포토닉스, 메타물질, 광섬유, 자유공간 광학 등이 센싱, 통신, 재료 가공 및 컴퓨팅에 적용되었습니다. 이와 동시에 초대규모 데이터센터가 부상했으며, 이들은 막대한 양의 광학 기술을 소비하면서 Lumentum, Coherent, Corning, IPG Photonics 등 수십억 달러 규모의 광학 기업들을 탄생시켰습니다. 현대 데이터센터가 광학 기술을 요구하는 이유는 단순히 데이터 전송과 교환을 넘어, 데이터를 '처리(계산)'하기 위함입니다. 초대규모 데이터센터 하나의 전력 소비량은 100메가와트(MW)에서 1기가와트(GW)에 달하며, 이 중 약 50%가 연산에 사용됩니다. 광학 계산은 전력 소비(및 이에 따른 냉각 수요)를 획기적으로 절감할 수 있는 솔루션입니다.
Neurophos는 광학 계산의 상용화를 선도하고 있습니다. 텍사스주 오스틴에 위치한 동사는 최근 광학 계산 연구 가속화를 위해 1억 1,000만 달러의 추가 자금을 조성했습니다. 이번 투자 라운드에서는 Gates Frontier가 리드하고, 마이크로소프트 벤처 M12, Carbon Direct Capital, Aramco Ventures, Bosch Ventures, Tectonic Ventures, Space Capital 등이 참여했습니다. 이를 통해 Neurophos는 2026년도에 인력을 약 4배 수준으로 확대할 예정입니다. Neurophos의 최고경영자(CEO)이자 공동창립자인 Patrick Bowen 박사는 다음과 같이 밝혔습니다. "무어의 법칙이 느려지고 있지만 AI의 발전은 기다리지 않습니다. 우리가 광자학 분야에서 이루어낸 돌파구는 전혀 새로운 확장 차원을 열었으며, 엄청난 양의 광학 병렬 처리를 단일 칩에 집적할 수 있게 했습니다. 이는 물리적 차원의 도약으로서, 시스템 확장 시 효율성과 기본 속도가 함께 향상됨을 의미합니다. 결과적으로 전통적인 GPU가 직면한 전력 벽(Power Wall) 제약에서 벗어날 수 있습니다. 광학 계산이 바꿀 것은 특정 전력, 공간, 예산 내에서 제공할 수 있는 AI 성능의 총량입니다."
먼저 몇 가지 기본 개념을 짚고 넘어갑시다. AI 추론 단계의 연산은 크게 두 종류로 나뉩니다. 바로 '프리필(pre-fill)'과 '디코드(decode)'입니다. 프리필은 대규모 언어모델(LLM) 추론의 첫 번째 단계로, 모델이 입력 프롬프트를 병렬로 읽고 분석하는 과정입니다. 디코드는 모델이 답변을 생성해 출력하는 단계로, 이 과정은 본질적으로 순차적입니다. AI 추론 작업에서 프리필이 전체 연산 부하를 주도합니다. LLM 학습 및 대량의 데이터에 대한 학습 역시 연산 부하를 유발하지만, 이는 초기 학습 기간에만 발생하므로 상대적으로 일시적인 전력 소모입니다. 학습 가중치 업데이트 자체의 전력 소모는 훨씬 낮습니다.
그림 1은 클래식 광학 컴퓨팅(전자회로 및 GPU 기반 경로)의 문제점과, Neurophos가 OCU(광학 계산 유닛) 아키텍처를 통해 어떻게 이를 해결하는지를 비교합니다.
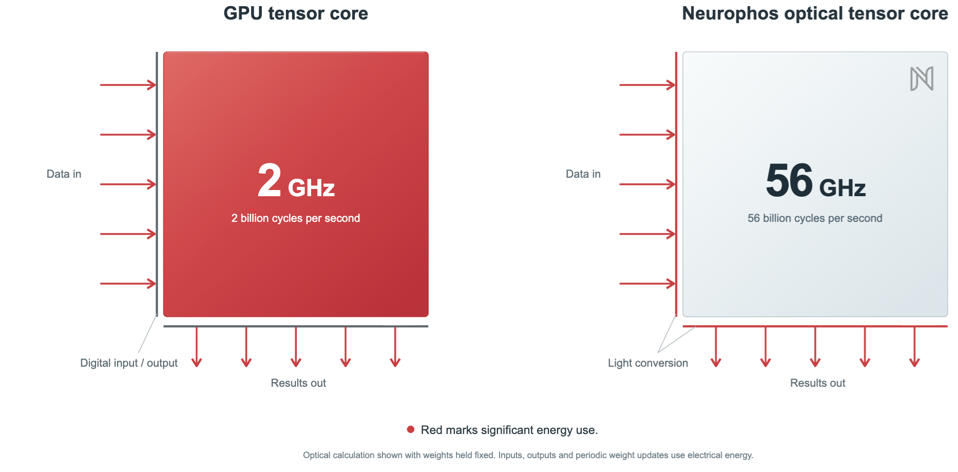
이전에서도 언급했듯, 데이터센터 환경에서는 전력 소비 절감이 가장 중요합니다. 현재의 연산은 전기 영역에서 이루어지지만, Scale Up 및 Scale Across 랙 내 데이터 전송 대부분은 이미 광통신으로 바뀌었습니다. 전기 영역 GPU 칩을 사용하려면 광-전기 변환 후 연산을 수행하고, 다시 전기-광 변환을 거쳐야 전송이 가능합니다. 금속도체 내 전자 이동 시 inherent한 손실이 발생합니다. 더구나 GPU 같은 전자 소자는 계산 코어 내부에 수많은 스위지로 구성되어 있으며, 스위치의 상태 안정화를 기다리는 시간만큼 순수 연산 시간이 감소합니다. 반면 Neurophos의 광학 코어는 스위치를 사용하지 않기 때문에 빛의 속도로 즉시 연산을 완료합니다. 이는 초당 560억 번의 계산을 병렬로 처리할 수 있다는 뜻이며, 동일 크기의 GPU보다 동작 주파수가 훨씬 빠릅니다. 속도 외에도 OCU의 전력 소모는 현저히 낮습니다. 스위스에 공급할 전력이 불필요하며, 신호 전달 손실도 극히 적습니다. 전기식 시스템의 경우 전력 소비와 처리 과정이 입출력 인터페이스(광-전기 및 전기-광 변환)에 집중됩니다. 결과적으로 동일한 칩 면적과 전력 제한 하에서 한 개의 OCU가 GPU 대비 초당 약 25배 많은 연산을 처리할 수 있습니다.
현재로서는 전자 메모리처럼 효율적인 광자 기반 저장 기술은 존재하지 않습니다. 따라서 연산 중간 중간 중단이 필수이며, 중간 결과를 고정시킨 뒤 다음 계산 단계로 넘어가는 식으로 수학적 연산을 클록 사이클 단위로 이산적으로 진행해야 합니다. 이러한 이유로 기존 SRAM과 DRAM이 여전히 필요합니다. 만약 향후 광 저장 기술 과제가 해결된다면, OCU의 입출력부에서 OEO 변환을 제거할 수 있어 처리 속도를 높이고 전력 소모, 제작 비용, 패키지 크기를 모두 줄일 수 있을 것입니다.
프리필 연산은 행렬 곱셈이 다수 포함되는데, 이는 LLM이 고차원 공간에서 프롬프트와 학습된 엔진 간의 관계를 매핑해야 하기 때문입니다. GPU 설계에서는 칩 면적 상당 부분이 이러한 연산 전용으로 할당됩니다. Neurophos 칩에서는 세 가지 과정을 통해 곱셈이 수행됩니다.
데이터 복사: 광분할기(Optical Splitter)를 사용하여 일정한 비율로 신호를 여러 경로로 나눕니다. 이는 광자 회로 내에 구현 가능한 수동 소자로, 입사하는 광자 흐름을 각각의 도파로를 따라 진행하는 다중 경로 신호로 분해하며, 간섭 결합기, 단열 테이퍼(Adiabatic Taper), 파장 민감 격자 등의 소자를 활용해 구현됩니다.
곱셈: 광 영역 내에서 완료되며, 반사와 투과 구조체를 활용하여 다수의 광빔 강도를 조합합니다. 실제 구현 소자로는 간섭계와 위상 변조기(Phase Shifter)가 사용됩니다.
덧셈: 광결합기(Optical Combiner)를 통해 구현됩니다. 이는 다중 경로의 광신호를 단일 출력 경로로 합성하는 소자로, 각 광경로의 진폭, 파장, 위상 또는 편광 특성을 통합합니다.
광학 컴퓨팅의 주요 응용 분야는 행렬-행렬 곱셈(Matrix-Matrix Multiplication)입니다. 광학 시스템에서 한 행렬은 광학 변조기 그리드(Grid)에 저장되고, 다른 하나는 입력 벡터 시퀀스로 주어지며 벡터 내 각 요소는 개별 광빔의 진폭에 인코딩됩니다. 복제 과정에서는 각 광빔을 약 1,000개로 분할하여 변조기 그리드의 한 행에 펼칩니다. 광학적 곱셈은 주로 반사 또는 투과 원리로 작동합니다. 복사된 각 광빔이 변조기 표면에서 반사될 때, 반사광 강도는 입사광 강도에 해당 변조기에 저장된 값의 곱으로 결정됩니다. 덧셈은 그리드의 각 열에서 반사된 광빔을 단일 광검출기(Photodetector)에 모아 집중시키며, 이를 통해 최종 출력의 단일 원소를 생성합니다. 변조기는 수천, 수만의 입력 벡터가 통과하는 동안에도 행렬 값을 유지하므로, 행렬 로딩에 소모된 에너지가 모든 벡터에分摊됩니다. 바로 이 점이 광학 텐서 코어가 벡터-행렬 곱셈이 아닌 행렬-행렬 곱셈 최적화에 특화되어 설계된 이유입니다.
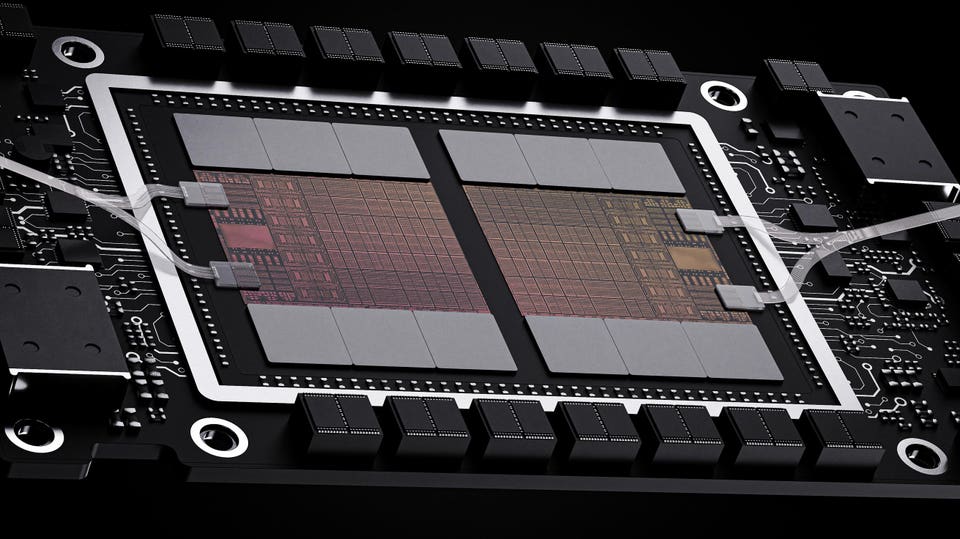
이러한 일련의 연산은 그림 1에 표시된 광학 칩 내에서 수행됩니다. 칩은 규소(Si), 질화규소(SiN), 인화인듐(InP) 등의 기재에 에칭된 미세 도파로로 구성됩니다. 도파로는 칩 내부에서 광빔을 안내하는 역할을 합니다. 레이저 소자와 광검출기가 내장되어 OEO 변환을 담당합니다. 변조기는 정보 인코딩 및 처리를 위해 광의 강도, 위상, 편파, 파장 등의 특성을 조절합니다. 변조기 외에도 도파로에는 광분할기, 반사/투과면, 광결합기가 집적되어 있습니다.
Neurophos의 AI 추론 칩은 가변 광학 소자를 내장한 메타서피스(Metasurface) 아키텍처를 채택했습니다. 이 기술은 초대규모 AI 추론 환경에서 충분한 연산력을 확보하기 위해 칩 제조, 전력 공급, 냉각 및 시스템 배치環節을 아우르는 AI 인프라의 핵심 제약 조건을 타파하는 데 목적이 있습니다. Microsoft는 적극적인 참여자이면서 주요 지분 투자사입니다. 기타 사업화 성과로는 초대규모 클라우드事業者와의 협력이 꼽힙니다. 회사는 최초의 메타서피스 어레이 연산 시연을 마쳤으며, 신뢰도와 성능이 개선했던 다수의 소자까지 현재 테스트 파이프라인에 진입시켰습니다. 공급망 네트워크는 최고 수준의 파운드리, 맞춤형 ASIC 설계 전문 기업, 광학 부품 업체, 그리고 패키징 파트너로 구성됩니다.
광학 계산 및 행렬 곱셈 구현의 주요 도전 과제는 표준 변조기의 크기가 다소 커서(약 2mm 길이)라는 점입니다. 이는 특정 크기의 칩에 배치할 수 있는 변조기 수를 제한하여 연산 속도와 에너지 효율(초당 연산 횟수/Watt)에 제약을 줍니다. 변조기가 1,000개 배열된 시스템이라면, 2,000회의 변환 과정(입력 1,000회, 출력 1,000회)만으로 총 100만 번의 곱셈과 100만 번의 덧셈을 수행할 수 있으므로, 변환 1회당 약 1,000회의 연산 효과가 산출됩니다. Neurophos의 '비결'은 메타물질 기술을 적용해 변조기 면적을 최신 기술 대비 약 1만 배 축소하여, 카드 테이블 크기 규모의 기판이 아닌 손톱 크기의 칩에 100만 개의 변조기를 집적한 데 있습니다. 이를 통해 1,000x1,000 배열 시스템을 단일 칩 위에서 실현할 수 있게 되었으며, 광학 컴퓨팅이 오랫동안 약속해 온 효율성 목표가 본격적으로 입증되기 시작했습니다.
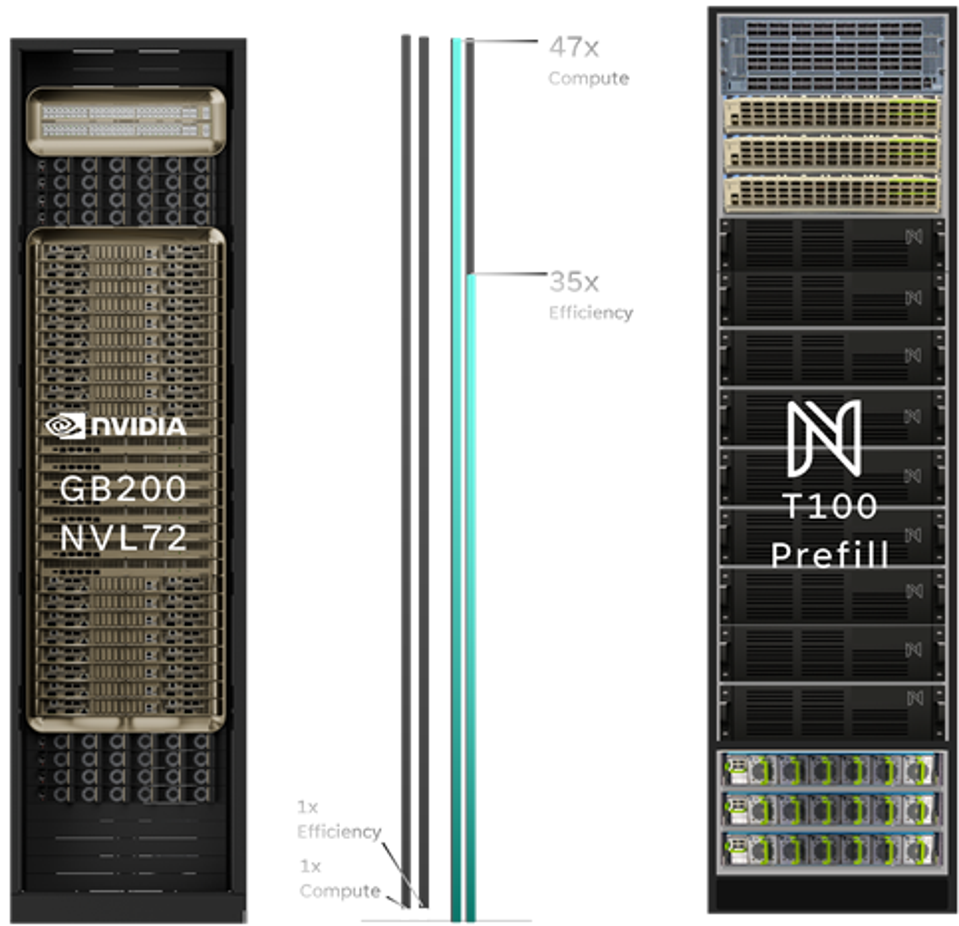
완전한 형태의 Neurophos 광학 텐서 코어는 세 가지 핵심 구성 요소로 이루어집니다. 첫째, 실리콘 포토닉스 칩이 입력 벡터를 생성하고 출력 벡터를 수집합니다. 이 칩은 56GHz 클록로 동작하며, 이것이 연산 속도를 결정합니다. 여기서는 일반적인 대형 변조기를 사용하나, 개수는 100만이 아닌 약 1,000개 정도로 최소화하여 '작음'보다는 '빠름'에 우선순위를 둡니다. 둘째, 메타서피스 칩은 가중치 행렬을 저장합니다. 입력 벡터가 다양하게 변화해도 행렬 값은 동일하게 유지되므로, 해당 변조기들은 '빠름'보다 '작음'에 최적화되어 있습니다. 셋째, 광학 프로젝션 시스템이 두 칩을 연결합니다. 이 시스템은 실리콘 포토닉스 칩의 각 입력 광빔을 복사하여 메타서피스의 해당 행으로 펼치고, 각 열에서 반사된 빛을 다시 실리콘 칩 내 단일 광검출기로 집속하여 합산(summation)을 완수합니다. 여기에 HBM 메모리와 제어/저장을 위한 디지털 칩을 패키징하면, 이 광학 텐서 코어는 GPU를 위한 플러그 앤 플레이 대체재가 됩니다. 포토마스크(Lithography) 공정 크기 기준으로 측정 시, 이 설계는 현존 최첨단 GPU보다 약 50배 빠른 연산 속도를 자랑하며, 기반 에너지 효율은 약 35배 향상된 수치입니다.
광학 기술은 이미 데이터센터 생태계의 핵심 축으로 자리 잡았습니다. 향후 5년간 Scale-Up 랙에서 전기 패킷 스위칭(EPS) 대신 광 회로 스위칭(OCS) 적용 비중이 늘어나면서 광학 모듈의 점유율은 지속적으로 상승할 전망입니다. 관련 전문가들은 향후 5년간 OCS 시장 규모가 약 5배 성장하여 연간 110억 달러에 달할 것으로 예측합니다. 또 다른 주력 시장은 바로 연산 부문입니다. OCU는 GPU 등 기존 전자 회로 대비 연산 속도, 칩 면적, 전력 효율 측면에서 비약적인 개선을 보여주고 있습니다. Yole Group의 보고서에 따르면 최초 OCU 양산품이 2028년 출시될 예정이며, 2034년에는 시장 가치가 약 27억 달러(약 100만 대 규모)까지 성장할 것으로 보입니다. 그러나 진정한 잠재력은 여기서 멈추지 않습니다. OCU가 점차 데이터센터 내 GPU 연산 시장을 대체해 나갈 것이기 때문입니다. 현재 해당 총괄 시장은 연간 약 1조 달러 규모로 추산됩니다.
TechFlow 공식 커뮤니티에 오신 것을 환영합니다
Telegram 구독 그룹:https://t.me/TechFlowDaily
트위터 공식 계정:https://x.com/TechFlowPost
트위터 영어 계정:https://x.com/BlockFlow_News
 Forbes
















