


AI가 인터넷 경제를 파괴하고 있다: 기계 트래픽이 인간을 초과할 때, 콘텐츠 유료화 모델은 강제적으로 재시동된다
작성자: Shoal Research
편집: TechFlow
TechFlow 가이드: Cloudflare 최신 데이터에 따르면 AI 봇 트래픽이 전 네트워크 HTML 요청의 60%를 차지해 처음으로 인간을 능가했다. 이는 개방형 인터넷을 20년간 지탱해온 '콘텐츠 대 트래픽' 모델이 붕괴하고 있음을 의미하며, 동시에 '요청 당 과금(Pay-per-request)' 방식의 새로운 인프라는 아직 준비되지 않았음을 시사한다. 콘텐츠 크리에이터, 광고주 및 검색 트래픽에 의존하는 모든 실무자에게 이는 알고리즘 업데이트보다 더 근본적인 생존 문제다.
2026년 3월 19일, Cloudflare 최고경영자(CEO) 매튜 프린스(Matthew Prince)는 생성형 AI의 영향으로 봇 트래픽이 2027년에 인간 트래픽을 넘을 것이라고 예측했다. Cloudflare는 전 세계 최대의 콘텐츠 배포 네트워크(CDN)로 인터넷의 약 20%를 커버한다. 불과 몇 달 후, 프린스는 에이전트 기반 트래픽의 성장 속도가 너무 빨라 이미 로봇이 인간 트래픽을 앞질렀다고 발표했다. Cloudflare 네트워크에서 HTML 콘텐츠 HTTP 요청 중 봇은 약 60%, 인간은 38.2%를 차지한다. 자동화 시스템이 생성한 HTML 페이지 요청 비중이 인간을 초과하고 그중 AI 에이전트의 비율이 꾸준히 상승함에 따라, 인터넷 생존의 기반이었던 비즈니스 모델이 무너지고 있다.

개방형 인터넷을 살찌게 한 그 거래
월드 와이드 웹(WWW)은 전례 없는 글로벌 정보 민주화를 실현했으며, 이 사명을 뒷받침하는 것은 간단 명료한 '콘텐츠 대 트래픽' 교환 시스템이다. 출판사가 네트워크에 콘텐츠를 게시하면, 검색 엔진은 사용자가 검색할 때 해당 웹사이트의 독자를 유입시킨다. 출판사는 정보나 엔터테인먼트 형태의 콘텐츠로 네트워크에 공헌하고, 검색 엔진은 관련 웹페이지로 독자를 유도하며, 광고주는 사용자들이 접속한 웹페이지에 타겟팅된 광고를 게재하여 이번 방문을 수익화한다. 이러한 순환 구조가 시너지를 내며 수십억 달러 규모의 광고 산업을 구축했고, 유료 장벽 없는 개방형 인터넷을 부양했다.
이 거래는 방대한 무료 접근성 정보를 부양하는 동시에 유통 권한을 검색 및 광고 플랫폼에게 집중시켰다. 행동 기반 광고, SEO 최적화된 콘텐츠 밀집도, 트래픽 추구의 콘텐츠 생산을 보상함으로써 출판사가 추천 트래픽과 주목(tracking attention) 트래픽에 깊이 의존하도록 만들었다. AI는 이미 취약한 이 거래 중 '추천' 메커니즘을 침식하고 있으며, 대체 솔루션은 아직 준비되지 않았다.
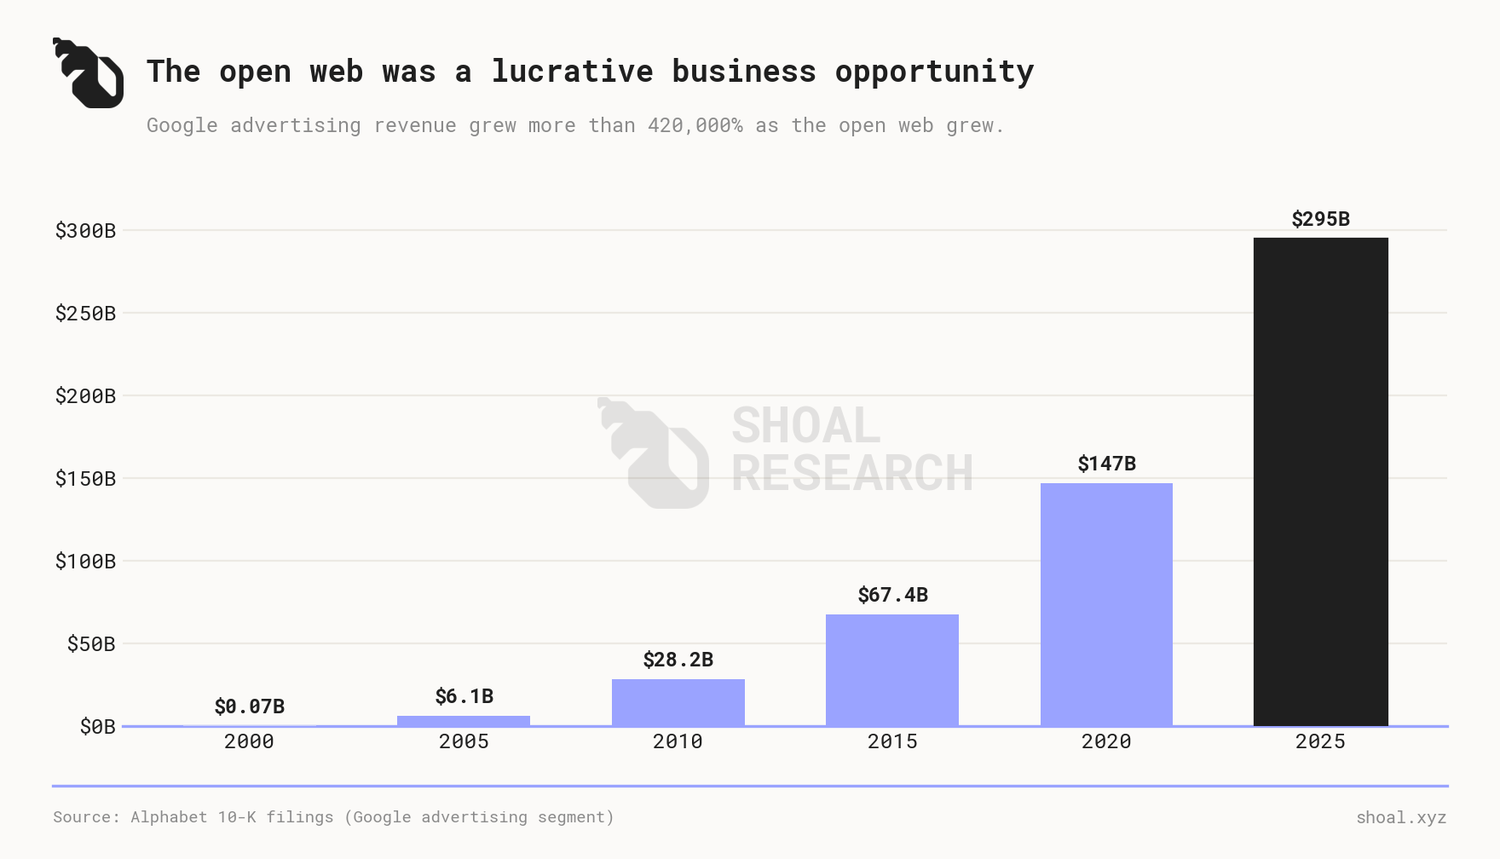
구글의 광고 수입은 2001년 6,690만 달러(광고 수입을 최초로 완전히 공개한 해)에서 2025년 2,947억 달러로 증가했으며, 약 4,400배 불어났다.
그러나 최근 몇 년간 AI 채팅봇 애플리케이션의 폭발적 성장은 웹 정보 탐색에 완전히 새로운 패러다임을 도입했다. 설계상 이러한 AI 애플리케이션은 사용자 편의성을 최우선으로 고려하여 대상 Audience를 채팅 인터페이스 내부에 묶어둔다. 이는 사용자에게 편리하지만 출판사에게는 치명적이다. 검색 엔진은 독자를 콘텐츠 원본 웹사이트로 안내하지만, AI 애플리케이션은 정보를 압축·요약하여 사용자의 질문에 대한 최종 답변의 일부로 직접 제시한다. 출판사는 사용자와의 직접적인 연결고리를 잃고 인간 기반 방문 수도 감소하면서 웹사이트 트래픽으로 수익을 창출하기가 점점 어려워지고 있다.
부상하는 해결책 중 하나는 인터넷 상 콘텐츠와 검색을 위한 완전히 새로운 '요청 당 과금(Pay-per-request)' 결제 인프라를 도입하는 것이다. 본고에서는 AI가 어떻게 '인터넷을 무너뜨리는지', 해당 솔루션의 두 가지 상이한 경로, 그리고 이 신흥 요청 당 과금 네트워크가 현재 어떤 상태인지 살펴본다.
AI 크롤러와 콘텐츠-트래픽 교환 시스템의 몰락
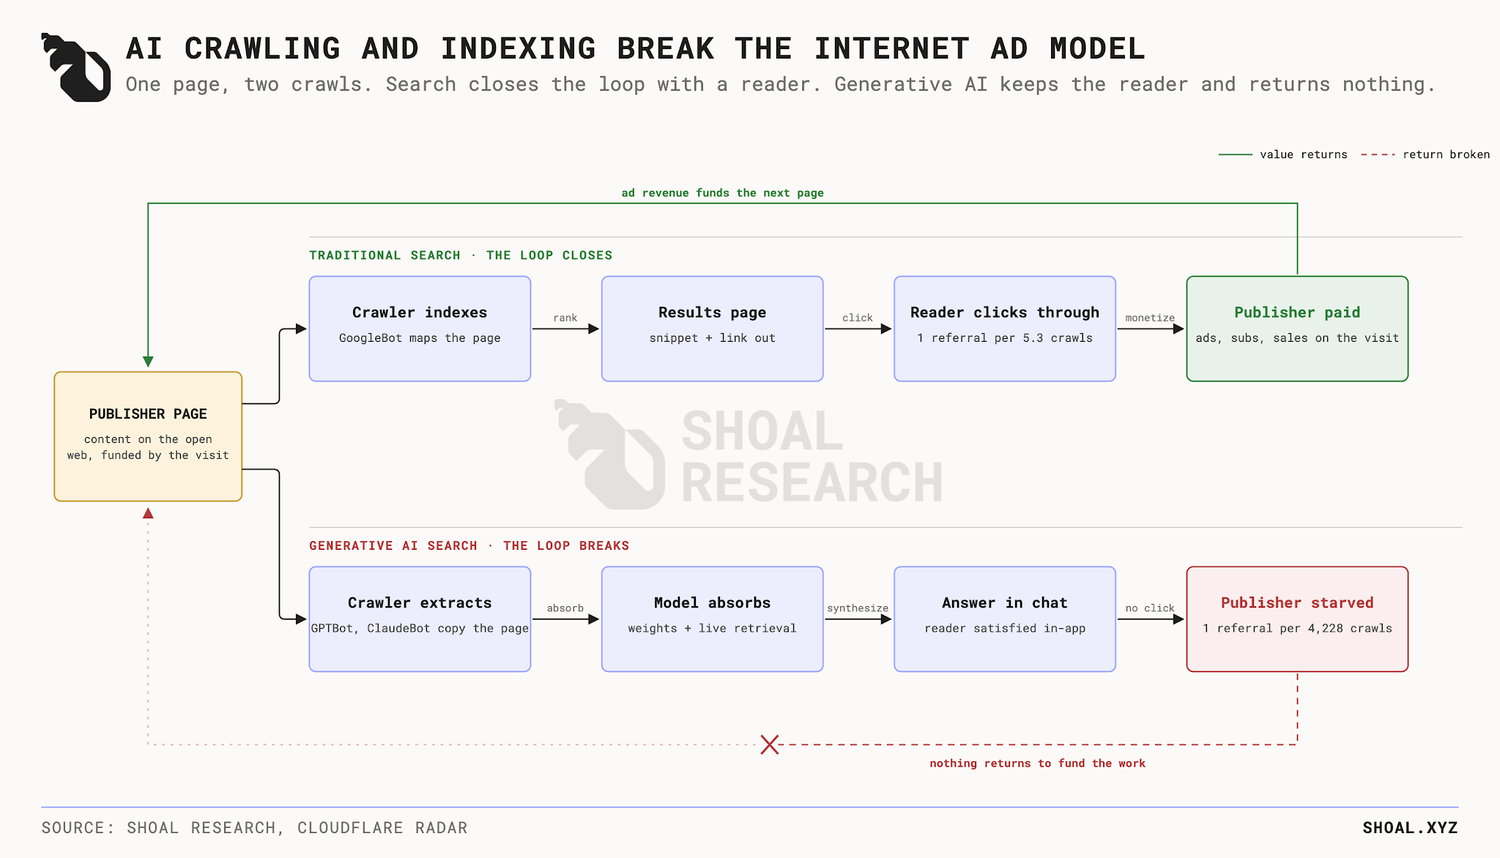
검색 엔진은 크롤러(웹페이지 인덱스를 구축하는 자동화 프로그램)를 사용하여 네트워크의 '지도'를 만든다. 전통적인 콘텐츠 대 트래픽模式中, 출판사는 검색 엔진이 인간 독자를 다시 자신의 웹사이트로 유입시켜주는 것을 대가로 이러한 크롤러가 텍스트를 무료로 복제하는 것을 허용한다. 이러한 액세스를 관리하기 위해 업계는 robots.txt라는 텍스트 파일을 의존하는데, 이는 암호화되지 않고 자발적으로 준수하는 명예 시스템이다. robots.txt가 오랫동안 원활하게 작동할 수 있었던 이유는 이를 무시하는 것이 곧 출판사 콘텐츠에 대한 접근권을 상실함을 의미하며, 이는 직접적으로 검색 엔진의 네트워크 인덱싱 품질을 저해하기 때문이다.
생성형 AI 애플리케이션은 크롤러를 인덱싱 도구에서 능동적 소비자로 전환시킴으로써 웹의 콘텐츠-트래픽 교환 구조를 무너뜨리고 있으며, 이는 훈련 단계와 실시간 검색 단계에서 가장 뚜렷하게 나타난다. 훈련 단계에서 GPT나 Claude와 같은 대형 언어 모델(LLM)은 다양한 도서, 기사, 코드, 예술작품을 포함해 개방형 네트워크에서 수집한 방대한 어구를 학습한다. 모델은 전체 인류의 지식에 대해 훈련을 마치면 출처 링크 없이 제작자에게任何费用도 지불하지 않은 채 결과를 사용자에게 제공한다. 실시간 검색 단계에서는 모델을 사용자가 질문한 그 순간 실시간 네트워크를 인덱싱하여 관련 단락을 가져온 후 재포맷한다. 모델은 원문을 독자에게 전달하지 않고, 정보를 새로운 인라인 응답으로 재기술하여 사용자의 질문에 완전히 답한다. 크롤러는 한 페이지에 대해 한 번만 인덱싱하면 되고, 모델은 발견한 내용을 수백만 명의 독자에게 제공하지만, 그 중 어느 누구도 원본 출처로 되돌아가지 않는다.
영향
추출 메커니즘을 행위 데이터, 연방 소송, 그리고 예술적 착취와 함께 고려했을 때, 개방형 네트워크의 기반이 구조적 붕괴를 겪고 있다는 사실이 점차 선명해지고 있으며, 그 영향은 이미 상호 연관된 여러 영역에서 나타나기 시작했다.
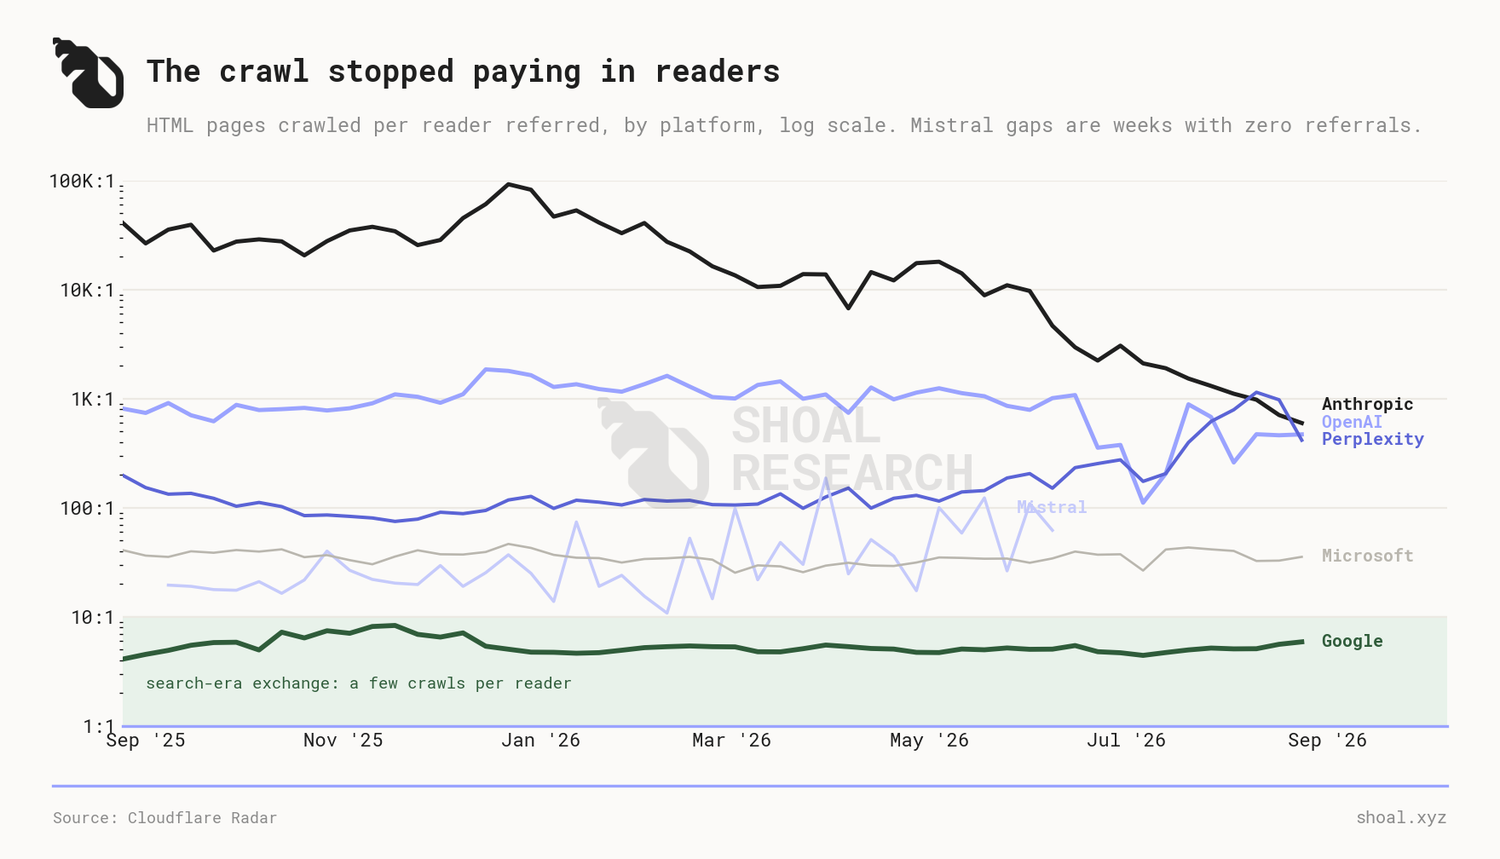
AI 크롤러의 행동에 미치는 영향은 '크롤링-유입비(crawl-to-dispatch ratio)'로 측정할 수 있는데, 이는 크롤러가 가져간 페이지 수와 실제 돌려보낸 사용자 수의 비율이다. Cloudflare 데이터에 따르면 지난 6개월 동안 훈련용(43.9%) 및 훈련+검색용(41.5%) 크롤러가 Cloudflare 네트워크에서 관측된 식별된 AI 크롤러 요청의 85% 이상을 차지했다. Googlebot은 방문자 1인당 여전히 약 5개의 페이지를 크롤링해야 하는데(지난해 기준 5.3건), 이는 역사적 교환 수준에 가까우며 각 주요 AI 플랫폼은 이 수치보다 1~3자릿수 높다. 지난 1년 간 Anthropic의 ClaudeBot은 원본 사이트 방문자 1인당 평균 4,200페이지를 크롤링했으며, Mistral은 884개, OpenAI는 731개, Perplexity는 147개였다. Cloudflare는 고유 앱(native apps)에서 오는 유입이 리퍼러 헤더(referrer header)를 포함하지 않으므로 이러한 비정상이 과장되었을 수 있다고 지적한다. 퍼듀 연구소(Pew Research Center)의 한 연구에 따르면 AI 요약이 검색 쿼리를 가로채면 인간 클릭률은 15%에서 8%로 하락하고, 요약을 통한 직접 클릭 귀속은 1%로 떨어지며, 사용자는 26%의 경우 세션을 완전히 중단한다.
AI 크롤러는 법적 소송도 촉발했다. Bartz v. Anthropic 사건에서 William Alsup 판사는 합법적으로 획득된 도서를 활용한 학습은 변환적(transformative) 성격을 띠고 있어 새 무언가를 창출할 뿐 책 자체를 대체하지 않는다는 이유로 합리적 사용(fair use)에 해당한다고 판결했으며, Anthropic이 다운로드한 무단 도서 컬렉션에 대한 혐의는 심리 단계에 들어갔다. 이후 Anthropic은 이 혐의를 15억 달러에 사적으로 합의했다. 약 50만 권의 작품으로 환산하면 작품당 약 3,000달러 수준이다. 이 결과는 학습 과정이 합리적 사용에 해당한다는 판정이 유지되었으며, 합의가 본래 훨씬 높은 법정 손해배상을 배제했기 때문에 폭넓게 Anthropic의 승리로 해석된다. 사건이 합의되면서 무단 콘텐츠 학습의 실제 비용이 얼마인지 확인한 법원은 없다. 동시에, <뉴욕타임스> v. OpenAI 및 마이크로소프트 사건은 진행 중이며, OpenAI로 하여금 유료 구독을 대체하기 위해 모델이 기사를 얼마나 많이 복사하는지 조사하는 일환으로 ChatGPT 대화 로그 2,000만 건을 제출하도록 강요하고 있다.
이러한 사례들은 AI 크롤러가 계량화되지 않은 방식으로 데이터를 크롤링하는 비용이 특히 독립 크리에이터와 시각 예술가들에게 부과되고 있음을 드러낸다. 2025년 초 OpenAI가 지브리 스타일 렌더링 능력을 발표했을 때, 이는 기존 저작권 보호가 얼마나 취약한지를 정확히 드러냈다. 미국 법률은 작품의 구체적 표현은 보호하지만 전체 스타일은 보호하지 않기 때문에, AI 모델은 수십 년간의 인간 노동을 통해 확립된 예술 미학을 체계적으로 복제할 수 있으며, 제작자를 언급하거나 보상할 필요조차 없다. OpenAI 정책은 생존한 작가인 하야오 미야자키 이름 프롬프트 사용을 금지하면서도 '지브리(Ghibli)' 프롬프트는 완전히 허용한다. 토끼 등 구체적인 캐릭터는 보호되지만 일반적인 지브리 스타일은 보호되지 않아, 모델이 그런 화면을 생성할 수 있는 이유는 단순히 해당 스튜디오 영화를 학습 자료로 사용했기 때문임에도 불구하고 예술가들에게 거의 법적 근거가 없다. 요청 당 과금 인프라는 위의 모든 피해를 해결할 수 없다. 이는 미래의 작품 접근에 대해 계량화와 보상을 제공할 수는 있지만, 예술가가 이미 학습에 사용한 자료를 소급하여 보상하거나 모델이 이미 습득한 스타일을 재현하는 것을 방지할 수는 없다. 이러한 피해에는 별도의 라이선스, 저작권, 집행 구제 조치가 필요하다.
요컨대, 콘텐츠-트래픽 교환 붕괴에 대응하는 두 가지 주요 조치(소송 및 개인 라이선스 협상)는 확장 가능한 비즈니스 모델이라기보다 임시 응급처치에 불과하다. 지금까지 소송은 과거 크롤링 행위에 대한 가격을 책정했을 뿐 지속적인 혹은 향후 크롤링에는 손도 대지 못했고, 민간 양자 라이선스 계약은 대형 미디어 그룹으로 하여금 아카이브 접근 권한을 AI 연구소에 직접 판매하게 했다(예: OpenAI와 NewsCorp 간의 2억 5천만 달러 계약, 또는 구글이 연간 6,000만 달러를 Reddit과 나누기로 했다는 보도). 가격이 만만치 않음에도 시장 조사 결과 이러한 민간 거래는 대부분 라이선스 부여 기관이 예상하는 AI 수입의 1% 미만이었다. 그러나 이러한 계약을 협상하는 데는 막대한 재정과 법적 자원이 필요하므로, 인터넷의 독립적 롱테일(수백만 명의 독립 콘텐츠 제작자)은 여전히 AI 크롤러에 대규모로 대응할 방법을 확보하지 못하고 있다.
상황이 점차 명확해졌다. robots.txt 기반의 비암호화 신뢰 체계와 개방형 인터넷을 30년 가까이 지탱해온 콘텐츠-트래픽 교환은, 경제적으로 데이터 소비를 유입 트래픽보다 우선시하며 크롤러가 최우선 소비자 역을 수행하는 인터넷을 감당할 수 없게 되었다. 과거 출판사는 100%의 콘텐츠 생산 비용을 부담하는 대신 100%의 소비자 트래픽과 주의력을 얻었기에 이에 쾌히 동의했다. 반면 생성형 AI는 콘텐츠를 완전히 소비하지만 사실상 귀인을 제공하지 않으며, 이는 출판사가 광고나 구독 수익을 창출하는 데 필수적인 인간 네트워크 트래픽의 근원을 실제로 차단하는 결과를 낳았다. 결국 출판기는 기계 크롤링으로 인해 발생하는 고액 호스팅 요금을 지불하면서도 정작 트래픽은 얻을 수 없었다. 이러한 압력은 동시에 두 방향에서 발생한다. 로봇 1대를 서비스하는 데 드는 대역폭과 계산 비용은 독자 1인에게 제공하는 것과 동일하지만, 로봇은 떠나갈 때 광고를 보지도 않고 구독을 시작하지도 않는다. 크롤링-유입비가 수백에서 수천에 달하는 상황에서, 출판사가 수익을 낼 수 있는 방문 1회당 수천 건의 요청을 유료로 서비스해야 한다. 출판기가 로봇이 텍스트를 무료로 복제하도록 하는 서버 비용만으로는 감당할 수 없으므로, 인터넷은 창작자가 산출물에 대해 대가를 받을 수 있도록 보장할 새로운 방식을 필요로 한다. 독자가 웹사이트를 방문하는 대신 AI 요약을 읽는다면, 출판가는 인간 주의력만으로 수익을 올릴 수 없다. 따라서 수익화의 시점은 AI 로봇이 실제로 데이터를 크롤링하는 순간으로 이동했으며, 논리적인 다음 단계는 새로운 네이티브 온라인 요청 당 과금 결제 인프라를 도입하는 것이다.
요청 당 과금(Pay-per-request) 네트워크
요청 당 과금 모델을 인터넷 전반으로 확장하려면 콘텐츠와 서버 접근을 효율적으로 계량화할 방식이 필요하다. 비록 이러한 활동의 상당 부분이 AI 크롤러에 의해 주도되고 있더라도, 이 프레임워크는 데이터 소스와 자동화 API를 포함한 모든 비인간 상호작용에 적용 가능하다. 쉽게 말해 유료 콘텐츠에 접근하려면 한 소프트웨어가 다른 소프트웨어에게 프로그래밍 방식으로 결제를 수행해야 하며, 이 과정을 공식적으로는 머신 페이킹(Machine Payment)이라 부른다.
대규모 머신 페이킹을 지원하기 위해 인프라 기업들은 네트워크 라우팅 레이어에 자동 청구 게이트를 구축하여 요청이 발생한 밀리초 단위 시점에 봇에게 요금이 부과된다. 다만, 구현 방식은 크게 두 가지 상이한 방법으로 나뉜다. 첫째는 폐쇄형 마켓플레이스(Closed Marketplace) 모델로, 크롤러가 계정을 등록하고 고유한 디지털 키를 받아 중간 라우팅 프록시를 통해 웹사이트에 접근하도록 요구한다. 둘째는 개방형 프로토콜(Open Protocol) 모델로, 표준화된 공용 소프트웨어 규칙, 머신 가독성 헤더(machine-readable headers) 사용 및 광범위한 디지털 트랙(digital tracks)에서의 결제 정산을 지원하는 방식으로 설계되었다.
폐쇄형 마켓플레이스
게이트드 마켓(gated marketplace) 모델은 웹페이지 콘텐츠를 기업 중재자가 관리하는 사적 자산으로 간주한다. 이 프레임워크 내에서 머신 페이킹 전에 먼저 인증과 접근 허가가 완료되어야 한다. 퍼블리셔는 네트워크를 구성하여 수신 중인 AI 크롤러를 인간 사용자를 대상으로 하는 공개 웹사이트에서 마켓플레이스 제공업체가 관리하는 전용 서브도메인으로 리다이렉트한다. 이 게이트웨이에서 플랫폼은 데이터베이스를 대조하여 크롤러의 자격 증명을 확인하고, 퍼블리셔가 설정한 맞춤형 접근 규칙을 평가하며, 사용량을 기록한 후 페이지를 머신 가독성 텍스트로 포맷한다. 금융 거래는 인터넷 프로토콜 계층 외부에서 진행된다. 봇이 요청을 시작하면 마켓플레이스는 해당 사용 기록을 남기고 AI 기업이 사전에 충전한 신용 잔액에서 차감한다. 결제는 Stripe Connect 등의 머천트 플랫폼을 통해 법정화폐로 정기적으로 이루어지는데, 매 요청마다 신용카드를 사용할 경우 수수료가 요청 자체의 가치보다 높아질 수 있기 때문이다. AI 크롤러와 퍼블리셔 원천 서버 사이에 직접 중재자를 배치하는 것은 보안 극대화, 공격성 트래픽으로부터의 서버 보호, 검증된 기업 파트너만 접근할 수 있도록 보장하는 데 도움이 된다. 그러나 이러한 프레임워크가 대규모로 시행되면 개방형 네트워크가 라이선스 기반의 스토어로 구성된 네트워크로 변모하여 인간 사용자의 경험을 더욱 악화시킬 수 있다.
초기 웹 기반 프로세스화 요청 당 과금 결제 인프라는 게이트드 마켓 유형이었으며, 가장 유명한 사례는 TollBit와 Cloudflare 요청 당 크롤링 첫 번째 버전(V1)이다. TollBit는 AI 에이전트 네트워크 트래픽을 관리·모니터링하고 수익화하는 플랫폼이다. 이를 배포하려면 퍼블리셔는 전용 서브도메인(예: https://tollbit.thedailydispatching.com/)을 설정해야 하며, 서버는 AI 크롤러가 메인 사이트에 접근 시도할 것을 감지하면 자동으로 TollBit 서브도메인으로 리다이렉트한다. 크롤러는付费 후에만 접근 권한을 얻는다. TollBit는 해당 AI 기업이 등록된 청구 계정을 보유하고 있는지 검사하고, 봇이 요청한 페이지 수를 기록하며, 깨끗한 텍스트 형식으로 데이터를 제공함과 동시에 미화로 결제를 처리한다. 여기에는 API 키가 필요하므로, 오늘날 콘텐츠 발견 비용은 셀프서비스 방식이 아니다. AI 개발자는 반드시 먼저 TollBit에 등록해야 한다.
2025년 7월 1일, Cloudflare는 최초의 요청 당 크롤링 모델을 출시했다. Cloudflare는 DNS(도메인 시스템)와 CDN(Content Delivery Network) 레벨에서 운영되므로, 트래픽이 콘텐츠 퍼블리셔의 물리적 원천 서버에 실제 도달하기 전에 이미 처리된다. 요청 당 크롤링 V1에서 Cloudflare는 에지(Web Application Firewall, WAF) 기능을 통합하여 기본적으로 네트워크상의 알려진 AI 크롤러를 자동으로 감지하고 차단한다. AI 크롤러가 요청 당 크롤링으로 보호받는 도메인에 접근하려고 할 때, Cloudflare는 요청이 퍼블리셔 웹페이지에 도달하기 전에 이를 차단하며, 웹사이트 소유자가 콘텐츠를 수익화하기로 선택한 경우 결제 절차를 진행한다.
게이트드 마켓의 과제
TollBit는 개발자 API 설정, 고유 키 및 전통적인 은행 채널에 의존해 결제를 진행한다. Stripe 등의 머천트 네트워크를 통해 요청 당 거래를 라우팅하면 고정된 거래 처리 수수료(일반적으로 약 30센트 + 일정 비율)가 발생하여, 1달러 미만의 단일 실시간 요청을 경제적 비효율로 만든다. 이러한 비용 장벽을 우회하려면 인간 개발자가 게이트드 마켓 중재자에 수동으로 계정을 등록하고, 고유한 API 키를 생성하며, 신용카드나 은행 이체로 잔액을 사전 충전해야 한다. 플랫폼은 이후 여기서 차감한다. 따라서 에이전트 및 기타 자율 소프트웨어는 현재로서는 독립적으로 필요에 따라 데이터를 발견하고 구매하지 못한다. 대신 인간 관리자가 상업용 계정을 수동으로 생성하고, 각 별도 제공업체 사이의 변동하는 잔액을 모니터링하며, 보안 키를 조정해야 한다.
AI 중심 프로세스의 많은 부분에서 인간 개입이 필수 불가결하긴 하지만, 게이트드 마켓 모델을 사용하여 웹 페이지 콘텐츠 접근을 대규모로 관리하면 예측 가능하고 선형적인 네트워크 트래픽 패턴을 기본 가정으로 삼게 되며, 이는 현대 소프트웨어의 동작 현실과 직접적으로 충돌한다. AI 에이전트와 크롤러는 사용자의 프롬프트에 따라 동적으로 탐색 경로를 선택하는 추론 루프를 사용하므로, 작업에 필요한 정확한 데이터를 포함하는 익숙지 않은 도메인을 자주 마주치게 된다. 작업 도중 멈춰서 수동 인간 개입을 요청하면 실행 병목 현상이 빠르게 발생하여 사용자 경험을 파괴한다. 고정 요금제는 이 경우에 최고의 솔루션이 되지 못한다. AI 에이전트는 명령 수신 시 언제든지 실행되며, 이는 종종 예측 불가능한 집중적 버스트(예: 한 사람이 연구 집중 프로젝트를 3일간 수행한 뒤 2주간 휴식하는 경우) 형태로 나타난다.
사전 자금 예치금과 보호된 콘텐츠 및 데이터 접근을 위한 맞춤형 소프트웨어 통합 사이에서, 게이트드 마켓은 본질적으로 매우 라이선스 기반 시스템이다. 한편, 웹 퍼블리셔는 숙련된 테크기업으로부터 통제되고 검증된 트래픽을 받을 수 있지만, 다른 한편으로는 여러 별도 플랫폼에서 사전 충전 계정을 관리하는 행정 및 재정 부담이 비익명 접근을 제한하고, 독립 개발자의 자발적 크롤링을 방해하며, 대규모 기업 트래픽이 부족한 중소규모 퍼블리셔의 수익화 기회를 감소시킨다. 반면, 직접적인 머신 투 머신(기기 간) 금융 핸쉬크는 퍼블리셔가 크롤러가 요청할 텍스트와 데이터에 미세 요금을 부과할 수 있게 해준다. 이 디자인 철학이 개방형 프로토콜 모델의 기초를 형성한다.
개방형 대안: x402 및 MPP
개방형 프로토콜은 공개적이고 표준화된 통신 규칙 위에 구축된 네트워크 아키텍처다. 현대 네트워크의 대부분은 여전히 사용 중인 HTTP, SMTP, TCP/IP 등 개방형 프로토콜 기반으로 형성되어 왔다. 최근 몇 년간, 30여 년간 보존되었으나 사용하지 않던 HTTP 402 상태 코드는 블록체인 트랙을 사용하는 개방형 프로토콜 위에서 머신 페이킹을 지원하기 위한 핵심 네이티브 웹 인프라 구성 요소로 자리 잡았다.
HTTP 402를 활용한 비트코인 결제 실험은 2015년까지 거슬러 올라가며, 선도 프로젝트로는 21co Bitcoin Computer와 라이트닝 네트워크(Lightning Network)의 L402가 있다. 2025년 5월, x402 프로토콜이 최초로 안정적인 코인(stablecoin)을 HTTP 402 플로우에 도입했으며, Stripe와 Tempo의 협력 머신 페이킹 프로토콜(MPP) 같은 노력들은 안정적인 코인 외에도 비트코인과 신용카드 결제를 지원한다. 신용카드 옵션은 1달러 미만의 미결제보다는 거시적 거래용으로 설계되었는데, 고정된 카드 사육 수수료가 1달러 미만의 요청을 흡수하기 때문이다. 안정적인 코인은 여전히 요청당 가격 매기기를 실현 가능한 상태로 만드는 핵심 트랙이다.
x402는 제3자 계정 등록이나 고유 클리어링하우스 없이도 결제 지시를 데이터 교환 코드에 직접 내장한다. AI 크롤러가 웹페이지를 요청할 때 호스트 서버는 연결 메타데이터에 머신 가독성 응답(페이먼트 헤더)을 직접 삽입한다. 이 헤더 정보는 각 요청의 정확한 가격, 지정된 결제 네트워크, 수취인의 디지털 청구 주소를 제공한다.
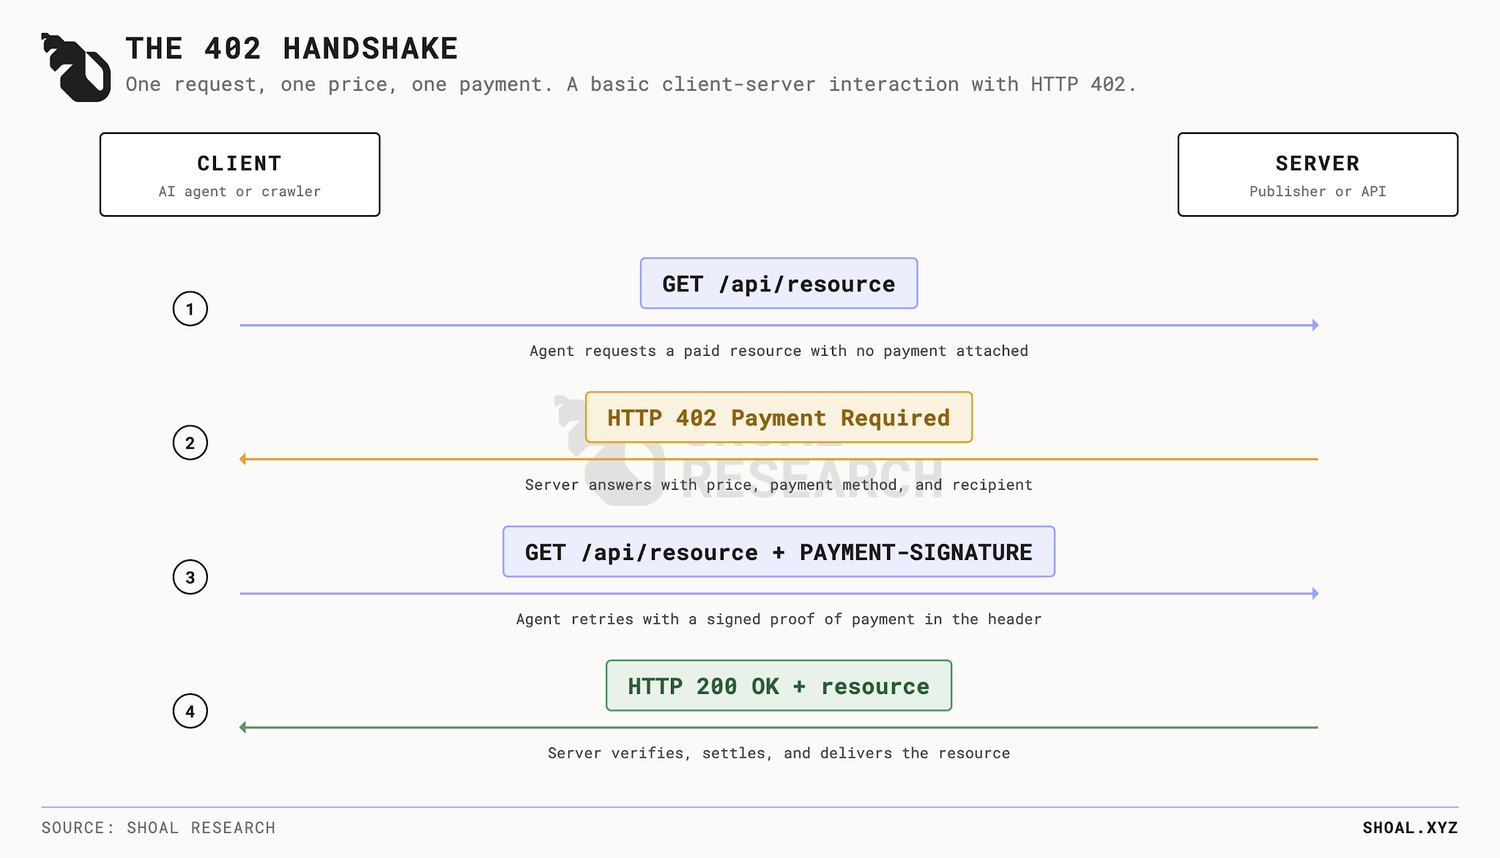
블록체인은 머신 페이킹을 촉진하는 데 있어서 점점 더 중요한 역할을 수행하고 있는데, 이는 왜냐하면 불변성과 프로그래밍 가능성이 특징인 금융 레이어를 제공하여 기본 속도 및 자동화 수준이 소프트웨어 로직과 일치하기 때문이다. Stablecoin 등 암호화폐는 구조적으로 네트워크 내 AI 에이전트와 밀접한 관계를 맺고 있다. 이는 AI 에이전트와 크롤러가 동일한 네트워크 네이티브 인프라 위에서 실행되며, 소프트웨어 코드 형태로 존재하여 간단한 API 엔드포인트 및 암호화 서명을 통해 통합될 수 있기 때문이다. 블록체인 트랙을 사용한 결제 비용과 수수료는 여전히 현저히 낮으며, 주요 고투플체인(upstream chain)에서 송금 1회당 일반적으로 몇 분의 1달러밖에 들지 않아 신용카드와 핀테크사보다 훨씬 저렴하다(점점 많은 핀테크사들이 이를 좁히려는 노력을 기울이고 있으나, 예를 들어 Wise 등).
블록체인 트랙은 설계 단계부터 각 결제에 대해 암호화된 영수증과 검증을 제공한다. 각 요청당 과금 사이클은 구매자의 디지털 서명, 요청된 URL, 정확한 타임스탬프가 포함된 영구 저장 영수증을 제공한다. 이러한 지시가 공개 블록 체인에 저장되므로 모든 자동화 에이전트는 수신된 메타데이터를 파싱하고 호환 자산(예: 스테이블코인)을 사용하여 미결제 micro-payments를 실행하며 단일 연속 HTTP 핸드셰이크로 콘텐츠를 다운로드할 수 있다. 전통적인 은행 트랙의 정산은 청산소가 상용은행 장부 간 차수를 대조해야 하므로 보통 며칠이 소요되지만, 블록체인 정산은 네트워크 노드가 디지털 서명을 검증하고 전역 블록체인 상태를 갱신하는 즉시 완료된다. 앞서 언급했듯이 주요 체인에서는 보통 몇 초 만에 끝난다. 무엇보다 개방형 프로토콜 방식은 네트워크 데이터 접근을 표준화하여 모든 규모 퍼블리셔가 자산을 수익화할 수 있게 하며, 자금充裕한 자동화 계정을 보유한 개발자가 사전 허가 절차 없이 크롤링을 수행할 수 있게 한다.
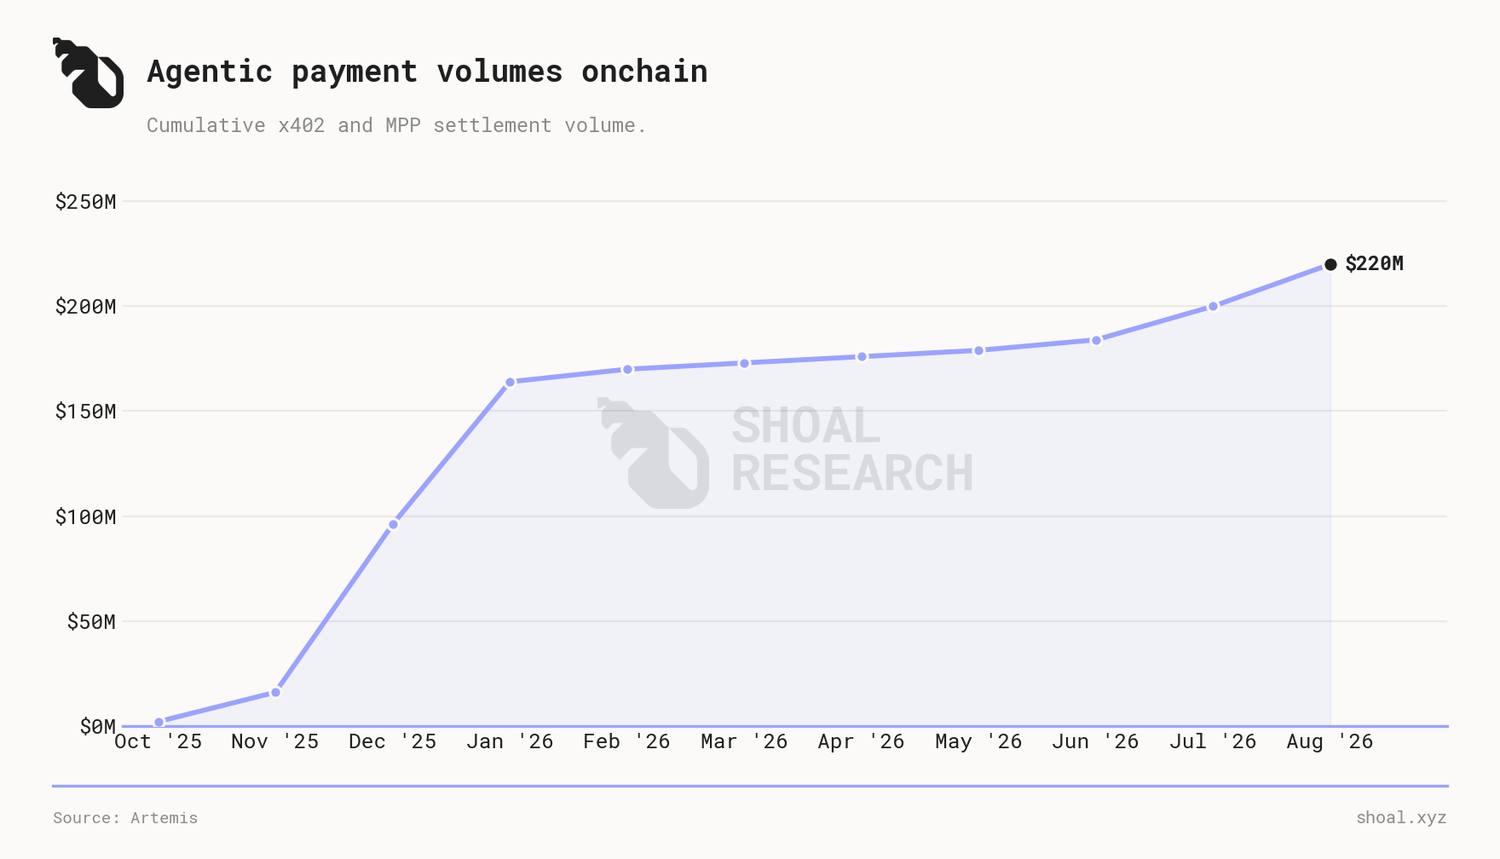
2026년 6월 15일, 아마존 웹 서비스(AWS)는 x402 프로토콜을 CloudFront 및 Web Application Firewall(WAF)에 직접 통합했다. 이 구성을 통해 인터넷의 약 4분의 1에 해당하는 부분이 기존 클라우드 콘솔을 통해 자동화 에이전트 청구 기능을 활성화하고 유료 봇에게 콘텐츠를 제공할 수 있다. Cloudflare도 뒤이어 나섰다. 기존 Pay-Per-Crawl V1은 Cloudflare가 기록상 머천트로 stripe를 통해 결제를 처리하도록 요구했지만, 새로운 Cloudflare Monetization Gateway는 결제 과정에서 Cloudflare를 완전히 배제하여 결제가 P2P 방식으로 판매자의 지갑으로 직접 라우팅되도록 했다.
폐쇄형 마켓플레이스와 개방형 프로토콜의 주요 차이는 누가 네트워크 콘텐츠 접근권을 구매할 수 있는지에 있다. 폐쇄형 마켓플레이스 모델에서는 접근이 큐레이션된 화이트리스트로 제한되며, AI 봇은 모회사에서 기업 계약을 수동으로 서명하고 중재 플랫폼의 신원 조사를 통과한 후에만 콘텐츠를 구매할 수 있다. 개방형 프로토콜 모드에서는 접근이 완전히 자동화되고 제한이 없으며, 인터넷상의 어떤 소프트웨어 프로그램이라도 자동 청구 계좌가 요청된 미세 요금을 즉각적으로 정산한다면 언제든 데이터를 즉시 구매하고 다운로드할 수 있다. 이 두 시스템이 인터넷 라우팅 네트워크에서 보급됨에 따라 퍼블리셔는 두 가지 상이한 인프라 옵션 간 선택에 직면한다. 폐쇄형 마켓플레이스 모델은 엄격한 보안 규정 준수, 법적 보상, 큐레이션된 기업 제휴관계를 최우선으로 생각하는 조직을 대상으로 한다. 반면 개방형 프로토콜 모델은 마찰 없는 미결제(microtransaction)가 필요한 자동화 워크플로우에 적합하며, 다양한 독립 개발자와 퍼블리셔 생태계가 행정적 장벽 없이 데이터 프로그램을 프로그래매틱 방식으로 교환할 수 있게 한다.
오늘날 AI 크롤러가 실제로 접하는 환경
요청당 과금 네트워크의 실제 커버리지를 측정하기 위해 Shoal Research는 2026년 8월 19일 AI 크롤러(GPTBot) 자격으로 주요 퍼블리셔 및 소비자 사이트 108곳을 스캔했다. 이후 샘플은 108개에서 500개 도메인으로 확대되었다. 이하 결과는 초기 8월 테스트 작동을 묘사한다. 각 요청마다 상태 코드, 리다이렉션 체인, 응답 헤더 및 챌린지 페이로드를 기록했으며, 수집 기간 중 데이터 무결성을 보장하기 위해 SHA-256 해시를 계산했다. 엔드포인트의 HTTP 402 응답이 Payment-Required / X-Payment-Required 헤더 또는 유효한 x402 JSON 챌린지 페이로드에서 해석 가능한 결제 매개변수를 반환할 경우에만 해당 엔드포인트를 x402 페이퍼블 또는 에이전트 페이퍼블로 분류한다.
108개 퍼블리셔 중 네트워크는 세 가지 주요 태세로 나뉜다: 무료 제공(49.1%, n=53): 53개 도메인이 HTTP 200 OK로 메인 페이지를 오픈하여 제한 없이 추출 가능. 경계 차단(33.3%, n=36 합계): 31개 도메인이 HTTP 403 Forbidden을 반환, 2곳이 인증 요구(HTTP 401), 2곳이 콘텐츠 협상 거부(HTTP 406), 1곳이 법적 차단(HTTP 451)을 반환.另外还有 3개 퍼블리처는 여러 시도 후 타임아웃. HTTP 402 반환(14.8%, n=16): 정확히 16개 퍼블리셔가 HTTP 402 Payment Required 상태 코드를 반환.
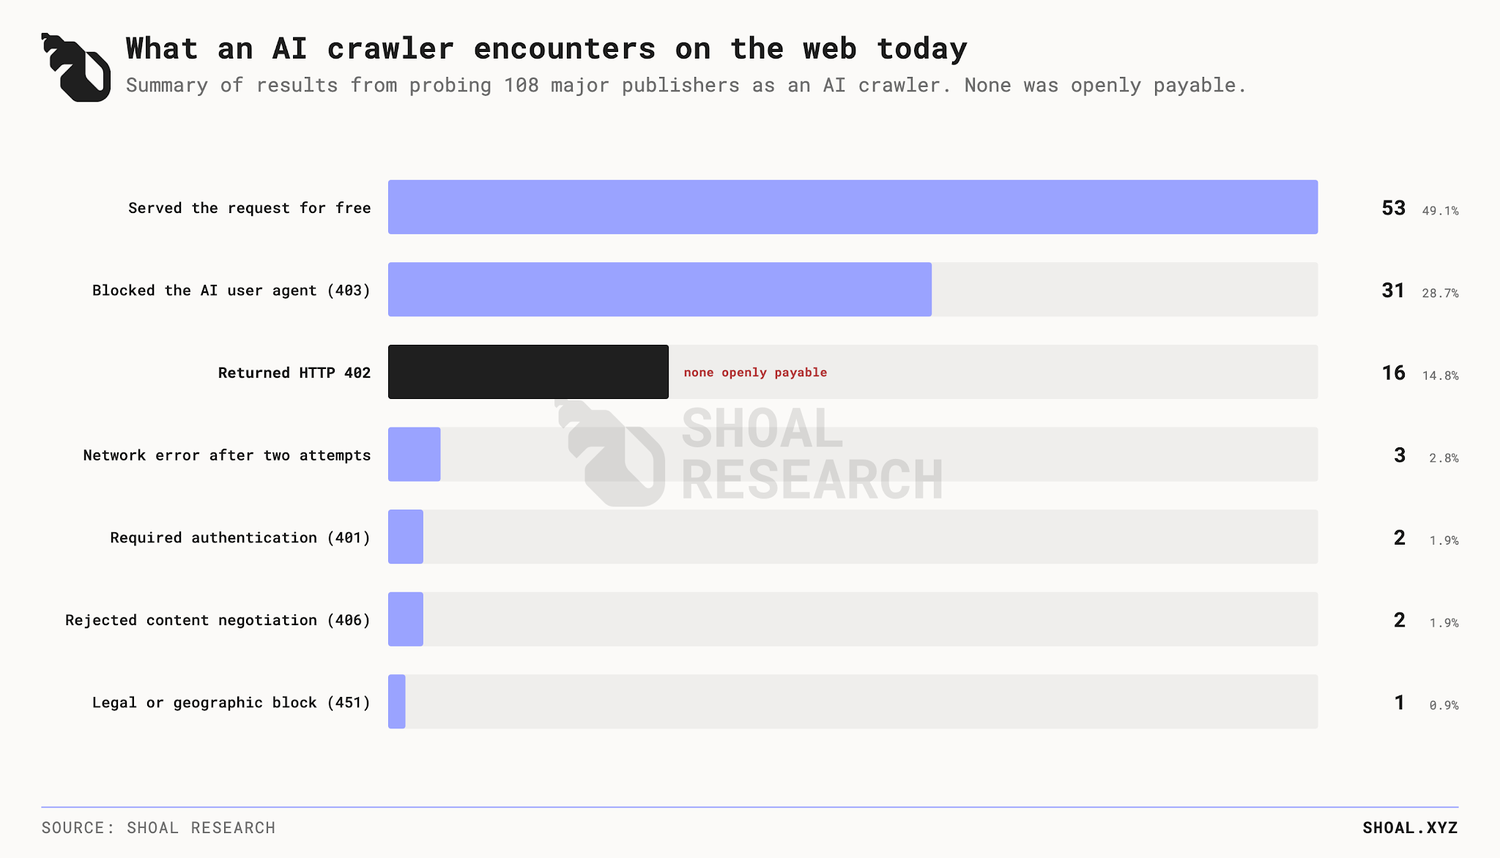
가장 중요한 점은 데이터셋에 속한 어떤 퍼블리셔도 개방형 머신 페이퍼블 챌린지를 반환하지 않았다는 사실이다.
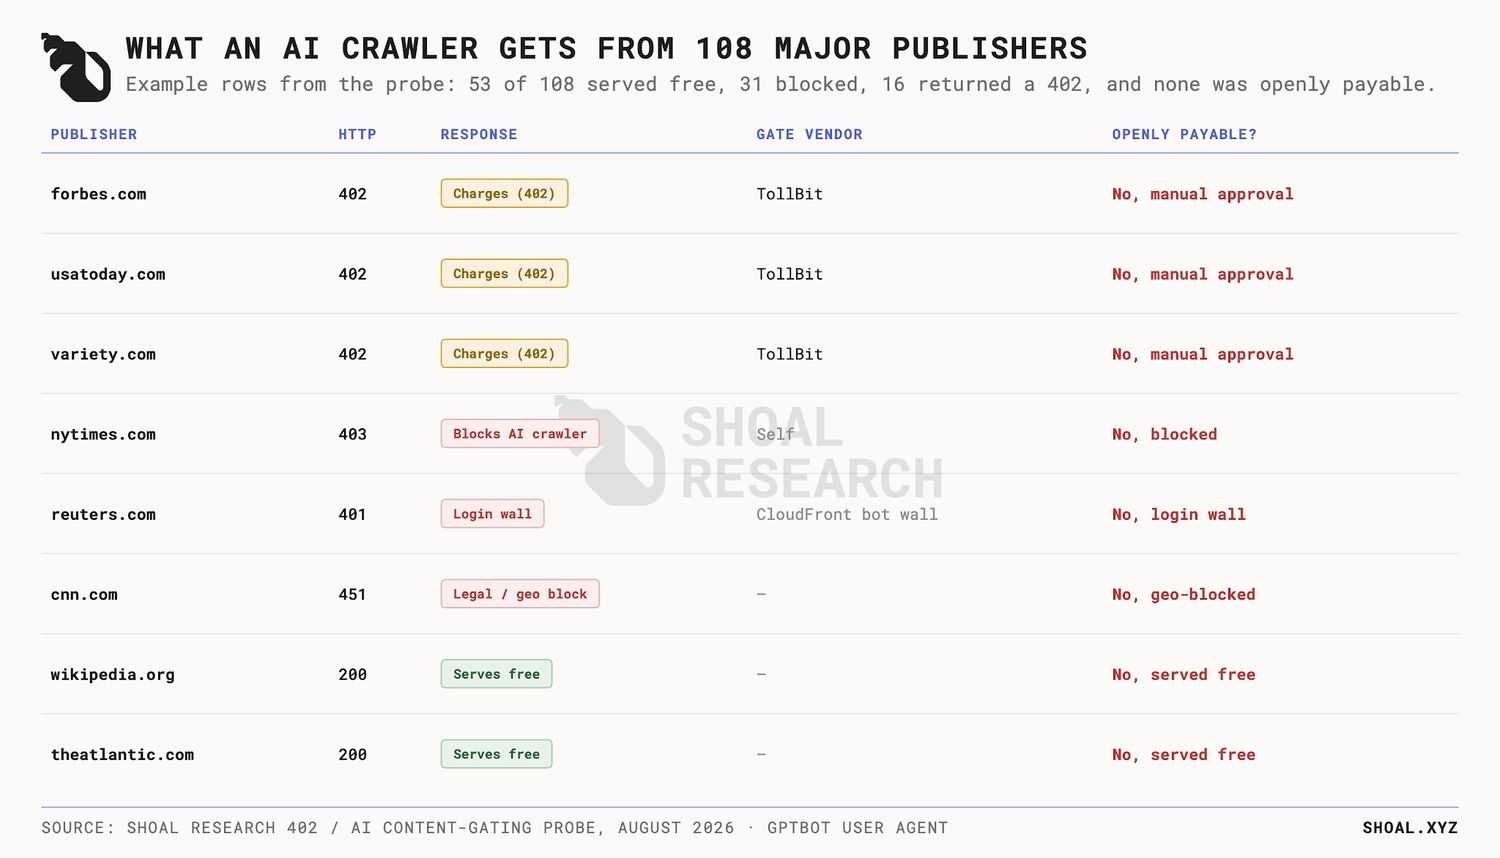
16개 HTTP 402 응답 중 10건은 TollBit Bot Paywall로 리다이렉션되었고, 6건은 정적 HTML 라이선스 문의 폼을 반환했다. 인증된 개발자 키를 사용하여 베이스라인 데이터셋 내 TollBit 관리 하에 있는 모든 13개 퍼블리셔에 대해 2차 검사를 수행한 결과, 모든 요금 쿼리에서 HTTP 403을 반환했다. API 페이로드는 콘텐츠 공급자가 프로그램 방식 접근을 비활성화했으며, 크롤링 당 가격费率을 반환하지 않았음을 명시적으로 나타냈다.
이러한 결과를 해석하는 한 가지 방법은 TollBit가 전통적 퍼블리셔의 초기 AI 파트너로서 사용량 기반 과금 방식 테스트 및 이해를 돕는 동시에, 통제된 에이전트 접근이 퍼블리셔에게 주는 제어력과 보안성을 유지하는 것이라고 볼 수 있다. 수동 개발자 등록, 고유 API 키, 기업 화이트리스트가 필요한 시스템은 동적 네트워크 경로에서 탐색하는 자율 에이전트의 unprecedented 규모로 확장하기 어렵다. 오히려 이는 전통적 수익을 보호하면서 영구적인 머신 네이티브 정산 표준이 수립되기를 기다리는 과도기적 조치다. 현재는 초기 단계에 있으며, TollBit와 같은 제공업체들은 이러한 서비스에서 파생된 접근, 라이선스, 자율성 사이의 균형을 어떻게 맞추고 정리할 것인지 모색 중이라고 판단한다.
또한 8월 19일 Coinbase CDP 레지스트리 전체를 푸칭하여 실제로 x402를 사용하고 있는 주체와 해당 네트워크에서 구동 중인 서비스를 파악했다. 해당 네트워크는 15,000개 이상의 엔드포인트를 보유하고 있으며 그중 수백 개가 활성 사용 중이다.
주요 콘텐츠 퍼블리셔들은 아직 x402를 채택하지 않았지만, 이러한 결핍 속에서 활발한 공급 측 시장이 형성되었다. 소비형 미디어는 아직 적극적으로 통합하지 않았으나, 개발자 도구, 전문 데이터 공급업체 및 에이전트 네트워크는 빠른 속도로 개방형 머신 페이징 엔드포인트를 배포했다. x402 생태계에서 식별 가능한 이름으로는 Tavily, Nansen, CoinGecko, Chainlink, Apify, Browserbase 등의 데이터 API와 최근 Ramp 등이 포함된다. x402 상의 상위 서비스 제공업체에는 ChatGPT, Claude, TripAdvisor, Perplexity 등이 있으나, 아직 대형 콘텐츠 퍼블리셔는 없다.
15,073개의 활성 엔드포인트는 소프트웨어가 개방형 공공 트랙에서 적극적으로 가격을 매기고 타 소프트웨어에 대한 프로그램 방식 접근권을 판매 중임을 시사한다. 해당 네트워크를 추적하는 일부 기관은 결합 시장을 통계에 포함하면 엔드포인트 수가 50,000개에 달할 수 있다고 보고했다. 그러나 이러한 엔드포인트는 여전히 크롤링, AI 도구 호출, 실시간 데이터 스트림에厳格하게 집중되어 있다. 전체 레지스트리를 주요 소비 미디어 및 출판 도메인(<뉴욕타임스>, 로이터, ESPN, 위키백과)과 교차 비교할 때 일치율은 0%다. 우리는 이러한 상황이 느리더라도 확실하게 변화할 것으로 예상한다. 일반적으로 유명 기관이 ‘국면을 띄우는(initiate)’ 것이 필요하기 때문이다. 네트워크 화폐화의 역사적 전환은 흔히 단일 incumbent이 ‘현재 상태(status quo)’를 깨뜨림에 따라 발생한다. <뉴욕타임스>는 2011년 미터링 페이월을 출시했고, AP통신은 2023년 상업용 AI 데이터 거래의 선례를 만들어 뉴스 그룹에서 <타임>, 컨데 Nast까지 이어지는 연쇄 반응을 일으켰다. 따라서 우리는 첫 라인업 출판사가 개방형 프로토콜(x402, MPP 등)에서 자체 접근권에 가격을 매길 때 나머지 시장 참여자가 빠르게 뒤따를 것으로 예상된다.
개방형 프로토콜 방식의 과제
개방형 요청당 과금 프로토콜의 인프라는 이미 구동 중이지만 시장 자체는 여전히 초기 단계에 있다. 개방형 결제 기술 파이프라인은 적극적으로 전개 중이며: 퍼블리셔는 머신 가독성 권리 프레임워크(RSL 등)를 보유하며, AWS CloudFront 및 Cloudflare의 호스팅 및 라우팅 게이트웨이는 요청이 발생한 밀리초 단위에서 청구를 실행할 수 있고, 정산 트랙은 신용카드부터 디지털 자산 및 스테이블코인까지 모두 갖추어져 x402 및 MPP 등의 프로토콜을 통해 누구나 접근 가능하다. 적극적인 채택을 막는 가장 큰 장벽은 완전히 수요 측에 위치해 있다.
첫째, 주요 AI 연구소 중 개방형 머신 페이킹 트랙을 통해 소비자급 네트워크 콘텐츠 라우팅용 크롤러 트래픽을 생산하는 곳이 없다. 이는 세 가지 주요 이유 때문이다. 첫째, 크롤러는 통합 지갑, 자동 구매 예산, 그리고 무엇보다 중요하게도 요청한 콘텐츠에 대해 실제 결제를 해야 하는 사업적 의무가 부족하다. 우리의 크롤러 테스트에서 확인할 수 있듯이 대부분의 네트워크는 여전히 완전히 진입 장벽이 없다. 이는 HTTP 402로 차단된 에이전트가 해당 URL을 직접捨棄하고, 개방형 무제한 경쟁사로부터 거의 또는 완전히 동일한 콘텐츠를 0비용으로 추출할 수 있음을 의미한다. 법적 환경은 이러한 역학을 강화한다. Federal rulings(William Alsup 판사의 Bartz v. Anthropic 사건 판결)에 따르면, 법원은 합법적으로 접근 가능한 저작물을 AI 모델 학습에 투입하는 것을 변환적 합리적 사용(fair use)으로 규정했다. Alsup 판사는 불법적으로 획득한 무단 데이터셋을 보관하는 행위를 비난했으나, 개방형 네트워크에서 접근 가능한 콘텐츠 학습에는 어떠한 저작권 책임도 지지 않는다. 공개 네트워크 텍스트 추출이 법적으로 무료이므로 AI 연구소는 개방형 미세 요금을 자발적으로 지급할 사업적 동기를 갖지 못한다.
AI 검색 제공업체의 보상 처리 방식
생산 측면에서의 채택은 여전히 제한적이지만, AI 검색 제공업체들은 이제 보상을 제품 설계의 일부로 인식하기 시작했다.
미공개 Shoal Signal 인터뷰에서 Parallel의 현장 배포 엔지니어 Son Do는 Index를 소개했다. Index는 출판사와 직접 협업하여 각 출처가 에이전트의 최종 답변에 기여한 정도를 측정하고 해당 출처들과 수익을 공유하는 프로그램이다. Do는 출판사와 기타 데이터 제공자가 사용량 기반 모드로 전환할 것이며, 에이전트 결제 트랙이 다수의 소액 거래를 지원하지 않을 것으로 예상한다. Index는 보상이 AI 검색 및 검색 제품의 설계 단계에 진입하고 있음을 보여주지만, 아직 주요 AI 연구소의 표준 구매 행태가 되지는 못했다.
법적, 경제적 측면에서의 의무 부재 외에도, 기존 개방형 결제 프로토콜에는 구조적 결함이 하나 존재한다. 이는 요청당 과금 사이클에서 잘못된 부분을 계량화한다는 점이다. 즉, 초기 HTTP 크롤링이 아닌, 모델이 섭취한 지식을 종합하여 사용자 프롬프트에 답하는 시점인 다운스트림 추론(downstream reasoning)을 계량해야 함에도 불구하고 그렇지 않다는 것이다. 원본 HTML 크롤링 시 1달러 미만의 요금을 징수해도, 만약 AI 모델이 해당 기사를 한번에 흡수하여 수백만 번의 사용자 답변에서 재현한다면, 이는 창작자에게 적절한 보상이 될 수 없다. RSL과 같은 프레임워크가 추론 기반 과금 옵션을 정의하고 있긴 하지만, Cloudflare나 AWS와 같은 네트워크급 게이트웨이는 뉴럴 네트워크의 잠재적 가중치를 검사하거나, 암호화된 방식으로 특정 출력 토큰을 생성한 학습 문서를 검증할 수 없다. Cloudflare가 2026년 7월 Ceramic.ai 및 You.com과 진행한 파일럿 프로젝트는 바로 이러한 기술적 병목을 정확히 드러낸다. 이 계획은 크롤링 기반 과금 방식을 탈피하고자 “쿼리 당 과금(query-based)” 모드를 시험하며, 출판사 텍스트가 실제 사용자 대상 AI 답변에 인용되었을 때만 비용을 지급한다. 비록 이는 가치 창조의 순간을 올바르게 겨냥하고 있으나, AI 서버 외부에 위치한 Cloudflare 같은 네트워크 엣지 제공자는 모델 생성 과정에서 어떤 출처를 인용했는지 독립적으로 검증할 수 없다는 점을 의미하므로, 시스템은 AI 기업이 자체적으로 인용량을 집계하고 미납 금액을 보고하는 것에 의존할 수밖에 없으며, 다시 명예 시스템(honor system)으로 회귀하게 된다.
개방형 프로토콜이 직면한 또 다른 근본적인 도전 과제는, AI 크롤러가 콘텐츠에 대해 미세 요금을 한 번 지불한 후 텍스트를 자체 캐시나 메모리에 기록한 다음 해당 데이터를 무기한으로 제공되는 것을 진짜로 막을 수 없다는 것이다. 또한 수천 번에 걸쳐 여러 웹사이트 및 퍼블리셔 간에서 이를 반복하는 것을 막을 수도 없다. Tempo의 MPP 공동저자 Brendan Ryan이 진행한 Shoal Signal 인터뷰에서论述된 바와 같이, 판매자의 과금 능력은 정보가 얼마나 고유하고 시간 민감성이 높으며 캐싱하기 어려운지에 largely 달려있다.
이러한 한계는 aforementioned 정적 창작물과 저널리즘 리포트에 가장 심각한 영향을 미친다. 정적 텍스트는 발행 직후 거의 즉각적으로 경제적 가치를 상실편하며, 심지어 AI 도구의 검색 메커니즘을 통해 수집된 경우라 해도 마찬가지다. 일단 AI 모델이 탐사 기사, 역사적 글, 또는 뉴스 릴리즈를 읽으면 해당 정보는 모델의 기억 속에 흡수된다. 모델은 원본 웹사이트에 재접근하지 않고도 영원히 이 사실들로 질문에 답할 수 있다. 따라서 공개 네트워크 텍스트를 AI 인터페이스와 단순하게 패키징하는 소프트웨어 도구는 경쟁사가 동일한 무료 정보에 동일한 크롤러를 구축함에 따라 이익이 급격히 소멸되는 것을 목도할 것이다.
따라서 하위 규칙은 매우 간단하다. 정적 데이터는 거의 즉각적으로 가격 매기기 능력을 상실하는 반면, 동적이면서 크롤링 불가능한 정보는 유료 지속 가능성을 유지한다. AI 모델이 유료되지 않은 기사나 역사적 보고서를 한 번 읽고 해당 지식을 가중치(weight)에 영구적으로 저장할 수 있으므로, 요청당 과금 미결제로는 정적 텍스트에 의존하는 비즈니스를 지탱할 수 없다. 지속적付费은 반드시 지속적으로 생산되고 검증되어야 하는 정보에만 적용되는데, 우리는 이것이 세 가지 범주로 귀결된다고 본다.
첫째는 실시간성이고 일시적인 상태(real-time, ephemeral state)로, 실시간 주문서(orderbook), 아SECOND級 금융 가격 형성, 긴급 뉴스 telemetry, IoT 센서 데이터 스트림 등을 포함한다. AI 모델은 수개월 전의 학습 가중치나 오래된 캐시에서 현재 세계 상태에 대한 쿼리에 답할 수 없다. 해당 정확한 시점에서 소스 서버로 새로우며 유료화된 API 요청을 보내야만 현재 현실을 확보할 수 있다.
둘째는 개방형 네트워크에 접촉하지 않는 독점 오프라인 데이터(private offline data)다. 사적 자본시장(specialty capital markets)의情報을 예로 들면, 보도자료에 발표한 역사적 투자 라운드와 임원 변경은 저비용 경쟁사에 의해 빠르게 크롤링되어 상품화된다. 진정한 가격 결정 권한은 1차적 수작업 연구를 수행하는 공급업체에 속하는데, 예를 들어 펀드 매니저와의 비밀 유지 관계를 통해 비공개 지분 구조 표 조항, 사적 거래 평가, 검증된 LP 포트폴리오 구성 등을 직접 수집하는 업체들이 해당된다. 이러한 데이터는 공개 URL에서 절대 인덱싱되지 않으므로 자동화 크롤러가 유료 장벽을 우회하거나 0원으로 추출할 수 없다.
셋째는 뚜렷한 인간 목소리와 브랜드 평판이다. Shoal Signal에서 매체 전략가 Ashni Christ가 지적했듯, 차단되거나 해제된 일반 뉴스 집계 피드(feed)는 즉시 똑같은 자동 크롤러로 대체되며 청중 입장에서 손실은 전혀 없다. 하지만 고정된 견해를 가진 진정한 분석가, 조사 기자, 또는 크리에이터가 콘텐츠 출간을 중단하면 독자들은 즉시 이를 인지하고 그들을 찾아 나선다. 실시간 인터뷰, 주관적 분석, 그리고 직접적인 접촉은 LLM이 미리 계산하거나 중간 캐시에 저장하거나, 정적 학습 데이터셋에서 복제할 수 없으며, 이는 실시간 정보 흐름, 사적 오프라인 레코드, 개인적 관점을 유일하게 신뢰할 수 있게 가격매기기 가능한 자산으로 만든다.
결론
인터넷이 무너지고 있다. 적어도 외관상으로 그러하다.
서로 간의 통신 및 조속 가속화를 위해 인류는 전 세계 컴퓨터 및 소프트웨어 네트워크를 구축하고 연결했다. 수십 년간 이어져 온 모든 후속 기술 층은 이러한 교환을 더 빠르고 효율적으로 만들기 위해 설계되었으며, 이는 결국 대규모 자동화를 위해 건설된 소프트웨어를 탄생시켰다. 생성형 AI는 이러한 자동화 능력을 단번에 수억 명에게 직접 이전했다. 그러나 자동화 소프트웨어가 네트워크를 장악함에 따라 정보 발견, 통합, 소비 방식의 근원적 변화를 촉발하고 있다. 이러한 전환의 가장 심각한 후과는 경제적 차원에 있다. 지난 30년간 개방형 인터넷을 지탱해온 광고 노출 및 인간 추천 모드를 통해 네트워크 트래픽을 수익화하는 것은 더 이상 불가능해졌다. 바로 그렇기에 우리는 지금 요청당 과금이 적용된 인터넷이 형성되는 과정을 목격하고 있는 것이다.
현재의 두 가지 상이한 경로는 네트워크 세계의 오랜 이야기다. 중앙화·비공개형 중재자는 법정화폐 청구, 원스톱 규제 준수, 친숙한 기업 가입 절차를 제공하지만 대가로 플랫폼 잠금(platfor lock-in) 및 허가식 검열을 동반한다. 그리고 개방형 프로토콜은 허가 없는 접근과 스테이블코인을 통한 프로그램 방식 미결제를 제공하지만, 기업형 배포, 추론 귀인(inference attribution), 그리고 무엇보다 실질적 퍼블리셔 채택 측면에서 여전히 간극을 보여주고 있다.
우리가 요청당 과금 인터넷 현황을 직접 테스트한 결과, 개방형 결제 프로토콜의 인프라 및 공급 측이 이미 갖춰진 것을 확인했다. x402와 같은 개방형 프로토콜은 데이터 수집, 도구 호출, AI 추론, 실시간 데이터 피드 등 기능형 시장을 활발히 추진 중이지만, 아직 주요 온라인 퍼블리셔의 지원을 받지 못하고 있다. TollBit와 같은 플랫폼은 현재 프로그램 방식 수익화 시장으로 홍보되고 있으나, 데이터는 퍼블리처가 이를 일시적 대안으로만 활용하여 크롤러를 차단하고 AI 연구소를 사적인 오프라인 거래로 유도하고 있음을 보여준다.
이는 폐쇄형 마켓플레이스와 개방형 프로토콜 중 무엇이 ‘승리’할지 결론 내리는 작업이 아직 멀었음을 알려준다. 사실, 왜 반드시 한쪽으로 편향되어야 한다고 생각하는가? 미래는 서로 다른 고객과 용례를 위해 두 경로 모두를 포괄할 가능성이 높다. 스테이블코인은 선불 포인트, 구독, 전통적 인보이스와 마찬가지로 활발히 사용될 것이다. 이 게임은 일부가 주장하거나 최소한 그렇게 믿고 있는 것처럼 제로섬 게임(zerosum game)이 아니다. 적어도 당분간은 말이다.
그럼에도 불구하고 인터넷이 전환점에 서 있다는 점에서 미래의 향방에 대해 선제적 예측을 내놓기 쉽지만, 중요한 것은 거리를 두고 망망대해처럼 펼쳐진 시야를 확보하며 네트워크가 탄생한 지 30년이 되었음을 잊지 않는 것이다. 그리고 이 세월 동안 네트워크는 끊임없이 진화해 왔다.新興 요청당 과금 인터넷이 결제 인프라를 폐쇄형 마켓플레이스나 개방형 프로토콜 중 하나로 수렴하든, 한 가지 가능성은 항상 존재한다. 활발하게 진화하고 자금 융통이 용이한 AI 분야의 추가 발전은 기존 두 경로 모두를 무용지물로 만들转而为新途奠定基石할 수 있다는 것이다. 당장 현재로서는 개방형 프로토콜과 폐쇄형 마켓플레이스가 각각 서로 다른 세그먼트와 용례를 위해 더 광범위하게 채택되는 모습을 목격할 가능성이 더 크다. 그러나 모든 선제적 판단이 그러하듯, 오직 시간이야말로 최종 답안을 줄 것이다.
舊契約崩壞最終可能造就一個更健康網絡的同時,也可能提高那些一開始就沒有資金支付按次使用費用或使用代理的人的全球信息獲取成本。不過,直接的機器支付可能為發布者提供一條不依賴廣告或平台控制推薦的機器使用變現路徑。結果將取決於這些新軌道是繼續向獨立發布者開放,還是變成又一層把關者。
TechFlow 공식 커뮤니티에 오신 것을 환영합니다
Telegram 구독 그룹:https://t.me/TechFlowDaily
트위터 공식 계정:https://x.com/TechFlowPost
트위터 영어 계정:https://x.com/BlockFlow_News
 @Shoalresearch














