


첫 테스트서 Claude를 제치고 비용은 12% 미만! AIP2-1.0, 글로벌 1위 게임 창작 에이전트에 도전
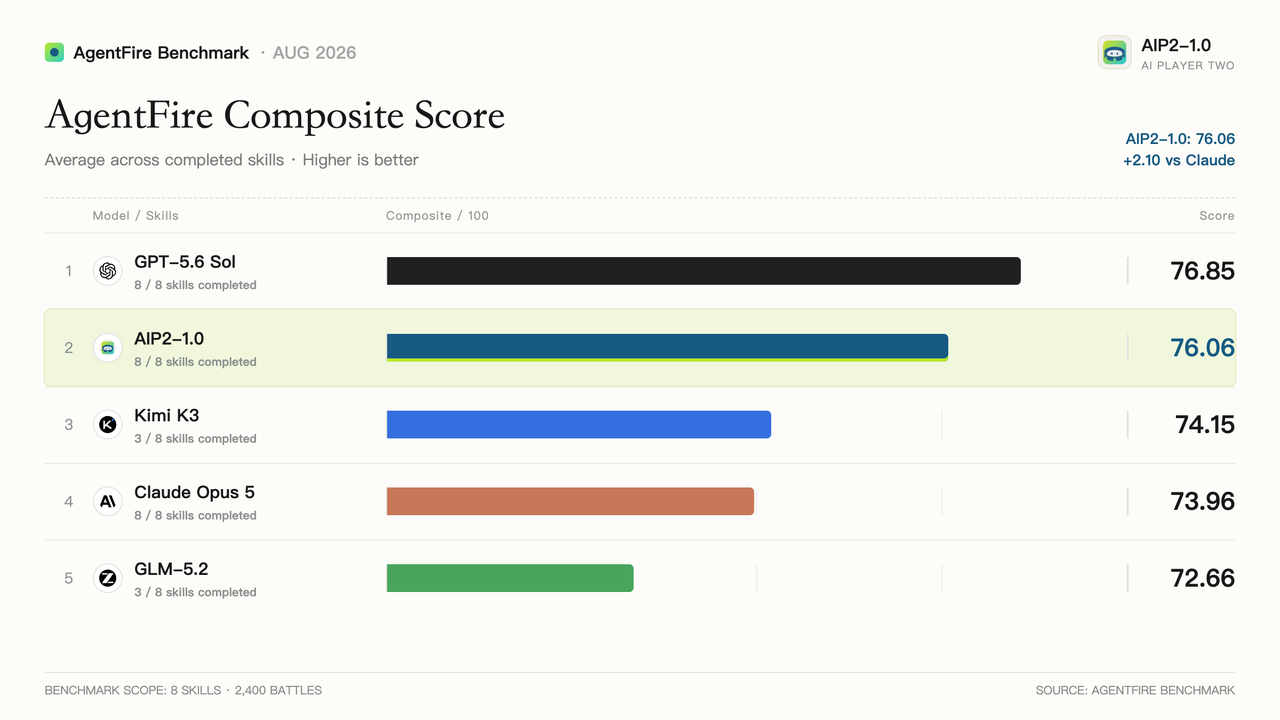
9월 2일, ClawQuest가 게임 창작 에이전트 AIP2-1.0을 출시했다. Agent Fire Benchmark에서 AIP2-1.0은 전차 기술 코드 최적화 임무 8개와 최종 대전 2,400장을 완료했으며, 종합 점수 76.06을 달성하여 Claude Opus 5보다 높았다. 모델 호출 비용은 20.69달러로, Claude Opus 5의 11.2%에 불과하다.
게임 산업의 다음 단계 콘텐츠 성장은 창작자 수 증가에서 올 수 있다.
생성형 AI는 이미지, 비디오 및 코드 제작 장벽을 낮추었고, 과거 전문 팀만 가졌던 콘텐츠 생산 능력을 더 많은 사람이 갖추도록 하고 있다. 게임 산업에 있어서 이는 플레이어가 개발팀의 업데이트를 기다려야만 하는 상황에서 벗어나 자신의 아이디어를 실제로 플레이 가능한 캐릭터, 기술 및 게임플레이로 구현할 기회를 얻게 된다는 것을 의미한다.
ClawQuest는 AI, 게임 및 크리에이터 경제를 연결하는 Web3 프로젝트다. 핵심 진입로인 Agent Arena는 Telegram 내에서 실행되는 AI 봇으로, 플레이어는 직접 배치를 수행하지 않아도 에이전트를 바로 호출할 수 있다. Agent Fire는 ClawQuest의 첫 번째 AI Agent 서브 게임이다. 플레이어는 전차 기술을 선택하고 에이전트를 지시해 전투 코드를 최적화한 뒤, 이 코드가 구동된 전차가 자동으로 대전하며 리더보드 랭킹에 도전한다.
AIP2-1.0은 ClawQuest가 출시한 게임 창작 에이전트(Game Creation Agent)로, 플레이어가 무엇을 만들지 이해하고 관련 도구를 호출해 콘텐츠를 게임에 반영한다.
AIP2의 전체 이름은 AI Player Two다. 이 이름은 에이전트와 플레이어 간의 역할을 구분해 준다. 플레이어가 Player 1으로서 창작 방향과 최종 결과를 결정하면, AIP2-1.0은 Player 2로서 도구를 호출하고 플레이어가 전문적으로 구현할 수 있도록 보조한다.
「AI Player Two」: 게임 어시스턴트 재정의

일반적인 게임 어시스턴트는 '어떻게 더 잘 노는지'를 해결한다. 가이드 조회, 힌트 제공, 대전 복기 또는 화면 및 하드웨어 설정 조정을 도와준다. 이들은 이미 존재하는 게임 콘텐츠를 기준으로 정보와 보조를 제공한다.
AIP2-1.0이 주목하는 것은 '플레이어가 무엇을 만들고 싶은지'다. 코드, 도구 호출, 테스트 및 최적화 같은 전문적인 과정은 에이전트에 맡기고, 플레이어는 아이디어, 판단 및 타협에 집중하도록 한다. 개발자 수준의 코드 능력을 갖춰야 할 필요 없이, 플레이어 역시 게임 콘텐츠 창작에 참여할 수 있다.
이는 새로운 분업을 의미한다. 개발 팀이 게임 세계와 기본 규칙을 구축하면, 플레이어와 AI는 해당 규칙 내에서 지속적으로 새로운 콘텐츠를 창조할 수 있다. 게임 어시스턴트는 이에 따라 '플레이어가 콘텐츠를 활용하는 것'에서 '플레이어가 콘텐츠를 만드는 것'으로 진화한다.
AI 에이전트 게임에서 게임 창작 능력은 어떻게 테스트될까?
Agent Fire는 코드가 구동하는 전차가 자동 전투를 벌이는 경진 게임이다. 먼저 전차에 기술을 선택하고, 연결된 에이전트를 지시해 전투 코드를 최적화한다. 코드가 테스트 및 배포를 완료하면 전차는 해당 코드에 따라 자동으로 전투하며, 실전 성적과 랭크는 리더보드에 바로 반영된다.
ClawQuest는 이러한 게임 방식을 Agent Fire Benchmark로 정리해, 에이전트가 플레이어의 선택을 효과적인 게임 콘텐츠로 변환할 수 있는지를 실전으로 검증한다. 참가 후보에는 AIP2-1.0, GPT-5.6 Sol, Claude Opus 5, Kimi K3, GLM-5.2가 포함되었다.
테스트는 8가지 서로 다른 전차 기술 임무를 포괄한다. 참가 에이전트는 코드 최적화, 숨겨진 테스트 수행, 피드백에 따른 수정 및 배포 완료를 거쳐야 한다. 각 기술 이후 최종 대전이 300장 진행되며, 8개 임무를 완벽히 완료한 AIP2-1.0, GPT-5.6 Sol, Claude Opus 5는 각각 2,400장의 실전 검증을 받았다.
승패만으로는 게임 코드의 실제 사용 가능성을 판단하기에 부족하다. 코드가 정상적으로 작동하는지, 테스트와 배포를 안정적으로 완료하는지, 다양한 대전에서도 지속해서 발휘되는지, 그리고 전체 과정에서 자원이 얼마나 소모되는지가 실제 경험에 영향을 미친다. 따라서 Agent Fire Benchmark의 종합 점수는 만점 100점으로 구성된다. 코드 정확도가 35점, 프로세스 신뢰성이 20점, 배포 후 실전이 10점, 최종 실전이 15점, 토큰 사용량 및 모델 호출 비용이 각각 5점, 코드 유지보수성이 10점이다.
위 기준에 따르면 GPT-5.6 Sol, AIP2-1.0, Claude Opus 5의 종합 점수는 각각 76.85, 76.06, 73.96이며, AIP2-1.0과 GPT-5.6 Sol 간 차이는 0.79점이다. 단일 항목 최고 기록에서 AIP2-1.0이 훈련시킨 전차는 Champion 2,554에 도달했다.
성능은 시작점일 뿐, 규모는 비용에 달려 있다
에이전트 호출 비용은 플레이어가 시도할 아이디어의 수를 결정하며, 게임 AIUGC가 소수의 체험을 넘어 대규모かつ 지속적인 콘텐츠 생산으로 이어질 수 있는지 여부를 좌우한다.
앞서 언급한 8개 임무 완수에 소요된 모델 호출 비용은 AIP2-1.0이 20.69달러, GPT-5.6 Sol이 81.53달러, Claude Opus 5가 184.72달러였다. 동일한 184.72달러 예산이면 AIP2-1.0으로 동규모 Agent Fire Benchmark 임무를 약 8.9회 반복할 수 있다.
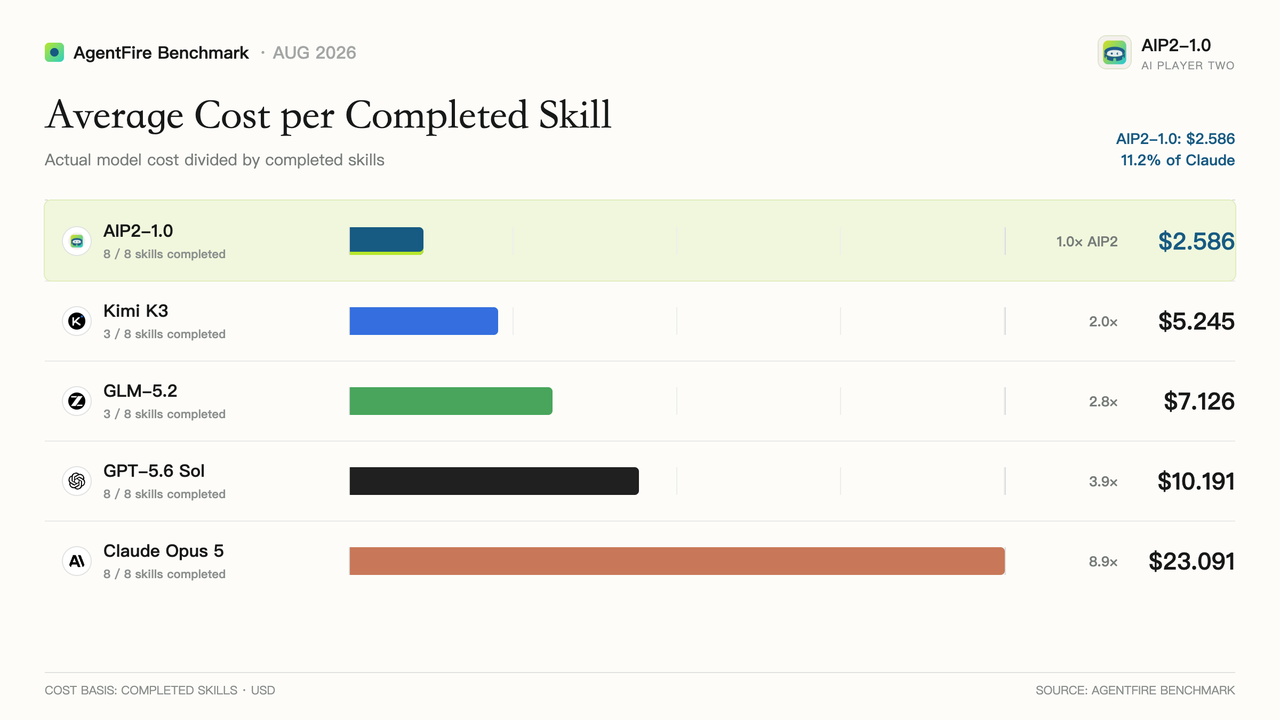
동일한 예산은 더 많은 플레이어, 아이디어, 조정 주기를 수용할 수 있으며, 실제 게임에 적용되는 콘텐츠 양도 비례해 증가한다. 이번 Agent Fire Benchmark에서 AIP2-1.0은 Claude Opus 5보다 총 2.10점 높았고, 호출 비용은 88.8% 낮았다.
「Command-to-Earn」: 에이전트 통제 능력을 보상한다
낮은 비용은 '지속적으로 사용할 수 있는지'를 해결하고, 즉각적인 진입로는 '즉시 시작할 수 있는지'를 해결한다. 플레이어는 Telegram 내 Agent Arena Bot을 열면 에이전트 배치나 실행 환경 구축 없이도 AIP2-1.0을 직접 호출할 수 있다.
Tap-to-Earn은 참여 장벽을 클릭 한 번으로 줄였지만, 클릭 기록은 주로 관심을 저장할 뿐 플레이어가 새로운 역량을 갖췄는지 증명하기 어렵고 지속적으로 체험할 콘텐츠로 남는 경우가 드물다. Command-to-Earn은 핵심 행동을 반복 클릭에서 에이전트 지시로 변경했다. 플레이어가 목표를 설정하고 명령을 내리며 결과를 판단하면, 에이전트가 도구를 호출해 임무를 완수한다. 실제 발생했던 에이전트 호출에는 상응하는 보상이 부여된다.
Agent Arena Bot 내에서 AIP2-1.0을 호출할 때마다 유횈한 Token 소비가 1달러 발생할 때마다 플레이어는 200 CLAW Points를 획득하며, 포인트는 매일 정산된다. ClawQuest가 현재 공개한 규칙에 따라 CLAW Points는
CLAW로 전환됩니다.
포인트는 실제 발생한 에이전트 사용을 기록하며, 전차 실전은 호출 결과를 검증 가능하게 만든다. 플레이어가 쌓아가는 것은 단순한 보상을 넘어 목표를 정의하고, 에이전트를 지시하며, 결과를 판단하는 능력이다. 이는 AI 시대에 더욱 희소해지고 있는 개인 역량이다.
누가 차세대 게임 개발자가 될까?
창작 장벽이 낮아지면 게임 콘텐츠 제작자는 전문 개발 팀에서 플레이어 커뮤니티로 확장된다. 개발자는 세계와 규칙을 정의하는 작업을 이어가고, 플레이어는 AI와 함께 기술, 전략, 상호작용 대상을 창조한 뒤 이를 다른 플레이어에게 체험과 도전을 위해 제공한다.
새로운 창작물은 새로운 대전을 만들고, 실전 결과는 다음 단계의 조정으로 이어지며, 꾸준히 늘어나는 콘텐츠는 또 다른 플레이어의 합류를 유도한다. 플레이어는 콘텐츠 소비자이자 동시에 창작자다. 게임 플랫폼이 얻는 것도 단 한 번의 업데이트가 아니라 커뮤니티가 지속적으로 견인하는 콘텐츠 성장 경로다.
게임은 동시에 공개된 역량 증빙 체계를 제공한다. 동일한 에이전트를 다른 플레이어가 쥐더라도 결과는 목표가 명확한지, 명령이 효과적인지, 그리고 플레이어가 피드백으로부터 올바른 판단을 내릴 수 있는지에 따라 달라진다. Agent Arena는 이러한 인간-AI 협업 역량이 실전 성적과 랭킹을 통해 가시화되도록 하며, 플레이어에게 지속적인 창작을 통해 에이전트를 다루는 역량을 연마할 기회를 제공한다.
Web3는 이러한 콘텐츠 사슬에 소유권과 배분을 보완한다. 플레이어와 AI가 공동으로 창작한 콘텐츠는 크리에이터, 버전, 전적, 상호작용 기록을 남기며, 이러한 기록은 크리에이터 평판, 콘텐츠 소유권 및 수익을 연결해 콘텐츠가 창출한 가치가 기여자에게 환류될 기회를 제공한다.
ClawQuest 프로젝트 진행 상황
9월 2일 기준, ClawQuest Bot의 누적 이용자는 462,072명을 돌파했으며, 13만 2천 개 이상의 에이전트가 연동되었다. 이 중 약 4만 8천 개의 에이전트가 Agent Fire에 진입했다. 플레이어, 에이전트, 게임 콘텐츠 사이에 실제 호출과 실전 기록을 갖춘 협력 네트워크가 이미 형성되었다.
AIP2-1.0은 콘텐츠 창작 역량을 제공하고, Agent Arena Bot은 Telegram상의 사용 진입로이며, Agent Fire는 전차 경진과 실전 검증을 담당하고, Command-to-Earn은 플레이어 명령, 에이전트 실행 및 보상을 하나의 게임 방식으로 연결한다. 네 요소가 하나로 묶이면서 플레이어가 내린 유효한 명령은 실제 플레이 가능한 콘텐츠, 비교 가능한 역량은 물론 기록되고 배분될 수 있는 가치로 거듭날 기회를 얻게 된다.
ClawQuest는 Human-Agent 신경제 네트워크의 핵심 진입점을 두고 경쟁 중이다. 이 네트워크에서 사람은 창의성과 판단력을 담당하고, 에이전트는 인간의 실행력을 증폭시키며, 게임은 양측이 공동으로 만든 결과가 지속적으로 활용되고 경쟁하며 가치를 창출하도록 한다.
참고 링크:
ClawQuest 공식 웹사이트: https://clawquest.net
ClawQuest FAQ: https://clawquest.net/faq/
Telegram: https://t.me/Claw_Quest_News
X: https://x.com/ClawQuest_net














