AI Agent가 서로 고용할 때, 누가 감독할 것인가?
글: Thejaswini M A
번역: Saoirse, Foresight News
인터넷 발전 초기 아주 긴 기간 동안, 검색 엔진은 결과 목록을 반환하는 역할만 담당했고 나머지 모든 작업은 사용자에게 맡겨졌다. 눈에 들어온 것은 파란색 제목과 하이퍼링크였다. 이후 우리는 조회 요구와 일치해 보이는 콘텐츠를 클릭했다. 하지만 그런 경험을 과거의 이야기로 여기는 게 좀 이상하고, 어느새 세월이 흘렀다는 사실을 절감하게 만든다.
글쓰는 이로서 나는 평소 SEO라는 시스템에 반감을 가져왔다. 키워드는 종종 글의 훌륭한 내용을 훼손한다. 구글의 랭킹 알고리즘에서는 외부 링크가 투표로 간주된다. 본질적으로 다른 웹사이트가 당신의 페이지로 더 많이 링크할수록 해당 페이지의 가중치가 높아진다. 하지만 탓할 일도, 볼일도 없다. 신뢰도가 전혀 없는 것보다는 나으니 말이다. 광고가 인터넷의 모든 것을 먹여 살린다. 하지만 콘텐츠 발행 측에게는 분명히 불쾌한 메커니즘이다.
이제 이런 패턴은 사그라지고 있다. 금융 경제 관련 책을 찾고 싶거나, 장시간 보행 후 발목 통증 대처법을 알고 싶다면 바로 Gemini를 켠다. 일부는 Perplexity나 GPT를 사용하고, 토큰 소비에 민감하지 않은 이들은 Claude를 직접 고른다. 이러한 도구들의 효과가 긴 한 편의 글을 읽는 것보다 반드시 낫을까? 우리는 모른다… 아니라고 할 수도 있겠지만, 분명 삶을 편하게 만들어준다. 상반된 두 편의 글을 읽을 필요가 없다. AI가 이미 문제를 처리해 주었다.
적어도 30세 미만 세대에게 검색 엔진은 더 이상 능동적으로 접속해야 하는 포털이 아닐 것이다.
그후 에이전트(Agent)가 등장해 구도를 완전히 뒤집었다. 비인간 트래픽이 인간 트래픽을 이미 초과했다. 연구 작업을 수행하는 에이전트는 수천 개의 웹페이지를 읽다가도 최종적으로는 메모 한 줄만 출력할 수 있다. 이는 인간과는 완전히 다르다. 따라서 에이전트가 주도하는 경제 체계에서 광고는 가치를 상실할지도 모른다. 저는 소프트웨어가 자신이 소모하는 리소스에 대해 지불해야 하는지 탐구한 글을 두 편 썼다. 결론은 지불 자체가 오히려 가장 간단한 단계라는 것이었다.
네트워크에서 임무를 완수하고 가치 정산을 실현하기 위해 에이전트는 서로 독립적인 6단계 기술 스택이 필요하다.
에이전트는 웹 페이지 리소스를 찾아야 하고, 반환된 결과를 신뢰하며, 다른 봇을 신뢰하고, 작업 완료 여부를 확인하고, 결제를 실행해야 하며, 나아가 콘텐츠 크리에이터에게 적절한 보상을 남겨야 한다. 이어지는 부분에서는 이를 순서대로 단계별로 살펴보겠다.
실제 웹에는 무엇이 있는가?
기계와 인간 모두 「검색」을 사용하지만, 둘이 웹페이지에 요구하는 바는 완전히 다르다.
인간 검색은 전체 웹페이지 목록을 반환해 사용자가 제목을 훑고 선택적으로 이동하도록 한다. 반면 AI 에이전트를 위한 기계 검색은 다르다. 에이전트는 컨텍스트 윈도우(단기 기억) 제한으로 인해 웹페이지를 통째로浏览하지 않는다. 가중치 기준 전체 링크를 반환하지 않으며, 작업에 가장 유용한 소수의 문단만 추출해 모델에 직접 전달한다. 이는 메모리 오버플로를 방지하며, 전체 과정은 밀리초 단위로 끝난다.
이 영역의 양대 주요 공급자는 Parallel과 Exa이며, 둘 다 에이전트 전용 검색을 제공하는 독립 기업이다. Parallel은 Parag Agarwal이 Twitter를 떠난 후 설립했으며, 4월 1억 달러 규모 자금조달을 마치고 시가총액 20억 달러를 기록했다. Parallel은 명확한 목표를 바탕으로 검색을 실행해 압축된 콘텐츠 스냅샷을 반환하며, 스냅샷은 작업 기여도 순으로 정렬되고 각 사실에는 인용 출처와 신뢰 점수가 부여된다.
반면 Exa는 a16z의 주도적 출자로 5월 2억 5천만 달러 자금조달을 완료했으며 평가액은 22억 달러다. 5000개 이상의 기업과 4만 명의 개발자를 서비스하며 Cursor, Cognition, HubSpot, OpenRouter, Monday.com 등 제품에 기반 기능을 제공한다. Exa는 키워드 매칭보다 의미 이해를 중시하며, 원문에 질의어가 존재하지 않아도 관련 콘텐츠를 반환할 수 있고, 동시에 클린 상태의 원본 웹페이지 텍스트도 함께 제공한다.
Parallel 공식 문서에 따르면, 고속 모드 2종은 1000회 검색 요청당 1달러, 저속 모드 2종은 5달러다. 웹페이지 길이와 관계없이 URL 콘텐츠 추출 비용은 1000건당 1달러로 통일된다. Exa의 1000회 검색 요청 요금은 7달러로 Parallel의 7배에 달하며, 웹페이지 콘텐츠 추출은 1000페이지당 1달러, 인용 기능이 포함된 Q&A API는 1000회당 5달러다.
검색 성능은 과연 어떠한가?
구글은 대내적으로 검색 품질 평가를 진행한다. 사용자가 첫 번째 결과를 클릭했는지, 페이지에 머무르는지 즉시 이탈하는지 판단하며, 동시에 인력 채점원을 고용해 결과에 점수를 매긴다. 과거 RTEC 같은 테스트도 있었지만, 대외적으로 공개되어 구매 가능한 랭킹은 존재하지 않았다. Google Analytics나 Similarweb이 추적하는 것은 유입 트래픽이지 검색 품질이 아니다.
반면 에이전트 인터넷 환경에서는 이미 실험용 베이스라인 테스트 세트가 등장해, 검색 도구가 AI에게 정답을 얻도록 돕는지 전문적으로 측정하고 있다.
OpenAI는 2025년 4월 1266문제의 역공학 시험지를 담은 BrowseComp를 발표했다. 문제 출제자는 먼저 검증 가능한 객관적 사실을 정한 뒤 질문을 설계하고, 그 사실을 다층 제약 조건 속에 숨긴다. 만약 먼저 문제를 내고 정답을 찾는 방식이라면 일반 지식 퀴즈와 다를 바 없어 모델이 자신의 기억이나 운 좋게 찾은 검색으로 맞추기 쉽다. 반면 사실을 먼저 확정하고 질문을 포장하는 방식이어야 비로소 도구의 웹 검색 능력을 진정으로 검증할 수 있다.
제원본 GPT-4o의 점수는 고작 0.6%였으며, 웹 브라우저 기능을 활성화한 GPT-4o는 1.9%를 기록했고, OpenAI의 Deep Research는 51.5%를 달성했다.

테스트 목표는 시스템이 실제 인터넷에서 숨겨졌으나 검증 가능한 사실을 하나 찾아 출력할 수 있는지 입증하는 것이다. 1266문제 모두 짧은 정답을 가지고 있으며, 모델은 한 번만 답변할 기회가 주어진다. 일치하면 점수 획득, 불일치 시 무점수로, 최종 점수는 정답률의 백분율이다. 제원본 GPT-4o의 0.6%는 모델이 고유 기억으로 사실상 사실을 끌어내기 어렵다는 것을 의미하며, 브라우저를 연 GPT-4o의 1.9%는 기초 검색 도구가 가져오는 향상이 미미함을 보여준다. Deep Research의 51.5%는 긴 검색-독해 사이클을 통해 목표 사실을 찾을 확률이 약 절반 수준임을 나타낸다.
BrowseComp 외에도 기타 평가 세트들이 존재한다: SimpleQA(OpenAI, 4326문제), 채점이 용이한 사실 기반 테스트다. 브라우저 도구 속도가 빨라지며 SimpleQA 난이도는 모델에게 쉽게 돌파되었으며, 이에 BrowseComp가 나왔다. GAIA(Meta / Hugging Face, 466개 인공 작업)는 실제 어시스턴트 시나리오를 겨냥했으며, 웹 탐색, 도구 호출, 파일 읽기, 다단계 추론 등 단순 검색을 넘어선 작업이 필요할 수 있다. DeepSearchQA는 다중 회차 검색을 다루는 연구 데이터세트이며, Artificial Analysis는 이 데이터세트를 기반으로 종합 평가를 실시한다. FRAMES(Google DeepMind, 824개 샘플)는 다중hop 문제로, 여러 출처에서 사실을 추출해 통합해야 하는 문제집이다.
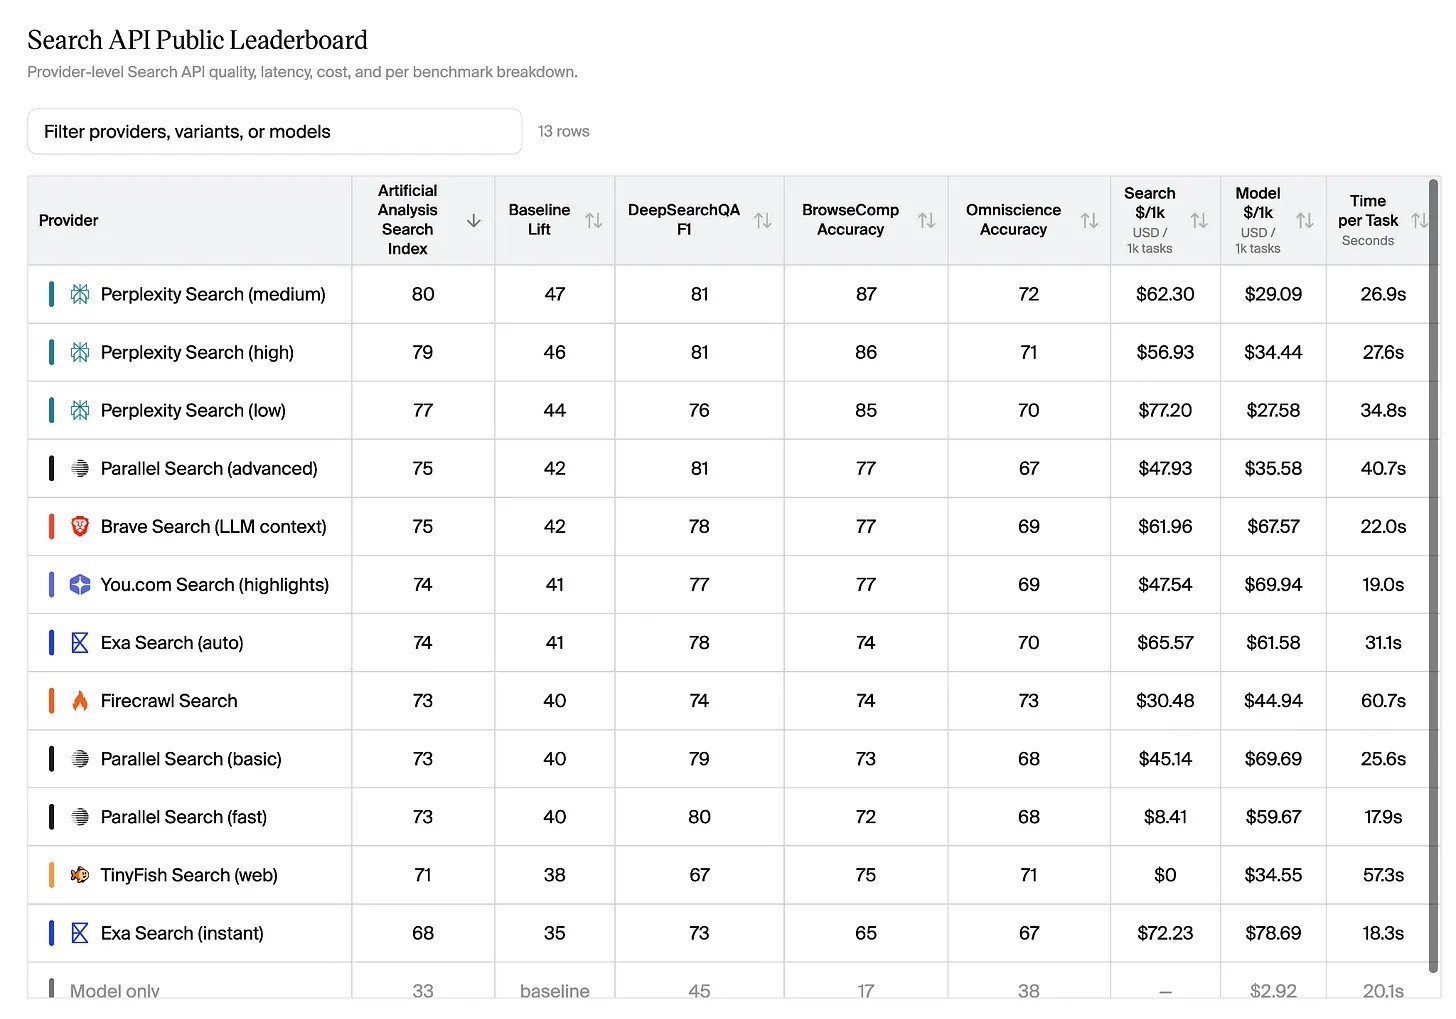
민간 기관 Artificial Analysis는 George Cameron과 Micah Hill-Smith가 공동 설립했으며, 2026년 8월 18일 검색 지수를 발표했다. 이 평가는 답변에 사용되는 AI 모델과 평가 규칙을 고정하고, 에이전트가 호출하는 검색 API만 교체한다. 점수가 변동되면 차이는 검색 도구 자체에서 비롯된 것이지 모델 능력 차이로 인한 것이 아님을 의미한다.
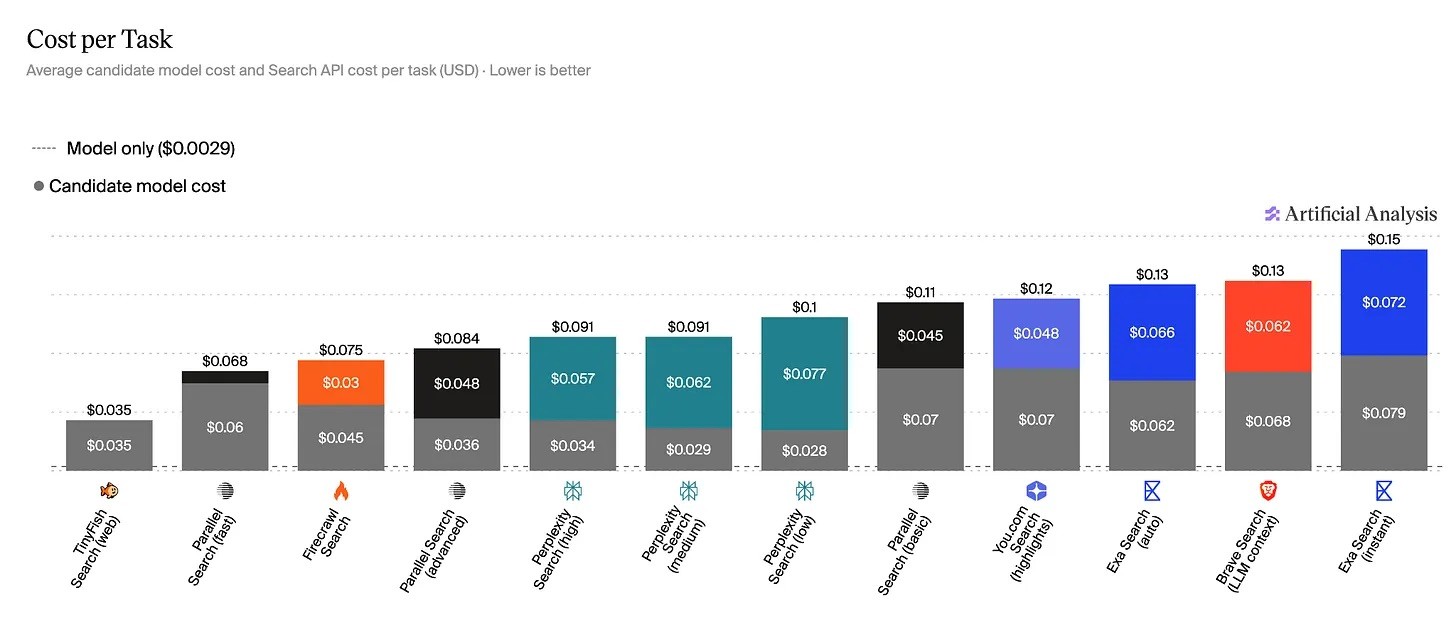
출처: @artificialanalysis
검색을 전혀 사용하지 않을 때, 동일 모델은 이 지표에서 33점의 베이스라인 점수를 받았고 BrowseComp 하위 세트 베이스라인 점수는 17점이었다. 각 검색 서비스 제공업체 순위가 어떻게 변동되든 베이스라인 점수는 절대 바뀌지 않는다.
8월 27일 기준 Artificial Analysis 검색 지수: Perplexity 미드랭크 버전이 80점으로 1위, Parallel 고급 등급과 Brave가 75점으로 공동 2위, You.com 및 Exa는 74점, Firecrawl, Parallel 기본판, Parallel 고속판은 모두 73점이다.
검색 도구 점수가 베이스라인을 상회한다면, 검색이 실제로 모델을 새로운 정보 습득에 성공적으로 도와줬음을 의미한다. 논리는 다음과 같다. AI가 기억만으로 답변할 경우 베이스라인 점수를 받는다. 검색을 연동한 후 점수가 상승한다면 검색이 모델이 본래 알지 못했던 정보를 찾아냈다는 것이고, 점수가 오르지 않다면 검색은 역할을 하지 못한 것이다.
그러나 평가 자체에도 한계가 존재한다. 테스트 질문과 사용된 모델이 특정 비즈니스 시나리오 전용인 것은 아니기 때문이다. 서비스 제공업체는 마치 과거 웹사이트들이 구글 SEO를 최적화하듯, 알려진 테스트 세트(예: DeepSearchQA)에 맞춰 시험 대비식 최적화를 할 수 있다.
상대방 봇은 누구인가?
두 AI 에이전트가 서로 업무 위임 시, 지갑 주소와 소개만으로는 신뢰를 구축하기에 부족하다. 지갑 주소는 계정 자금 보유 여부만 증명할 뿐이며, 설명 텍스트는 쉽게 위변조될 수 있어 봇 개발자 신분을 입증하지 못하며 과거 작업 기록의 진위도 뒷받침하지 못한다. ERC-8004 표준은 바로 에이전트의 실체 신원과 평판 검증 문제를 해결하기 위해 설계되었다.
ERC-8004는 MetaMask, 이더리움 재단, Google, Coinbase 관계자들이 공동으로 작성했으며, 2026년 1월 29일 이더리움 메인넷에 출시되었고 크게 세 가지 등록부를 포함한다.
첫째, 신원 등록부로 NFT 형태로 구현된다. 각 에이전트는 일련번호 토큰 하나에 대응하며, 토큰의 URI는 등록 파일을 가리켜 에이전트 이름, 서버 엔드포인트, x402 결제 지원 여부, 지원하는 신뢰 모델 등을 기록한다. 토큰 보유자가 곧 에이전트 소유자이며, 토큰 소유권이 이전되면 기존 결제 지갑 정보는 초기화되고 새 보유자는 통제권을 입증하기 위해 서명을 다시 해야 한다.
둘째, 평판 등록부로 서명付き 피드백을 수신하며, 즉 체인상 공개 리뷰 시스템이다. 에이전트 사용 후 사용자는 체인에 점수를 남길 수 있으며, 작업 태그(예: 검색, 평가 등)를 병기한다. 에이전트 소유자는 자기 자신에게 리뷰를 남길 수 없으며, 리뷰는 취소를 지원한다. 누구나 리뷰 하단에 메모를 추가할 수 있고, 환불 기록이나 스팸 경고도 점수 옆에 첨부 가능하다. 이는 에이전트 ID에 바인딩된 공개 리뷰 공간이지, 특정 앱 내부의 사유 별점 시스템이 아니다.
셋째, 검증 등록부로 제3자 독립 검사를 연결한다. 에이전트가 검증 요청을发起하면, 검증 스마트 계약이 0~100 점수를 반환하고 증거 링크를 동반한다. 증거 출처는 작업 재실행 결과, 영지식 증명 또는 보안 칩 발급 증명 중 하나일 수 있다.
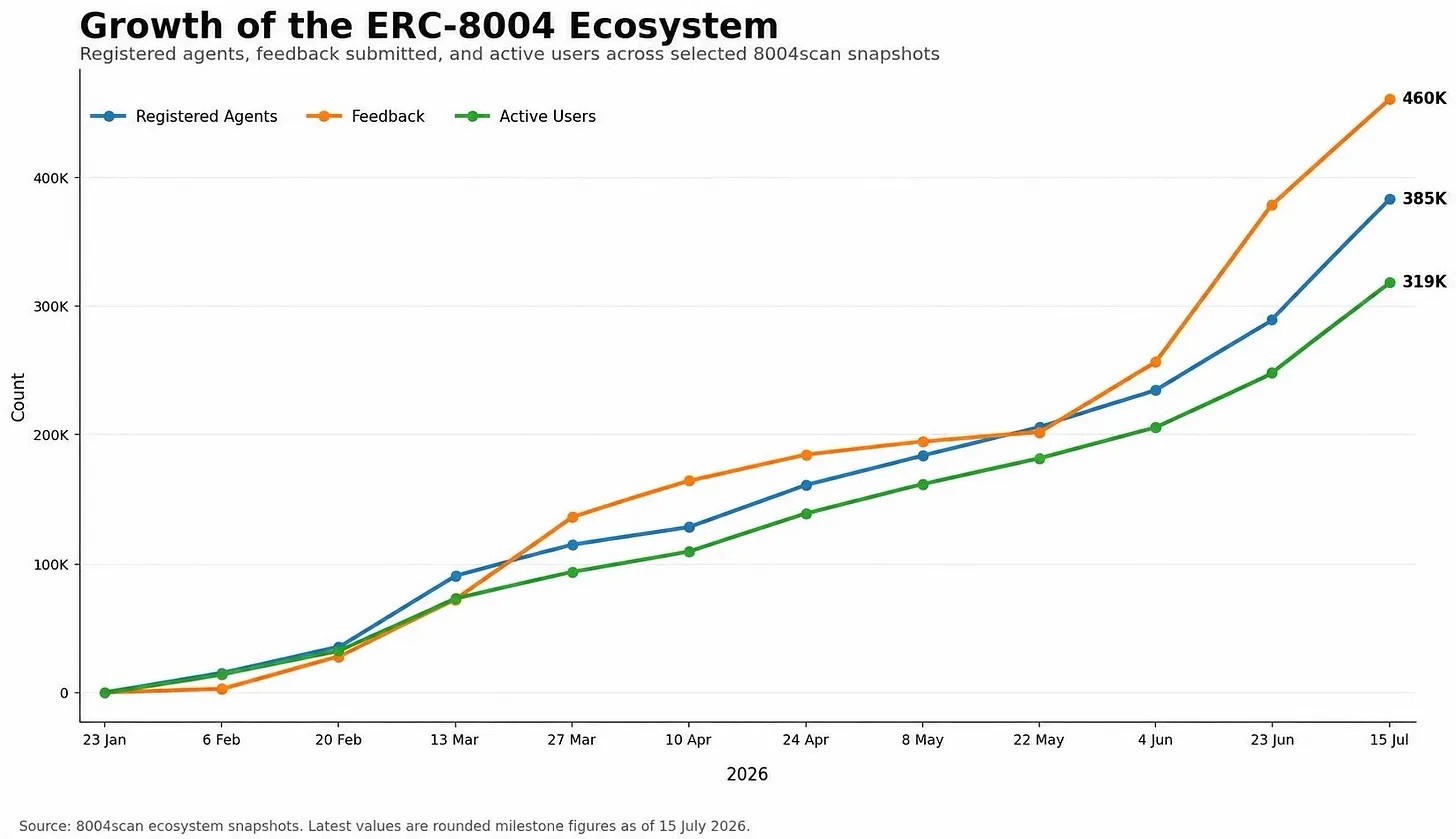
이 규격 자체는 결제 로직을 처리하지 않으며, 문서에서도 이를 명시했다. 단지 에이전트 신원, 외부 평가, 제3자 검사 결과만 기록할 뿐 결제는 다른 프로토콜이 수행한다. 등록부의 데이터 품질은 그리 낙관적이 아니다. 8004scan의 7월 통계에 따르면 29개 퍼블릭 체인에 걸쳐 총 38만 5998개의 에이전트가 등록되었으며 46만 건 이상의 리뷰를 보유하고 있다. 대부분의 ID는 단순히 빈 배지에 불과하며, 89.2%는 외부 공개 호출이 가능한 표준 서비스 인터페이스조차 갖추고 있지 않다. 사용 가능한 서비스를 가진 에이전트는 단 8631개로, 비율은 고작 2.24%에 그친다.
출처: @8004_scan
5월 이더리움, BNB 체인, Base 체인을 대상으로 한 크롤러 조사 결과: 체인 상 점수는 다른 에이전트 간 수평 비교가 불가능했다. 대부분 피드백이誰でも 검증 가능한 작업 결과와 바인딩되지 않았으며, 리뷰 부트스트랩 비용이 매우 낮았다. 의심스러운 리뷰를 필터링 제거한 후, 상당수평가 대상 에이전트는 더 이상 유효한 평가조차 보유하지 않게 되었다. 해당 표준은 단지 리뷰 데이터 출력 형식을 통일할 뿐, 어떤 리뷰가 진정성 있게 신뢰할 만한지는 외부 시스템에 맡긴다. ENS, EigenLayer, The Graph, Taiko가 해당 표준接入을 표명했지만 아직 리뷰 필터링 도구는 개발되지 않았다.
에이전트는 정말 업무를 완수했는가?
에이전틱 커머스(Agentic Commerce) 아키텍처는 이더리움 재단과 Virtuals Protocol이 공동으로 설계했으며, 주 목적은 자율적 AI 에이전트 간의 상호 고용, 협업 작업, 체인 상 정산을 가능하게 해 전 과정에서 인간 중재를 완전히 배제하는 것이다. ERC-8004와 ERC-8183(에스크로 표준)이 이 체계를 함께 구현한다. ERC-8183은 에이전트 간 작업 발표, 자금 에스크로, 결과 검증, 정산 전 과정을 표준화한다.
작업 흐름은 다음과 같다. 작업을发起하는 클라이언트 에이전트가 작업을 발표하며, 작업 설명, 마감 기한, 예산을 명시하고 평가자를 지정한다. 클라이언트는 자금을 스마트 계약에 예치하며, 자금이 잠기는 순간 어느 쪽도 단일 의사결정으로 자금을 인출할 수 없다.
서비스를 제공하는 에이전트는 오프체인에서 계산을 완료한 후 최종 결과를 IPFS, Arweave 등의 탈중앙화 저장소에 업로드하고 체인에는 해시값 또는 자원 위치 표시자만 제출한다. 평가자(전담 심판 에이전트, 자동화 오라클, 영지식 증명 검증자 등)가 인도물을 점검한다.
평가자가 작업 통과를 판정하면 수수료를 공제한 후 서비스 제공자에 지급하며, 실패로 판정되면 자금을 클라이언트에 환불한다. 서비스 제공자가 통신두절되거나 평가자가 마감 기한을 넘어 멈춰 설 경우 계약은 공개 환불 로직을 트리거하여 자금을 클라이언트에 되돌리고, 자산이 영구적으로 잠기는 상황을 방지한다.
평가자를 클라이언트 자체가 직접 맡을 수도 있으며, 문서에서는 이를 제3자가 없는 상황의 기본 방식으로 제시한다. 아울러 규정은 명시한다: 본協定은 분쟁 해결 및 중재 메커니즘을 제공하지 않으며, 결과 거부 혹은 시간 초과 종료即为 최종 판정. 당신이 선택한 채점 봇이 악의적으로 당신을 사기칠 경우 관리자나 고객상담 센터에 호소할 방법이 없다. 구원의 손씨가 없고, 앞선 단계에서 지적한 문제 때문에 신뢰할 수 있는 평가자를挑選하는 데 체인 상 평가에만 의존할 수도 없다. 대부분 평가는 허구이기 때문이다.
UMA, Kleros, Bittensor 같은 시스템은 평가자의 단일 지점 악용 위험을 완화할 수 있지만 속도를 희생하고 비용을 인상한다. 순수 자동화 에스크로 정산은 초 단위 내에 완료되며 수수료가 극도로 낮다. 반면 UMA, Kleros를 통한 분쟁 절차 승격은 도전 창구, 담보 증치 그리고 인간 투표를 투입해야 함을 의미한다.
자금이 이체되었는가?
최근 업계에서 이 부분에 대한 논의가 많았던 만큼 간략히 정리해보겠다.
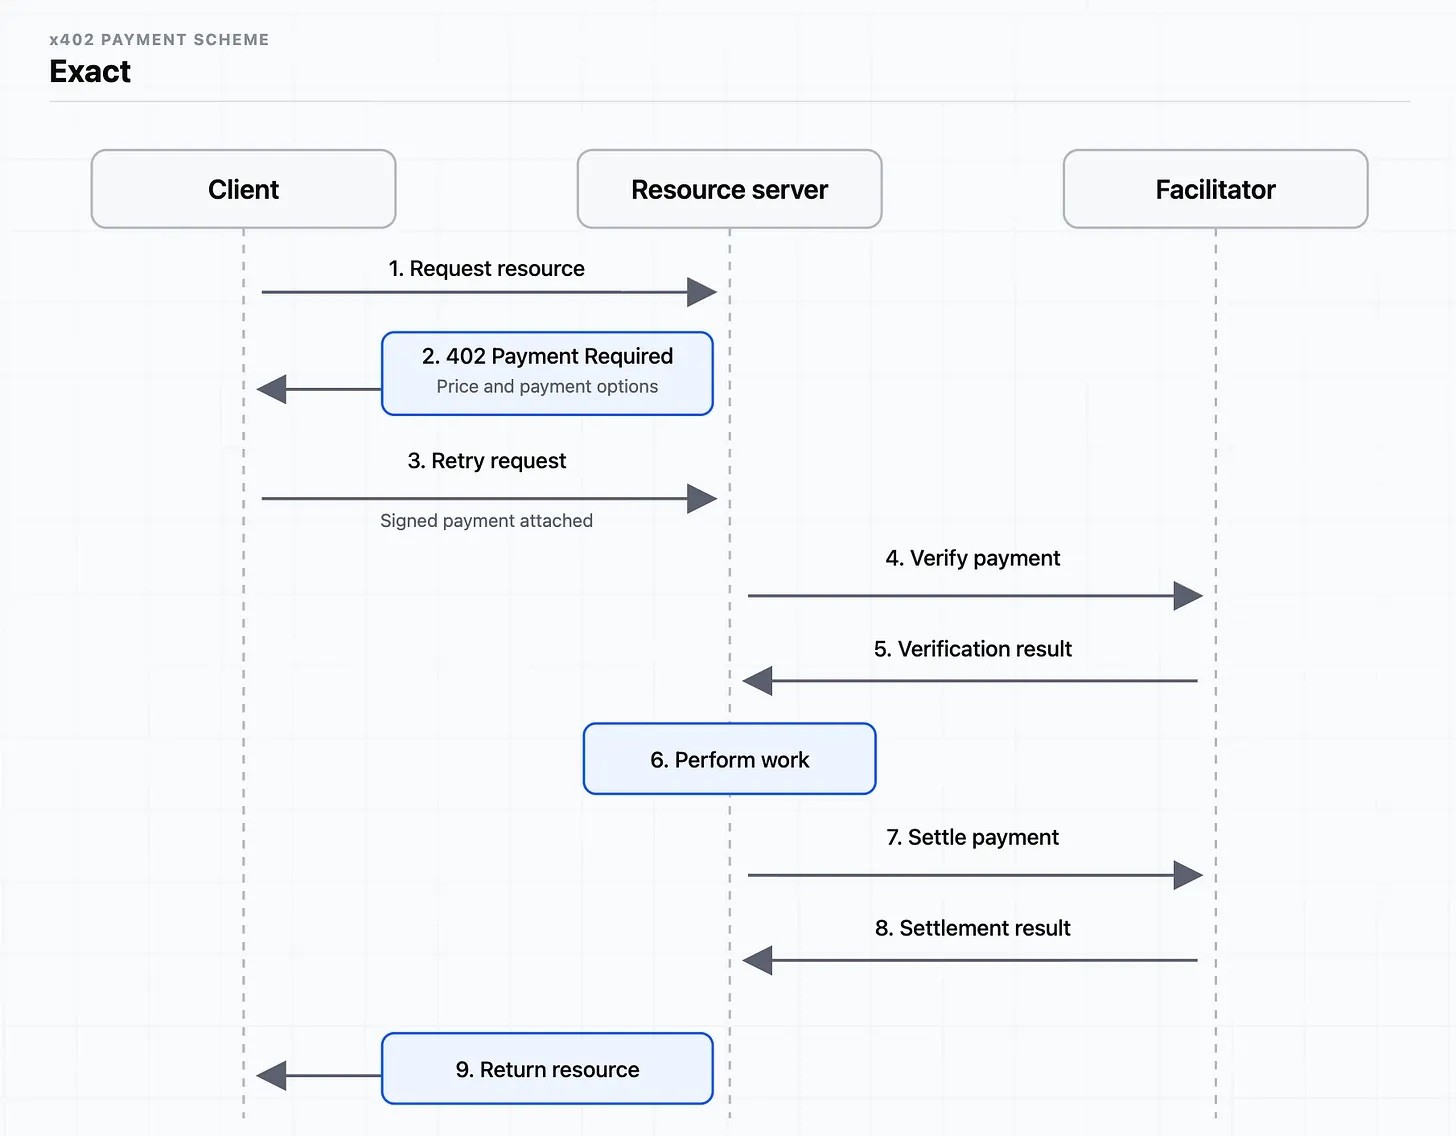
x402는 Coinbase에서 출시했으며 기존 퍼블릭 체인 위에 얹히는 레이어 프로토콜로, 요청 단위마다 비용을 차감하고 스테이블코인으로 송금을 완료한다.
출처: @coinbase
또 다른 하나는 머신 페이먼트 프로토콜(MPP)로, 2026년 3월 Stripe와 Tempo가 공동 발표한 지 Tempo 메인넷이 당일 정식 런칭했다. MPP는 HTTP 표준이다. 서버는 402 결제 필요 응답을 반환하며 도전을 동반하고, 에이전트는 결제 증빙을 들고 요청을 재시도하며, 서버는 자원과 결제 영수증을 돌려준다.
자금의 실제 흐름은 하부 채널에 달려있다. Tempo 상의 단일 거래 체인 정산은 약 0.5초가 소요된다. 일련의 소액 호출에 직면했을 때 에이전트는 미리 자금을 잠궈두고 과정에서 지속적으로 장부를 기재한 뒤 마지막으로 일괄 체인 청산할 수 있으며, 각각의 호출마다 체인 트랜잭션을发起하지 않아도 된다. 결제 한도는 이번 세션 잠금 한도 또는 액세스 키로 제어되며, '일회성 승인·영구 과금' 방식이 아니다.
MPP는 다양한 하부 채널을 지원한다: Visa가 카드 규정을 발표했으며, 에이전트는 토큰화된 카드로 결제 가능할 수 있다. Lightspark는 동일한 402 흐름을 기반으로 라이트닝 네트워크 결제 방안을 구현하고 동시 Visa 카드 계획을 마련했다. 이미 Stripe 카드 결제를接入한 상점은 MPP 카드를 통해 결제를 직접 수령할 수 있으며 자금은 일반 Stripe 계좌로 진입한다. 라이트닝 네트워크는 MPP 규칙 아래 또 다른 선택 채널이다. Stripe는 x402도 동시에 지원한다. x402와 MPP는 모두 HTTP 402 「결제 필요」 상태 코드를 재활용하지만, 둘은 서로 다른 프로토콜에 속한다.
콘텐츠 크리에이터는 보상을 받았는가?
크리에이터가 돈을 받지 못하면 새로이 검색할 콘텐츠가 고갈될 것이다. 수익 창출이 불가능해지면 작가는 작품 게시를 중단하겠고, AI 에이전트는 결국 새로운 독서 소재를 다 떨어뜨릴 것이다.
Cloudflare, Parallel, OpenLedger는 해당 분야의 대표적인 세 프로젝트다.
Cloudflare는 초기에 크롤러가 웹페이지를 긁어갈 때 일정 금액을 균일하게 청구했다. 이 방식은 지나치게 거칠어서 홈 페이지 긁기와 깊이 있는 보도 기사를 긁는 경우의 요금이 완전히 동일했다. 이제 Cloudflare는 가치 기반 과금 모델로 전환했다. 콘텐츠가 진정한 가치를 창출할 때만 발행측에 보상을 지급한다. 아울러 광고 수익형 사이트에 대해서는 AI 서비스 제공업체가 유료화를 거부할 경우 Cloudflare가 AI 크롤러를 차단한다.
Parallel은 5월 19일 Index 제품을 선보였다. 협력 게임 이론의 샤플리 값(Shapley Value) 알고리즘을 차용해 각 정보원이 에이전트의 최종 작업 결과에 기여한 비중을 계산하고 이에 따라 수익을 분배한다. 클릭 수 기준으로 균일하게 지급하던 방식을 벗어났다. 대신 수학 모델을 통해 단편 글 하나가 작업에 기여한 실질적 영향을 측정한다. 협력사는 The Atlantic, Fortune, PR Newswire, PitchBook, ZoomInfo, Tracxn, RocketReach, Enigma, Fiscal AI 등이다.
현재 Index는 에이전트가 Parallel 자체 검색 도구를 사용할 때만 정산이 이루어진다. 다른 모든 AI 플랫폼이接入하지 않는 한, 이 방식이 전역 공통 표준이 될 수는 없을 것이다.
OpenLedger는 또 다른 방안으로 토큰 시스템을 활용한다. 데이터세트가 AI 모델에 미치는 영향도를 집계하여 자체 토큰으로 기여자에게 보상을 배분한다. 이 방안은 AI 훈련 데이터 개발자를 타겟으로 하며, 기자의 일상적인 기사 원고에 대한 보상을 목적으로 하지 않는다.
필자는 이러한 프로젝트들이 크리에이터에게 실제로 지급하는真實 금액 데이터를 찾기 시도했다. Cloudflare는 현금화 수치를 공개하지 않았으며, Parallel 역시 폭스하지 않았고, OpenLedger는 OPEN 토큰으로 결재하지만 총 현금화 규모에 대한 독립 통계는 외부에 공개하지 않았다. 그러므로 현재로서는 이 메커니즘의 실질 효과를 판단할 확실한 사실관계가 부재하다.
인간 상업 발전사에서 계산기는 오히려 매우 늦게 등장한 산물이다. 인간은 오랜 세월 구두 약속과 현지 평판 체계를 축적한 뒤에야 낮은 마찰력의 결제를 발명했다. 반면 머신 인터넷의 발전 경로는 정반대다. 탄생 순간부터 즉시적이고 스트리밍 형태의 글로벌 정산을 실현했다. 지금 에이전트 경제는 막중한 상황에 두 대의 로봇이 몇 달러짜리 업무로 서로 사기 치는 것을 방지하려 온통 서둘러 체인 상 소액 분쟁 법정까지 쌓아올리고 있다.
마치는 글로 테리 프린셋(Terry Pratchett)의 말을 빌린다:
「순수 논리만 외치며 기계는 주어진 명령을 따르기만 한다고 말하기도 쉽다. 하지만 사람들은 기계가 조금만이라도 상식을 갖추기를 기대할 권리가 있다.」