


X 신규 알고리즘 오픈소스 공개, 우리는 도대체 어떤 콘텐츠를 만들어야 더 매력적으로 다가갈 수 있을까?
좋아요는 거의 가치가 없고, 대화와 상호작용이야말로 진정한 화폐다.
저자: David, TechFlow
1월 20일 오후, X는 새로운 추천 알고리즘의 코드를 공개했다.
머스크가 덧붙인 답변이颇有 흥미로웠다. "이 알고리즘이 얼마나 멍청한지 우리가 잘 안다. 아직 대대적인 수정이 필요하지만, 적어도 우리가 실시간으로 개선하려고 발버둥치는 모습을 볼 수는 있다. 다른 소셜 미디어 플랫폼은 감히 이렇게 하지 못할 것이다."
이 말에는 두 가지 의미가 담겨 있다. 하나는 알고리즘에 문제가 있음을 인정하는 것이며, 다른 하나는 ‘투명성’을 강점으로 내세우는 것이다.
이번이 X가 두 번째로 알고리즘을 오픈소스화한 사례다. 2023년에 공개된 이전 버전의 코드는 3년간 업데이트되지 않아 실제 시스템과 이미 괴리되어 있었다. 이번에는 완전히 새로 작성되었으며, 핵심 모델이 기존의 전통적 머신러닝에서 그록(Grok) 트랜스포머로 교체되었다. 공식 입장은 “수작업으로 특징을 설계하는 과정을 완전히 제거했다”는 것이다.
쉬운 말로 풀면: 예전 알고리즘은 엔지니어가 수동으로 파라미터를 조정하는 방식이었지만, 이제는 AI가 사용자의 상호작용 기록을 직접 분석해 콘텐츠를 노출할지를 결정한다는 뜻이다.
콘텐츠 제작자에게 있어 이는 과거의 ‘언제 게시해야 하는가’, ‘어떤 태그를 붙여야 팔로워가 늘어나는가’ 같은 미신들이 더 이상 통하지 않을 수 있음을 의미한다.
우리는 AI의 도움을 받아 공개된 깃허브 저장소도 살펴보았으며, 코드 내부에 실제로 몇 가지 명확한 논리 구조가 숨어 있는 것을 확인했다. 자세히 들여다보자.
 예를 들어보자. 구형 알고리즘은 사람이 직접 작성한 점수표처럼, 항목마다 체크해서 점수를 매기는 방식이었다.
반면 신형 알고리즘은 당신의 모든 열람 기록을 본 AI가 바로 다음에 보고 싶은 것을 바로 추측하는 형태다.
콘텐츠 제작자 입장에서는 이로 인해 두 가지 변화가 생긴다.
첫째, 과거의 ‘최적 게시 시간’, ‘황금 태그’ 등의 테크닉은 참고 가치가 낮아졌다.
왜냐하면 모델은 더 이상 이런 고정된 특징을 보지 않고, 오직 각 사용자의 개인적 선호만을 고려하기 때문이다.
둘째, 당신의 콘텐츠가 얼마나 많이 노출되느냐는 점점 더 ‘당신의 콘텐츠를 본 사람들이 어떻게 반응하느냐’에 달려 있다.
이 반응은 15가지 행동 예측으로 측정되며, 다음 장에서 자세히 설명하겠다.
 공식은 다음과 같다:
최종 점수(Final Score) = Σ (가중치 × P(행동))
긍정적 행동의 가중치는 양수이며, 부정적 행동의 가중치는 음수다.
최종 점수가 높은 포스트가 상위에 노출되고, 낮은 것은 아래로 가라앉는다.
공식을 벗어나서 생각해보면, 핵심은 다음과 같다:
이제 콘텐츠가 좋은지 나쁜지는 콘텐츠 자체의 질보다는 '해당 콘텐츠를 보고 당신이 어떤 반응을 보일지'에 더 크게 좌우된다. 물론 가독성과 유익함은 전파의 기초이지만, 알고리즘은 콘텐츠 자체의 질보다는 당신의 행동을 중시한다.
극단적으로 생각해보면, 저속하더라도 사람들이 댓글을 달며 분노하게 만드는 포스트가, 훌륭하지만 아무도 상호작용하지 않는 포스트보다 더 높은 점수를 받을 수도 있다는 뜻이다. 시스템의 근본 논리는 아마도 이것이 맞을 것이다.
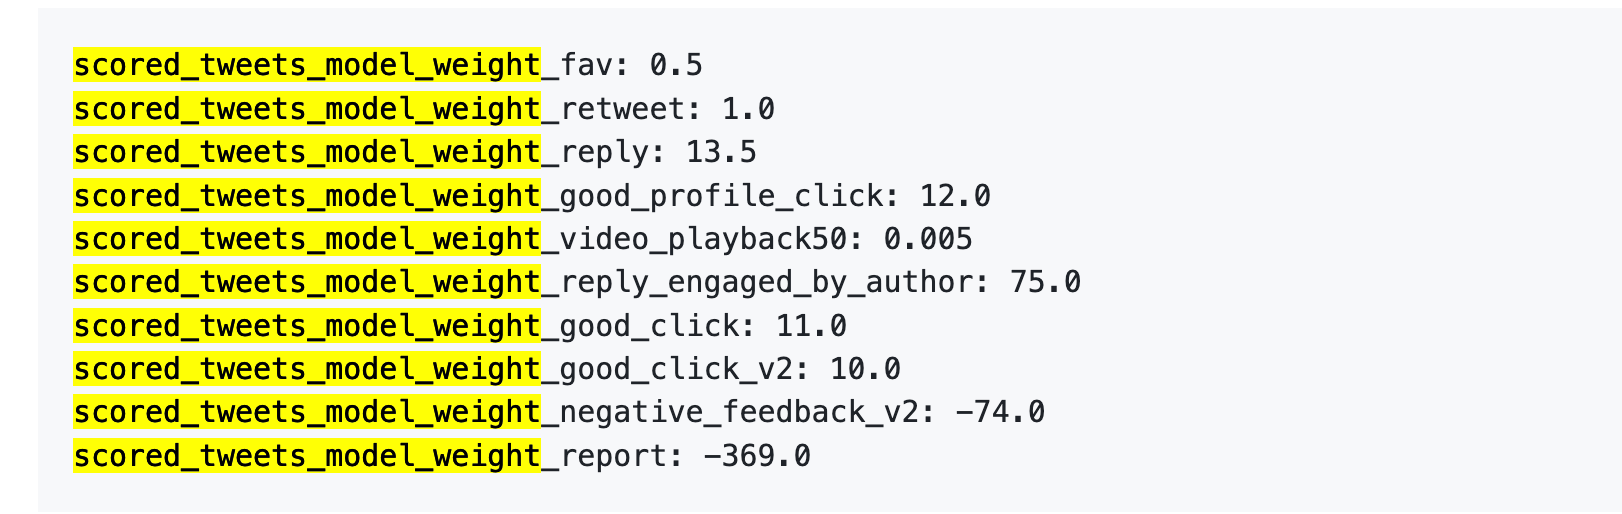
다만, 이번에 공개된 새 버전 알고리즘은 각 행동의 구체적인 가중치 값을 공개하지 않았다. 그러나 2023년 버전은 공개한 바 있다.
 더 쉽게 풀어보면:
 자료 출처: 옛 버전 GitHub twitter/the-algorithm-ml 저장소, 클릭하면 원래 알고리즘 확인 가능
다음의 몇 가지 숫자는 주목할 만하다.
첫째, 좋아요는 거의 무가치하다.
가중치는 0.5로, 모든 긍정적 행동 중 가장 낮다. 알고리즘 관점에서 좋아요 하나의 가치는 거의 0에 가깝다.
둘째, 대화형 상호작용이 진짜 화폐다.
‘당신이 답글을 달고, 작성자가 다시 답글을 달 때’의 가중치는 75로, 좋아요의 150배에 달한다. 알고리즘이 원하는 것은 일방적인 ‘좋아요’가 아니라 왕복하는 대화다.
셋째, 부정적 피드백의 대가는 매우 크다.
차단 또는 음소거(-74)는 148회의 좋아요로 상쇄해야 한다. 신고(-369)는 무려 738회의 좋아요가 필요하다. 또한 이러한 마이너스 점수는 계정 신뢰도 점수에 누적되어 이후 모든 포스트의 배포에 영향을 준다.
넷째, 영상 전체 재생율의 가중치가 놀랄 만큼 낮다.
단 0.005로, 거의 무시할 수준이다. 이는 틱톡(TikTok)이나 도우인(抖音)과 극명한 대비를 이룬다. 이들 플랫폼은 완결 시청률을 핵심 지표로 삼는다.
공식 문서에서도 동일하게 밝혔다. "파일 내 정확한 가중치는 언제든지 조정될 수 있다... 이후 우리는 플랫폼 지표를 최적화하기 위해 주기적으로 가중치를 조정해왔다."
가중치는 언제든지 바뀔 수 있으며, 실제로도 조정된 바 있다.
새 버전은 구체적인 수치를 공개하지 않았지만, README에 명시된 논리 구조는 동일하다. 긍정적 행동은 가산점, 부정적 행동은 감점, 이를 가중합산.
구체적인 숫자는 바뀌었을 수 있으나, 그 등급 간의 관계는 여전히 유지되었을 가능성이 높다. 즉, 다른 사람의 댓글에 답글을 다는 것은 좋아요 100개를 받는 것보다 더 유리하다. 누군가 당신을 차단하게 만드는 것은 아무도 상호작용하지 않는 것보다 훨씬 더 해롭다.
알고리즘 로직 변화: 수작업 정의에서 AI 자동 판단으로
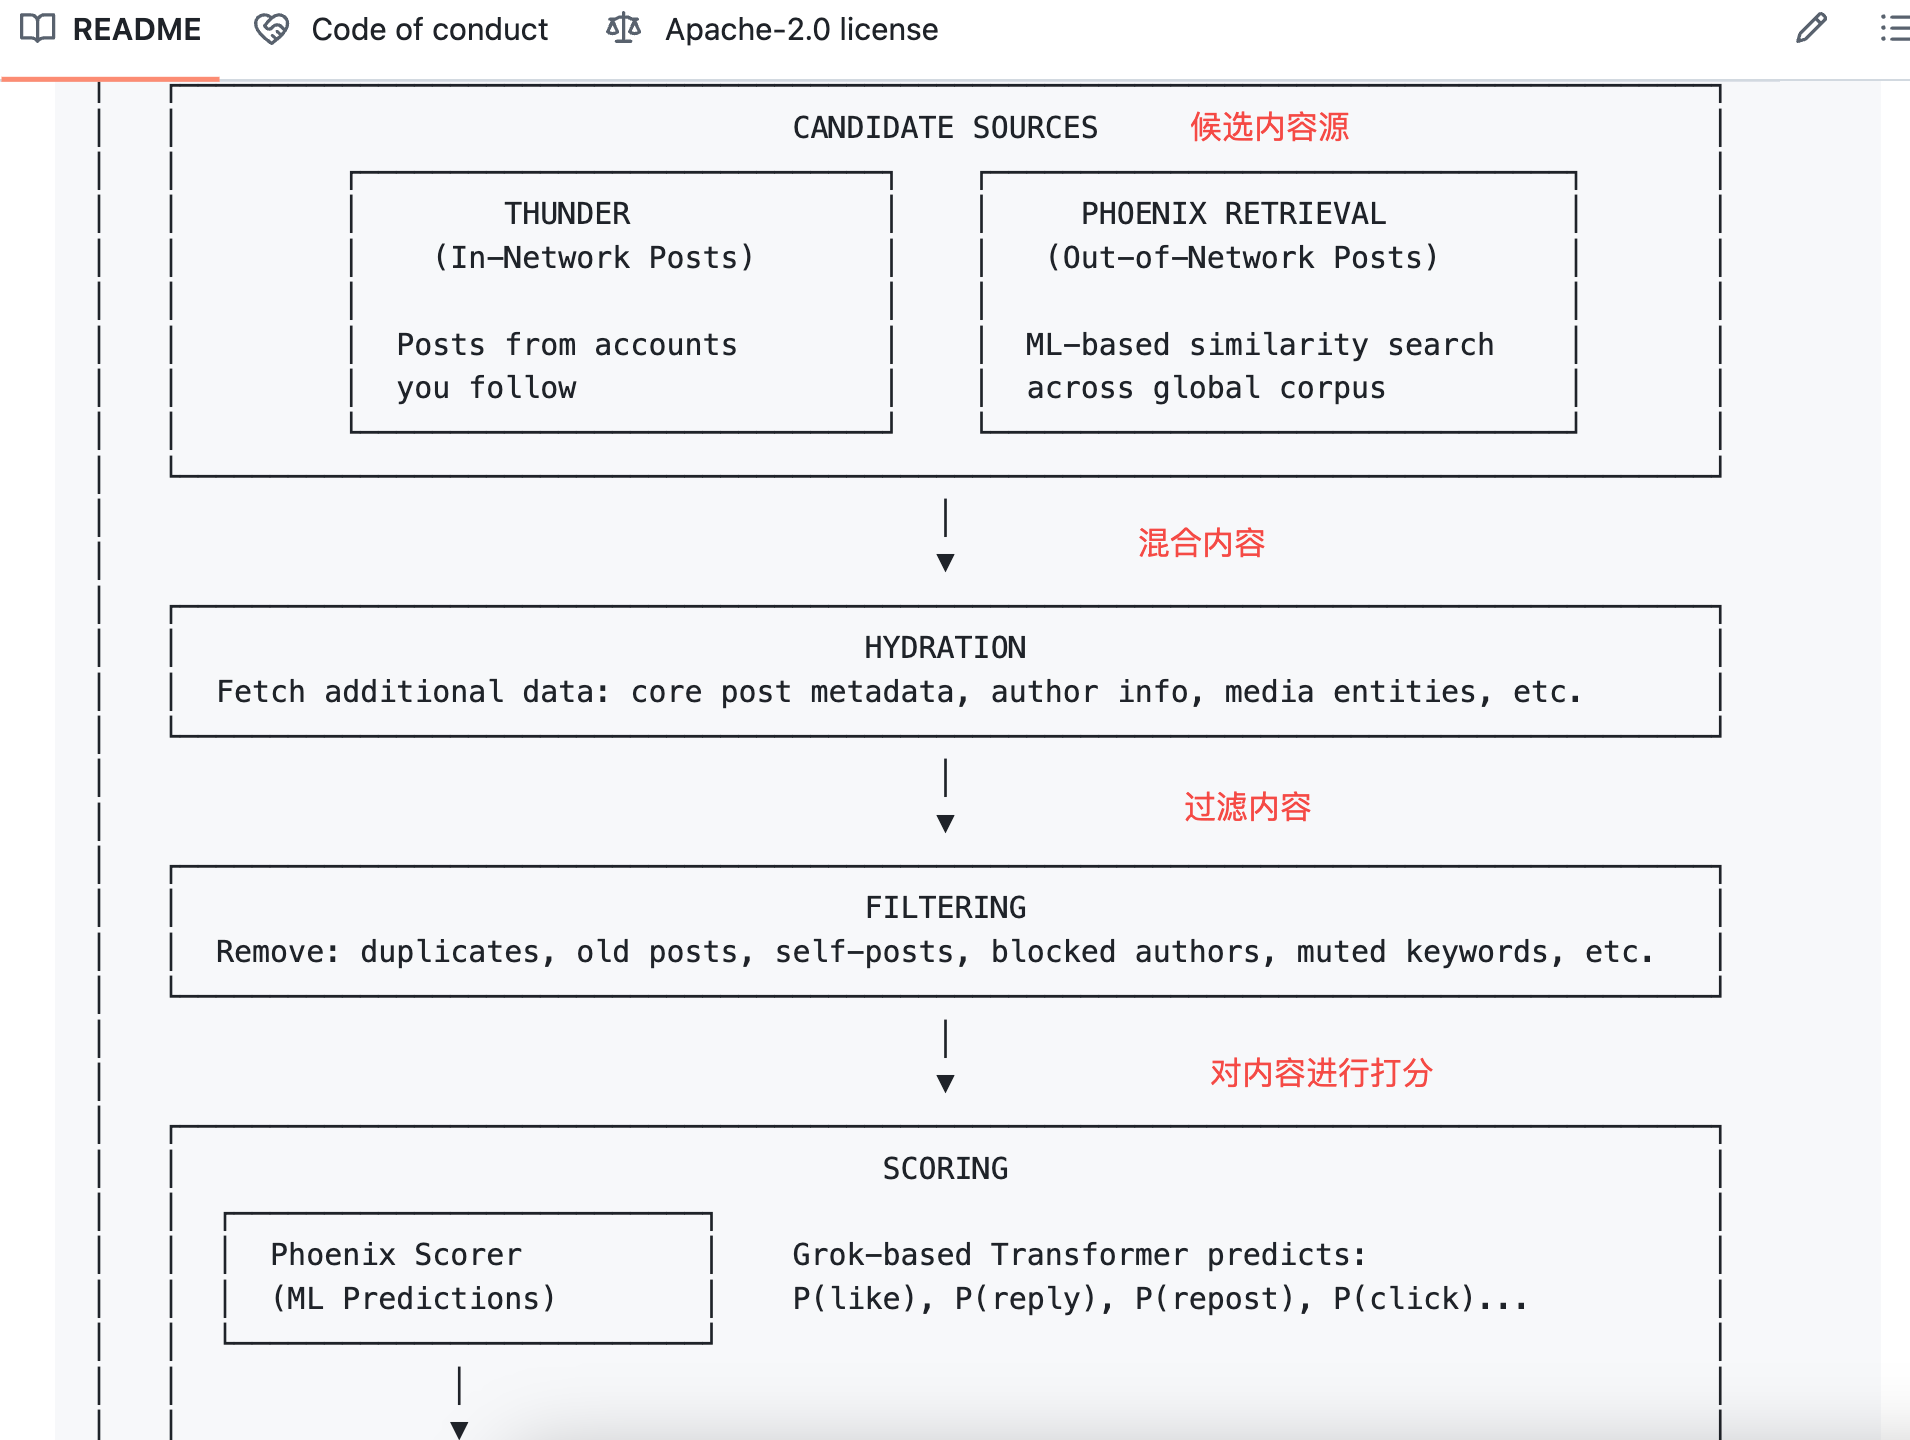
먼저 새 버전과 옛 버전의 차이점을 명확히 하자. 그렇지 않으면 이후 설명이 혼란스러울 수 있다. 2023년, 트위터가 공개한 버전은 Heavy Ranker라고 불렸으며, 본질적으로 전통적인 머신러닝 방식이었다. 엔지니어들은 수백 가지의 '특징(feature)'을 수동으로 정의해야 했다. 예를 들어, 해당 포스트에 사진이 포함됐는지, 게시자의 팔로워 수는 얼마인지, 게시 시점이 현재로부터 얼마나 되었는지, 링크가 포함돼 있는지 등등이었다. 그리고 각 특징마다 가중치를 부여하고 이것을 반복적으로 조정하며 어떤 조합이 가장 효과적인지 평가했다. 이번에 공개된 새 버전은 Phoenix라 불리며, 아키텍처가 완전히 다르다. 말하자면 AI 대규모 모델에 더욱 의존하는 알고리즘인데, 핵심은 Grok의 트랜스포머 모델이며, ChatGPT나 Claude와 동일한 기술 체계를 사용하고 있다. 공식 README 문서는 매우 직설적으로 밝히고 있다. "We have eliminated every single hand-engineered feature." (모든 수작업으로 설계된 특징을 완전히 제거했다.) 내용의 특징을 수작업으로 추출하던 규칙은 단 하나도 남김없이 모두 제거된 것이다. 그렇다면 지금 이 알고리즘은 무엇을 기준으로 콘텐츠의 질을 판단하는가? 정답은 바로 당신의 행동 시퀀스(behavior sequence)다. 당신이 과거에 어떤 콘텐츠에 좋아요를 눌렀는지, 누구에게 답글을 달았는지, 어떤 포스트에서 2분 이상 머물렀는지, 어떤 계정을 차단했는지 등을 Phoenix는 모두 수집해 트랜스포머 모델에 입력하고, 모델이 스스로 패턴을 학습하고 요약하게 만든다.
예를 들어보자. 구형 알고리즘은 사람이 직접 작성한 점수표처럼, 항목마다 체크해서 점수를 매기는 방식이었다.
반면 신형 알고리즘은 당신의 모든 열람 기록을 본 AI가 바로 다음에 보고 싶은 것을 바로 추측하는 형태다.
콘텐츠 제작자 입장에서는 이로 인해 두 가지 변화가 생긴다.
첫째, 과거의 ‘최적 게시 시간’, ‘황금 태그’ 등의 테크닉은 참고 가치가 낮아졌다.
왜냐하면 모델은 더 이상 이런 고정된 특징을 보지 않고, 오직 각 사용자의 개인적 선호만을 고려하기 때문이다.
둘째, 당신의 콘텐츠가 얼마나 많이 노출되느냐는 점점 더 ‘당신의 콘텐츠를 본 사람들이 어떻게 반응하느냐’에 달려 있다.
이 반응은 15가지 행동 예측으로 측정되며, 다음 장에서 자세히 설명하겠다.
알고리즘은 당신의 15가지 반응을 예측한다
Phoenix는 추천 대상인 포스트를 받은 후, 현재 사용자가 해당 콘텐츠를 보고 나타낼 수 있는 15가지 행동을 예측한다:- 긍정적 행동: 좋아요, 답글, 리트윗, 인용 리트윗, 포스트 클릭, 작성자 프로필 클릭, 비디오 절반 이상 시청, 이미지 확장, 공유, 일정 시간 이상 머무름, 작성자 팔로우
- 부정적 행동: '흥미 없음' 클릭, 작성자 차단, 작성자 음소거, 신고
공식은 다음과 같다:
최종 점수(Final Score) = Σ (가중치 × P(행동))
긍정적 행동의 가중치는 양수이며, 부정적 행동의 가중치는 음수다.
최종 점수가 높은 포스트가 상위에 노출되고, 낮은 것은 아래로 가라앉는다.
공식을 벗어나서 생각해보면, 핵심은 다음과 같다:
이제 콘텐츠가 좋은지 나쁜지는 콘텐츠 자체의 질보다는 '해당 콘텐츠를 보고 당신이 어떤 반응을 보일지'에 더 크게 좌우된다. 물론 가독성과 유익함은 전파의 기초이지만, 알고리즘은 콘텐츠 자체의 질보다는 당신의 행동을 중시한다.
극단적으로 생각해보면, 저속하더라도 사람들이 댓글을 달며 분노하게 만드는 포스트가, 훌륭하지만 아무도 상호작용하지 않는 포스트보다 더 높은 점수를 받을 수도 있다는 뜻이다. 시스템의 근본 논리는 아마도 이것이 맞을 것이다.
다만, 이번에 공개된 새 버전 알고리즘은 각 행동의 구체적인 가중치 값을 공개하지 않았다. 그러나 2023년 버전은 공개한 바 있다.
옛 버전 참고: 신고 1회 = 좋아요 738회
이제 2023년 데이터를 살펴보자. 옛날 데이터이긴 하지만, 알고리즘이 각 행동을 얼마나 '가치 있게' 여기는지 이해하는 데 도움이 된다. 2023년 4월 5일, X는 실제로 깃허브에 일련의 가중치 데이터를 공개한 바 있다. 바로 숫자를 보자:
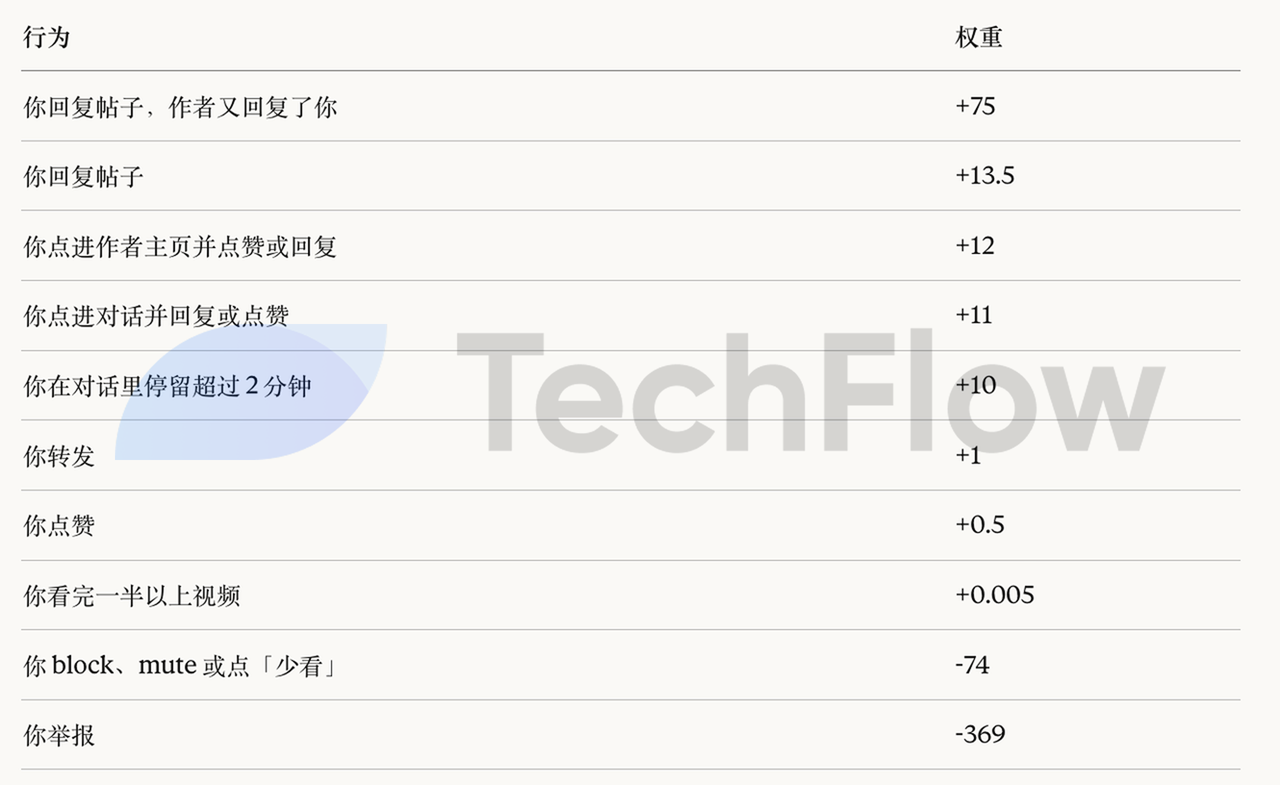
더 쉽게 풀어보면:
자료 출처: 옛 버전 GitHub twitter/the-algorithm-ml 저장소, 클릭하면 원래 알고리즘 확인 가능
다음의 몇 가지 숫자는 주목할 만하다.
첫째, 좋아요는 거의 무가치하다.
가중치는 0.5로, 모든 긍정적 행동 중 가장 낮다. 알고리즘 관점에서 좋아요 하나의 가치는 거의 0에 가깝다.
둘째, 대화형 상호작용이 진짜 화폐다.
‘당신이 답글을 달고, 작성자가 다시 답글을 달 때’의 가중치는 75로, 좋아요의 150배에 달한다. 알고리즘이 원하는 것은 일방적인 ‘좋아요’가 아니라 왕복하는 대화다.
셋째, 부정적 피드백의 대가는 매우 크다.
차단 또는 음소거(-74)는 148회의 좋아요로 상쇄해야 한다. 신고(-369)는 무려 738회의 좋아요가 필요하다. 또한 이러한 마이너스 점수는 계정 신뢰도 점수에 누적되어 이후 모든 포스트의 배포에 영향을 준다.
넷째, 영상 전체 재생율의 가중치가 놀랄 만큼 낮다.
단 0.005로, 거의 무시할 수준이다. 이는 틱톡(TikTok)이나 도우인(抖音)과 극명한 대비를 이룬다. 이들 플랫폼은 완결 시청률을 핵심 지표로 삼는다.
공식 문서에서도 동일하게 밝혔다. "파일 내 정확한 가중치는 언제든지 조정될 수 있다... 이후 우리는 플랫폼 지표를 최적화하기 위해 주기적으로 가중치를 조정해왔다."
가중치는 언제든지 바뀔 수 있으며, 실제로도 조정된 바 있다.
새 버전은 구체적인 수치를 공개하지 않았지만, README에 명시된 논리 구조는 동일하다. 긍정적 행동은 가산점, 부정적 행동은 감점, 이를 가중합산.
구체적인 숫자는 바뀌었을 수 있으나, 그 등급 간의 관계는 여전히 유지되었을 가능성이 높다. 즉, 다른 사람의 댓글에 답글을 다는 것은 좋아요 100개를 받는 것보다 더 유리하다. 누군가 당신을 차단하게 만드는 것은 아무도 상호작용하지 않는 것보다 훨씬 더 해롭다.
이 정보를 알고 난 후, 콘텐츠 제작자는 무엇을 할 수 있을까
트위터의 신구 알고리즘 코드를 분석한 결과, 결론적으로 다음과 같은 실행 가능한 전략을 도출할 수 있다. 1. 댓글에 답글을 달아라. 가중치 표에서 ‘작성자가 댓글에 답글을 달기’는 가장 높은 점수 항목(+75)이며, 사용자의 단순 좋아요보다 150배 더 높다. 댓글을 유도하라는 뜻이 아니라, 누군가 댓글을 달았다면 반드시 답글을 달라는 의미다. “감사합니다” 한마디라도 답글을 달면, 알고리즘은 이를 기록한다. 2. 사용자가 스크롤을 넘기게 만들지 마라. 한 번의 차단(block)은 148회의 좋아요로 상쇄해야 한다. 논란성 콘텐츠는 확실히 상호작용을 유도할 수 있지만, 그 상호작용이 ‘이 사람은 짜증나, 차단!’이라는 방식이라면, 당신의 계정 신뢰도 점수는 계속 손상되어 이후 모든 포스트의 배포에 악영향을 끼친다. 논란성 트래픽은 양날의 검이며, 상대를 베기 전에 자신부터 베는 것이다. 3. 외부 링크는 댓글에 넣어라. 알고리즘은 사용자가 사이트 외부로 나가는 것을 원치 않는다. 본문에 링크를 포함하면 가중치가 낮아진다. 머스크 본인이 공개적으로 언급한 사항이다. 유입을 유도하고 싶다면 본문에는 콘텐츠를, 링크는 첫 번째 댓글에 넣는 것이 좋다. 4. 연달아 게시하지 마라. 새 버전 코드에는 Author Diversity Scorer(작성자 다양성 스코어)가 있는데, 동일 작성자의 연속된 포스트에 가중치를 낮춘다. 사용자의 피드를 더 다양한 콘텐츠로 구성하려는 의도지만, 부작용으로는 10개를 연달아 올리는 것보다 하나를 정성껏 올리는 것이 더 효과적이라는 점이다. 6. 더 이상 ‘최적 게시 시간’은 존재하지 않는다. 옛 버전 알고리즘에는 ‘게시 시간’이라는 수작업 특징이 있었지만, 새 버전은 이를 과감히 제거했다. Phoenix는 오직 사용자의 행동 시퀀스만을 보며, 포스트가 몇 시에 게시됐는지는 보지 않는다. ‘화요일 오후 3시에 게시하면 효과가 좋다’는 팁들의 참고 가치는 점점 낮아지고 있다. 위 내용은 코드 수준에서 파악할 수 있는 정보들이다. X의 공식 문서에서 확인할 수 있는 추가 가산/감점 요소들도 있는데, 이번에 공개된 저장소에는 포함되지 않았다. 예를 들어, 블루 체크 인증은 가산점이 있으며, 전부 대문자 입력은 가중치 감점, 민감 콘텐츠는 도달률 80% 감소 등이 있다. 이 규칙들은 공개되지 않았으므로 여기서는 생략한다. 요약하면, 이번에 공개된 내용은 상당히 실질적이다. 전체 시스템 아키텍처, 후보 콘텐츠 추출 로직, 순위 산정 및 점수화 프로세스, 각종 필터링 기능의 구현까지 포함되어 있다. 코드는 주로 Rust와 Python으로 작성되었으며, 구조가 명확하고, README 문서는 많은 상용 프로젝트보다 훨씬 상세하게 작성되어 있다. 하지만 몇 가지 중요한 것은 공개되지 않았다. 1. 가중치 파라미터가 공개되지 않았다. 코드에는 ‘긍정적 행동은 가산, 부정적 행동은 감점’이라고만 되어 있고, 좋아요 하나당 몇 점인지, block은 얼마나 감점되는지 구체적인 수치는 없다. 2023년 버전은 적어도 숫자를 공개했지만, 이번엔 공식 구조만 제시했다. 2. 모델 가중치가 공개되지 않았다. Phoenix는 Grok 트랜스포머를 사용하지만, 모델 자체의 파라미터는 공개되지 않았다. 모델이 어떻게 호출되는지는 알 수 있지만, 내부 연산 방식은 알 수 없다. 3. 학습 데이터가 공개되지 않았다. 모델이 어떤 데이터로 훈련되었는지, 사용자 행동 데이터는 어떻게 샘플링했는지, 긍정/부정 샘플은 어떻게 구성했는지 등은 전혀 공개되지 않았다. 비유하자면, 이번 공개는 “우리는 가중합산으로 총점을 산출한다”고 알려주는 수준이며, 가중치가 정확히 얼마인지까지는 알려주지 않은 셈이다. “트랜스포머로 행동 확률을 예측한다”고는 말하지만, 트랜스포머 내부가 어떻게 구성돼 있는지는 알려주지 않은 것이다. 타 플랫폼과 비교하면, 틱톡이나 인스타그램은 이런 정보조차 공개한 적이 없다. X가 이번에 공개한 정보량은 실제로 다른 주요 플랫폼보다 많다. 다만 ‘완전한 투명성’까지는 아직 거리가 있다. 하지만 이는 공개가 무의미하다는 뜻은 아니다. 콘텐츠 제작자와 연구자들에게 있어, 코드를 볼 수 있다는 것 자체만으로도 보지 못하는 것보다 훨씬 낫다.TechFlow 공식 커뮤니티에 오신 것을 환영합니다
Telegram 구독 그룹:https://t.me/TechFlowDaily
트위터 공식 계정:https://x.com/TechFlowPost
트위터 영어 계정:https://x.com/BlockFlow_News
즐겨찾기 추가
소셜 미디어 공유
 深潮TechFlow







