


AIが「悪役」に、DeFi保険はストレステストを要する
執筆:jrdothoughts
翻訳・編集:AididiaoJP、Foresight News
DeFi保険の見落としポイント:事故歴がない=安全ではない
まずブラックジョークなセールストークを一つ聞いてください。「当社の新型機は絶対的に安全です。一度も墜落したことがありません。」
「どれくらい飛行しましたか?」
「……う〜ん、確か2回だけですけど。」
この例をDeFiのボールトに置き換えてみると、おなじみのストーリーになります。半年間は順調に引き出しでき、攻撃にも遭わず、利回りの面でも悪くない。これは確かに一つの証拠ではあります。しかし、この半年の間にネットワーク混雑時の担保資産のデカップリング、LP(流動性プロバイダー)による一斉の撤退、オラクル情報の更新遅延といった事象には遭遇したでしょうか。おそらく遭遇していないでしょう。
過去に一切の事故が起きていない状態が示すのは、あくまでそのシステムが何を経験してきたかという事実だけです。引受担当者が問うべきなのは、次は何に直面する可能性があるかという点です。
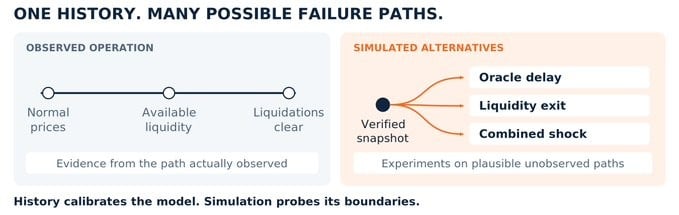
ここにFirelightが市場機会を見出したのです。過去の事故発生有無だけでなく、「どのようなプロセスで損失が発生するか」に基づいて価格設定を行うアプローチです。歴史データは基準を定め、シミュレーションは代替シナリオを探求し、AIは脆弱性を発見し、資本が裏書きをつける――そんな役割分担が期待されています。
歴史はスナップショットだが、システムは変動する
過去の損失データとは、ある機械が特定の条件下で稼働していた状態を切り取ったスナップショットに過ぎません。機械の状態が変われば、スナップショットを改めて見直さなければなりません。
あるボールトに新しい担保資産の種類が追加され、オラクルが変更され、レバレッジ度が引き上げられたとします。名称もロゴも変わらなくても、リスクは既に大きく異なっています。中に組み込まれている借り手やリクイデーター(清算人)、LPは単なる表の数値ではありません。インセンティブに対して行動し、いざという時には皆が同じ出口へ殺到しようとします。
これはちょうど、平常時の火曜日の通勤状況に基づいて描かれた地図のようなものです。普段はよく当てはまっていても、主要な橋が封鎖されればたちどころに使えなくなります。地図自体に誤りはなく、道路環境が変わってしまったのです。
したがって、Firelightにとって真の問題は単に「当該プロトコルがハッキングされたことがあるか」ではなく、「どのような権限が存在するか」「どの依存関係が本当に重要か」「全参加者が同時に撤退を試みた際、どの清算パスが機能し続けるか」という点にあります。Firelightが公開しているフレームワークでは、技術的脆弱性と経済的脆弱性が明確に分離されており、それらを一本化して安全スコアとして算出する仕組みにはなっていません。
引受の対象となるのは、システムの現在の構成と依存関係であり、長年受け継がれてきたブランド名ではありません。
キャタストロフィー保険(巨災保険)はすでにシナリオを作成している
伝統的な保険会社も不確実性のモデリングを放棄していません。キャタストロフィー(大規模災害)保険の担い手は常に、災害がどのように発生し、どの資産が曝露するか、構造的にどれほど脆弱か、最終的に契約はいくら支払う必要があるかをシミュレーションしてきました。過去に襲来したハリケーンが、これから起きうる全てのハリケーンを代表できるわけではありません。
DeFiにも独自のキャタストロフィーモデルが必要です。ただし、災害がハリケーンからオラクル障害へと変わり、被害対象が建物からローンポジションへ、脆弱性が建築品質から担保バッファーと清算設計へ移行し、最終的には保険条項に基づいて賠償金を算出するという違いがあります。
キャタストロフィーモデルが問うのは「ハリケーンが都市を通過するとどうなるか」でした。DeFiモデルが問うのは「ある障害が依存関係のグラフに沿って拡散するとどうなるか」です。
Firelightは公開議論の中で、リスク分解、歴史補正、モンテカルロシミュレーション、言語モデル、強化学習を組み合わせた「金融クラッシュテストラボ」の構築を提唱しています。ただしこれは提案段階の方向性であり、すべての要素がすでに運用されていることを意味するものではありません。
補足ですが、Firelightは自社の製品を伝統的な保険契約ではなく「プロトコルベースの保障」であると定義しています。本文中における保険の类比は、引受規律に着目したものであり、製品の法的性質については言及していません。
金融クラッシュテストラボの構築方法
第一段階:初期状態を固定し、再現性を確保します。スマートコントラクトのバージョン、残高、担保ポジション、およびオラクル設定、清算ルール、市場流動性をすべてロックする必要があります。これを行わないと、二つのシミュレーション結果が一致しない場合、単純に開始地点が異なるだけで、実は同じシステムを評価していない可能性があります。
第二段階:実行と仮定の切り分けを行います。ブロックチェーンのフォークを用いれば実際のコントラクト論理を実行できますが、明日の流動性やオンチェーン外の価格、人間の行動などを空想で生み出すことはできません。これらは明示的にモデル化する必要があります。フォークを利用したエージェント駆動型のテスト手法は、DeFi研究において既に実績があります。
第三段階:模擬環境に参加者を配置します。借り手、リクイデーター、預け手、LPなど、各主体には資金制約とインセンティブが存在します。ただし、誰かに主人公光环を与えるべきではありません。リクイデーターが良い結末を作るためだけに赤字取引をしてはいけません。登場人物を全員LLM(大規模言語モデル)にする必要はなく、単純かつ透明なルールの方が優れていることも多く、処理速度も早く再現性も高まります。技術面的な欠陥発見には依然としてファズテスト、コードレビュー、フォルトインジェクションが不可欠であり、これらの手法は経済シミュレーションと並列して実行されるもので、相互に置き換わるものではありません。
第四段階:破壊(ストレス発生)を行います。価格のジャグ(スキップ)、オラクルの更新遅延、流動性の枯渇、執行の中断など、あらゆる事象をテストします。変化させるのは規模だけでなく順序でもあります。LPが価格ショックの前に流動性を撤回する場合と、ショックの後に撤回する場合では、結果が全く異なる可能性があります。
シミュレーションの最終出力は、曖昧な安全スコアであってはならず、損失連鎖であるべきです。「どのポジションが最初に失敗したか」「いくつ回収できたか」「ギャップがどのように拡大したか」。この連鎖を明らかにして初めて、カバレッジリミットや資本要件の設定、あるいは潔く「保険不適用」の判断を下せるのです。
AIに「悪役席」を与えても、物理法則は変えられない
AIの最も直感的な用途は、コードとドキュメントの読解です。言語モデルは依存関係を整理したり、アップグレード内容を解説したり、失敗シナリオを提示したりできます。しかし、説得力のある物語が作成されたからといって、実際に脆弱性が見つかったわけではありません。それは依然としてエビデンスが必要です。
より興味深い使い方は、AIが自ら可能なシナリオを探査させることです。モンテカルロシミュレーションは設定された分布からサンプリングしますが、もちろん役に立ちます。しかし、本当に致命的な組み合わせは稀すぎて、ランダムサンプリングの大部分は単に通常ケースの繰り返しになってしまうかもしれません。
適応型ストレステストはこの流れを逆手にとります。エージェントがシミュレーター内で摂動因子を選択し、信頼性の高い失敗経路を能動的に探ります。自動運転テストの分野では、強化学習を使ってこのアプローチが既に実証されています。エージェントは気象を変えられますが、物理法則を書き換えることはできません。
Firelightの提案設定では、エージェントは現実的な境界線内でオラクルの遅延、流動性撤退、リクイデーターの介入頻度を調整できます。破壊的な経路を見つければ報酬、不正行為があればペナルティ。無限の資本と全能権限を持つ悪役は、有益な引受モデルにはなり得ません。
その後、AIに失敗軌跡のクラスタリングを行い、不確実性を最も減らせる次の実験群を選び出させます。見た目上は数百種類違うように思える災害も、同じ清算ネックポイントを共有している可能性があります。それこそが具体的なアクションにつながる価値です。
速度も重要です。低コストな近似手法で多数のシナリオを事前スクリーニングし、後から高コストな実行テストで重要シナリオを複数の独立したテスト環境で再実行します。ただし、近道は検証されていなければなりません。誤ったシミュレーターを高速化しても、ただ間違いをより迅速に、かつ自信を持って犯すようになるだけです。
AIが果たすべき役割は、アドバーサリアルテストにおける運転手であり、安全審判官ではありません。何が調査対象になるかはAIですが、その発見が妥当かどうかを決めるのは実行エンジン、ドメイン専門家、そしてエビデンスです。
損失軌跡から保障条項へ
架空のローンボルトを想定してみましょう。担保資産の下落、LPの一斉撤退、オラクル更新の遅滞が発生します。リクイデーターは介入しましたが、スリッテージにより回収価値が目減りし、最終的には借り手の負債額が担保資産の実質売却価額を上回る事態になりました。
コントロールグループを設定して比較します。価格だけが下落する場合、価格下落と同時に流動性が枯渇する場合、複数要因が同時に作用する場合など。そうすることで、真の弱点が価格にあるのか、マーケットディープネスにあるのか、あるいは両者の相互作用にあるのかを見極められるのです。
一例として、シミュレーション実行で200万ドルの認定損失が発生し、免責額が50万ドル、保証限度額が100万ドルだと仮定します。まず最初の50万ドルがセルフリテンション層で吸収され、次に保険側で100万ドルが支払い、残り50万ドルはカバー範囲外となります。
これは架空のサンプル条項であり、Firelightの正式見積もりでもなく、実際のシミュレーション結果でもありません。認定基準、回収プロセス、除外責任、重複保険などは引き続き整理する必要があります。
重要なのは、経済的損失が発生したからといって自動的に賠償金が支払われるわけではないということです。シミュレーションが真の意味で価値を生むのは、引受決定に反映されて初めてです。例えば、カバレッジリミットを引き下げる、より厳格なリスク管理を求める、追加資本を積む、あるいは潔く契約を断るなどの判断につながらなければなりません。災害シミュレーションアニメーションがいくら立派でも、それ自体が財務上の決定を下すわけではありません。
失敗経路を発見すること≠確率を計算すること
アドバーサリアルエージェントがテストの30%でシステムを突破したとしましょう。これはシステムが30%の失敗確率を持っていることを意味するのでしょうか。答えはノーです。そのエージェントはそもそも脆弱性を検索するために特化して作られているからです。
失敗を検出することは、「どう壊れる可能性があり、どこまで壊れうるか」に答えます。確率を推定することは、「これらの条件が保険期間中にどれだけ頻繁に発生するか」に答えます。この2つを混同すれば、偽りの精度を生み出すことになります。
概念的レベルでは、期待賠償額は各シナリオでの賠償金額にそのシナリオの発生確率を乗じ、総和を取ったものです。これらの確率にはエビデンスによる裏付けが必要であり、仮定も明確に文書化されるべきです。信頼できる推計値がない場合は、区間推定や保守的上限、ストレステストによる制約を用い、少数点以下まで精緻に数値を捏造してはいけません。
期待賠償額はプレミアム全体に等しくありません。資本はテールリスク、運営コスト、不確実性をカバーするために充当される必要があり、テールリスクは往々にして非常に過酷な内容になります。ポートフォリオの観点で見ると、共通の依存関係によって複数のコントラクトが同時に賠償トリガーを発動させる可能性もあります。
Firelightが公開している資本枠組みでは、集中リスクと担保資産のドリフト(値動き/下落)が既に考慮されています。シミュレーションにおいては両端同時のストレステストが行われるべきです。一方は保険金請求の急増、他方は支援資産の同時減価売却難化です。大規模災害時に資本自体が縮小する場合、保障プールは平均損失だけで推計してはいけません。
「ストレステスター」自身を誰がストレステストするのか?
シミュレーターは論理的に一貫していても、導き出される結論が完全に間違っている場合があります。非現実的なリクイデーター設定で100万回実行しても、単に一つの過ちを100万回繰り返しているに過ぎません。実行回数を増やせばサンプリングエラーは減少しますが、モデル自体のバイアスが自動的に縮小するわけではないのです。
信頼できるラボは以下の4つの活動を行います:既知のイベントを振り返る(ポストモーテム)、アウトオブサンプルデータで検証する、別チームが独立に構築したモデルと比較する、参加者の行動に関する仮定を調整する。スナップショット、乱数シード、実行ログは全てアーカイブされ、重要な発見の再現性を確保します。そして何度も問いかけなければなりません。AIが発見したのは、プロトコルの脆弱性なのか、それともシミュレーター自身のバグなのかと。
どのテストセットも、全ての災害経路を網羅したと証明できるものではありません。未知の依存関係や未曾有の行動パターンが存在し得るからこそ、資本バッファー、除外責任、引受における自制心が求められるのです。
契約の境界線も明確にしておく必要があります。新たなエビデンスは将来の価格設定とキャパシティに影響を与え得ますが、既存のカバレッジがターゲットのように揺らぐものになってはいけません。Firelightの公開フレームワークでは、継続的なリスクモニタリングとカバー期間中の固定レートが明確に分離されています。継続的な学習と約束の維持は両立可能ですが、危険が生じてから約束事項を書き換えるのは許されません。
結論:損失出現前に学ぶ
最大の価値は、引受プロセスを開発フローに埋め込むことにあります。システムに重大な変更が入れば対応テストがトリガーされ、その結果が新たな保障判断に反映され、実際の事案が次期モデルの改善に役立ちます。エンジニアリング品質が高まるほど、最終的には保障価格とアクセス可能性に直結してきます。
過去の理赔記録は事後の補習に過ぎません。シミュレーションにより、Firelightはシステムがどのように障害を起こし得るかを事前に把握することができます。
AIが検索範囲を拡張し、エビデンスが結論を拘束し、資本が約束を果たす役割を担います。目標はあらゆる災害を予測することではなく、直面し得る状況を明確にした上で資本を投じ、避けられない損失を受け止める準備を整えることです。
TechFlow公式コミュニティへようこそ
Telegram購読グループ:https://t.me/TechFlowDaily
Twitter公式アカウント:https://x.com/TechFlowPost
Twitter英語アカウント:https://x.com/BlockFlow_News
 @jrdothoughts














