


Neurophos 光チップ資金調達1億1000万米ドル:同等消費電力時の演算性能はGPUの25倍に達すると主張
著者:Sabbir Rangwala
編集:TechFlow
TechFlow 解説:オースティンのスタートアップ企業 Neurophos は、シリコンフォトニクスとメタマテリアルを用いて光学計算ユニット(OCU)を開発し、Gates Frontier がリードし、Microsoft のベンチャーキャピタルである M12 などが参画するシリーズAラウンドで1億1,000万米ドルの資金調達を果たした。記事によると、その光コアイノベーターはチップ内のスイッチを必要とせず、同等のサイズと消費電力を持つGPUと比較して演算能力が約25倍に達するという。OCUは2028年に導入され、2034年には市場規模が約27億ドルに達すると予測されており、これはAI推論におけるプリフィル段階での行列演算性能とデータセンターのエネルギー消費のボトルネックに賭けたものである。
要旨
光演算は1960年に始まり、過去数十年で顕著な成熟を遂げており、光ドメイン内で計算を実行する。テキサス州オースティンを拠点とするNeurophosは、シリコンフォトニクス回路とメタマテリアルを用いて光学計算ユニット(OCU)を構築している。同社は先頃、フォトンAIチップの開発を加速させるため1億1,000万米ドルのシリーズAファンド調達を完了した。Neurophosの光学コアイノベーションは内部スイッチを必要とせず、光速で瞬時に計算を完了できる。そのため、同一のチップ面積と消費電力条件下で、従来のGPUに対して大幅に高い秒間演算数を達成可能だ。潜在的市場も極めて巨大であり、OCUがデータセンター内のGPU演算市場を順次代替していくにつれ、当該市場は現在年間約1兆米ドルと見積もられている。
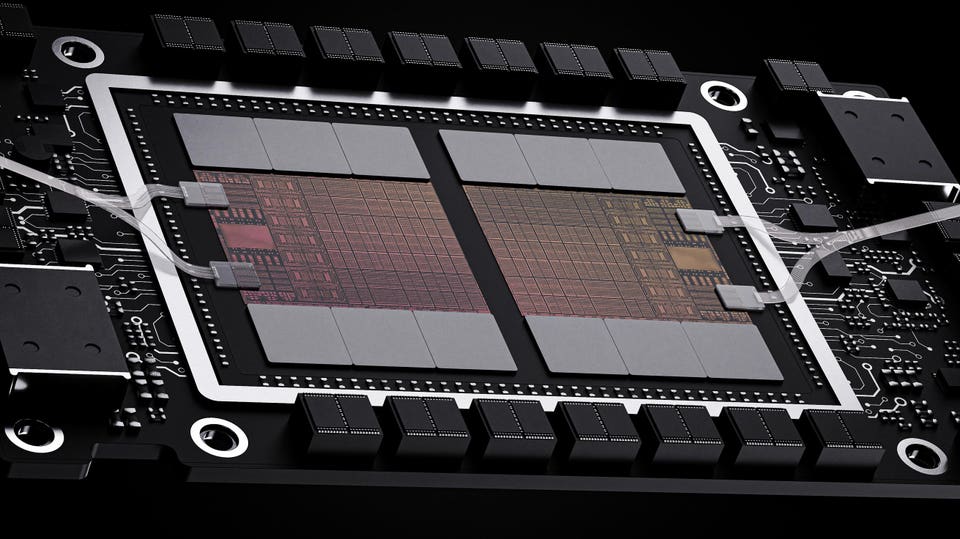
計算は通常、電子回路の上で行われる――トランジスタ、スイッチ、メモリを通じてデジタルビットを移動させる。それは高効率であり、スケーラビリティ、サイズ、消費電力、速度の各面でムーアの法則に忠実に追従してきた。
問題は、データセンターが膨大な量の光データを処理しなければならない点にある。従来、これらのデータはまず電ドメインへ変換(光子がビットになる)されなければならず、その後異なるチャネルにデータを切り替え、オンライン検索やAIデータストリームの学習・トレーニングに対する計算を実行していた。光から電に戻り、再び光への変換(OEO)は損失が極めて大きく、データセンターのエネルギー消費と水使用量を大幅に押し上げる――金銭的、政治的な観点、さらには企業のイメージに至るまで、決して軽視できないコストが生じる。光路交換(OCS)はシリコンフォトニクスとメタマテリアルの活用により光ビームの切り替えを進めており、高額なOEO変換の影響低減において大きな進歩を遂げている。しかし、計算自体を支援する技術はまだ必要だった。これこそがNeurophosが取り組んでいる課題であり、同社はシリコンフォトニクス回路とメタマテリアル技術を用い、光ドメイン内で計算を完結させている。
光演算そのものは新しい概念ではない。
その起源は1960年だ。研究者がレンズや光学フィルターを用いてフーリエ変換――信号や波を各周波数成分に分解する数学的操作――が可能であることを発見したのである。
1970年代:空間光変調器(SLM)がさらに進展し、プログラム可能な方法で光パターンを生成したり、焦点を変更したり、さらにはレーザービームを特定のモードで移動させることが可能となった。
1980~2000年:その後20年間で学術研究とイノベーションが多数生まれたが、商業化には至らなかった――主に電子計算の急激な進歩と、光学技術が実験室にとどまっていたことが理由だ。後にSLM技術はベクトル・行列乗算(VMM)の実装に応用され、これが重要な突破口となった。
2000~2025年:この25年間を通じて光学技術は成熟迎来了――光半導体、シリコンフォトニクス、メタマテリアル、光ファイバー、フリースペースオプティクスは、センシング、通信、材料加工、計算に応用された。超大型データセンターもこの期間に台頭し、それらは膨大な数の光学技術を使用し、Lumentum、Coherent、Corning、IPG Photonics など十億ドル規模の光学プレーヤーを生み出した。現在、データセンターが光学を必要とするのは、単にデータの伝送と交換のためだけでなく、「データに対して何らかの処理を行う」ためでもある――例えば計算が行えるようにするためだ。超大型データセンターの消費電力は100メガワットから1ギガワットに及ぶうち、約50%が計算に充てられている。光演算はエネルギー消費(およびそれに伴う冷却ニーズ)を大幅に削減できる。
Neurophosは光演算の実用化において最先端を走っている。同社はテキサス州オースティンに位置し、光演算の進展を加速させるため先頃1億1,000万米ドルの追加調達を実施した。本ラウンドはGates Frontierがリードし、MicrosoftのベンチャーキャピタルであるM12、Carbon Direct Capital、Aramco Ventures、Bosch Ventures、Tectonic Ventures、Space Capitalなどが参加投資した。これにより同社は2026年にチーム規模を約4倍に拡大できる見込みとなっている。NeurophosのCEO兼創業者であるPatrick Bowen博士は次のように述べている。「ムーアの法則は鈍化しつつあるが、AIは待っていてはくれない。我々のフォトニクス分野でのブレークスルーは新たなスケーリング次元を開き、膨大な並列処理を単一チップに収縮させる。この物理レベルでの飛躍は、スケールアウトする際にも効率的な運用と基礎演算速度が同時に向上することを意味し、従来のGPUが抱えるパワーウォールの制約から解放されるのだ。光演算が根本から変えるのは、特定の消費電力、スペース、予算の条件下で、どの程度のAI性能を提供できるかという点である。」
まず基本的な事項を確認しよう。AI推論フェーズにおける計算は2種類に分けられる――「プリフィル(prefill)」と「デコード(decode)」である。プリフィルは大規模言語モデル(LLM)推論の第一工程であり、モデルが入力プロンプト全体を並列で読み取り分析する。一方、デコードはモデルが回答を出力する工程であり、この段階は非常に直列的となる。AI推論における演算負荷の大部分を占めるのがプリフィルである。LLMのトレーニングや膨大なデータセットを用いた学習でも演算負荷が発生するが、こちらは初期トレーニング時の短時間における高消費電力に留まり、トレーニング後のモデル更新自体の消費電力は遥かに低い。
図1では、古典的な光演算(電気系およびGPUベースのパス)とその課題、そしてNeurophosがOCU(光学計算ユニット)アーキテクチャによってこれをどのように解決するかを対比している。
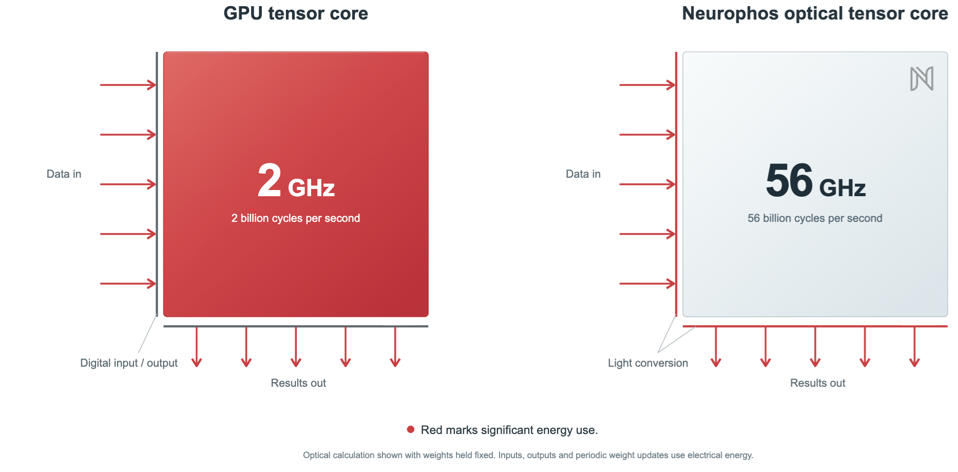
前述の通り、データセンター環境では消費電力の抑制が極めて重要だ。現在の計算は電気ドメインで実行されているが、Scale-Up および Scale-Across ラック内のデータ伝送の多くは既に光で行われている。電気ドメインのGPUチップで計算するには、まず光から電気へ変換してから計算を行い、その後転送のために電気から光へ戻す必要がある。金属導体における電子の移動には損失が生じる。加えて、GPUなどの電気素子は演算コア内部に多数のスイッチで覆われており、スイッチの安定待ち計算時間が消費されてしまう。Neurophosの光学コアイノベーションにおいては、スイッチが不要なため計算は光速で瞬時に完了する。同時に数百万回の計算を実現し、秒間560億回の演算を記録しており、これは同等サイズのGPUと比較して極めて高速である。速度以外にも、OCUの消費電力は顕著に低い――スイッチへの給電が不要であり、信号伝播損失も最小限だからだ。電気システムにおけるフローと消費電力の大部分は入出力端に集中し、エレクトロニック・オプティカル(E/O)およびオプティック・エレクトロニック(O/E)変換に充てられる。その結果、同一のチップ面積と消費電力条件下では、1つのOCUがGPUよりも約25倍多くの秒間演算数を達成可能となる。
現在、電子のように効率の良い光ストレージ技術は存在しない。そのため、計算を一時停止して中間結果を保持し、次の計算工程へ移行しながら数学演算を一歩ずつ離散的に進めていく必要がある。このため依然としてSRAMおよびDRAMの使用が必須となる。将来、光ストレージの問題が解決されれば、OCUの入出力端におけるOEO変換が不要になり、さらなる高速化に加え、消費電力・コスト・サイズの低減が見込まれる。
プリフィル演算は行列乗算を大量に含んでおり、LLMが高次元空間上でプロンプトと訓練済みエンジンの関連性を確立する必要があるためである。GPU上ではチップ面積の相当部分がこれらの計算専用に割り当てられている。Neurophosのチップでは、乗算は以下の3つの操作によって完了する。
1. 数据のコピー:光カプラを用いて、信号を一定比率で複数の経路へ分配する。これは光子回路に取り込み可能なパッシブ素子であり、入力される光子流を異なる光導波路に沿った多重流に分割し、干渉結合器、絶熱テーパー、波長感応型回折格子などで実現する。
2. 乗算:光ドメイン内で完了し、反射構造および透過構造を組み合わせて複数ビームの強度を合成する。実際の光学素子としては、干渉計や位相変調器が用いられる。
3. 加算:光マルチプレクサ(合波器)――複数の光信号を単一出力経路へ統合する素子を用いて行われる。各経路の光の振幅、波長、位相、または偏波特性などを合成可能だ。
光演算の主要な用途は行列・行列乗算である。光学において、一つの行列は光学変調器グリッド内に配置され、もう一方は入力ベクトル系列として供給され、ベクトル内の各数値は対応する光束の振幅としてエンコーディングされる。コピー処理では、各光束を約1,000本に分割し、変調器グリッドの一行上に拡散配置する。光学乗算は反射または透過により実行され、コピーされた各光束は変調器で反射し、反射光は入射光に変調器に格納された数値を乗じたものとなる。加算処理では、グリッドの各列から反射された光を単一的光検出器に集光し、それらの光を合成することで出力要素を生成する。変調器は数千数万の入力ベクトルが通過しても行列状態を維持するため、行列ロード時のエネルギーはこれらの全ベクトルに分散される――ここが光テンソルコアイノベーションがベクトル・行列ではなく行列・行列乗算向けに設計されている理由である。
これらの処理は光学チップ上(図1参照)で行われ、チップはシリコン、窒化珪素(SiN)、ホスファイドインジウム(InP)などの素材にエッチングされた微細な光導波路によって構成されている。光導波路はチップ内で光束を誘導する。レーザ光源と光検出器はOEO変換を実現するために集積されている。変調器は光の強度、位相、偏波、波長などの特性を変更して情報をエンコードおよび処理する。変調器に加え、光導波路には分波器、反射・透過面、合波器も集積されている。
NeurophosのAI推論チップは、調整可能な光学素子を備えたメタサーフェスアーキテクチャを採用している。これはAIインフラストラクチャの核心的な制約目標であり、超大型推論向けに十分な演算能力を製造・供給・冷却・展開することを目指す。Microsoftは深く関与し、投資家としても参加している。その他の商業的進展としては、超大型クラウドベンダーとも連携が進んでいる。同社は初のメタサーフェス配列に関する計算デモンストレーションを完了しており、信頼性と性能を改善したより多くのデバイスのファブレス生産を進めている。サプライチェーン側には、主要ファウンドリ、カスタムASIC設計会社、光学部品供給商、パッケージングパートナーが含まれる。
光演算と行列乗算における重要な課題の一つは、標準的な変調器の寸法がやや大きく、長さが約2mmである点だ。これは同一面積のチップに収められる変調器数が少なくなり、演算速度とエネルギー効率(演算数/ワット)が制限されることを意味する。1,000個の変調器からなる配列の場合、2,000回の変換(入力1,000、出力1,000)のみで100万回の乗算と100万回の加算を完了できるため、1回の変換あたり約1,000回の演算にエネルギーを分散できる。Neurophosの「秘訣」とは、メタマテリアルを活用して変調器の面積を現状の最先端技術と比較して約1万分の1にまで縮小し、カードデッキほどの基板ではなく爪ほどの大きさのチップに100万個の変調器を搭載できるようにした点にある。これにより1,000×1,000の配列を単一チップ上で実現可能となり、光演算が長らく謳ってきた効率性が現実のものとなった。
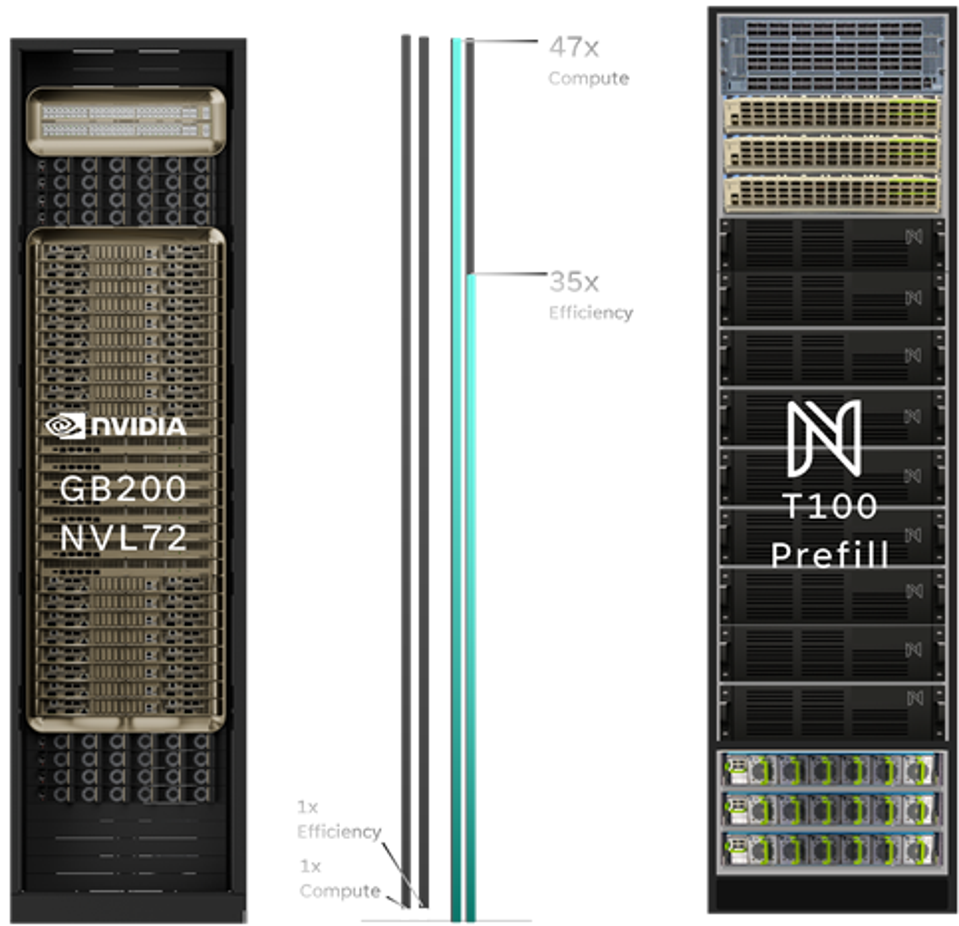
Neurophosの完全な光学テンソルコアイノベーションは3つのコンポーネントから構成される。第一に、シリコンフォトニクスチップが入力ベクトルを生成し、出力ベクトルを受信する。これは56GHzのクロックで動作し、このクロックが演算速度を決定する。標準的な大規模変調器を使用するが、必要な数は100万個ではなく約1,000個であるため、小型化よりも高速化を優先している。第二に、メタサーフェスチップが重み行列を保持する。行列は多数の入力ベクトルを通じて変化しないため、これらの変調器は高速化よりも小型化を重視している。最後に、光学投射システムが両チップを接続する。これはシリコンフォトニクスチップ上の各入力光束をコピーしてメタサーフェスの一行に拡散配置し、さらに各列からの反射光束をシリコンフォトニクスチップ上の単一光検出器に集光して合算を完了する。ここにHBMと制御・記憶用のデジタルチップを搭載・パッケージングすれば、この光学テンソルコアイノベーションはGPUの差し替え可能な代替製品となる。フォトマスクサイズ当たりのダイ面積で評価した場合、現在の最先端GPUと比較して約50倍高速であり、基礎的なエネルギー効率も約35倍高い。
光学技術はすでにデータセンターの重要な構成要素である。今後5年間では、Scale-Upラックにおいて光路交換(OCS)が電気グループ交換(EPS)に取って代わるにつれて、光学技術の占有率はさらに上昇する見通しだ。OCS市場は今後5年で約5倍に成長し、年間110億ドル規模になると予測されている。もう一つの大型市場は計算分野であり、OCUはGPUなどの電気系パスと比較して、演算速度、チップ面積、消費電力の観点から顕著な改善を示している。Yole Groupによると、初のOCUは2028年の導入が予想され、2034年までに市場規模は約27億ドル(約100万台分)に達すると見込まれる。ただし、潜在的な市場規模はこれだけには留まらない――OCUがデータセンター内のGPU演算市場を順次置き換えていくに従って、当該市場は今や年間約1兆米ドルと見積もられている。
TechFlow公式コミュニティへようこそ
Telegram購読グループ:https://t.me/TechFlowDaily
Twitter公式アカウント:https://x.com/TechFlowPost
Twitter英語アカウント:https://x.com/BlockFlow_News
 Forbes
















