


AIがインターネット経済を殺している:ボットトラフィックが人間を超えたとき、コンテンツ課金モデルは再始動を余儀なくされる
著者:Shoal Research
翻訳:TechFlow
TechFlow解説:Cloudflareの最新データによると、AIボットトラフィックがネット全体のHTMLリクエストの60%を占め、初めて人間を上回った。これは、オープンなインターネットを20年間支えてきた「コンテンツ対トラフィック」モデルが崩壊しつつあり、「リクエスト課金」型の新しいインフラが準備できていないことを意味する。コンテンツクリエイター、広告主、そして検索流入に依存するすべての関係者にとって、これはアルゴリズムの更新よりも根源的な存続の問題だ。
2026年3月19日、CloudflareのCEOであるMatthew Princeは生成系AIの発展により、2027年にボットトラフィックが人間トラフィックを上回ると予測していた。Cloudflareは世界最大規模のCDNであり、インターネットの約20%をカバーしている。わずか数ヶ月後、Princeはエージェント型トラフィックの成長が極めて速く、既にボットが人間を超えたと発表した。Cloudflareネットワーク上のHTMLコンテンツに対するHTTPリクエストのうち、ボットが約60%、人間が38.2%となった。自動化システムによって生成されるHTMLページリクエストの割合が人間を超え、その中でAIエージェントの比率が上昇するにつれ、インターネットのビジネスモデルは崩壊しつつある。

オープンインターネットを養ってきた取引
World Wide Webは前例のないグローバルな情報の民主化を実現し、この使命を支えたのは、シンプルで直接的な「コンテンツ対トラフィック」の物々交換メカニズムだった。出版者はWeb上にコンテンツを公開し、検索エンジンはユーザーの検索時にそれらのウェブサイトへ読者を誘導する。出版者は情報や娯楽を「コンテンツ」として提供し、検索エンジンは読者を関連ページへと案内し、広告主はユーザーが誘導されたページ上でターゲット広告を表示することでその訪問を変換する。この同期動作する閉ループは、数十億ドル規模の広告基盤を築き、有料ウォールのないオープンなインターネットを支えてきた。
この取引は無数の無料かつ公開可能な情報を養う一方で、配布の権力を検索エンジンと広告プラットフォームに集中させた。行動広告、SEO最適化されたコンテンツの量産、トラフィック追跡型のコンテンツ生産が賞賛され、出版者は推薦トラフィックと注目のトラフィックに深く依存することになった。AIはこの脆い取引における「推薦」の環節を侵食しており、代替案はまだ準備が整っていない。
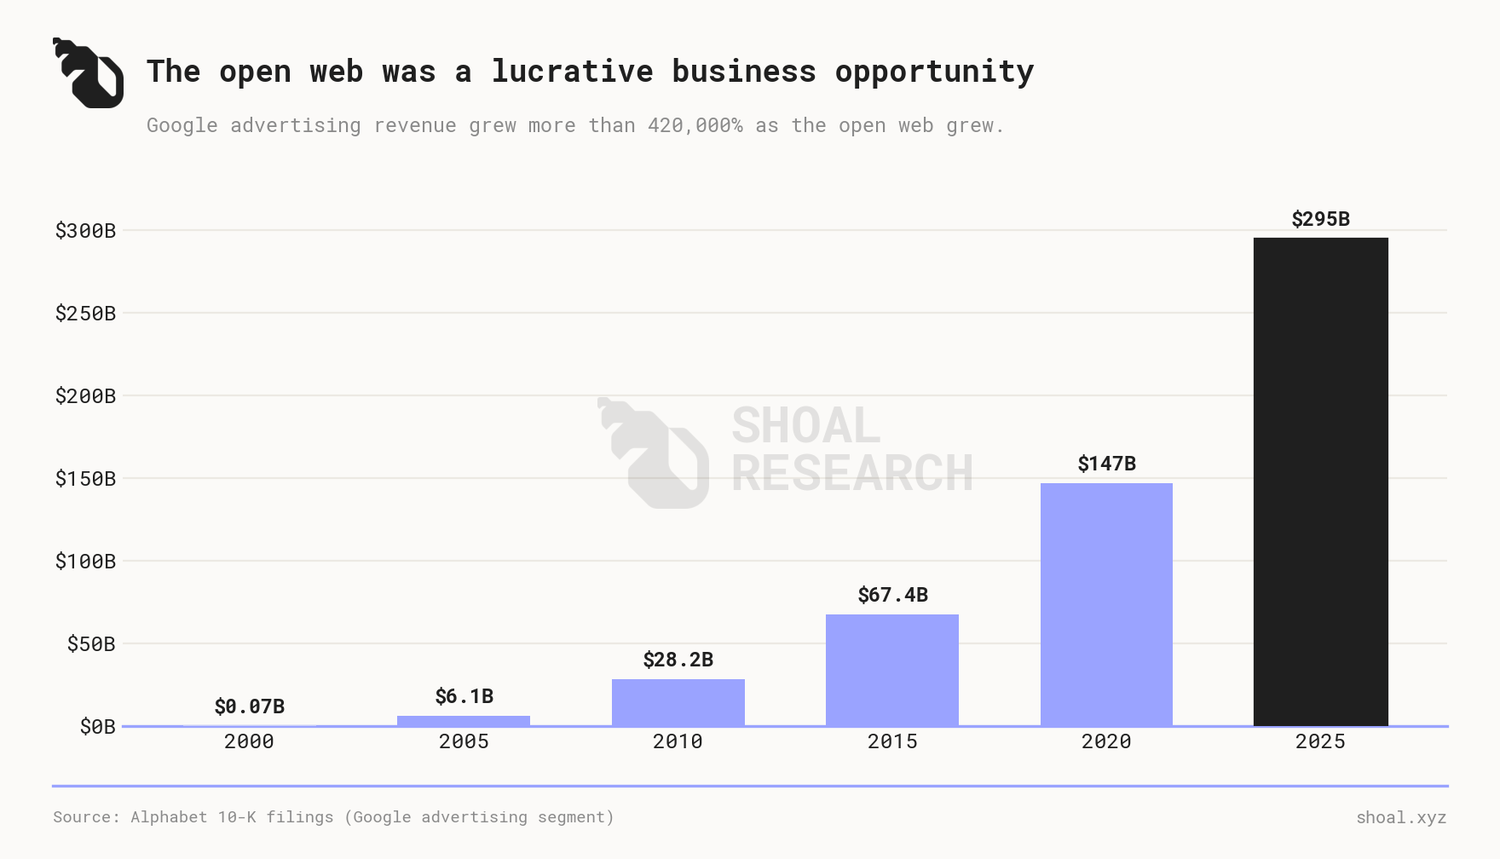
Googleの広告収入は2001年の6,690万米ドル(同社が広告収入を初めて完全に開示した年)から2025年には2,947億米ドルへと増大し、約4,400倍の成長を示した。
しかし近年、AIチャットボットアプリの爆発的成長は、Web情報の発見において全く新たなパラダイムを導入した。設計上、これらのAIアプリはユーザーの利便性を優先し、オーディエンスをチャット画面内部に留めるようになっている。ユーザーには便利だが、出版者にとっては特に致命的だ。検索エンジンは読者をコンテンツソースのウェブサイトへ導く一方、AIアプリは情報を圧縮・要約し、ユーザーの質問に対する最終回答の一部として直接提示する。出版者はウェブサイト経由での収益化が難しくなりつつあり、ユーザーとの直接的な関係性が失われ、人間の訪問も減少している。
台頭しつつある解決策は、インターネット上のコンテンツと検索に対して全く新しい「リクエスト課金」型支払いインフラを導入することだ。本稿では、AIがどのように「インターネットを崩壊させるか」、このソリューションの二つの異なるアプローチ、そしてこの新興のリクエスト課金型ネットワークが現在どのような状態にあるかを探讨する。
AIスクレイピングとバーターモデルの終焉
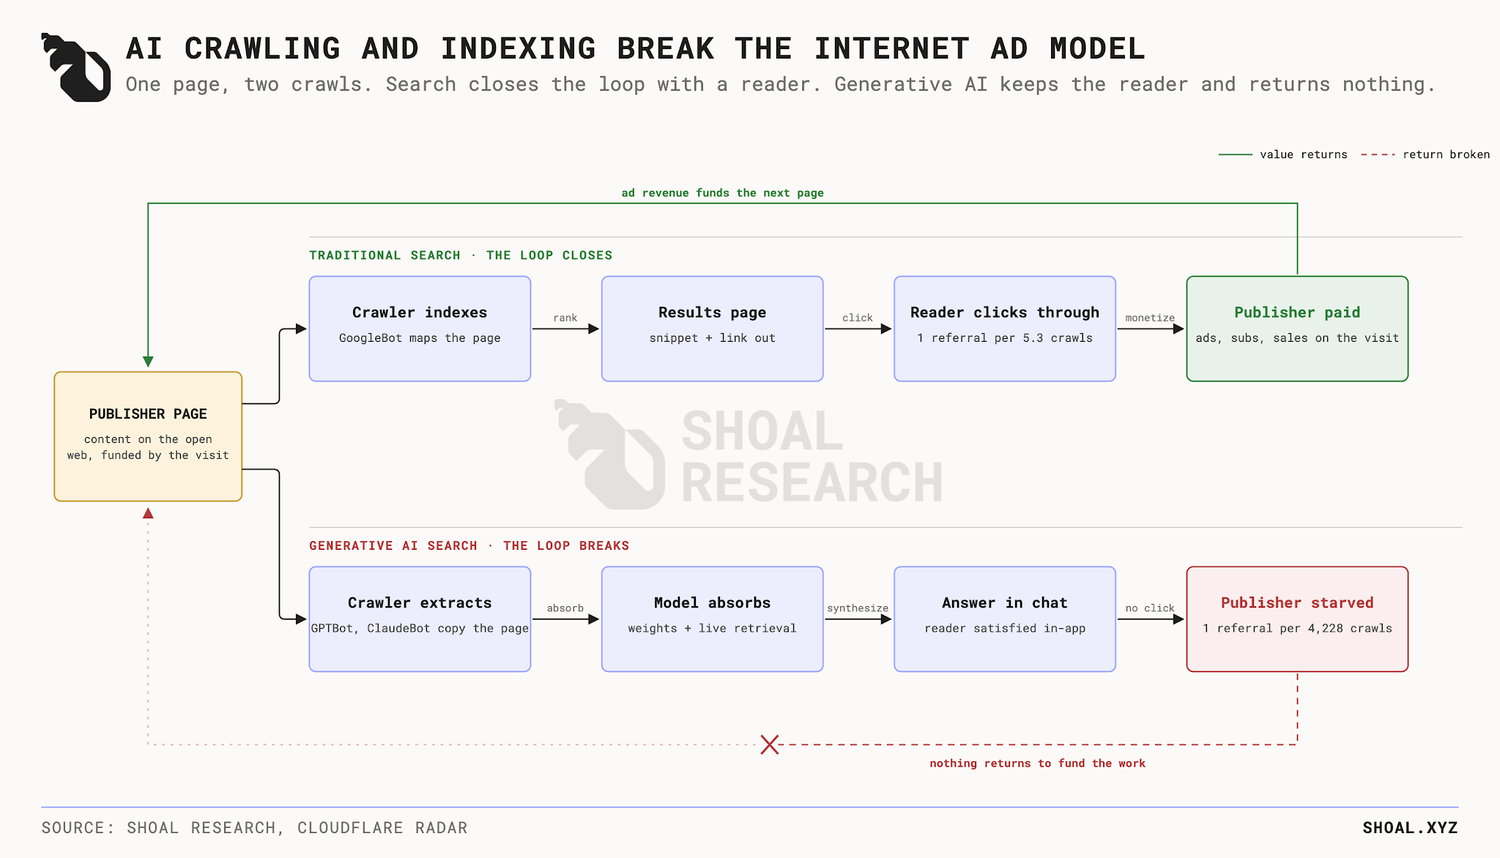
検索エンジンはクローラー(ウェブページの索引を構築するための自動化プログラム)を使用して、Webの「地図」を作成している。従来のコンテンツ対トラフィックモデル下では、出版者はこれらのクローラーがテキストを無料で複製することを許可していた。なぜなら、検索エンジンは人間の読者を彼らのウェブサイトへ誘導することで見返りを与えていたからだ。このアクセスを管理するために業界はrobots.txtと呼ばれるテキストファイルに依存しており、これは暗号化されていない、自主遵守による名誉システムのルールセットだ。robots.txtが長期間平稳に機能してきた理由は、robots.txtを無視することは出版者コンテンツへのアクセス権を喪失することを意味し、それが検索エンジンによるネットワークのインデックス品質に直接的なダメージを与えるためだ。
生成系AIアプリはクローラーをインデックスツールから主動消費者へと変容させ、Webのコンテンツ対トラフィック取引を瓦解させた。これは訓練とリアルタイム检索の二つの环节で最も顕著に現れる。訓練段階では、GPTやClaudeのような大規模言語モデルがOpen Webから書籍、記事、コード、芸術作品などを含む膨大なコーパスを取得して学習する。モデルはこれら全ての人類の知識上で訓練を終了し、それをユーザーにフィードバックする際、出典リンクは一切付与せず、クリエイターへの費用も支払わない。リアルタイム检索段階では、モデルはユーザーの質問に応答する際にその瞬間に実時間Webを索引付けし、関連段落を取得して再フォーマットする。モデルは生ページをリーダーに渡すのではなく、情報を言い換え、ユーザーの質問を完全に回答する全新的なinline応答として提供します。クローラーは一度だけページのために索引を作成すればよく、モデルはその発見した内容を数百万人のリーダーに提供できるが、その内の誰もがオリジナルソースへ引き戻されることはない。
影響
抽出メカニズムを行動データ、連邦訴訟、そして芸術的搾取と併せて検討すると、オープンのWebの基礎構造が構造的崩壊を経ていることが明らかであり、その影響は複数の相互関連した領域で既に顕在化している。
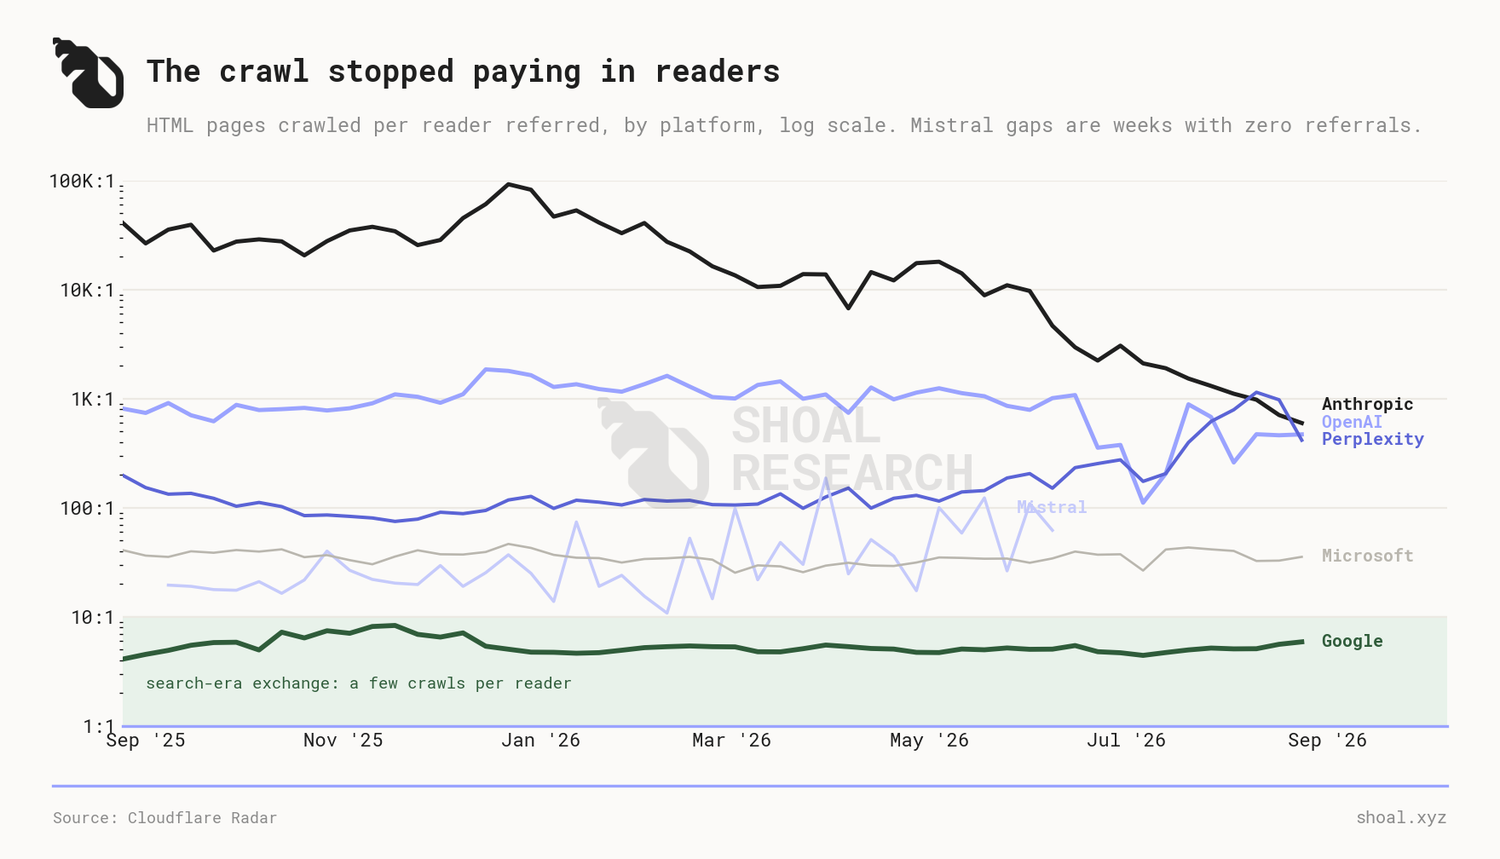
AIスクレイピングが行動に与える影響は「スクレイピング対導流比率」で測定できる。つまり、スクレイピングされたページ数と実際に持ち帰られたユーザー数の比率である。Cloudflareのデータによると、過去六ヶ月だけで、訓練類(43.9%)および訓練加検索类(41.5%)のクローラーが、Cloudflareネットワークで観測された識別済みAIクローラーリクエストの85%以上を占めた。Googlebotはまだ一人の訪問客を持ち戻るために約五ページをスクレイピングする必要がある。過去一年間はその比率が5.3ページであり、これは歴史的な交換レベルに近いが、主要なAIプラットフォームそれぞれが一から三個桁高い値を示している。過去一年間で、AnthropicのClaudeBotは源サイトへ一人の訪問客を持ち戻るために平均4,200ページ、Mistralは884ページ、OpenAIは731ページ、Perplexityは147ページをスクレイピングした。Cloudflareは確かに指出するが、ネイティブアプリからの導流には導流ヘッダー情報が伴わないため、これらの比率は不均衡度を過大評価している可能性がある。Pew Research Centerの研究によると、AIサマリーが検索クエリをインターセプトすると、人間のクリック率は15%から8%へと低下し、サマリーからの直接的なクリック帰因は1%へと低下し、ユーザーは26%の場合セッションを完全に放棄する。
AIスクレイピングは法的訴訟も引き起こした。Bartz対Anthropic事件で、William Alsup裁判官は合法的に入手した書籍を用いての訓練が変換性を持つためフェアユースに該当し、すなわち書籍そのものではなく新しいものを創造するため、著作権侵害ではないと裁定した。一方、Anthropicがダウンロードした海賊版図書庫に関する訴えについては審理段階に入った。後にAnthropicはこれを15億米ドルで私下和解し、約50万点の作品に対して作品あたり約3,000米ドルの計算となった。この結果は広くAnthropicの勝利として解釈されている。なぜなら訓練がフェアユースに該当する裁定が維持され、和解により本来はるかに高額な法定賠償の可能性を排除したからだ。案件が和解されたことで、海賊版コンテンツを用いた訓練の実質的なコストを確定させた裁判所は存在しない。同時に、『ニューヨーク・タイムズ』対OpenAIおよびMicrosoft事件は進行中で、OpenAIにChatGPTの2,000万件の会話ログの提出を義務付け、モデルがいかに大幅に記事をコピーして有料サブスクリプションを代替しているかの調査一部となっている。
これらの事件は、AIスクレイピングの無計量スクレイピングのコストが、特に独立クリエイターやビジュアルアーティストにのしかかっていることを浮き彫りにした。OpenAIが2025年初頭にジブリスタイルのレンダリング能力を発表した時、まさに既存の著作権保護がどれほど脆弱かが露呈した。アメリカ法は作品の具体的な表現を保護するものであり、全体としてのスタイルを保護するものではないため、AIモデルは数十年にわたる人類の労働によって築かれた芸術的美学を体系的に克隆でき、クリエイターの言及や補償を必要としない。OpenAIの方針では宮崎駿などの存命アーティストの名をプロンプトに使用することは禁止しているものの、「ジブリ」という名前の使用は完全に許容している。『トトロ』のような特定のキャラクターは保護されているが、一般的なジブリスタイルは保護されておらず、モデルがそのような画像を生成できるのは該当スタジオの映画を訓練データに使ったからに過ぎないにもかかわらず、アーティストが法的根拠を持つことはほぼ不可能だ。リクエスト課金インフラは上記のすべての被害を解消するわけではない。未来のアクセスに対して計量と補償を行うことは可能だが、訓練にすでに用いられた素材を遡及補償したり、モデルがすでに習得したスタイルの再現を防ぐことはできない。これらの被害に対処するには、別のライセンス、著作権、そして執行救済措置が必要だ。
要するに、コンテンツ対トラフィック取引の崩壊に対する二つの主な対応(訴訟と私的ライセンス契約)はいずれも拡張可能なビジネスモデルではなく、一時的な応急処置に過ぎない。これまでのところ、訴訟は過去のスクレイピングに価格を決定したが、持続的かつ将来的なクロールには一切手が触れておらず、私的二辺ライセンス契約は大メディアグループが自らのアーカイブアクセス権をAIラボに直接販売する道を開いた(例えばOpenAIとNewsCorp間の2.5億米ドルの契約、またはRedditとの年間6,000万米ドルという報告があるGoogleとの取引)。高額ではあるが、一つの市場調査により、これらの私的取引が多く是被授权者が予想するAI収入の百分の一未満であることが判明した。しかし、このような契約を交渉するには多大な資金力と法的リソースが必要であり、それはインターネットの独立ロングテール(数百万名の独立コンテンツクリエイター)が依然として大規模にAIスクレイピングに対応できないことを意味する。
そこで状況が明確になった。robots.txtに依存する非暗号化信用体系と、オープンなインターネットを支えてきた三十年のコンテンツ対トラフィック取引は、経済的にデータの消費が導流トラフィックより優先され、クローラーが第一級消費者となるインターネットには耐えられない。過去、出版者は100%のコンテンツ生産コストを引き受けることに喜んで同意していた。なぜなら彼らは100%の消費者トラフィックと注目を獲得できたからだ。生成系AIはコンテンツを全面的に消費しながら几乎归因を提供せず、実際には人間Webトラフィックの源泉を断ち切り、出版者が広告収入やサブスクリプション収入を生み出すために不可欠なトラフィックなのだ。結果として出版者は機械によるスクレイピングのために高額のホスティング請求書を払い続けながら、何のトラフィックも得られない。この圧迫は両方向から同時に発生している。一人のロボットへの帯域幅と計算コストは一人の読者へのものと同等だが、ロボットは去っても広告を見たり、サブスクリプションを開始したりしない。スクレイピング対導流比率が数百や数千に達する状況下では、出版者は収益化可能なアクセス一つあたりに数千回のリクエストに対する費用を負担しなければならない。出版者は単にロボットのテキストの無料複製のためにサーバー費用を支払う余裕がないため、インターネットはクリエイターが彼らの産出に対して報酬を得られるようにする方法を新たに見出す必要がある。人々がWebサイトを訪問する代わりにAIサマリーを読むのであれば、出版者は人間だけの注目で稼ぐことはできなくなる。したがって、収益化のタイミングはAIロボットが実際にデータをスクレイピングする那一刻となり、次に論理的に進むべきステップは、新たなネットワークネイティブなリクエスト課金型支払いインフラを導入することだ。
リクエスト課金型ネットワーク
リクエスト課金モードをインターネット全体に拡大するには、コンテンツとサーバーアクセスを効率的に計量する方法が必要だ。こうした活動のますます大きな部分がAIクローラーによって駆動されているとはいえ、このフレームワークはデータソースや自動化APIなど、あらゆる非人間インタラクションに適応する。簡潔に言えば、有料コンテンツにアクセスするには、ソフトウェアが他のソフトウェアに対してプログラム方式で支払いを行う必要があり、このプロセスは正式にマシンペイメント(機械間決済)と呼ばれる。
大規模にマシンペイメントをサポートするために、インフラ企業はネットワークルーティング層に自動課金ゲートを構築し、リクエストが発生したミリ秒単位でロボットに課金する。ただし、実行方式は主に二つの全く異なるアプローチに分かれる。一つはクローズドマーケットモードで、クローラーにアカウント登録とユニークなデジタルキーの取得を求め、中間ルーティングプロキシを介してウェブサイトへのアクセスを許可する方法。もう一つはオープンプロトコルモードで、標準化された公開ソフトウェアルール、機械可読ヘッダーの使用を中心に設計され、より広範なデジタルレール上での決済連携をサポートするように作られている。
クローズドマーケット
ガードドマーケット(門控市場)モードは、Webページコンテンツを企業ミドルウェアが管理する私有資産とみなす。このフレームワーク下では、マシンペイメントの前にID認証とアクセス許可が完了しなければならない。パブリッシャーは自身のネットワークを設定し、入力されるAIクローラーをヒューマン向け公開ウェブサイトからマーケットプロバイダーが管理する専用のセカンダリURLへRedirectする。このゲートウェイにおいて、プラットフォームはデータベースに対してクローラーの認証資格を確認し、パブリッシャーが設定したカスタムアクセスルールを評価し、使用状況を記録し、ページを機械可読テキストへフォーマットする。金融取引はインターネットプロトコル層の外側で行われる。ロボットがリクエストを開始すると、マーケットはその利用を記録し、AI企業が事前にチャージしたクレジット残高から差し引く。決済はStripe Connectなどのマーチャントプラットフォームを通じて法定通貨で定期的に行われ、毎回のリクエストでクレジットカードを清算すると手数料の方がリクエスト自体の価値を上回ってしまうからである。AIクローラーとパブリッシャー源站サーバーの間にミドルウェアを直接設置することで、セキュリティを最大化し、サーバーを激进トラフィックから保護し、検証済みの企業パートナーのみが入場できるようになる。しかし、このフレームワークが大規模に実装されると、オープンなネットワークがライセンス制ショップで構成されるネットワークに変貌し、人間ユーザーの体験をさらに悪化させる可能性がある。
初期のネットワーク向けプログラム化リクエスト課金型支払いインフラはずっとガードドマーケット中心であり、其中最も著名なのがTollBitと、Cloudflareリクエスト課金の第1世代版だ。TollBitはAIエージェントのネットワークトラフィックを管理・監視し、収益化するプラットフォームである。導入するには、パブリッシャーは専用のサブドメイン(例:https://tollbit.thedailydispatching.com/)を設定し、AIクローラーがメインサイトを訪問しようとした時点でサーバーが自動的にそのクローラーをTollBitのサブドメインへRedirectする。クローラーは支払いが完了してからアクセス権を獲得する。TollBitは当該AI企業が登録済みの課金アカウントを保有しているか確認し、ロボットがリクエストしたページ数を記録し、クリーンなテキスト形式でデータを配信し、同時に米ドル建てで決済を処理する。これにはAPIキーが必要であるため、現在コンテンツコストを発見するのはセルフサービスではない。AI開発者はまずTollBitに登録する必要がある。
2025年7月1日、Cloudflareは最初のリクエスト課金モデルをリリースした。CloudflareはDNSとCDNレイヤーで稼働しているため、トラフィックが実際のコンテンツパブリッシャーの物理源站サーバーに到達する前に処理を行うことができる。リクエスト課金第1世代において、CloudflareはエンドポイントレベルのWebアプリケーションファイアウォール(WAF)を統合し、デフォルトでネットワーク上で知られているAIクローラーを自動的に検出してブロックする。AIクローラーがリクエスト課金で保護されたドメインへのアクセスを要求する場合、Cloudflareはリクエストが発行者Webページに到達する前にブロックし、サイトオーナーが自身のコンテンツを収益化することを選択した場合、決済を仲介する。
門控市場の課題
TollBitは開発者APIの設定、専有キー、および従来の銀行チャンネルに依存して決済を行う。Stripeなどのマーチャントネットワークを介してリクエスト課金型トランザクションをルーティングすると、固定的なトランザクション処理手数料(通常は30セントプラス総額の一定割合)が含まれるため、一回限りの1米セント未満のリクエスト課金型リクエストを経済的に実行不可能にする。このコスト障壁を回避するために、ヒューマン開発者は手動でガードドマーケットミドルウェアにアカウント登録し、ユニークなAPIキーを生成し、クレジットカードや銀行送金で残高を事前にチャージし、プラットフォームはそこから段階的に減額していく。そのため、エージェントその他の自律ソフトウェアは現時点でオンデマンドでデータを発見・購入することができない。むしろ、ヒューマンマネージャーが手動で商業アカウントを設立し、各独立プロバイダー間で絶えず変動する残高を監視し、安全鍵を調整する必要がある。
人間の介入を維持することが多くのAI中心ワークフローにおいて不可欠な部分ではあるものの、ガードドマーケットモードを使用してWebコンテンツへのアクセスを大規模に管理することは、予測可能で線形なネットワークトラフィックパターンを前提としており、これは現代ソフトウェアの運用現実と直接衝突する。AIエージェントとクローラーは推論ループを使用して、ユーザーが与えたプロンプトに応じてナビゲーションパスを動的に選択するため、タスクに必要な正確なデータを含んだ見慣れないドメインに遭遇することが多い。タスク途中で中断して人工介入を求めるのは、迅速に実行ボトルネックを引き起こし、UXを破壊する。固定料金のサブスクリプションもここでは最高効率のソリューションではない。AIエージェントは指示を受け取次第随時実行され、これは往々にして予測不能な集中バーストとして現れる(例えば、誰かが3日間研究密集型のプロジェクトを行った後、2週間休憩するなど)。
事前資金デポジットと、保護されたコンテンツおよびデータへのアクセスに必要なカスタムソフトウェア統合の間で、ガードドマーケットは本質的に高度にライセンス制なシステムである。一方で、Webパブリッシャーは成熟したテクノロジー企業からの制御され、検証されたトラフィックを受け取ることができる。他方で、複数独立プラットフォームでの事前チャージアカウント管理に伴う行政・財務負担は匿名でないアクセスを制限し、独立開発者の自然発生的なクロールを妨げ、大規模企業トラフィックを持たない中小パブリッシャーの収益化機会を減少させる。相比之下、直接的なマシンツーマシン金融ハンドシェイクは、パブリッシャーがクローラーが要求するテキストとデータにマイクロフィーを追加することを可能にする。この設計思想がオープンプロトコルモードの基盤を成している。
開放的代替案:x402とMPP
オープンプロトコルは、公開かつ標準化された通信ルールの上に構築されたネットワークアーキテクチャである。現代Webの大部分はHTTP、SMTP、TCP/IPなどのオープンプロトコルに基づいており、今日でも使用されている。近年、HTTP 402ステータスコード(三十年以上保持されていたが活用されてこなかった)は、ブロックチェーンレールを使用するオープンプロトコル上でマシンペイメントをサポートするためのコアなWebネイティブインフラ要素となっている。
Bitcoin決済のためのHTTP 402実験は2015年にまでさかのぼり、パイオニアプロジェクトには21co Bitcoin ComputerとLightning NetworkのL402が含まれる。2025年5月、x402プロトコルは初めてステーブルコインをHTTP 402フローへ導入し、StripeとTempoの共同マシンペイメントプロトコル(MPP)などの取り組みはステーブルコインに加えてBitcoinやクレジットカード決済もサポートしている。クレジットカードオプションはマイクロペイメントではなくマクロトランザクション向けに設計されており、固定的な清算手数料が1米セント未満のリクエストを飲み干してしまうからである。ステーブルコインが依然としてリクエスト課金型プライシングを実行可能なレールである。
x402は支払い指示をデータ交換コードに直接埋め込み、第三者のアカウント登録や専有清算所を不要とする。AIクローラーがWebページを要求すると、ホストサーバーは接続メタデータ中に機械可読の応答(ペイメントヘッダー)を直接埋め込む。このヘッダーは、リクエストごとの正確な価格、指定されたペイメントネットワーク、および受信側のデジタルBillアドレスを提供する。
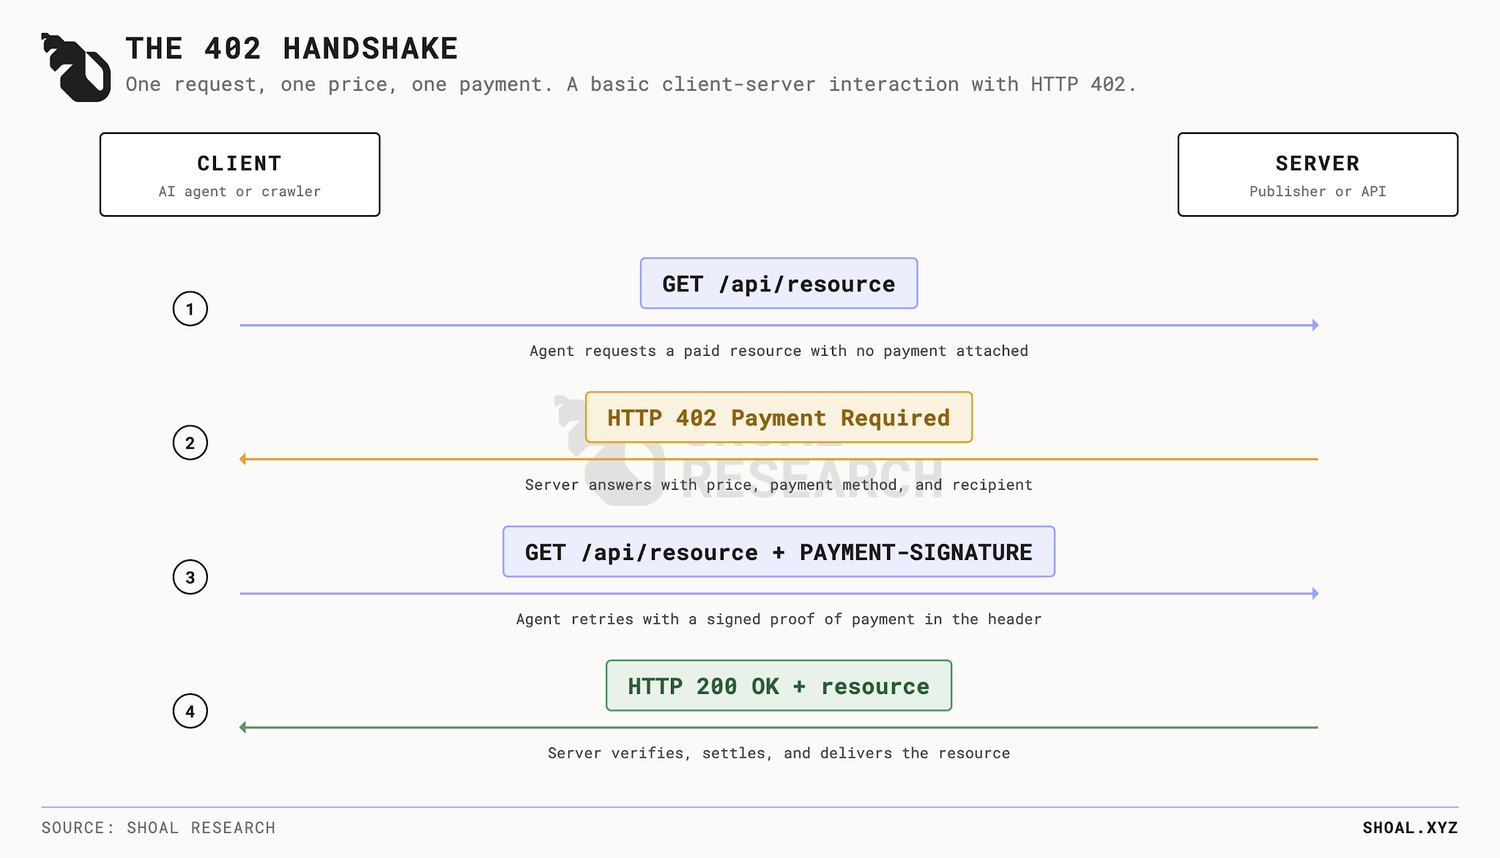
ブロックチェーンはマシンペイメントにおいて日益突出した役割を果たしており、因为它们提供了一个不可篡改、可编程的金融层,其原生速度和自动化水平与软件逻辑一致。ステーブルコインなどの暗号資産は、AIエージェントと同じネットワークネイティブインフラ上で稼働し、シンプルなAPIエンドポイントと暗号署名によって統合可能なソフトウェアコードの形態を取っているため、AIエージェントやクローラーと構造的に密接に隣接している。ブロックチェーンレールを使用して決済を行う場合のコストと手数料は依然として显著に低く、主要な高スループットチェーンでは通常1回あたりの送金で数セント以下であり、クレジットカードやフィンテック企業(Wiseのようにこのギャップを積極的に縮小しつつある企業が増えているとはいえ)よりも遥かに安い。
ブロックチェーンレールは设计上、各決済に対して暗号化的領収証と検証を提供する。リクエスト課金サイクルごとに、バイヤーのデジタル署名、要求されたURL、正確なタイムスタンプを含む永久保存された領収証が付与される。これらの指示がパブリックチェーン上に保存されているため、どの自動化エージェントも incoming メタデータを解析し、互換性のある資産(ステーブルコインなど)を使用してマイクロペイメントを実行し、単一の継続的HTTPハンドシェイクでコンテンツをダウンロードすることができる。伝統的な銀行レールの決済は清算所が商業銀行の台帳間で貸借を照合する必要があり、通常数日を要するが、ブロックチェーン決済はネットワークノードがデジタル署名を検証しグローバルチェーンの状態を更新した後、即座に完了する。前述の通り、主要チェーンでは通常数秒で完了する。最も重要なのは、オープンプロトコルアプローチがWebデータアクセスを標準化し、任意規模のパブリッシャーが自身の資産を収益化できるようにし、資金豊富な自動化アカウントを持つ開発者が事前の行政许可なしにクロール可能にするということだ。
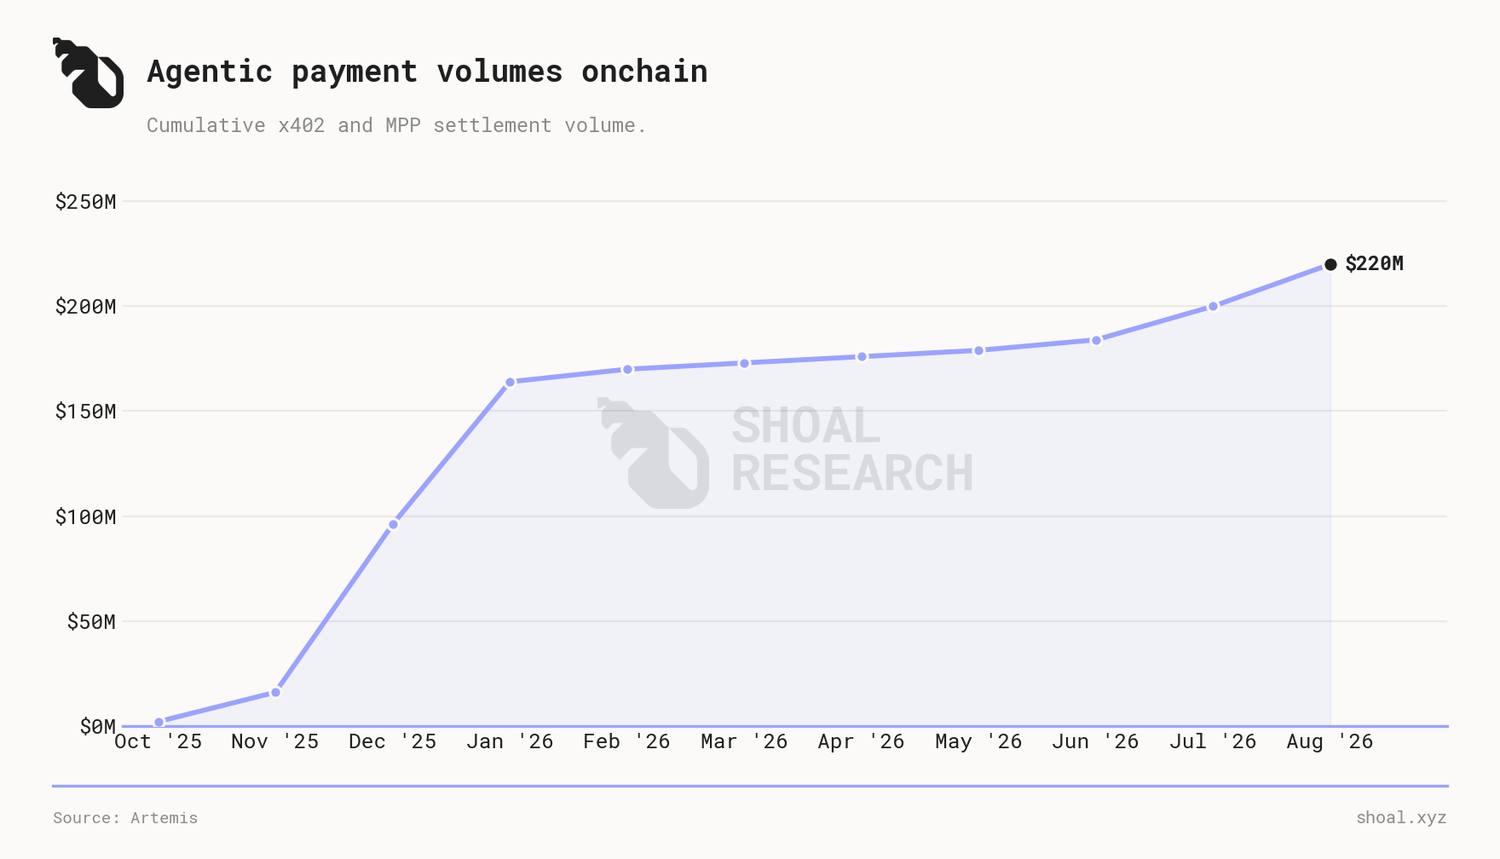
2026年6月15日、Amazon Web Services (AWS) はx402プロトコルをCloudFrontおよびWeb Application Firewallに直接統合した。この構成により、インターネットの約四分の一が、既存のクラウドコンソールから自動化エージェント課金を直接アクティベートし、有料ロボットにコンテンツを提供できるようになる。Cloudflareも遅れず追随し、そのPay-Per-Crawl V1はCloudflareをStripeを通じて決済を処理する記録マーチャントとして要求していたが、新しいCloudflare Monetization Gatewayは決済环节中からCloudflareを完全に除外し、決済はPeer-to-Peer方式で売り手のウォレットへ直接ルーティングされる。
クローズドマーケットとオープンプロトコルの主な違いは、Webコンテンツへのアクセス権を購入できる主体である。クローズドマーケットモードでは、アクセスはキュレーションされたホワイトリストに限定される。AIロボットは親会社がマニュアルで企業契約に署名し、ミドルウェアプラットフォームの背景審査を通過してからでなければコンテンツを購入できない。オープンプロトコルモードでは、アクセスは完全自動且つ制限なく、Internet上の任意のソフトウェアプログラムが即時にデータを購入・ダウンロードでき、その自動課金アカウントが要求されたマイクロ費をその場で決済できればよい。これらの二つのシステムがインターネットルーティングネットワーク中で普及するにつれ、パブリッシャーは二つの異なるインフラオプションの間で選択を迫られることになる。クローズドマーケットモードは厳格なセキュリティコンプライアンス、法的賠償、キュレーション企業パートナーシップを最優先するエンタープライズ組織に役立つ。対照的に、オープンプロトコルモードは摩擦のないマイクロトランザクションを必要とする自動化ワークフローに役立ち、多様な独立開発者とパブリッシャーのエコシステムが行政障壁なしにデータ.programmatic交換できるようにする。
今日のAIクローラーが実際に直面している状況
リクエスト課金型ネットワークの実質的なカバー範囲を測定するために、Shoal Researchは2026年8月19日、AIクローラー(GPTBot)として主要パブリッシャーおよびコンシューマーサイトの108社をプローブした。対象サンプルはその後108ドメインから500ドメインへと拡張された。以下の結果は当初の8月実施分を記述する。各リクエストに対して、ステータスコード、リダイレクトチェーン、レスポンスヘッダー、チャレンジボディを記録し、SHA-256ハッシュを計算して収集実行中のデータ整合性を確保した。エンドポイントのHTTP 402応答がPayment-Required / X-Payment-Requiredヘッダーの有効なx402 JSONチャレンジペイロード内で解析可能な決済パラメータを返す場合、该エンドポイントはx402ペイ可能またはエージェントペイ可能与分类。
108社のパブリッシャー中、Webは三つの主要な姿勢に分かれた:
無料で提供(49.1%,n=53):53ドメインがHTTP 200 OKでメインページを公開提供し、 unrestricted アクセスを許可している。
境界封鎖(33.3%,n=36合計):31ドメインがHTTP 403 Forbiddenを返し、2つが認証を要求(HTTP 401)、2つがコンテンツネゴシエーションを拒否(HTTP 406)、1つが法的封鎖を返す(HTTP 451)。さらに3社は試行の末タイムアウトした。
HTTP 402を返す(14.8%,n=16):ちょうど16社のパブリッシャーがHTTP 402 Payment Requiredステータスコードを返した。
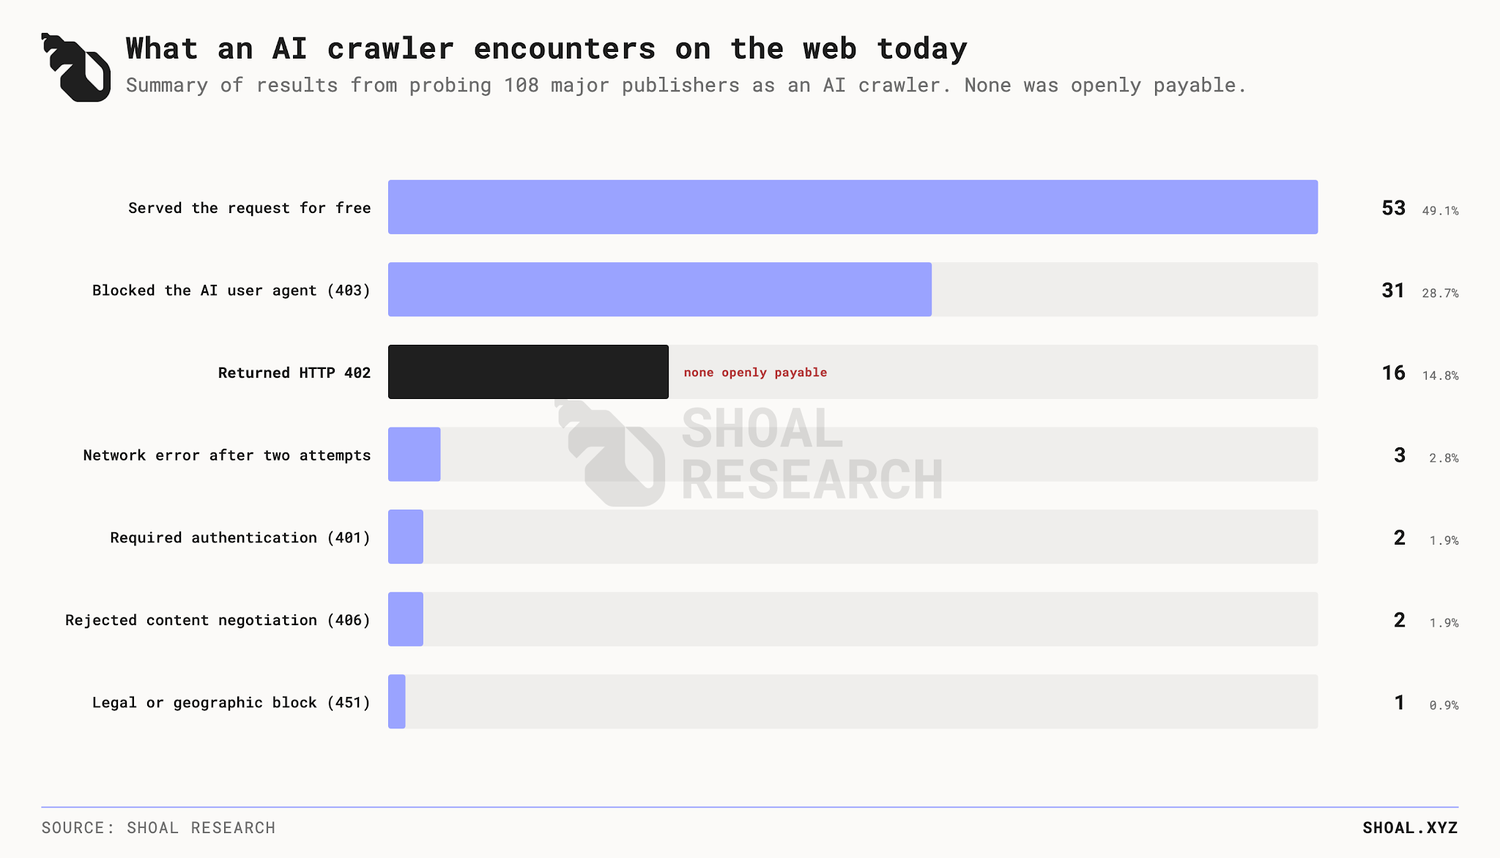
極めて重要なことには、データセット中のどのパブリッシャーも開放的で機械可読な決済チャレンジを返さなかった。
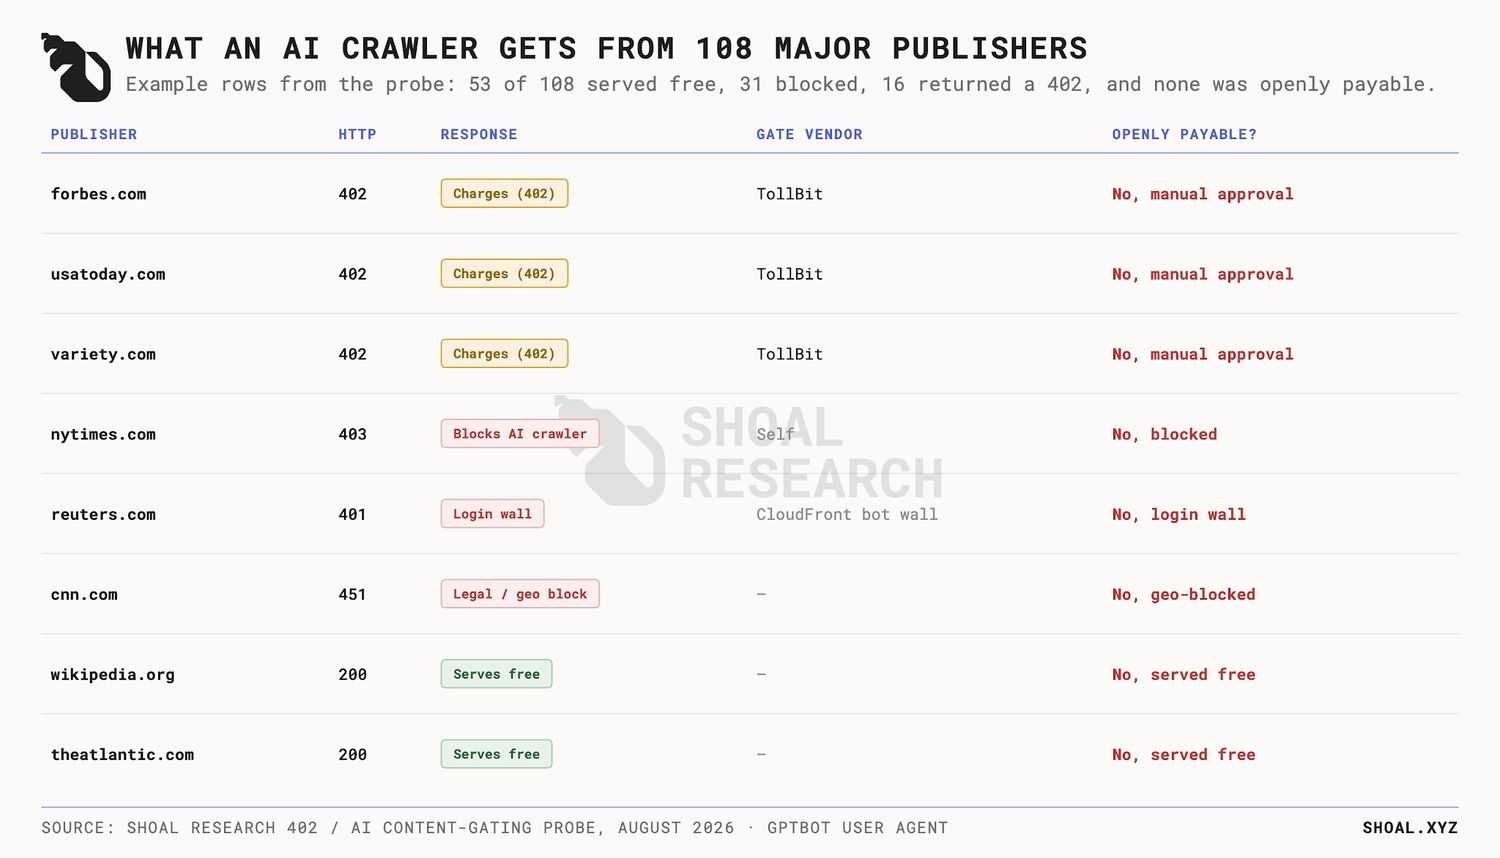
16回のHTTP 402応答中、10回はTollBot Bot PaywallへRedirectし、6回は静的HTMLライセンス問い合わせフォームを返した。ベースラインデータセットに含まれるTollBit管理下にある全13社について、認証済み開発者キーを使用した二次検査では、全てのレートクエリでHTTP 403を返した。APIペイロードは明確にコンテンツプロバイダーがプログラム化アクセスを無効にしており、リクエストごとのクロール料金レートを返していないことを示している。
これらの結果を解釈する一つの方法是、TollBitが伝統的パブリッシャーのための初期AIパートナーとして機能し、彼らがコンテンツの使用量ベース課金をテスト・理解するのを支援しながら、依然として制御されたエージェントアクセスにもたらされる制御力と安全性を提供しているということだ。手動の開発者登録、専有APIキー、企業ホワイトリストを必要とするシステムは、動的ネットワークパスをナビゲートする自律エージェントの前例のない規模へ拡張するのは難しい。むしろ、これは恒久的なマシンネイティブ決済基準が形成されるのを待つ間、伝統的收入を守るための移行措置である。現在はまだ初期段階であり、TollBitのようなプロバイダーは、サービスに付随するアクセス、ライセンス、自律性のバランスをどのように取り/manageするかを理解し制定しようとしていると考える。
また私たちは8月19日にCoinbase CDPレジストリ全体のプルを実行し、実際にx402を使用しているのは誰なのか、該ネットワーク上でどのサービスが稼働しているのかを探った。該ネットワークは15,000以上のエンドポイントを擁すると謳っており、そのうち数百が活発に使用されている。
主流コンテンツパブリッシャーはまだx402を採用していないが、この不在の下で活発な供給側市場が形成されている。コンシューマーメディアはまだ積極的に統合していないものの、開発者ツール、専門データサプライヤー、エージェントネットワークは開放的マシンペイメントエンドポイントを迅速に展開してきた。x402エコシステムで認識される名前にはTavily、Nansen、CoinGecko、Chainlink、Apify、BrowserbaseなどのデータAPIがあり、最近ではRampも加わった。x402上のトップサービスプロバイダーにはChatGPT、Claude、TripAdvisor、Perplexityなどの名前が含まれるが、大手コンテンツパブリッシャーは現状不在だ。
15,073のアクティブエンドポイントは、ソフトウェアがオープンな公共レール上で他のソフトウェアへのプログラム化アクセス権を積極的に価格設定し販売していることを示している。該ネットワークを追跡する一部の機関は、バンドルマーケットを統計に含めるとエンドポイント数が50,000に達すると報告している。しかし、これらのエンドポイントは依然としてスクレイピング、AIツール呼び出し、リアルタイムデータストリームに厳密に集中している。整個レジストリを主流コンシューマーメディアおよび出版ドメイン(『ニューヨーク・タイムズ』、ロイター、ESPN、ウィキペディア)とクロスチェックすると、マッチ率はゼロだった。私たちは通常有名な機関が「主導局面」を起こす必要があるため、この状況は緩やかだが確実に変化していくと予想している。ネットワークの貨幣化に関する歴史的転換は往々にして単一の既成プレイヤーが「現状」を打破することに続いて発生する。『ニューヨーク・タイムズ』が2011年に计量付费墙を導入し、AP通信が2023年に商業AIデータ取引の先鞭をつけることで、News Corpから『タイム』、Conde Nastへと連鎖反応を引き起こした。したがって、我々はファーストクラスの出版社がオープンプロトコル(x402、MPPなど)上で自身のアクセスを価格設定し始めれば、市場の残りの参加者が迅速に続くだろうと予想する。
オープンプロトコルアプローチの課題
オープンリクエスト課金プロトコルのインフラは稼働中だが、市場自体はまだ初期段階にある。オープン決済の技術パイプラインは積極的に展開されている。パブリッシャーにはRSLのような機械可読権利フレームワークが存在し、AWS CloudFrontおよびCloudflare内のホスティング&ルーティングゲートウェイはリクエストのミリ秒単位で課金でき、決済レールはクレジットカードからデジタル資産・ステーブルコインまで揃っており、x402やMPPなどのプロトコルを通じて普遍アクセス可能だ。積極的採用が残す最大の障害は完全に需要側に位置する。
第一に、主要AIラボはいずれもコンシューマー向けWebコンテンツ用にプロダクションクローラートラフィックをオープンマシンペイメントレールでルーティングしていない。我々はこれに三つの主な理由があると考えている。第一に、クローラーには統合ウォレット、自動調達予算、そして最も重要なこと:要求されたコンテンツに対して実際に支払う商業義務が欠如している。我々のクローラープローブで示唆された通り、Webの大部分は依然として完全にハードフリーだ。つまり、HTTP 402でブロックされたエージェントはそのURLを直接破棄でき、ハードフリーな競合他社からほぼ同一のコンテンツを無成本で抽出できる。法環境はこの動態を強化している。William Alsup裁判官がBartz対Anthropic事件で下した連邦判決のように、裁判所は合法かつアクセス可能な作品を取り込んでAIモデルを訓練することが変換性フェアユースに該当すると認定している。Alsupは違法に入手した海賊版データセットの保持に対しては制裁を下したが、オープンのWeb上でアクセス可能なコンテンツの訓練には著作権責任を負わない。公開Webテキストの抽出が法的に無料であるため、AIラボはオープンのマイクロフィートを自発的に支払う商業動機を持たない。
AI検索プロバイダーはどう報酬処理をしているか
プロダクション採用は限定的だが、AI検索プロバイダーは補償をプロダクトデザインの一部分として見做し始めている。
未発表のShoal Signalインタビューの中で、Parallelの前方配備エンジニアSon DoはIndexを説明した。これは直接パブリッシャーと協力し、各ソースがエージェントの最終回答に寄与した程度を測定し、それらのソースと収益を共有するプログラムだ。Doはパブリッシャーや他のデータプロバイダーが使用量ベースモードへ移行し、エージェントペイメントレールが大量の小額トランザクションをサポートすると予想している。Indexは、補償がAI検索および检索プロダクトの設計フェーズに入りつつあることを示すが、依然として主要AIラボの標準調達行動には至っていない。
法経済学的義務の欠如に加え、既存のオープン決済プロトコルには構造的欠陥がある。それはリクエスト課金サイクルの誤った部分を計量しているということだ。すなわち、初期HTTPスクレイピングではなく下流推論、つまりモデルが摄入した知識を合成してユーザープロンプトに応答する時刻を計量していない。生HTMLを取得する際に1米セント未満の料金を請求しても、AIモデルが一度にその報道を吸収し、百万回のユーザー回答でそれを再現する場合、クリエイターへの補償にはならない。RSLのようなフレームワークが推論課金のオプションを定義しているとはいえ、CloudflareやAWSなどのネットワークレベルゲートウェイはニューラルネットワークの潜在的重みを検査し、暗号化的に検証してどの訓練文書が特定の出力トークンを生み出したかを判断できない。Cloudflareが2026年7月にCeramic.aiおよびYou.comと行ったパイロットプロジェクトはまさにこの技術的ボトルネックを浮き彫りにした。該プランはスクレイピング課金モードから脱却し、「クエリ課金」モデルを試すもので、パブリッシャーのテキストが実際にユーザー面向AI回答に引用された場合にのみ支払いを行うものだった。これは確かに価値創造の瞬間を正確に標的としたが、CloudflareなどのネットワークエンドプロバイダーはAIサーバー外側に位置するため、Cloudflareは独自にモデルが生成过程中どのソースを引用したか検証できず、システムはAI企業に引用をカウントし債務額を自己報告することを余儀なくされ、名誉制度に戻ってしまった。
オープンプロトコルが直面するもう一つの根本的課題は、AIクローラーがコンテンツに対して一度マイクロ費を支払った後、テキストを内部キャッシュまたはメモリに書き込み、無限期にそのデータを配信することを真に阻止できないということだ。また、数千回の反復を通じて異なるサイトやパブリッシャー間で行うことも阻止できない。TempoのMPP共著者であるBrendan Ryanが我々のShoal Signalインタビューで論じたように、売側の課金能力は大きくその情報が独自性、時事的妥当性、キャッシュ難易度に依存する。
この制限は前述の静的クリエイティブ作品や報道において最も深刻だ。静的テキストは公開後間もなく経済的価値を失う。たとえAIツールの検索メカニズムによって収集されたとしても。一度AIモデルが調査報道、歴史記事、ニュース原稿を読み取ると、該情報はモデルの記憶に取り込まれる。モデルはこれらの事実を使って質問に永遠に応答でき、元のWebサイトを再度訪れる必要がない。したがって、公開WebテキストをAIインターフェースとパッケージ化するだけのソフトウエアツールは、競争他社が同じ無料情報上で同じクローラーを構築するため、利益が急速に消失する。
基本ルールは簡単だ:静的データはほとんど瞬時に価格設定能力を失い、動的かつキャッチ不可能な情報は支払い可能性を保つ。AIモデルは未払いの記事や歴史レポートを一度読み取り、その知識を重みの中に永久に保存できるため、リクエスト課金型のマイクロフィーは静的テキストに依存するビジネスを持続させることができない。継続的付費は、継続的生産と検証が必須な情報にのみ適用され、我々はこれが三つの主要コンテンツクラスに帰結すると考える:
第一はリアルタイムの短寿命ステータスである。リアルタイム注文簿、サブ秒金融プライシング、速報ニューステレメトリ、IoTセンサーデータストリームが含まれる。AIモデルは数ヶ月前の訓練重みや期限切れキャッシュから現在の世界のステータスに関するクエリに応答できない。現在の現実を取得するためには、その正確な時刻で源サーバーに対して新規かつ付費のAPIリクエストを発行する必要がある。
第二はオープンのWebに触れていない専用オフラインデータである。プライベートマーケットインテリジェンスを例にとる。ニュースリリースで発表された歴史的資金調達ラウンドや役員変更は急速に低コスト競合にスクレイピングされ商品化される。真の価格設定権は、ファンドマネジャーとの秘密保持関係を通じて非公開の株式持ち分テーブル条項、プライベート取引バリュエーション、検証済みLPアロケーションを手作業で収集するなど、一次手工人手研究を行うプロバイダーに属する。このデータは公開URLで索引付けされないため、自動化クローラーは有料ウォールを迂回したり、無料で抽出したりできない。
第三は鮮明な人間の声とブランド評判だ。メディアストラテジストのAshni ChristがShoal Signalで指摘した通り、遮蔽または停止された汎用的なニュース集約フィードは、すぐに全く同一の自動スクレイピング器に取って代わられ、オーディエンス損失はない。しかし確立された視点を持つ真正の分析家、調査記者、クリエイターがコンテンツ発行を中止すると、読者は直ちに気づき彼らを探す。リアルタイムインタビュー、主観的分析、直接接触はLLMによって事前計算され、中間キャッシュに保存されたり、静的訓練セットから複製されたりすることができない。これがリアルタイムデータストリーム、私有オフライン記録、パーソナルパースペクティブが唯一信頼できる価格設定資産であることを意味する。
結び
インターネットは崩壊しつつある。少なくともそう見える。
相互間の通信と協調を加速するために、人間は世界中のコンピュータとソフトウエアネットワークを構築し接続した。数十年の間、各 subsequent レベルの技術はこの交換をより速く、より効率的なものにする aimed で、最終的には大規模自動化用に建設されたソフトウエアを生み出した。生成系AIは這種自動化能力を数億人に一度に直接渡した。しかし自動化ソフトがネットワークを乗っ取るにつれ、情報が発見・合成・消費される方法を根本的に変えている。この転換のもっとも深刻な結果は経済面にある。過去三十年にオープンインターネットを支えてきた広告露出と人力推奨モードによってネットワークトラフィックを収益化することは再び不可能だ。正因如此、我们现在看到按请求付费的互联网正在形成。
既存の二つの異なるパスはネットワーク世界のおなじみの物語だ。中央集権的・クローズドソースのミドルウェアは、法定通貨課金、ワンストップコンプライアンス、馴染み深い企業オンボーディングプロセスを提供する一方で、プラットフォームロックインとライセンス制のゲートキーパーをもたらす。他方、オープンプロトコルは無许可アクセスとステーブルコインによるプログラム化マイクロペイメントを提供するが、企業配信、推論帰因、そして最も重要な実際のパブリッシャー採用において仍存在缺口。
我々が自らリクエスト課金型インターネットの状態をテストした結果、オープン決済プロトコルのインフラと供給側は既に準備完了だ。x402のようなオープンプロトコルはデータ収集、ツール呼び出し、AI推論、リアルタイムデータフィードといった機能型マーケットを积极推动しているが、主流オンラインパブリッシャーからは支持されていない。TollBitのようなプラットフォームは現在プログラム化収益化マーケットとして宣伝されているが、データはパブリッシャーがそれらを臨時的なソリューションとして利用し、スクレイピングを遮断しAIラボを私下のオフライン取引へ誘導していることを示している。
それは我々に、クローズドマーケットかオープンプロトコルかどちらが「勝つか」を判定するには遠すぎることを教えてくれる。実際、どちらかに偏る必要があるだろうか?未來はおそらく両方のパスを同時に含むことになり、異なる顧客や異なるユースケースにサービスを提供するだろう。ステーブルコインはプリペイドクレジット、サブスクリプション、伝統的な請求書とともに積極的に使用されることになる。このゲームは一部の人々が考えている、少なくとも主張しているようなゼロサムゲームではない。少なくともしばらくの間は。
ただ、インターネットが転換点にあるとはいえ、将来の走向についての先見性の予測をしやすいものではあるが、視野を広げてWebが存続したのはたった30年であり、その間常に継続的に進化してきたことを覚えておくことが重要だ。新興のリクエスト課金型インターネットが決済インフラの点上でクローズドマーケットかオープンプロトコルかに収束するのかどうかにかかわらず、一つの可能性は常にある。アクティブに进化する資金豊富なAI分野のさらなる発展が、両方のパスを無用にし、未曾探索的全新路を奠定するかもしれない。現時点では、我々はより有望なのはオープンプロトコルとクローズドマーケットが同時により广泛的に採用され、各自が異なる细分市场と異なるユースケースにサービスを提供する方向だと考えている。しかし、任何前瞻性判断一样,唯有时间能给出答案。
旧契約の崩塌は最終的により健全なネットワークを生み出す可能性がある一方で、最初にリクエスト課金型の使用料を支払う資金を持たなかったりエージェントを使用したりする人々のグローバル情報アクセスコストを引き上げる可能性もある。ただ、直接的なマシンペイメントはパブリッシャーにとって広告やプラットフォーム制御推奨に依存しない機械利用収益化パスを提供する可能性がある。結果は、这些新轨道是继续向独立发布者开放,还是变成又一层把关者。
TechFlow公式コミュニティへようこそ
Telegram購読グループ:https://t.me/TechFlowDaily
Twitter公式アカウント:https://x.com/TechFlowPost
Twitter英語アカウント:https://x.com/BlockFlow_News
 @Shoalresearch














