AI Agent が互いに雇い合うとき、誰が監視するのか?
執筆:Thejaswini M A
編集:Saoirse、Foresight News
インターネットの発展における長い期間にわたり、検索エンジンは単に検索結果のリストを返すだけで、残りの作業はすべてユーザーに任されていた。目に飛び込んでくるのは青色のタイトルとハイパーリンクだ。そして私たちは、自分の検索ニーズに合いそうだと思われるコンテンツをクリックする。この体験がもう過去のものになってしまったと思うと不思議な感覚を覚えず、同時にどこか歳月の流れを感じる。
ライターとして、私は以前からSEOという仕組みに違和感を抱いてきた。キーワードの最適化は記事の魅力ある部分を損ねることが多いし、Googleのランキングアルゴリズムでは外部への参照も「投票」と見なされる。本質的には、他のウェブサイトから自サイトへのリンクが多いほどページ評価が高くなる仕組みだ。しかしこれも仕方がないことだし、文句を言う筋合いでもない。何らかの信頼性があるなら、全く信用されないよりはマシだ。広告はインターネット上のすべての基盤を支えている。だがコンテンツ配信者は明らかにこのメカニズムを忌み嫌っているのが現実だ。
こうした従来型のパターンは現在、衰退しつつある。金融経済に関する書籍を探したい時や、長時間歩いた後に足が痛む時の対処法を知りたい時は、私は直接Geminiを開く。Perplexityを使う人もいるし、GPTを使う人もいる。トークン消費に敏感でない人はClaudeを直接選ぶ。これらのツールの効果は、確かに記事全体を読み込むよりも優れているのだろうか?答えは分からない…… とはいえ、生活が確かに楽になっていることは確かだ。対極的な意見を持つ2つの記事をわざわざ読む必要はなく、AIがすでにその問題を処理してくれている。
少なくとも30歳以下の層については、彼らはもはや検索エンジンを行き当たりばったりにアクセスする「入り口」として扱っていないと私は考える。
そこにエージェント(Agent)が台頭し、既存の構図を一変させた。非人間由来のトラフィックは既に人間のそれを上回っている。調査タスクを実行するエージェントは、数千のウェブページを読み込んでも、最終的に出力するのはわずか1枚のメモばかりである。これは人間の行動様式とは根本的に異なる。したがって、エージェント駆動型の経済システムにおいては、広告の価値が失われる可能性がある。以前、ソフトウェアが自身が要求するリソースに対して対価を払うべきかどうかを検討した記事2本を書いたが、結論として「決済行為そのものがむしろ最も簡単な要素である」と導き出した。
ネットワーク上でタスクを完了し、価値の決済を実現するには、エージェントには相互に独立した6層の技術スタックが必要になる。
エージェントはウェブリソースを発見し、返された結果を信用し、他エージェントを信用し、タスク完了を確認し、支払いを完了し、さらにコンテンツクリエイターに適切な報酬を残さなければならない。次に、この順序に沿って各レイヤーを順に解説していく。
本来のウェブにあるものは何か?
機械も人間も「検索」を利用するが、両者が求めるウェブページの性質は根本的に異なる。
人間の検索では、完全なウェブページのリストが返され、ユーザーがタイトルを見て自ら遷移先を選択する。一方、AIエージェント向けのマシンサーチはこれとは異なる。エージェントはコンテキストウィンドウ(短期記憶)の制約を受けるため、ウェブページを丸ごと閲覧しない。重み付けられた全リンクを返すのではなく、タスクに最も有用な一部の内容だけを抽出し、そのままモデルに供給することでメモリ不足を防ぎ、処理時間はミリ秒オーダーで終わる。
このカテゴリの大手企業はParallelとExaで、どちらもエージェント検索サービスを提供する独立企業である。ParallelはParag AgarwalによってTwitter退社後に設立され、4月に1億ドルの資金調達を果たし、企業価値は20億ドルとなった。Parallelは明確な目標に基づいて検索を実行し、圧縮されたコンテンツスニペットを返す。スニペットはタスクへの貢献度でソートされ、各事実には出典と信頼度が付される。
一方でExaはa16zがリード投資し、5月に2億5000万ドルの資金調達を完了、評価額は22億ドルとなっている。5000社以上の企業と4万人のデベロッパーにサービスを提供し、Cursor、Cognition、HubSpot、OpenRouter、Monday.comなどの製品に基盤能力を提供している。Exaはキーワードマッチングよりもセマンティック理解を重視しており、原文に検索語が出現していなくても関連するコンテンツを返し、かつクリーンな原文をそのまま提供するのが特徴だ。
Parallel公式ドキュメントによると、高速プラン2種で1000回の検索リクエストが1ドル、低速プラン2種が5ドルだ。記事の長短に関わらずURLからのコンテンツ抽出は一律で1000件あたり1ドル。Exaの1000回検索リクエスト料金は7ドルでParallelの約7倍、ページコンテンツ抽出は1000ページあたり1ドル、引用付きQ&A APIは1000回で5ドルだ。
検索性能は本当に優秀なのか?
Googleは検索品質の評価を主に社内で行っており、ユーザーがトップ結果をクリックしたか、ページに留まったのか即座に離れたのかを判断し、同時に人海戦術で採点員を雇って結果にスコアを付けている。過去にはRTECのようなテストもあったが、公開されて購入可能なレーティングボードは存在しなかった。Google AnalyticsやSimilarwebが計測するのはトラフィックであり、検索品質ではない。
エージェントインターネットの時代において、ラボベースのベンチマークセットが登場し、検索ツールがAIに正解をもたらせるかを専門に測定するようになった。
OpenAIは2025年4月にBrowseCompを公開し、1266問の逆構築型クイズが含まれる。設問作成者はまず検証可能な客観的事実を定め、その後に問題を作成し、事実を複数の制約条件の下に隠蔽する。先に問題を出すと一般的な知識クイズになり、モデルは自身の記憶や偶然の検索で正答してしまう可能性が高い。逆に事実を先に確定させて問題を作成すれば、初めてツールのウェブ検索能力を真に検証できる。
ネイティブGPT-4oのスコアはわずか0.6%に留まり、ウェブブラウジング機能を有効にしたGPT-4oでも1.9%。OpenAIのDeep Researchは51.5%を獲得した。

このテストの目的は、システムが実際のインターネット内で隠蔽されかつ検証可能な事実を見つけ出し、出力できるかを検証することにある。1266問全てに簡潔な正解があり、モデルの回答機会は1回のみで、一致すれば得点、不一致なら無得点となり、最終スコアは正解率が示す。ネイティブGPT-4oの0.6%は、モデルが内蔵記憶だけで事実を取得できないことを示す。ブラウジング機能付きGPT-4oの1.9%は、基礎的な検索ツールによる向上幅が極めて小さいことを意味し、Deep Researchの51.5%は、より長い検索・読解サイクルを経て、標的の事実をおよそ半分の確率で見つけられる可能性があることを示している。
BrowseCompのほかにも複数のベンチマークが存在する。SimpleQA(OpenAI、4326問)は採点が容易な事実認識テストだ。ブラウジングツールが高速化するにつれSimpleQAの難易度はモデルに簡単に突破されたため、BrowseCompが生まれた。GAIA(Meta/Hugging Face、466タスク)は実際のアシスタントシナリオを対象としており、ウェブ閲覧、ツール呼び出し、ファイル読み込み、複数ステップの推論などが求められ、単純な検索にとどまらない。DeepSearchQAはマルチラウンド検索の研究用データセットで、Artificial Analysisはこのデータを基に総合評価を行っている。FRAMES(Google DeepMind、824サンプル)はマルチホップQAセットであり、複数情報源から事実を抽出して統合する必要がある。
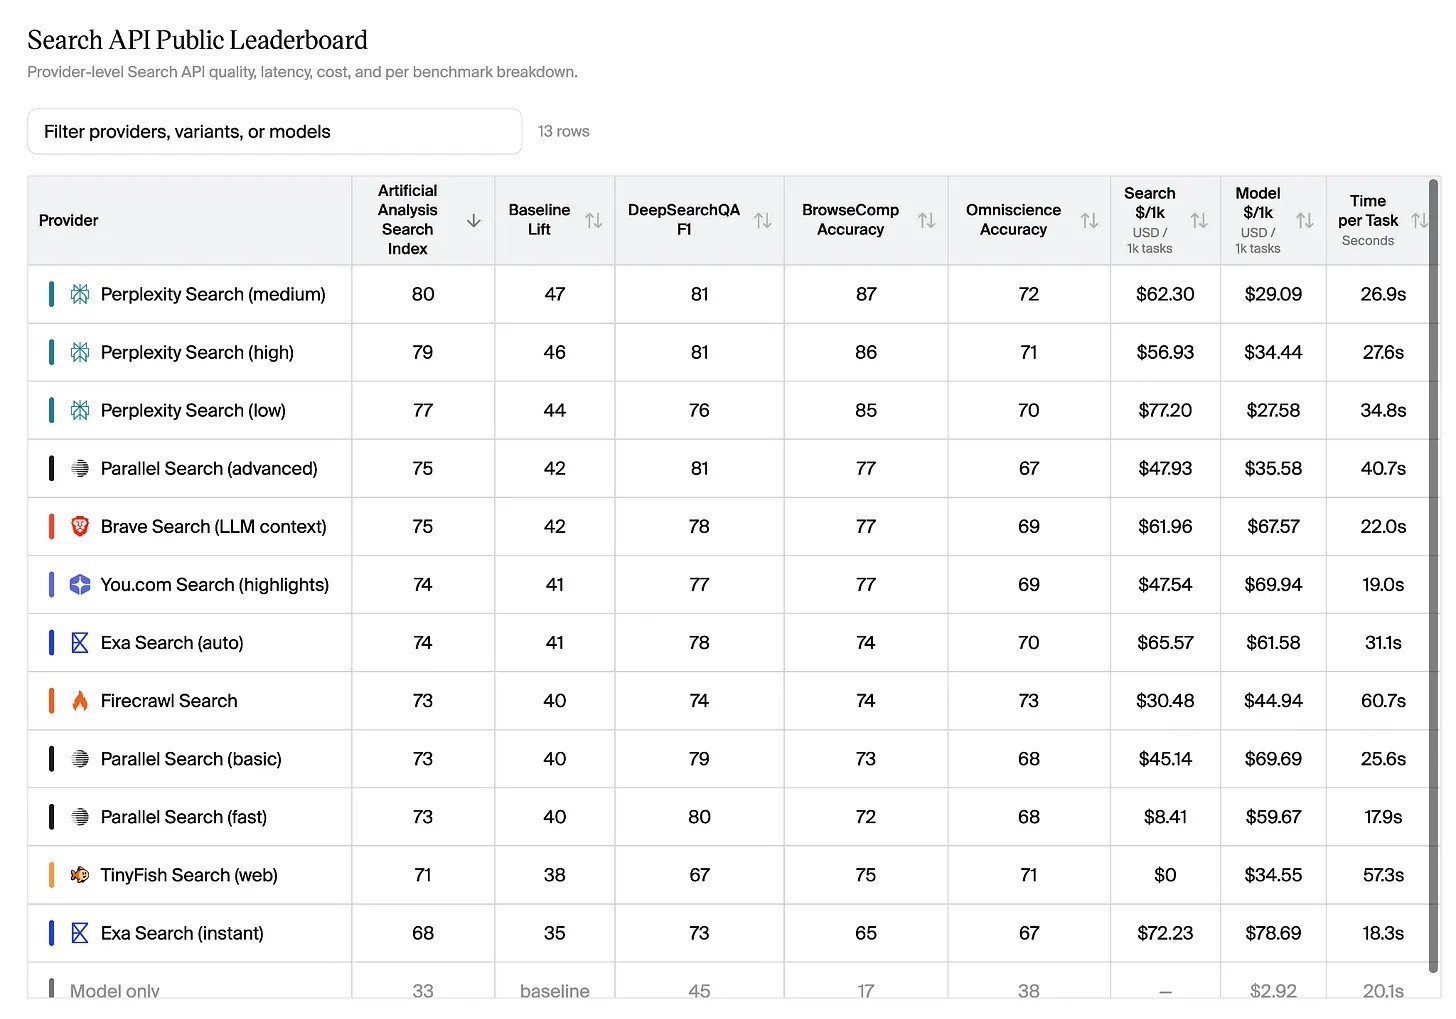
民間機関のArtificial AnalysisはGeorge CameronとMicah Hill-Smithによって共同設立され、2026年8月18日に検索インデックスを発表した。この評価では回答に使用するAIモデルと採点ルールを固定し、エージェントが呼び出す検索APIのみを変更する。スコアに変化があれば、その差異はモデル能力ではなく検索ツール自体に起因するものである。
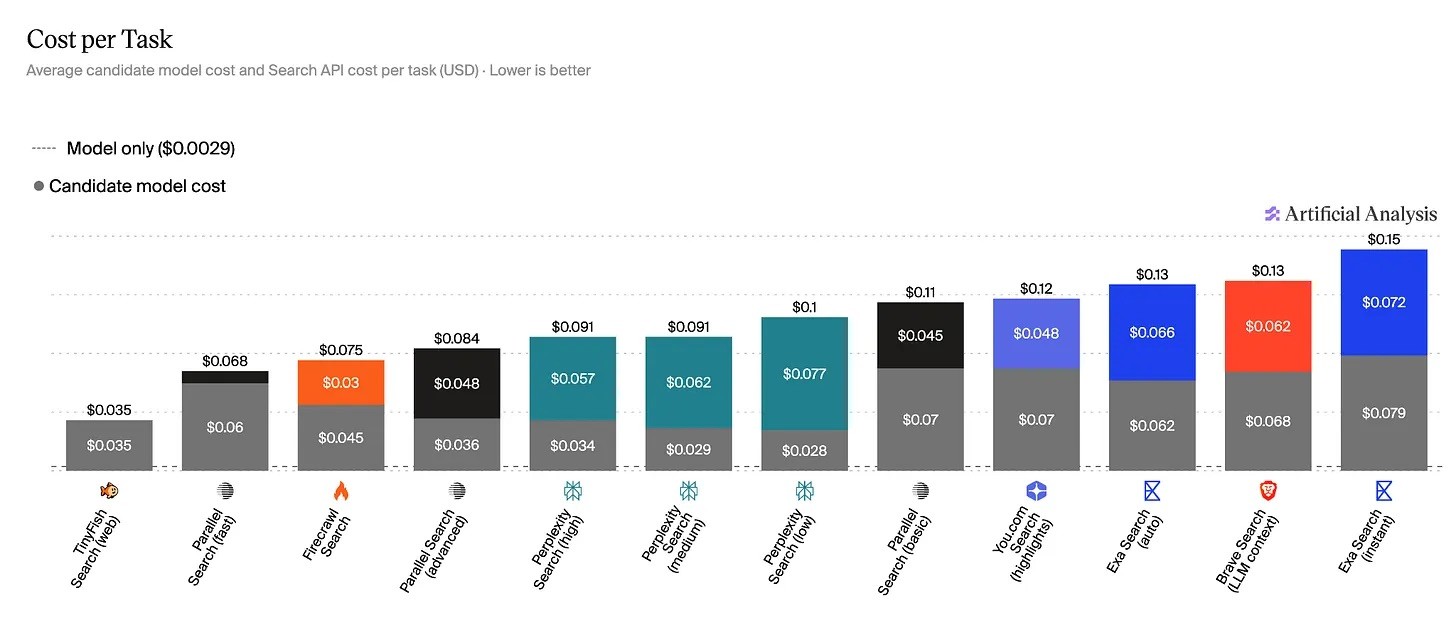
出典:@artificialanalysis
検索を完全に利用しない場合、同一モデルはこのインデックスにおいてベースラインスコア33、BrowseCompサブセットでは17を記録する。各検索サービスの順位変動に関わらず、ベースラインスコアは一切変化しない。
8月27日時点のArtificial Analysis検索インデックスでは、Perplexityミドルバージョンがスコア80で首位。ParallelプレミアムとBraveは同率2位の75点。You.comとExaは74点。Firecrawl、Parallelベーシック、Parallel高速版はいずれも73点だ。
検索ツールのスコアがベースラインを上回れば、検索が実際にモデルの新規情報取得に役立ったことを示す。ロジックは以下の通りだ。AIが記憶のみで回答するとベースラインスコアになり、検索を組み合わせた後にスコアが上がれば、検索によってモデルが以前知らなかった情報を見つけ出したことを意味する。スコアが上昇しなければ、検索は何も貢献していないことになる。
ただし評価自体にも限界がある。テスト課題や使用されるモデルは特定のビジネスシーン専用ではない。サービスプロバイダーは既存のテストセット(例えばDeepSearchQAなど)を対象とした対策最適化を実施でき、これはかつてウェブサイトがGoogle向けにSEO対策を行ったのと同様だ。
相手側のボットは誰なのか?
2つのAIエージェントが相互に作業を委任する場合、ウォレットアドレスと自己紹介文だけでは信頼関係を築けない。ウォレットアドレスは単にアカウントに資金が残っていることを証明するだけであり、説明文は偽造しやすい。ボットの開発者IDを示すこともできず、過去の履歴が本物かどうか裏付けることもできない。ERC-8004という規格は、まさにエージェントの正体と評判を検証するために設計されたものだ。
ERC-8004はMetaMask、イーサリアム財団、Google、Coinbaseの関係者によって共同で作成され、2026年1月29日にイーサリアムメインネットでローンチした。3つの大規模レジストリを含む。
第一にIDレジストリがあり、NFT形式で実装されている。各エージェントには番号付きトークンが割り当てられ、そのURIは登録ファイルを指し、エージェント名、サーバーエンドポイント、x402決済のサポート有無、対応する信頼モデルなどを記録する。トークンの保有者=エージェント所有者であり、所有権が移行すると従来の決済ウォレット情報はクリアされ、新しい保有者が制御権を証明するため再度署名しなければならない。
第二に評判レジストリがあり、署名付きフィードバックを受信する、つまりチェーン上の公開評価システムだ。エージェント使用後、ユーザーはチェーン上にスコアを残せ、タスクタグ(検索や採点など)を添えることができる。エージェント所有者は自分自身に対する評価を書くことが禁止されており、評価の取り消しも可能だ。誰でも評価欄にコメントを追加でき、返金履歴やスパム警告などもスコア横に付与できる。これはエージェントIDに紐づく公開コメント欄であり、特定アプリ内のプライベート星評価システムとは異なる。
第三に検証レジストリがあり、第三者による独立検証と連携する。エージェントが検証リクエストを発行し、バリデータースマートコントラクトが0〜100のスコアとエビデンスURLを返す。証拠元はタスク再実行の結果、ゼロ知識証明、またはセキュアチップが発行した証明書であってもよい。
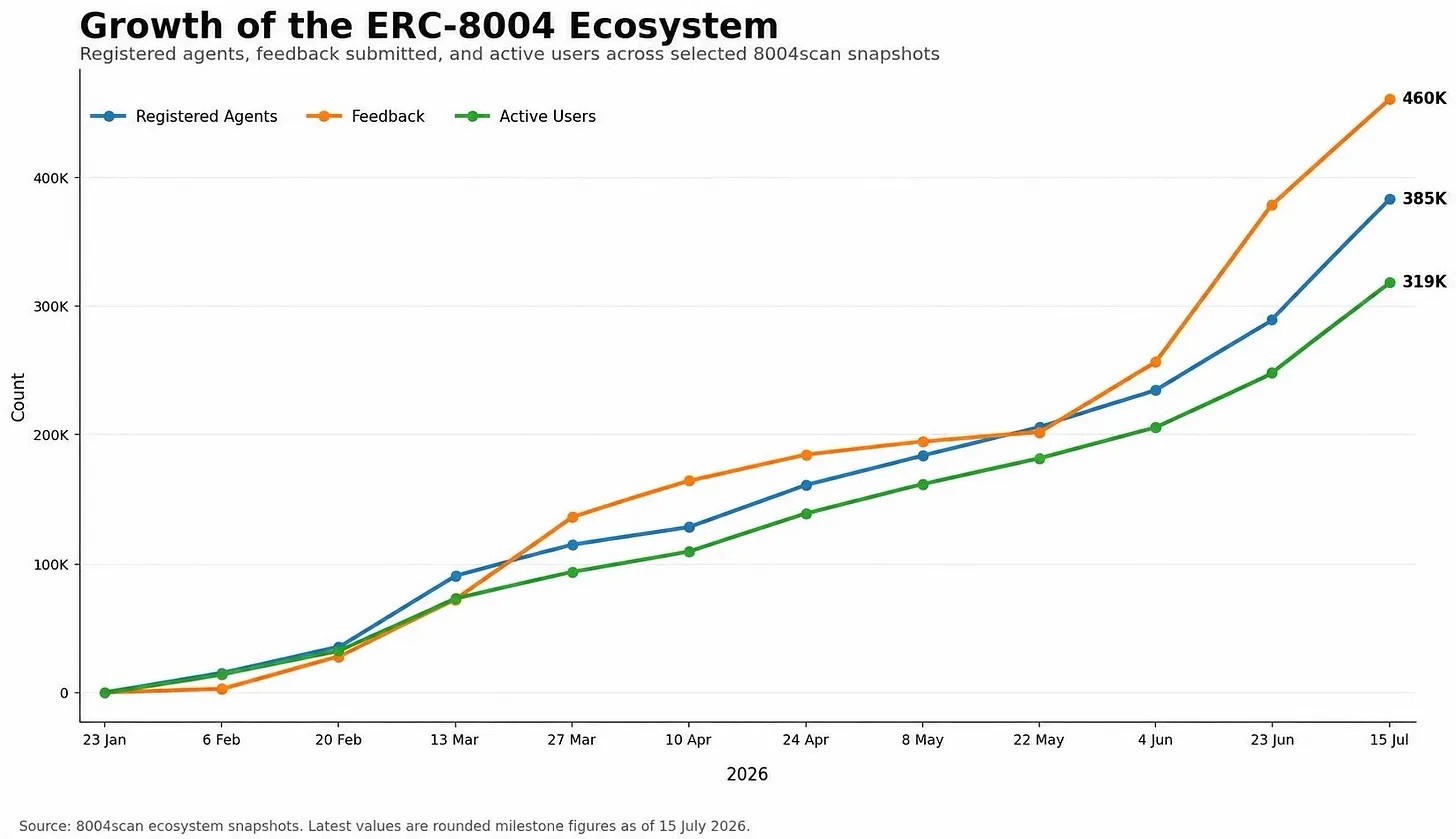
この規範自体は決済ロジックを処理せず、ドキュメントにも明記されている。エージェントID、外部評価、第三者の検証結果のみを記録し、決済は他のプロトコルに委ねられている。レジストリのデータ品質は芳しくない。8004scanの7月統計によると、29の公開チェーンを跨いで合計385,998個のエージェントが登録され、46万件以上のレビューがある。大半のIDは単なる空バッジに過ぎず、89.2%が外部公開可能な標準サービスAPIを持っていない。利用可能なサービスを持つエージェントは8,631個だけであり、比率はわずか2.24%だ。
出典:@8004_scan
5月のイーサリアム、BNBチェーン、Baseチェーンを対象としたクローラー調査により、オンチェーンスコアは異なるエージェント間で横断比較できないことが判明した。フィードバックの大部分は、誰もが検証可能なタスク成果物に紐づいておらず、レビュー操作のハードルが非常に低い。疑わしい評価をフィルタリングした後、多くの評価済みエージェントには有効なレビューが残っていなかった。この規格はレビューデータの出力フォーマットだけを統一しており、どの評価が真正で信頼できるかは外部システムに委ねている。ENS、EigenLayer、The Graph、Taikoが同規格への統合を表明しているものの、まだレビューフィルタリングツールは開発されていない。
エージェントは本当に業務を完遂したのか?
Agentic Commerceアーキテクチャはイーサリアム財団とVirtuals Protocolが共同設計したもので、自律型AIエージェント間での相互雇用・協業作業・オンチェーン決済の実現を目指し、人の介在なしに完結させるもの。ERC-8004とERC-8183(エスクロー規格)の組み合わせによりこの体系が実現する。ERC-8183はエージェント間のタスク投稿、資金管理、成果物検証、決済フローを標準化する。
ワークフローは以下の通りだ。タスクを発行するクライアントエージェントが課題を公開し、タスク内容、締切日時、予算を明記し、評価者を指定する。クライアントは資金をスマートコントラクトに預け、資金はロックされ、どちらの側も一方的に取り崩せない。
サービス提供するエージェントはオフチェーンで計算を行い、最終成果物をIPFSやArweaveといった分散型ストレージにアップロードし、チェーン上にはハッシュ値またはリソース識別子のみを送信する。評価者(専任審判エージェント、自動オラクル、ゼロ知識検証プロトコルなど)が納品物の確認を行う。
評価者がタスク合格を認定すれば手数料控除後にサービス側に支払われ、不合格なら資金はクライアントへ返還される。もしサービス提供者がメッセージレスになったり、評価者が締切後に停滞したりした場合、コントラクトは公開返金ロジックを発動し、資金をクライアントに戻して資産が永久にロックされるのを防ぐ。
評価者はクライアント自身を担当させることも可能で、ドキュメントはこれをサードパーティ不在のデフォルト手法としている。同時に規格では以下のように明記されている:本プロトコルは紛争解決および仲裁機制を提供せず、結果拒否/タイムアウトをもって最終裁定とする。もし選んだ評価ロボットが悪意を持ってあなたを騙したとしても、管理者やカスタマーサポートに苦情を申し立てる手段はない。あなたは頼るところがない上に、前述の問題もあり、オンチェーンレビューを頼りに信頼できる評価者を選ぶことすら不可能だ。大半の評価が偽物だからである。
UMA、Kleros、Bittensor等のシステムは評価者の一点依存リスクを軽減できるが、速度低下とコスト増を招く。純粋な自動化エスクロー決済は数秒で完了し手数料も極めて低いが、UMAやKlerosを通じて紛争フローをアップグレードすると、チャレンジウィンドウ、ステーキング保証金、さらには人間による投票参加が求められる。
資金は正しく移動したのか?
最近業界ではこの領域について議論が活発化しており、ここでは簡潔に説明する。
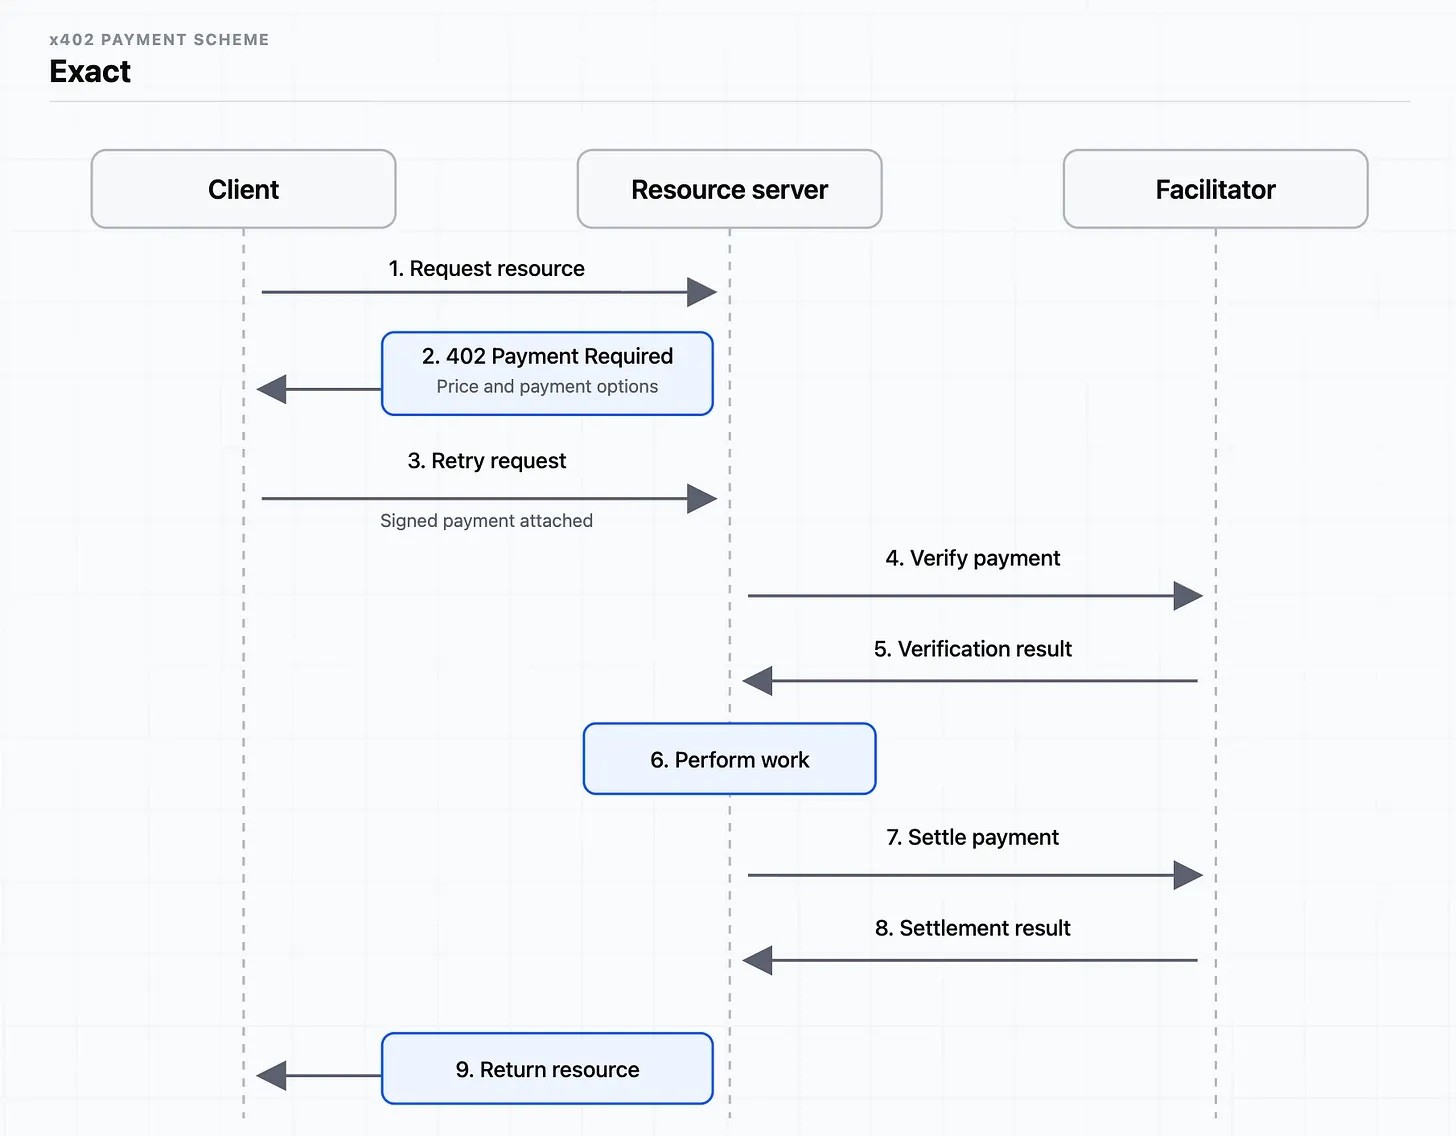
x402はCoinbaseが推進しており、既存の公開チェーンの上に重ねるレイヤープロトコルだ。リクエストごとに課金され、安定通貨による送金を完了させる。
出典:@coinbase
もう一つのソリューションはマシンペイメントプロトコル(MPP)で、StripeとTempoが2026年3月に共同発表し、同日Tempoメインネットが正式に稼働した。MPPはHTTP規格である。サーバーは「402 Required Payment」応答を返し、チャレンジ情報を添える。エージェントは支払い証明書を持ってリクエストを再開し、サーバーはリソースと支払いレシートを返信する。
資金の実際の移動は基盤チャネルに依存する。Tempoのオンチェーン取引1件あたりのsettmentは約0.5秒だ。一連の小額呼び出しに対応するため、エージェントは事前に資金をロックし、処理中に継続して帳簿を付け、最後にまとめてオンチェーンで清算する。これにより、毎回の呼び出しでオンチェーントランザクションを発行する必要がなくなる。支払い上限はそのセッションのロック枠またはアクセスキーで制御され、「一回限りの承認による永久引き落とし」ではない。
MPPは多種の基盤チャネルをサポートする。Visaがカード規格を公開し、エージェントはトークン化カードで決済できるようになる。Lightsparkは同じ402フローをベースにライトニングネットワーク決済ソリューションを実現し、Visaカードプランも用意している。Stripeカード決済にすでに対応している加盟店は、MPPカード決済を直接受け取ることができ、資金は通常のStripeアカウントに入る。ライトニングネットワークはMPP規則下のもう一つのオプションチャネルだ。Stripeはx402にも同時対応している。x402とMPPはいずれもHTTP 402ステータスコード「Required Payment」を再利用するが、両者は別々のプロトコルに属する。
コンテンツクリエイターは報酬を受け取れたのか?
クリエイターにお金が支払われなければ、新規検索コンテンツは生まれなくなる。クリエイターが収益化できなくなれば作品発信を停止し、AIエージェントは最終的に新たな読解素材を使い果たしてしまうだろう。
この分野における代表的プロジェクトはCloudflare、Parallel、OpenLedgerの三つだ。
Cloudflareは当初、クローラーによるウェブページスクレイピングに対して一律の固定料金を徴収していた。このアプローチは粗末であり、トップページの取得と深入りの調査報道記事の取得で課金額が全く変わらない。現在Cloudflareは価値連動課金モードへ移行しており、コンテンツが実際に価値を生んだ場合に限りパブリッシャーに報酬を支払う。さらに、広告収益型のサイトに関しては、AI事業者が支払いを拒否した場合、CloudflareがAIクローラーを遮断する。
Parallelは5月19日にIndexサービスをリリースした。協力ゲーム理論のシャプレイ値アルゴリズムを借用し、各情報源がエージェントの最終タスク成果に寄与した割合を計算して配分する。クリックごとの一律課金ではなく、数学モデルを用いて単一記事がタスクに果たした実質的貢献度を測定する。協力パートナーにはThe Atlantic、Fortune、PR Newswire、PitchBook、ZoomInfo、Tracxn、RocketReach、Enigma、Fiscal AIなどが含まれる。
現時点では、IndexはエージェントがParallel独自の検索ツールを使用した場合のみ決済を行う。他のAIプラットフォームがすべて接続しない限り、汎用ネットワークスタンダードにはなりえない。
OpenLedgerはトークンエコノミクスを活用する別のアプローチだ。データセットがAIモデルに与えた影響度を統計し、自社トークンで貢献者に報酬を支給する。このソリューションはAI訓練データ開発者を対象としており、ニュース記者の日頃の記事補填を目的としたものではない。
筆者はこれらのプロジェクトがクリエイターに実際いくら支払っているのかの正確な数値を探そうとした。Cloudflareは公表情報を持たないし、Parallelも開示していない。OpenLedgerはOPENトークンで決済しており、総支払額を独立して公表していない。そのため、現状ではこのメカニズムの実際の効果を判断する決定打となる事実はまだ存在しない。
人類の商業発展史において、現金計器は意外にも後に登場した産物だ。人類は何年もかけて口約束や地域社会の信用体制を築いて初めて、低摩擦の決済を発明したのである。一方、マシンインターネットの発展経路は完全に逆転している。誕生時から即時・ストリーミング型のグローバル決済を実現してきた。現在、エージェント経済ではあわてふためいてオンチェーンの小額紛争裁定廷を構築し、ロボ同士が数ドルのタスクを巡って互いに詐欺し合うのを防ごうとしている。
最後にテリ・プラッチェットの言葉を引用して締めくくる。
「純粋な論理だけを追及し、『機械は与えられた命令を実行しているだけだ』と簡単に言い逃れるのは簡単だ。だが人々は当然、機械にもわずかな常識があることを期待する権利を持っている。」