

从 AGI 到 ASI:通往超级智能的四条路
作者:Tim Genewein,Google DeepMind
编译:深潮 TechFlow
深潮导读:数十年来,人工智能研究始终聚焦于一个划时代的里程碑:构建具备人类智力水准的通用人工智能(AGI)。然而,随着前沿模型的推理能力与认知边界以指数级速度跨越式演进,人类必须直面一个更具深远影响的时代课题:AGI 之后究竟会发生什么?
Google DeepMind 研究科学家 Tim Genewein 发表长文,将通用智能置于连续演进的宏大坐标系中,全面解构了驱动认知工业化的底层飞轮,并详尽剖析了从专家级 AGI 迈向全面超越人类群体智慧的超级智能(ASI)所依赖的四条技术路径。
数十年来,整个人工智能学术界与工业界的研究焦点,始终牢牢锁定在一个极具象征意义的宏伟里程碑之上:打造出达到人类智慧水平的通用人工智能(AGI)。
随着底层算力基础设施与大语言模型架构的迅猛突破,AGI 正在从遥不可及的理论假说,逐步演变为触手可及的现实可能。此时此刻,我们再也无法回避一个更为关键的严肃叩问:在 AGI 达成之后,技术与文明究竟将驶向何方?
从 AGI 向超级智能(ASI)的跃迁绝非一蹴而就的单一事件,而是一场由多条互补交织的技术路线共同驱动的长周期演进。为了理清这幅复杂的未来图景,我们需要建立起严密的认知坐标系。
通用智能的连续谱系
若要推演高级人工智能的未来展开方式,最清晰的方法是将不论是生物学还是机器承载的通用智能,视作存在于一条连续平滑的光谱之上。
处于中段的人类水平 AGI,仅仅是这条漫长光谱上的一个特定节点。在此之前,人类已经研发出了狭义非通用 AI,以及处于萌芽期和发展期的各类基础大模型系统。
而超级智能(ASI)则坐落在这条光谱更靠右侧的高阶位置,它被定义为一种在绝大多数经济、科研与决策领域,能够全面且稳定地超越由人类顶尖专家群体构成的集体智慧的高级实体。
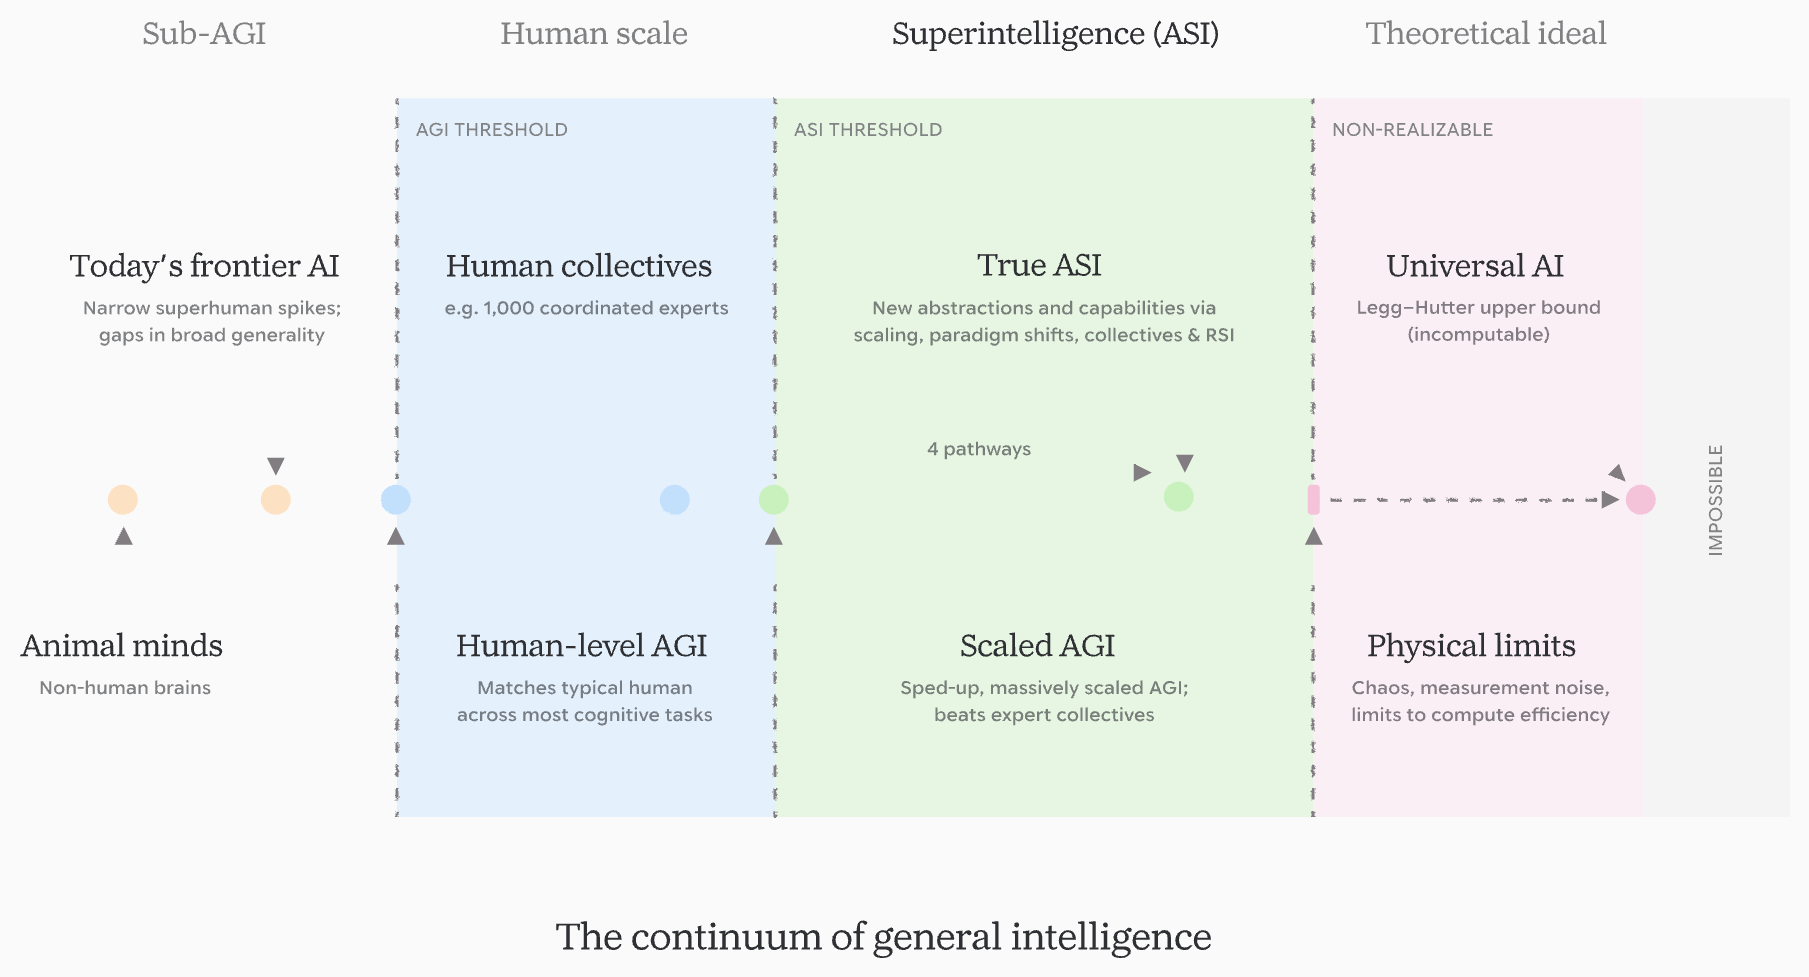
图:通用智能的连续谱系从人类水平延伸至理论上限(Google DeepMind)
从纯数学角度来看,我们对于智能光谱最顶端的理论物理与数学极限已经有了相对严谨的理解,例如理论计算机科学中的最优化计算与信息熵界限。
然而,仅仅知晓终极上限,并不能清晰描绘出通往峰顶的具体山径。即便是理论上被证明为最优的算法,其完全落地往往也需要超出地球上所有算力总和的天文数字资源。
现实中更具实用价值的飞跃,往往发生在次优启发式算法与高效工程架构的交汇处。在专家级 AGI 与全面超越人类的 ASI 之间,存在着一片亟待技术先驱深入探索的无人区。
认知工业化:有效算力的三重复合飞轮
即使部分观察者对前沿模型单点能力突破的持续性持有悲观态度,整个产业界正在发生的一场更深层次的变革同样不可阻挡:认知工业化(Cognitive Industrialization)。
在过去十年中,推动人工智能突飞猛进的根本燃料,是有效算力(Effective Compute)的复合指数级增长。这一持续膨胀的飞轮由三大互为乘数效应的核心支柱共同铸就:
其一,硬件制造工艺迭代:在摩尔定律及其衍生物理架构的演进下,单位美元所能购买的硬件计算浮点性能在过去几十年中保持着年均约 1.5 倍的复合增长。
其二,算法效率质的跃升:在过去十年中,训练出同等智力基准表现模型所需的绝对算力消耗,以每年 3 至 6 倍的速度断崖式下降;而在模型推理端,算法与量化部署的效率提升每年也达到了约 3 倍。
其三,算力基础设施投资规模暴增:全球针对人工智能专用算力硬件的资金投入以每年约 2.5 倍的速度急剧放大,大模型训练集群正在向数十万卡规模全速迈进。
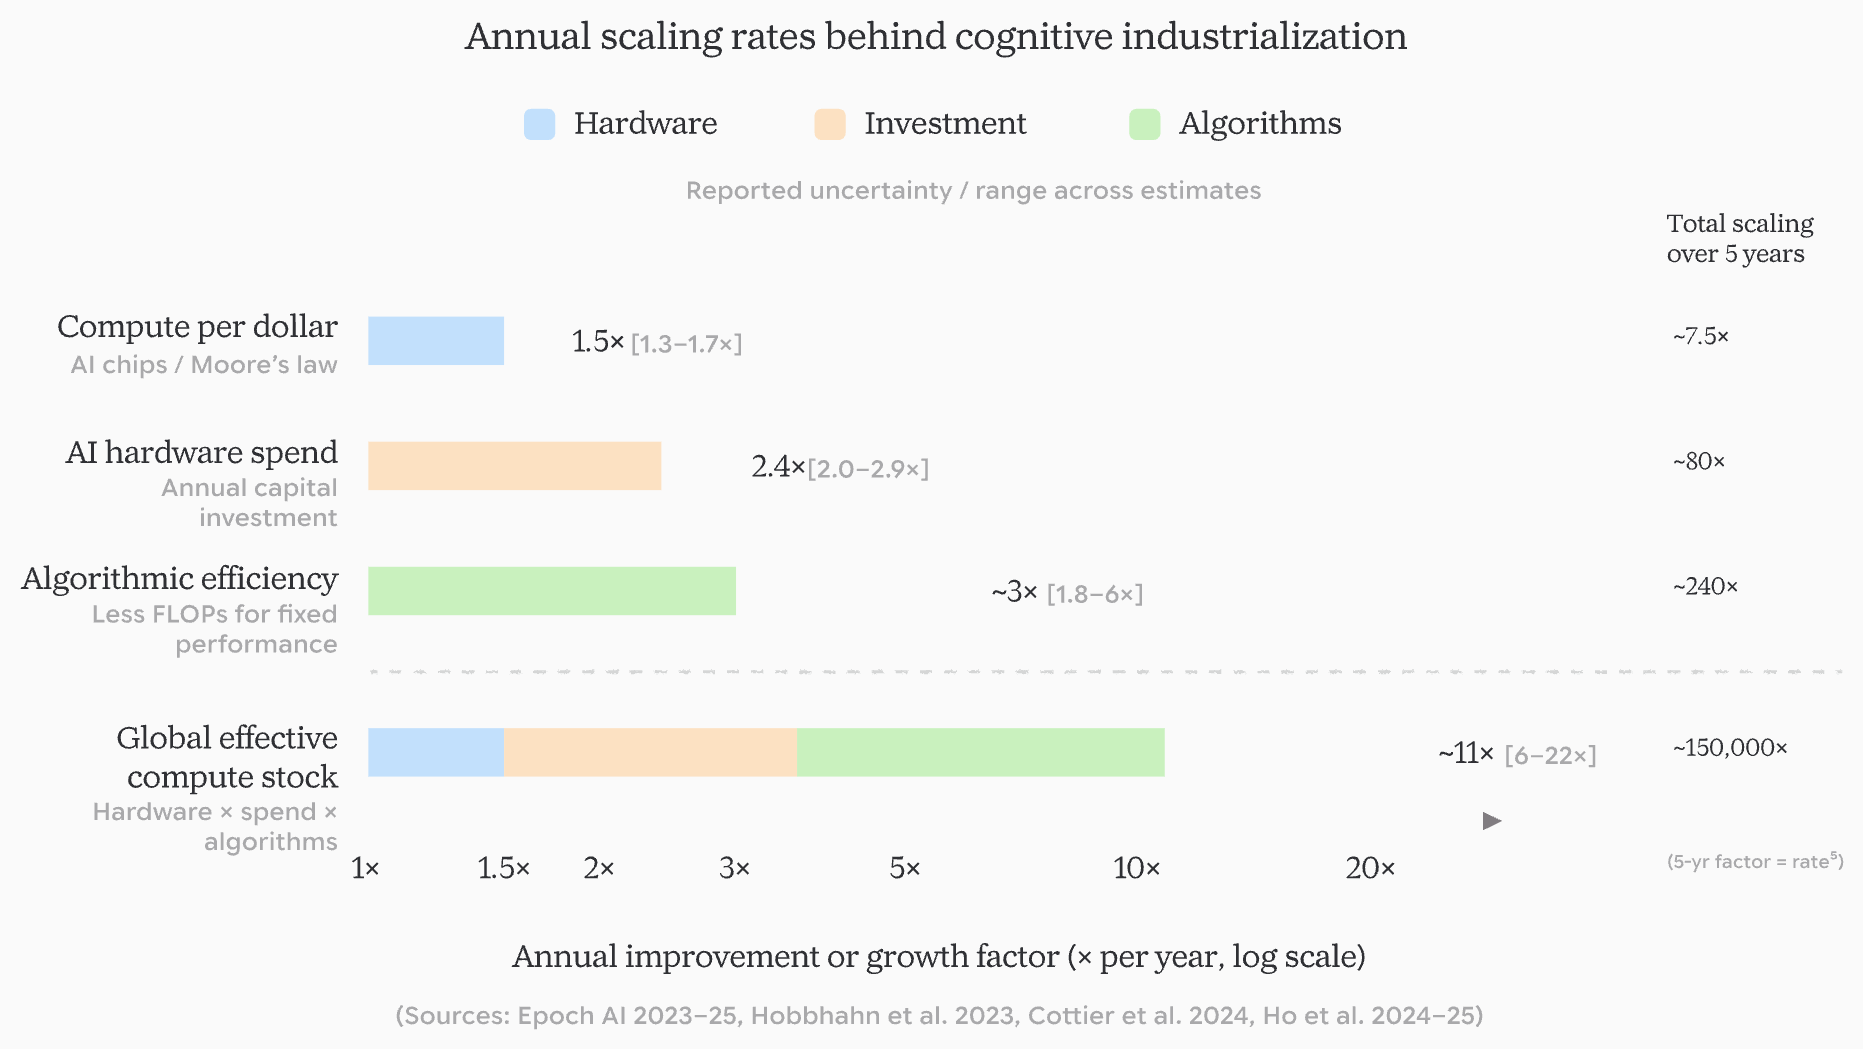
图:复合驱动力推动有效算力指数级扩张(Google DeepMind)
当这三股力量相互叠加时,全球有效算力的供给呈现出每年一个数量级以上的惊人膨胀。这就意味着,即便前沿底层架构在短期内停滞不前,已有 AGI 级别能力的边际边际成本也将被急速压缩至近乎零。
这种认知生产力的工业化普惠,使得社会有能力同时调用数以百万计的数字专家,将此前需要耗费人类数代人的科学难题与工程任务在极短周期内并行碾压解决。
从 AGI 走向 ASI 的四条核心路径
然而,技术演进的脚步绝不会止步于对存量能力的规模化复制。在迈向真正超级智能的过程中,Google DeepMind 梳理出了四条截然不同却高度互补的关键演进路径:
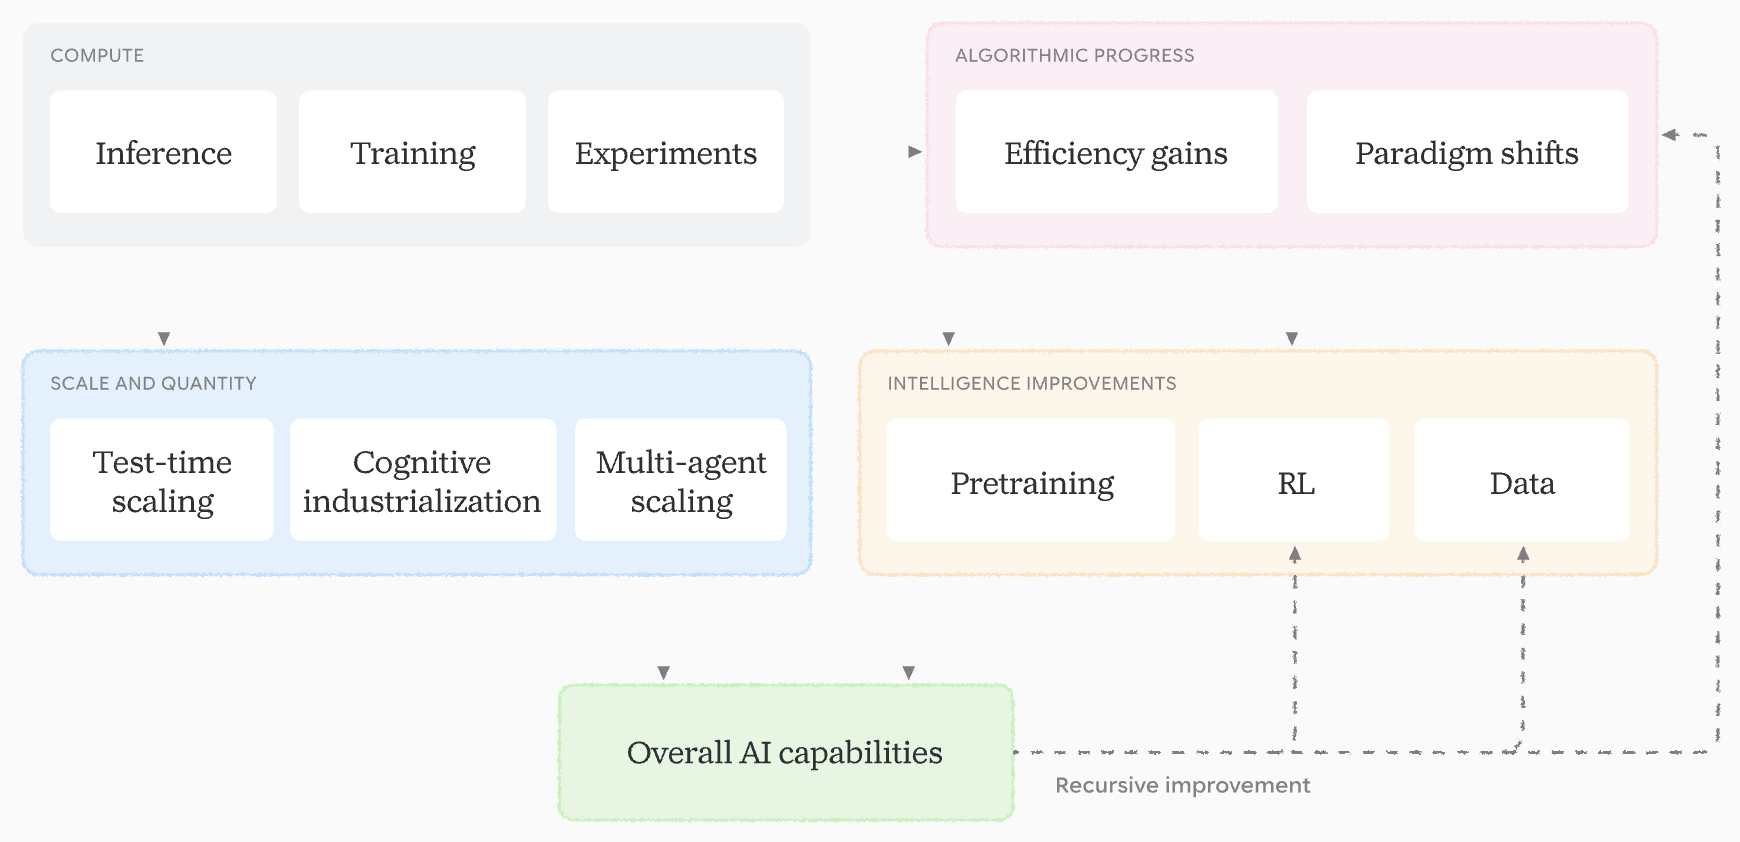
图:从 AGI 迈向超级智能的四条核心演进路径(Google DeepMind)
路径一:模型与数据缩放扩展(Scaling)
第一条路径是人类目前最为熟悉、也最为直观的规模扩展法则(Scaling Laws)。通过继续增加神经网络的参数容量、注入更为海量的高质量多模态数据,并匹配相适应的训练 FLOPs。
缩放法则的强大之处在于其惊人的可预测性与经验有效性。随着有效算力每年保持数倍以上的复合扩张,模型对复杂概念表征与跨领域知识迁移的深度将持续深化。
与此同时,后训练(Post-training)阶段的推理时计算扩展(Inference-time Compute)与强化学习探索,正在开辟出模型容量之外的全新第二增长曲线。
路径二:技术范式转移(Paradigm Shifts)
第二条路径关乎深层算法与底层架构的根本性范式跃迁。历史经验表明,单一技术范式的边际收益终将放缓,而全新的颠覆性架构往往应运而生。
当前主流的纯自回归 Transformer 架构在应对超长程因果规划、不确定性下的主动假设检验以及环境物理交互时,依然暴露出固有的局限性。
未来可能的范式突破包括但不限于:融入世界模型的基于搜索的深度规划框架、神经符号混合系统,以及借鉴生物脑神经机制的全新非 Transformer 神经形态架构。
路径三:提升智能体协同机制(Agent Coordination)
第三条路径着眼于由多个异构智能体构成的分布式协作体系。人类之所以能够创造灿烂的现代文明,并非因为个体大脑比远古智人强大数倍,而是依托了高度精密的社会分工与制度协同。
当数以万计的专业化 AGI 智能体能够借助标准化的通信协议、激励相容的协调机制以及多角色分工相互协作时,整个网络所涌现出的集体智慧将远远超越任何单一模型的算力上限。
这种多智能体系统不仅能够自组织地攻关复杂科研项目,还能够在动态环境博弈中通过彼此制衡与交叉验证,大幅降低单点幻觉与推理谬误的发生率。
路径四:递归自我改进(Recursive Self-Improvement)
第四条路径则是通向超级智能最具争议、也最为深远的核心驱动力:递归自我改进(RSI)。
在传统的科研范式中,人类研究人员构成了改进 AI 系统的主要瓶颈;而当 AGI 自身具备了阅读最新论文、自主设计模型架构、编写高效编译底层并开展大规模算法实验的能力时,智能的演进将彻底闭环。
每一次系统的迭代升级,都会创造出更为强大的下一代 AI 开发者,进而以更快的速度催生更高级的算法突破。这种自我强化的正反馈循环,正是数学家与计算机先驱所预言的智力爆炸的核心动力来源。
通向超级智能的多元演进之路
必须强调的是,这四条演进路径绝非非此即彼的割裂关系,而是呈现出极为紧密的协同共振效应。
规模扩展为全新技术范式的萌发奠定了算力与数据基础;而更高效的智能体协同架构,又反过来能够大幅加速递归自我改进过程中的并行研发效率。
从人类智能到超级智能,既不是遥不可及的神话,也不是单一奇点的瞬间降临,而是一场由工程探索、数学论证与产业协同共同谱写的波澜壮阔的技术长征。
唯有深入理解支撑这一进程的物理法则与演进路径,人类社会才能在超级智能的黎明真正到来之际,做好从容驾驭与负责任引导的充分准备。
欢迎加入深潮TechFlow官方社群
Telegram订阅群:https://t.me/TechFlowDaily
Twitter官方账号:https://x.com/TechFlowPost
Twitter英文账号:https://x.com/BlockFlow_News
 @GoogleDeepMind














