


Neurophos 光芯片融资 1.1 亿美元:同功耗算力称达 GPU 的 25 倍
作者:Sabbir Rangwala
编译:深潮 TechFlow
深潮导读:奥斯汀创业公司 Neurophos 用硅光与超材料做光学计算单元(OCU),刚拿下由 Gates Frontier 领投、微软风投基金 M12 等参投的 1.1 亿美元 A 轮。文章称其光核心无需片内开关、算力可达同尺寸同功耗 GPU 的约 25 倍,并展望 OCU 在 2028 年落地、2034 年约 27 亿美元市场——押注的是 AI 推理预填充阶段的矩阵算力与数据中心能耗瓶颈。
摘要
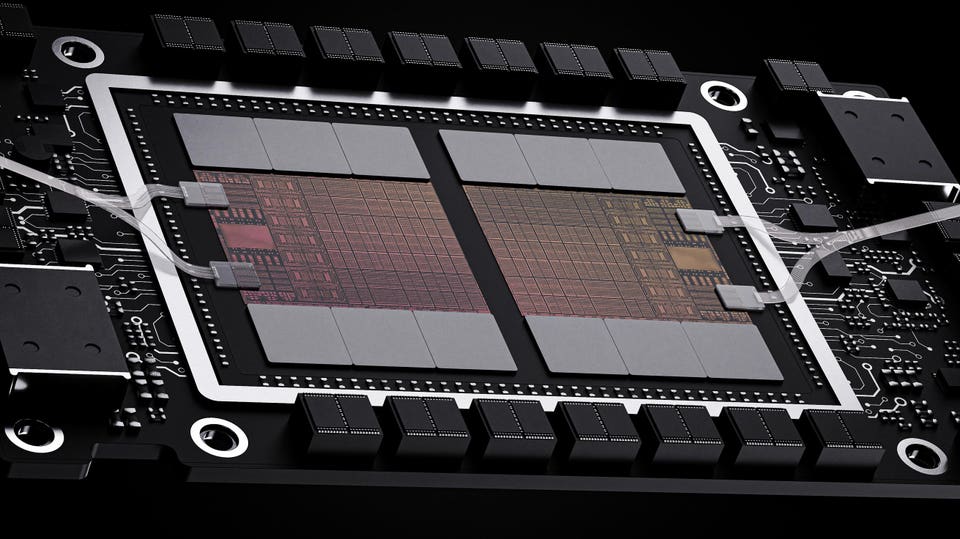
光计算始于 1960 年,并在过去数十年显著成熟,它在光域完成计算。总部位于得克萨斯州奥斯汀的 Neurophos,利用硅光电路与超材料构建光学计算单元(OCU)。该公司近日完成 1.1 亿美元 A 轮融资,以推进其光子 AI 芯片。Neurophos 的光学核心可在光速下瞬时完成计算,无需内部开关。因此,在相同芯片尺寸与能耗下,其技术可比肩的 GPU 实现显著更高的每秒运算次数。潜在市场也极为庞大——随着 OCU 日益替代数据中心中的 GPU 算力市场。这一市场如今估计约为每年 1 万亿美元。
计算通常在电子电路上完成——通过晶体管、开关与存储器移动数字比特。它效率很高,并在可扩展性、尺寸、功耗与速度上忠实追随摩尔定律。
问题在于,数据中心要处理海量光数据。传统上,这些数据必须先转换到电域(光子变成比特),才能把数据切换进不同通道,并对在线搜索以及 AI 数据流的学习与训练执行计算。光到电再回到光的转换(OEO)损耗极高,并大幅推高数据中心的能耗与用水——在金钱、政治与公司形象上都代价不菲。光路交换(OCS)正借助硅光与超材料来切换光束,在削弱这种昂贵的 OEO 转换上取得长足进展。但计算本身仍需要帮手。Neurophos 正做这件事。该公司用硅光电路与超材料技术,在光域完成计算。
光计算本身并不新鲜。
它始于 1960 年:研究者发现透镜与光学滤波器可以做傅里叶变换——一种把信号或波分解成各频率分量的数学运算。
1970 年代:空间光调制器(SLM)进一步推进,使人们能以可编程方式生成光图案、改变聚焦,甚至让激光束按特定模式移动。
1980–2000 年:随后二十年出现大量学术研究与创新,但始终未能商业化——主要因为电子计算突飞猛进,而光学仍困在实验室。SLM 技术后来被用于做向量-矩阵乘法(VMM),这是关键突破。
2000–2025 年:这 25 年见证了光学走向成熟——光半导体、硅光、超材料、光纤与自由空间光学,应用于传感、通信、材料加工与计算。超大规模数据中心也在此期间崛起,它们消耗海量光学技术,并催生了 Lumentum、Coherent、Corning 与 IPG Photonics 等数十亿美元级光学玩家。数据中心如今需要光学,不只是为了传输与交换数据,还要「对数据做事」——比如计算。一座超大规模数据中心功耗在 100 兆瓦到 1 吉瓦,其中约 50%用于计算。光计算可以大幅降低能耗(以及相应的冷却需求)。
Neurophos 走在让光计算落地的最前列。公司位于得州奥斯汀,近日再融资 1.1 亿美元以加速光计算进展。本轮由 Gates Frontier 领投,微软风投基金 M12、Carbon Direct Capital、Aramco Ventures、Bosch Ventures、Tectonic Ventures、Space Capital 等参投。这使公司得以在 2026 年把团队扩大约 4 倍。Neurophos 首席执行官兼联合创始人 Patrick Bowen 博士表示:「摩尔定律正在放缓,但 AI 等不起。我们在光子学上的突破打开了全新的扩展维度,把海量光学并行塞进单芯片。这种物理层面的跃迁意味着,扩容时效率与原始速度会一起提升,从而摆脱传统 GPU 所受的功耗墙约束。光计算改写的是:在给定功耗、空间与金钱下,我们能交付多少 AI。」
先讲几个基本点。AI 推理阶段的计算分两类——「预填充(prefill)」与「解码(decode)」。预填充是大语言模型(LLM)推理的第一阶段:模型并行读取并分析整段输入提示。解码则是模型写出回答,这一步高度串行。在 AI 推理中,预填充主导算力负载。训练 LLM、在海量数据上做学习也会带来算力负载;虽然耗电不小,但这是初始训练时的短暂功耗。训练更新本身的功耗要低得多。
图 1 对比了经典光计算(电学与基于 GPU 的路径)及其问题,以及 Neurophos 如何用 OCU(光学计算单元)架构求解。
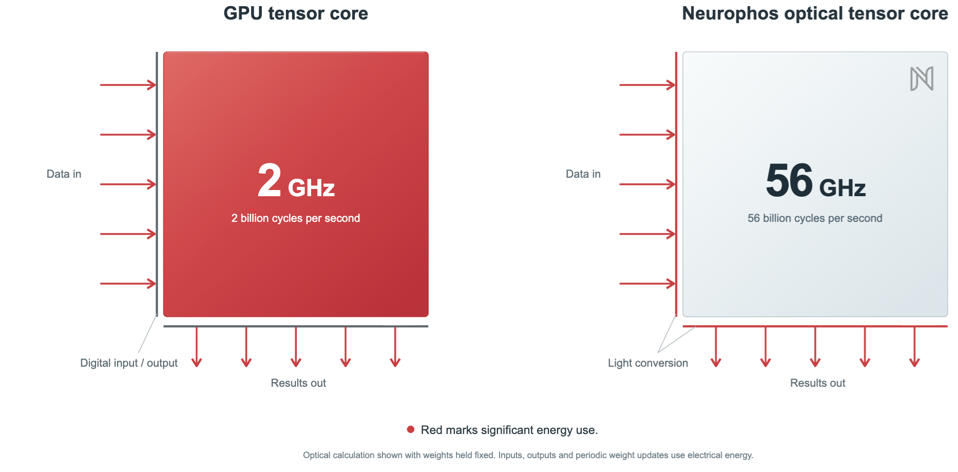
如前所述,在数据中心场景中,压低能耗至关重要。当前计算发生在电域——而 Scale Up 与 Scale Across 机架里的数据传输大多已是光。用电域 GPU 芯片做计算,需要先做光到电转换再计算,然后再做电到光转换以便传输。电子在金属导体中的传输有损耗。此外,像 GPU 这类电学器件在计算核心里布满开关;等待开关稳定会吃掉计算时间。在 Neurophos 的光学核心中,计算在光速下瞬时完成,因为不需要开关。它能同时完成数百万次计算,每秒 560 亿次,节奏远快于同等尺寸的 GPU。除速度外,OCU 功耗也显著更低:无需给开关供电,信号传播损耗也极小。电学流程与功耗集中在输入输出端,用于电光与光电转换。结果是,在相同芯片尺寸与能耗下,一颗 OCU 可比 GPU 多完成约 25 倍的每秒运算。
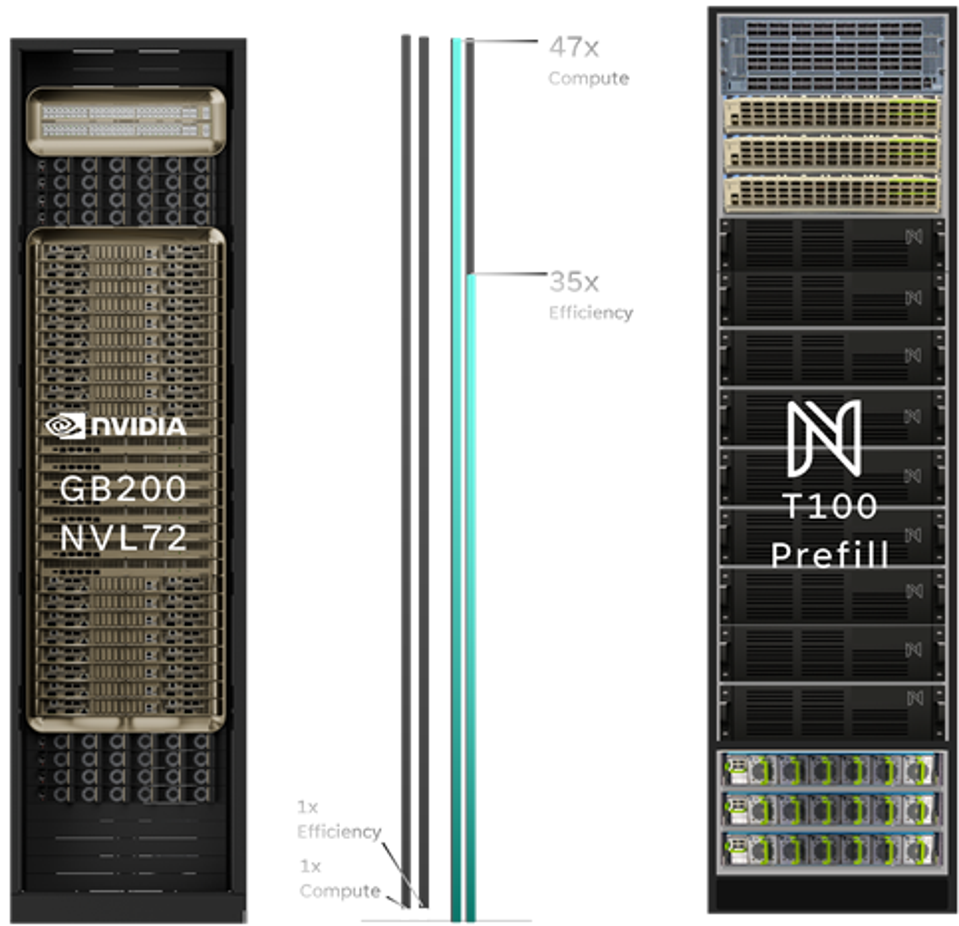
目前还没有像电子那样有效的光子存储技术。因此,计算必须暂停,把中间结果锁定,再进入下一计算阶段,把数学运算一拍一拍地离散推进。正因为如此,仍须使用 SRAM 与 DRAM。未来若光存储问题得到解决,OCU 输入输出端将不再需要 OEO 转换,从而带来更快速度,以及更低功耗、成本与尺寸。
预填充计算包含大量矩阵乘法,因为 LLM 要在高维空间里建立提示与已训练引擎之间的关联。在 GPU 上,芯片很大一块面积专用于这些计算。在 Neurophos 芯片上,乘法通过三项操作完成:
数据拷贝借助光分路器,按一定比例把信号分到不同路径。它是可做进光子电路的无源元件,把入射光子流拆成沿不同波导的多路流,并用干涉耦合器、绝热锥与波长敏感光栅等实现。
乘法在光域完成,利用反射与透射结构组合多束光的强度。实际光学元件可以是干涉仪与移相器。
加法借助光合路器——把多路光信号并入单路输出的元件。它可以合并各路光的振幅、波长、相位或偏振属性。
光计算的主要应用是矩阵-矩阵乘法。在光学里,一个矩阵存在光学调制器网格中,另一个则以输入向量序列送入,向量里每个数编码在各自光束的振幅上。拷贝靠把每束光拆成大约一千束,铺开落在调制器网格的一行。光学乘法靠反射或透射:每束被拷贝的光从调制器反射,反射光等于入射光乘以该调制器所存数值。加法则把网格每一列反射的光聚焦到单个光电探测器上,把这些光加总成输出的一个元素。因为调制器在成千上万个输入向量通过时一直保持其矩阵,加载矩阵的能量被摊到所有这些向量上——这正是光学张量核为矩阵-矩阵而非向量-矩阵乘法而建的原因。
这些操作发生在光学芯片上(如图 1 所示),芯片由蚀刻在硅、氮化硅(SiN)或磷化铟(InP)等材料中的微细波导构成。波导在芯片内引导光束。激光源与光探测器集成其中,以实现 OEO 转换。调制器改变光的强度、相位、偏振与波长等属性,以编码和处理信息。除调制器外,波导还集成分路器、反射与透射面,以及合路器。
Neurophos 的 AI 推理芯片采用带可调光学元件的超构表面架构。它瞄准 AI 基础设施的核心约束:为超大规模推理制造、供电、冷却并部署足够算力。微软深度参与,也是投资方。其他商业进展包括超大规模云厂商。公司已完成首个超构表面阵列的计算演示,并正在流片更多可靠性与性能改进的器件。供应链一端包括领先代工厂、定制 ASIC 设计方、光学供应商与封装伙伴。
光计算与矩阵乘法的一个关键挑战是:标准调制器尺寸偏大,长度约 2 毫米。这意味着给定尺寸的芯片上能塞进的调制器更少,从而限制算力速度与能效(运算次数/瓦)。一边一千个调制器的阵列,只需两千次转换(一千入、一千出)就能完成一百万次乘法与一百万次加法,于是每次转换被摊到大约一千次运算上。Neurophos 的「秘诀」是用超材料把调制器面积做到比当今先进水平小约 1 万倍,从而把一百万个调制器放进指甲盖大小的芯片,而不是牌桌大小的基板。这让千乘千阵列在单芯片上变得现实,也兑现了光计算一直承诺的效率。
完整的 Neurophos 光学张量核是三件套组件。第一,硅光芯片生成输入向量并收集输出向量。它以 56 吉赫兹时钟运行,该时钟决定算力速度。它使用常规大尺寸调制器,但大约只要一千个而非一百万个,因此更看重快而非小。第二,超构表面芯片保存权重矩阵。因为矩阵在许多输入向量间保持不变,这些调制器更看重小而非快。最后,光学投影系统连接两块芯片:它把硅光芯片上的每束输入光拷贝铺开到超构表面的一行,再把每列反射光聚焦回硅光芯片上的单个光电探测器完成求和。再封装上 HBM 与用于控制与存储的数字芯片,这一光学张量核就成为 GPU 的即插即用替代。按光刻版尺寸管芯计,它比当今最先进 GPU 快约 50 倍,基础能效约高 35 倍。
光学已是数据中心的重要组成部分;未来五年,随着 Scale-Up 机架越来越多采用光路交换(OCS)而非电分组交换(EPS),光学含量料将继续上升。OCS 市场预计未来五年增长约 5 倍,至每年 110 亿美元。另一大市场在计算:OCU 相对 GPU 等电学路径,在算力速度、芯片尺寸与功耗上展现显著改进。据 Yole Group,首批 OCU 预计 2028 年部署,到 2034 年市场有望增至约 27 亿美元(约 100 万套)。但潜在空间远不只如此——随着 OCU 日益替代数据中心 GPU 算力市场。这一市场如今估计约为每年 1 万亿美元。
欢迎加入深潮TechFlow官方社群
Telegram订阅群:https://t.me/TechFlowDaily
Twitter官方账号:https://x.com/TechFlowPost
Twitter英文账号:https://x.com/BlockFlow_News
 Forbes
















